 AIREITER
Anthropic 新旗舰的标价是每 100 万 token 输入 $8、输出 $40,但实际任务成本可能从 $2.48 一路涨到 $44.70。对于 Claude Fable 5.2 来说,真正决定账单的,是你选择了哪档推理强度。
Claude Fable 5.2 API 定价:模型 ID、缓存、Batch 与 Fast 模式
官方价格为:每 100 万 token 输入 $8.00、输出 $40.00;缓存读取 $0.20;5 分钟缓存写入 $10.00;1 小时缓存写入 $16.00。模型 ID 为 claude-fable-5-2(Claude Platform Docs),Bedrock ID 为 bedrock/claude_platform/claude-fable-5-2(LiteLLM)。上下文窗口为 1M token,最大输出 128K token,最小可缓存提示词长度为 512 token。Batch 将实时价格减半至 $4.00/$20.00;Fast 模式则翻倍至 $16.00/$80.00,速度最高可提升 2.5 倍。计算公式很直接:输入 token × $8 + 输出 token × $40,再按 $0.20 的缓存读取价格扣除缓存命中部分;使用 Batch 时整体再减半。
| 项目 | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| 输入 / 100 万 token | $8.00 | $10.00 | $4.00 |
| 输出 / 100 万 token | $40.00 | $50.00 | $20.00 |
| 缓存读取 / 100 万 token | $0.20 | $0.25 | $0.20 |
| 5 分钟缓存写入 / 100 万 token | $10.00 | $12.50 | $5.00 |
| 1 小时缓存写入 / 100 万 token | $16.00 | $20.00 | $8.00 |
| Batch 输入 / 输出 | $4.00 / $20.00 | $5.00 / $25.00 | $2.00 / $10.00 |
| Fast 输入 / 输出 | $16.00 / $80.00 | 不适用 | $8.00 / $40.00 |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K | 1M / 128K |
按同一口径计算:1000 万输入 token 加 100 万输出 token,Fable 5.1 的成本是 $150,Fable 5.2 标准模式为 $120(Fast 模式为 $240),Opus 5.5 则是 $60。缓存大约在重复使用两次前缀后开始回本:写入价格是输入价格的 1.25 倍,而读取价格仅为输入价格的 2.5%。根据一个中等负载模型,在 2000 万输入 token、500 万输出 token、80% 缓存命中的情况下,成本会从 $360 降到 $235,节省 $125。
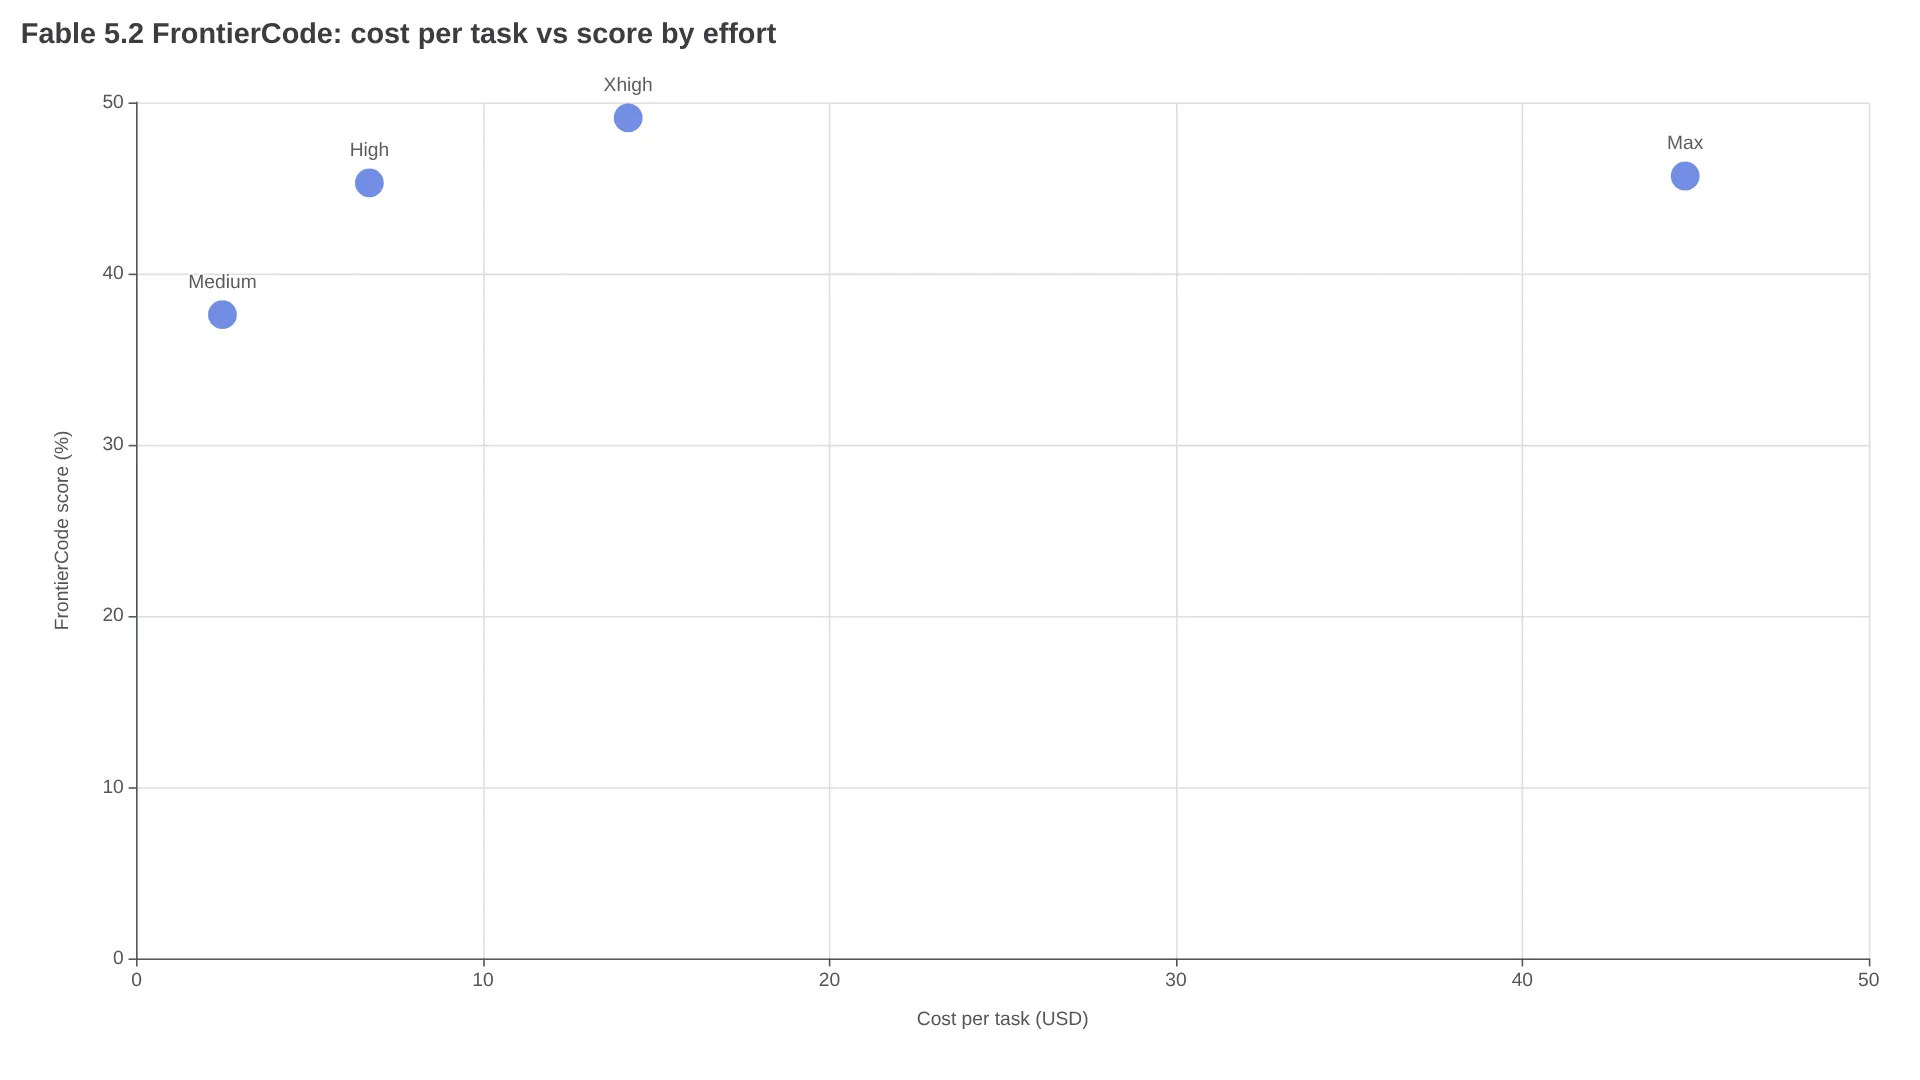
推理强度的账单效应:同一个模型,任务成本从 $2.48 到 $44.70
关于 Cognition FrontierCode 2.0 的独立报道显示,在 132 个可直接合并的补丁任务中,Fable 5.2 使用 Medium 时单任务成本为 $2.48、得分 37.6%;High 为 $6.72、得分 45.3%;Xhigh 为 $14.19、得分 49.1%;Max 为 $44.70、得分 45.7%。报道指出,Medium 是 Claude 应用和 Code 中的默认档位。Max 的成本是 Xhigh 的 3.15 倍,得分却更低,因此在这套测试中固定使用 Max 只会浪费预算。
| 指标 | Fable 5.2 | 竞品 | 怎么看 |
|---|---|---|---|
| FrontierCode,同等花费 | High:$6.72,45.3% | GPT-6 Astra Max:$6.68,42.8% | 同等预算下 Fable 高 2.5 个百分点 |
| FrontierCode 最高成绩 | Xhigh:$14.19,49.1% | Opus 5.5 Max:$12.82,45.5% | Fable 峰值更贵,但得分更高 |
| 代际提升 | Xhigh:49.1% | Fable 5.1 Xhigh:$8.68,32.4% | 任务成本增加 63%,得分提升 16.7 个百分点 |
同一报道还显示,Fable 5.2 的 Medium 比 Fable 5.1 的 Xhigh 高 5.2 个百分点,而单任务成本大约低 71%($2.48 对 $8.68)。对智能体而言,真正拉开总支出的往往不是单价,而是测试、重复读取、重试和任务委派。复杂任务可以默认使用 High;只有在质量门槛允许时才升级到 Xhigh;Max 则应保留给那些已经在自有工作负载上证明其价值的场景。
Fable 5.2 对比 Opus 5.5:按任务价格做模型路由
根据官方公告中的发布建议,大多数编程和知识工作应优先使用 Opus 5.5;Fable 5.2 更适合异常困难的任务,也可以作为廉价模型的顾问,或负责把任务分派给更快模型的编排器。Fable 的价格为 $8/$40,Opus 为 $4/$20。对日常任务使用 Fable,相当于为用不上的能力支付两倍价格。
| 工作负载 | 推荐选择 | 成本逻辑 |
|---|---|---|
| 卡住的迁移、顽固 Bug、困难设计 | Fable 5.2 High | 单任务 $6.72;在得分相当的情况下,比 Opus Max 的 $12.82 低一半 |
| 追求最高得分,预算次要 | Fable 5.2 Xhigh | $14.19,得分 49.1% |
| 日常代码、文档、草稿 | Opus 5.5 | token 价格低一半,也是厂商默认推荐 |
| 反复使用的系统提示词 | Fable High + 缓存 | 最低 512 token;在 5 分钟和 1 小时写入策略之间权衡 |
| 受延迟限制的会话 | 对比测试 Fast($16/$80)与 High | 只有吞吐量确实提升时,翻倍价格才值得 |
| 离线批量回填 | Batch API | 价格降低 50%:Fable $4/$20,Opus $2/$10 |
配额消耗与重置:订阅页面不会告诉你的事(用户反馈)
发布首周出现的配额信息来自用户反馈,并不是官方记录的 API 政策。Claude Code 和 Pro 用户反映,5 小时配额和周配额消耗得非常快;同时,Fable 的一次重置究竟会恢复 5 小时额度、每周 Fable 额度,还是通用容量,也并不清晰。Anthropic 在公告中表示,首发促销期间,用户根据订阅历史可获得一到三次 Fable 重置。
“大约 10 分钟就用掉了我每周额度的 20%”——u/travisrd,r/claude《Fable 5.2 太疯狂了》
“我的 5 小时额度正在被彻底吃光!!”——u/myairblaster,r/ClaudeAI《Fable 5.2》
“发现了一堆 Bug,还有几个 Opus 5.5 漏掉的关键 Bug”——u/TheMagicalOppai,r/ClaudeAI《Fable 5.2》
这类高峰式的 Bug 排查更适合使用按量付费的 API Key:订阅服务会受到 5 小时上限约束,而 API 支出则会随 High 推理任务线性增加——在 FrontierCode 样例中,每个任务约 $6.72。把团队工作切到 Fable 前,先在应用内确认重置范围,并分别记录 5 小时额度和每周额度的消耗。
Fable 与 Mythos:权重相同,安全门槛不同
根据官方公告,Fable 5.2 和 Mythos 5.2 共享同一套权重,但安全防护不同。Fable 面向普遍用户开放,相比 5.1 的误拒率减少 55%。Mythos 则通过 Cyber 和 Life Sciences Verification Programs,向经过审核的机构解除网络安全和生物学相关限制;其 token 价格同样是 $8/$40。
从 2026 年 11 月 9 日起,Fable 可用于付费 Claude 计划、Claude Code、Claude Platform API、AWS、Google Cloud 和 Microsoft Azure,生成速度最高比 5.1 快 30%。
如果团队正在寻找更便宜的默认模型,也可以查看Claude Sonnet 5.5 API 评测与定价,其价格路径为 $2/$10。