 AIREITER
Claude Sonnet 5.5 的输入价格为每百万 token $2,并在公开的 Terminal-Bench 4.0 测试中拿到 70.6% 的成绩。不过,一旦开启高强度推理,Agent 任务的实际成本可能显著高于这个定价带来的直觉。对于正在选择生产级编程模型的团队,Sonnet 5.5 适合先作为默认路线试点,但还不应直接替代 Opus 5.5。
生产环境结论:先把 Sonnet 5.5 作为默认编程模型
建议优先用 Claude Sonnet 5.5 处理范围明确的 Bug 修复、重构、测试生成,以及需要调用工具操作代码仓库的任务。Anthropic 公布的 Terminal-Bench 4.0 成绩为 70.6%,高于同一对比中的 Claude Opus 5.5(66.4%)和 Claude Sonnet 5(10.3%)。
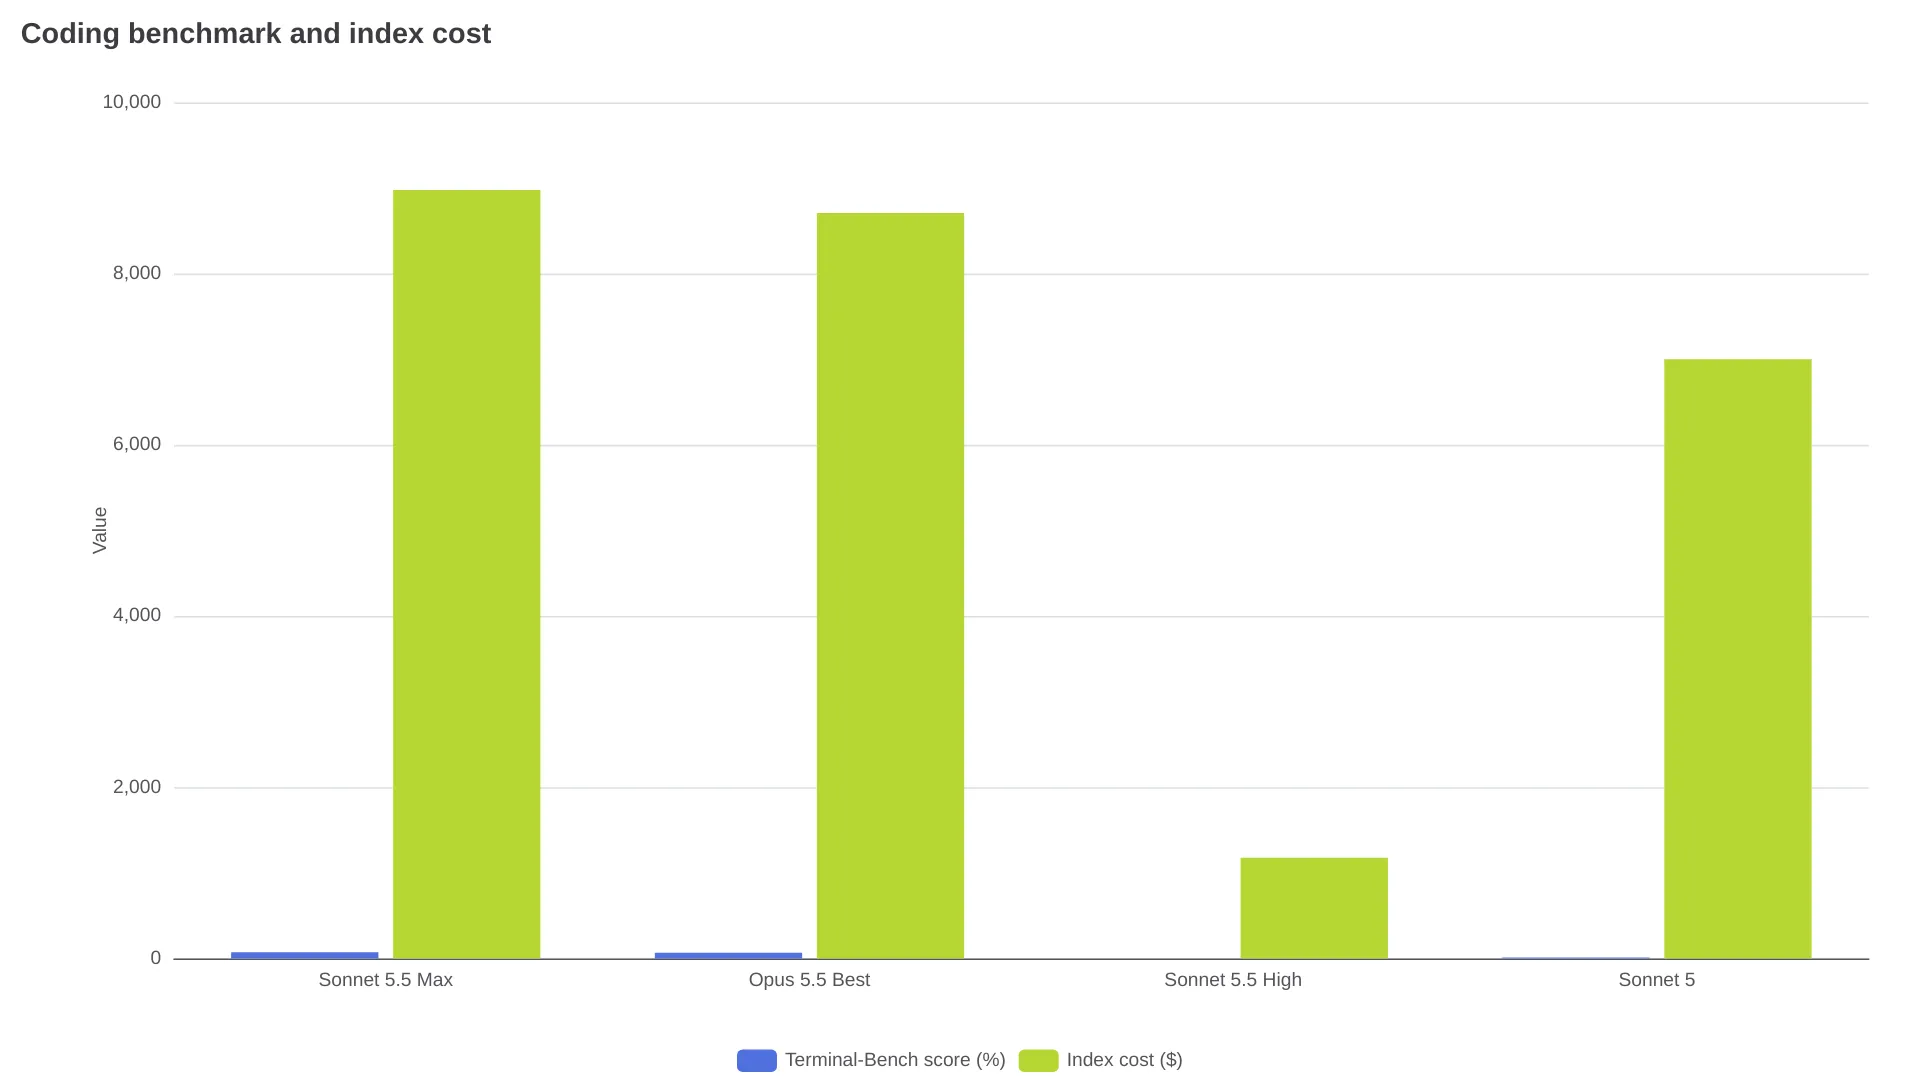
但要加上一道护栏:务必显式设置 effort 和输出上限。多份独立成本分析显示,Sonnet 5.5 在 max effort 下,每个基准任务的成本可能高于 Opus 5.5,尽管 Sonnet 的名义价格更低。
Claude Sonnet 5.5 给 API 团队带来了哪些变化
Claude Sonnet 5.5 于 September 28, 2026 发布。官方模型文档列出的模型 ID 为 claude-sonnet-5-5,支持 1-million-token 上下文窗口、128,000-token 标准最大输出、adaptive thinking,API 默认 effort 等级为 high。
| 生产环境细节 | Claude Sonnet 5.5 |
|---|---|
| 发布日期 | September 28, 2026 |
| 模型 ID | claude-sonnet-5-5 |
| 上下文窗口 | 1M tokens |
| 标准最大输出 | 128K tokens |
| Batch 最大输出 | 300K tokens,需使用文档中说明的 beta header |
| API 默认 effort | high |
Anthropic 在文档中承诺,不会在 September 28, 2027 之前退役该模型。这是生命周期下限,并不代表最终退役日期已经确定。
会直接影响编程账单的 API 默认设置
Adaptive thinking 默认开启。从 Sonnet 5 迁移时,如果需要关闭预先思考,团队应测试 between_tools。官方文档指出,强制工具调用现在会返回错误,而非默认的 temperature、top_p 或 top_k 值则会返回 HTTP 400 错误。
工具调用之间生成的文本可能会以 thinking block 的形式返回。如果流式客户端默认所有中间消息都是普通文本 block,迁移后可能表现为“没有响应”。在把 Sonnet 5.5 接入现有编程 Agent 之前,先更新解析器。
Terminal-Bench 性能:足以胜任默认路线
这里最值得关注的编程 Agent 基准测试是 Terminal-Bench 4.0,它评估的是多步骤命令行任务。Anthropic 公布的结果显示,Sonnet 5.5 得分 70.6%,Opus 5.5 为 66.4%,Sonnet 5 则为 10.3%。
| 模型 | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
上表数据来自 DataCamp 的基准测试总结,该页面将评测结果归因于 Anthropic 的发布材料。Sonnet 5.5 在终端编程对比中领先,但 Opus 5.5 在 CursorBench 以及多个更广泛的推理和知识工作评测中仍然占优。
在真实代码仓库的回放测试中,应关注测试是否通过、工具调用轮数和最终被接受的修改,而不能只看 diff。
真实工作负载下的 Claude Sonnet 5.5 API 定价
Anthropic 的价格表本身并不复杂,但编程 Agent 实际付费的内容可能比可见的 prompt 更多。Thinking token 按输出计费,而多轮调用中重复发送的仓库上下文,则可能以 cache read 的形式产生费用。
| API 项目 | Claude Sonnet 5.5 价格 |
|---|---|
| 输入 | $2 per 1M tokens |
| 输出,包括 thinking | $10 per 1M tokens |
| 5 分钟 cache write | $2.50 per 1M tokens |
| 1 小时 cache write | $4 per 1M tokens |
| Cache read | $0.20 per 1M tokens |
| Batch 输入 | 50% discount,相当于 $1 per 1M |
| Batch 输出 | 50% discount,相当于 $5 per 1M |
官方文档列出了 512-token 的最小可缓存 prompt,并说明 Sonnet 5.5 使用 adaptive thinking。根据 eesel 的独立定价分析,Sonnet 5.5 与 Sonnet 5 使用相同的 tokenizer;模型迁移并不会自动减少 token 数量。
一个包含 4,000 个输入 token 和 700 个输出 token 的请求,在不计其他费用的情况下,成本约为 $0.015:输入成本 $0.008,加上输出成本 $0.007。若编程 Agent 运行 20 轮,每轮产生 3,000 个新输入 token 和 2,000 个输出 token,那么在不计 cache read、cache write、工具调用和重试的情况下,新增输入成本约为 $0.12,输出成本约为 $0.40。这些只是工作负载示例,并不代表所有任务的统一价格。
Effort 才是真正的成本控制旋钮
TokenCost 的 effort 分析基于 Artificial Analysis Intelligence Index 的测量结果,报告了 Sonnet 5.5 的以下数据:
| Effort | 得分 | 完整指数成本 |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
最值得警惕的是 max。该分析显示,Opus 5.5 在 max 下的得分为 57.6,成本为 $8,708;在 xhigh 下得分为 56.0,成本为 $4,057。测试中,Sonnet 5.5 max 每个任务大约使用 193,000 个输出 token。
建议从 medium 或 high 开始,并限制输出 token;只有失败任务或高风险任务,才升级到更昂贵的模型路线。不要把旧版 Sonnet 5 的 max 设置原样复制到 Sonnet 5.5,除非已经重新完成成本和质量评估。
生产级编程模型迁移清单
- 在 staging 环境固定使用
claude-sonnet-5-5,不要直接全局切换 alias。 - 从代码仓库中回放具有代表性的 Bug 修复、重构、测试和多文件修改任务。
- 显式设置 effort,并记录输出 token、cache read、工具调用轮数、耗时以及修改被接受的比例。
- 在适用场景中,将
thinking: disabled替换为受支持的between_tools行为。 - 移除对强制工具调用的假设,并测试新的工具选择行为。
- 更新流式处理代码,确保能够处理工具调用之间的
thinkingblock。 - 重新检查非默认采样参数;官方文档列出,非默认
temperature、top_p和top_k会返回 400 错误。 - 为失控输出或反复工具循环设置消费上限和中止条件。
- 比较每个被接受修改的成本,而不是每个请求的成本。
- 先将模型部署到少量流量中。只有当 Sonnet 在双方约定的容忍范围内达到现有模型的修改接受率,同时降低每个被接受修改的成本时,才扩大流量。
Anthropic 员工 @cjav_dev 报告称,使用 thinking: {"type":"disabled"} 的请求开始返回 400 错误,应改用 between_tools(X 上的帖子)。
什么时候该选 Sonnet 5.5、Opus 5.5,还是更便宜的模型
| 工作负载 | 首选模型 | 原因 |
|---|---|---|
| 范围明确的 Bug 修复和重构 | Sonnet 5.5,使用 medium/high | 终端任务成绩强,同时 token 价格更低 |
| 大规模代码分类或简单编辑 | Sonnet 5.5,使用 low/medium,或更便宜的模型 | 避免为不必要的推理付费 |
| 长时间运行的代码仓库 Agent | Sonnet 5.5,配合缓存和严格预算 | 缓存命中和调用轮数决定实际账单 |
| 含义不明确的架构设计或最终评审 | Opus 5.5 | 更全面的判断能力比最低价目表更重要 |
| 离线、非紧急的代码分析 | Sonnet 5.5 Batch API | API 提供 50% 的输入/输出折扣 |
| Max-effort 终端实验 | 只有在完成内部基准测试后才使用 Sonnet 5.5 | Terminal-Bench 是它的相对优势,但 max 可能非常昂贵 |
定义清晰、可量化的任务交给 Sonnet;架构含义不明确的工作则升级到 Opus。
Claude Sonnet 5.5 API 常见问题
Claude Sonnet 5.5 API 怎么收费?
标准价格为每百万输入 token $2、每百万输出 token $10。Cache read 的价格为每百万 token $0.20,cache write 在五分钟有效期下为每百万 token $2.50、一个小时有效期下为每百万 token $4;Batch API 则对输入和输出都提供 50% 折扣。
Sonnet 5.5 编程能力比 Opus 5.5 更好吗?
在公开的 Terminal-Bench 4.0 对比中,Sonnet 5.5 以 70.6% 领先于 Opus 5.5 的 66.4%。但 Opus 在其他多项评测中仍然占优,因此团队应根据任务类型进行路由,而不要把单项编程成绩当成普遍排名。
Sonnet 5.5 的模型 ID 是什么?
在 Claude API 中使用 claude-sonnet-5-5。各服务商使用的具体标识符列在 Anthropic 的模型文档中。
Sonnet 5.5 支持 1M-token 上下文窗口吗?
支持。Anthropic 列出的上下文窗口为 1-million-token,标准最大输出为 128,000-token。Message Batches API beta 配合文档中说明的 beta header,可以支持 300,000 个输出 token。
从 Sonnet 5 迁移时有哪些变化?
Adaptive thinking 和响应 block 的行为发生了变化,强制工具调用可能报错,非默认采样参数可能返回 400 错误,thinking: disabled 也必须替换为受支持的行为。正式上线前,重新运行 Agent 和流式处理测试。
先进行为期一周的 medium/high-effort 回放试点,测量每个被接受修改的成本,并将失败案例升级到 Opus。