 AIREITER
一台 Mac mini 在本地用 2.81 秒生成了 38.5 秒音频,不用上云,也没有按量计费。这正是 Zyphra 为 ZONOS3-Mini 打出的卖点:这款于 2026 年 11 月 9 日发布的混合专家文本转语音模型,总参数量为 8 亿,但每一步实际只激活约 1 亿参数。不过,早期测试者也反复提醒:演示用的是英语和高性能硬件。换成你的文本、语言和 GPU,结果未必还能这么漂亮。
ZONOS3-Mini 是什么,能在哪里运行
ZONOS3-Mini 是 Zyphra 推出的零样本声音克隆 TTS 模型。输入一段文本和简短的参考音频,它就能模仿该声音说话;也可以直接选择 27 种预设声音,并调整年龄、口音和音色质感。模型权重采用 Apache 2.0 许可,运行时代码采用 MIT 许可,允许本地部署和商业复用。但请只克隆自己拥有或已获得授权的声音。
底层架构是稀疏 MoE:包含 64 个专家、采用 top-2 路由,11 层网络按 3:1 比例混合 Gated DeltaNet 与全局注意力。它还引入了新的 Zyphra Audio Codec 1(ZAC-1),以每秒 15 帧运行,替代 ZONOS2 所用的 86 Hz DAC。Zyphra 表示,这一变化将语音 token 数从每秒 774 个降至 150 个;在相同训练数据条件下,词错误率约比 DAC 低 10 倍。
核心规格包括:44.1 kHz 输出、最长可生成 10 分钟音频;原始音频克隆参考最长 60 秒,嵌入式声音克隆参考最长 120 秒;训练使用了 112 张 NVIDIA H100 GPU,持续 2.5 天。
目前有五种运行方式:
- 无需安装的浏览器 WebGPU Playground
- 基于 ggml 的原生 C++ 实现,可运行在 CPU、CUDA、Metal 或 Vulkan 上
- Apple MLX server
- 面向 NVIDIA 服务器的 SGLang 或 vLLM
- 通过 OpenAI 兼容
/v1/audio/speech端点调用 Zyphra 托管 API,模型名为zyphra/zonos3-mini
厂商给出的延迟数据很激进:Pixel 9 浏览器中的首音频时间低于 570 ms,M3 MacBook Air 上低于 150 ms;单张 H100 通过 SGLang 的中位延迟为 57–80 ms,峰值吞吐量最高可达每秒 457 音频秒。但手机和笔记本的数字应视为最佳情况。Zyphra 自己的发布帖中,对同一批设备给出的说法其实更保守:分别低于 800 ms 和低于 450 ms。因此,在对外承诺性能前,先在自己的硬件上测试。
发布材料中还有两个未说明的问题:技术文章称总参数量为 800M,而模型页面写的是 886M;另外,两边都没有说明水印、滥用防护措施,以及上传参考声音后的数据保留政策。
先用浏览器试,再决定要不要安装
浏览器 Playground 通过 WebGPU 在你的 GPU 上本地推理,不需要服务器,也没有安装步骤。但首次访问的代价并不小:一位早期测试者报告称,页面会先下载约 920 MB 的模型和编解码器文件,生成过一次后浏览器会将其缓存下来。
它很适合作为零成本的第一轮测试:先体验克隆和片段级控制,再在你性能最弱的目标设备上比较延迟。因为 WebGPU 的实际表现会随浏览器、驱动和 GPU 而变化。
“别因为一个小模型能在浏览器跑,就高喊‘云端 TTS 已死’!不同浏览器和驱动的 WebGPU 兼容性坑很多!英语演示效果好,不代表你的生产文本也能扛住!”—— @GKev1n,一位提醒大家别只凭演示就替换托管 TTS 的真实用户
如果你的用户使用老旧手机、核显设备或非 Chromium 浏览器,别在没有实测的前提下,把 Pixel 9 的数据直接套过去。
功能重点:免转录克隆声音,还能逐词控制
- 零样本声音克隆:最长可使用 60 秒参考音频,无需提供转录文本;原始音频模式更偏向自然效果,也可以生成可复用的说话人嵌入,供后续继续调整。
- 声音设计:可设定目标年龄、偏男性到偏女性的声线表现,并对美式、英式和澳式口音进行引导;还可组合柔和、沙哑、明亮、低沉等质感设置。
- 表达方式控制:语速、情绪、发声力度、活跃度、唤醒度和耳语都能控制,细到词语片段级别。例如只让“我没说”以耳语说出,句子其余部分仍保持中性语气。
- 生成后编辑:借助类似 VoiceCraft 的模型,可在音频生成后替换词语,同时保留原有声线和设置。念错一个名字时,不必整段重新生成。
Zyphra 自己也给出了重要提醒:情绪和表达参数只是目标,并非保证。调节语速也可能同时改变响度与音高;调整活跃度则可能影响音高和时长。
公开硬件实测:速度、显存,以及 Windows 的两个坑
| 测试环境 | 实测结果 | 来源 |
|---|---|---|
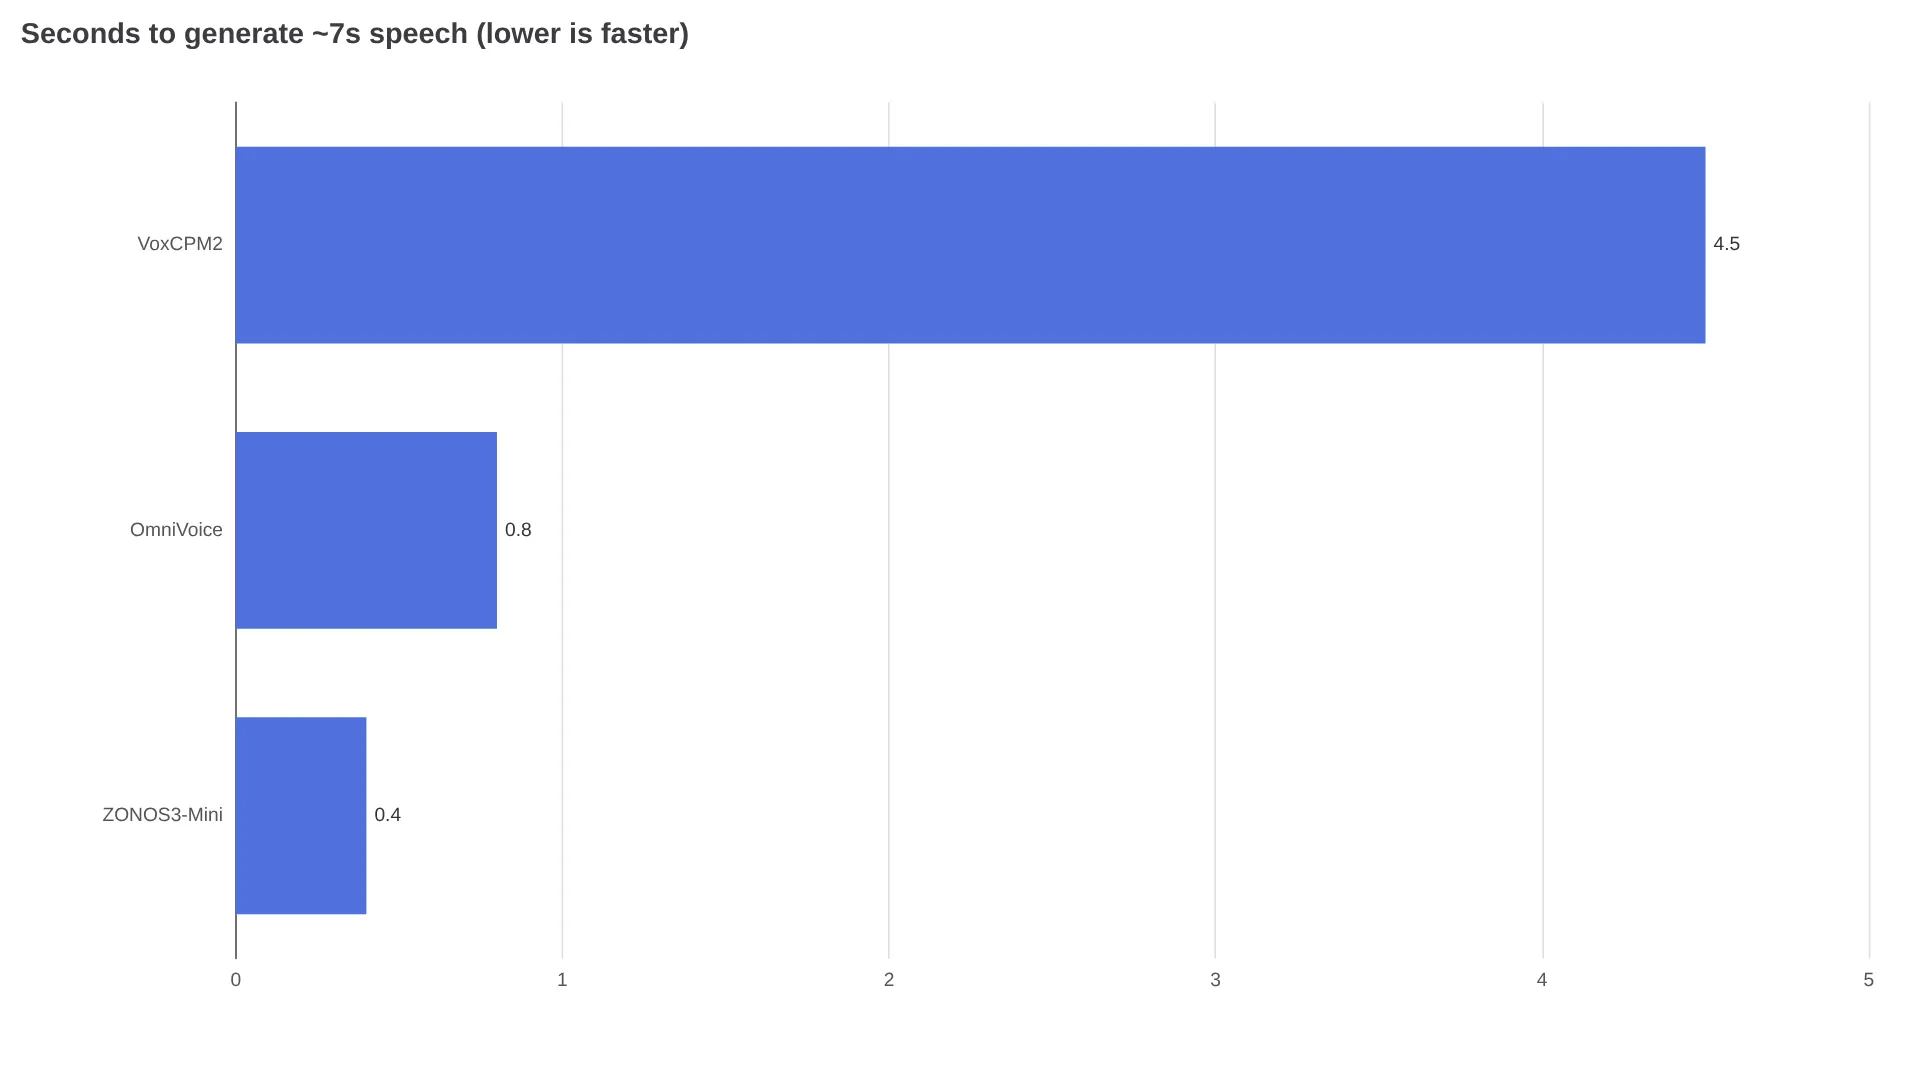
| RTX 5080,量化 ggml(0.66 GB 主干模型 + 0.45 GB 解码器) | 约 7.1 秒日语语音仅用 0.40 秒生成;总显存占用 2.4 GB,实时系数为 0.056,约为实时速度的 18 倍 | VRAM16 benchmark |
| 同一平台:31 秒文本;CPU 单独测试 7.2 秒片段 | GPU 生成耗时 1.50 秒、占用 2.5 GB;CPU 计算耗时 1.45 秒,启动到结束共 2.38 秒 | VRAM16 benchmark |
| 64 GB M5 Pro Mac mini,MLX server | 2.81 秒生成 38.5 秒音频;首音频时间为 75–100 ms;首次克隆时峰值内存约 16 GB | @pratikg |
GPU 测试的速度约为同一基准中此前 OmniVoice 测量结果的两倍,也明显领先于 VoxCPM2 的 0.63x 实时系数。
使用完整 2.2 GB 解码器后,显存占用升至 4.2 GB,但测试者无法确认是否存在可听出的质量差异。通过 Whisper large-v3 转录后,结果与目标日语和英语文本一致。这只能证明可懂度,并不能证明自然度或与参考声音的相似程度。
目前最快的本地测试报告来自一位 Apple Silicon 用户,他在 64 GB M5 Pro Mac mini 上通过 MLX server 运行:
“已完成基准测试:……最高可达实时速度的 13.7 倍。这是在我的 64GB M5 Pro Mac mini 上完成的,完全本地运行,使用他们的 MLX server:预设声音的首音频时间约为 75–100 ms。生成 38.5 秒音频片段耗时 2.81 秒。从一段 11–13 秒音频中克隆新声音后,约 1.3 秒即可开始说话。……WER 为 0–4%。只使用了几 GB 内存,首次声音克隆时峰值约为 16 GB。”—— @pratikg,发布了数据集和测试说明的真实用户
这份结果里有一个容易被忽略的前提:首次克隆的内存峰值接近 16 GB,而缓存后的克隆声音可以像预设声音一样快。如果计划批量克隆大量说话人,应按峰值而不是稳定运行时的占用来规划资源。
VRAM16 测试者还记录了 Windows 源码编译中的两个问题,并提供了补丁。首先,Microsoft 编译器不接受一个成员变量也叫 head 的 struct,而 GCC 和 Clang 可以接受。使用提供的重命名补丁后,只编译 zonos3-cli、zonos3-server 和 spk-encoder-cli。其次,日语 Windows 会以 CP932 而不是 UTF-8 传递 CLI 文本,导致生成乱码音频;程序需通过 GetCommandLineW 重新读取命令行。向 zonos3-server 发送的 JSON 请求理论上应已是 UTF-8,但尚未得到验证。
实际安装时,建议使用不含空格和非 ASCII 字符的路径,例如 C:\zonos3;安装带有 C++ 工具链的 Visual Studio 2022,以及 Git 和 FFmpeg。干净的 CUDA 环境大约需要五分钟完成配置,默认权重约 1.2 GB,本地 CUDA 还需约 2 GB 空间(安装说明)。
托管 API 怎么计费:每百万 UTF-8 字节 10 美元
托管服务提供 OpenAI 兼容语音端点:https://api.zyphracloud.com/api/v1/audio/speech。调用时使用模型 zyphra/zonos3-mini,并通过 bearer ZYPHRA_API_KEY 认证。下面的代码会启动一个本地 SGLang-Omni 服务器(SGLang cookbook),其请求格式与云端 API 相同。重点在于:你可以先对 localhost 开发原型,再把基础 URL 换成 Zyphra Cloud。
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
价格按字节而不是按字符或音频分钟计算:每 100 万 UTF-8 字节 $10.00;并发请求数为 1,每天最多 100 次生成,输入字符数不限,同时仍受前述 60/120 秒克隆上限约束。对于纯英文,按每个字符约 1 字节、每分钟口语约 800–900 个字符估算,10 美元大约可生成 1,100–1,250 分钟音频,每分钟不到 1 美分。CJK 文本的成本则明显更高,因为每个字符约占 3 字节,即按字符计算约为 3 倍。因此,中文、日文或韩文输入的每分钟成本,应使用自己的脚本进行测算。
本地或浏览器推理在购置硬件后几乎没有边际成本;托管套餐更适合原型开发和突发需求,但在 1 路并发、每天 100 次生成的限制下,不适合承载生产规模。需要高吞吐量的团队,应评估自托管 SGLang 或 vLLM 的成本,而不是直接把 10 美元的数字外推到生产场景。
对比 ElevenLabs、Fish、Qwen,以及“第一名”标签
Zyphra 的页面将 ZONOS3-Mini 与 Fish Audio、Qwen、Cartesia、ElevenLabs 和 OmniVoice 进行了对比,测试脚本包括三类:戏剧化预告片独白、用于考验一致性的长篇喜剧“straight to jail”段落,以及播客式对话文本。页面还有一张延迟与吞吐量的帕累托图。建议亲自试听这些样本。页面提供了播放器,却没有文字版胜负结论,也没有列出竞品模型版本、随机种子或统一设置的说明。
数值排名同样需要谨慎看待。Zyphra 的 ZTTS2-Eval 覆盖 35 种干净语言和 20 种真实环境语言,共有 420 项“指标 × 数据集 × 语言”评测条目;其 Capability Index 将 ZONOS3-Mini 排在开源模型第一,领先 Fish S2 Pro 和 MOSS TTS v1.5。不过,这是厂商基于自己设计的新测试来评价自己的产品。方法已经公开,但截至本文发布时,未找到独立复现结果;闭源模型的比较也只有音频样本,没有共享评分。
由于 Zyphra 没有提供分语言分数,也没有独立盲听胜率,普通话声调准确性、日语高低音重音、多音字处理以及长文本情绪表现都还未经证实。投入生产前必须自行测试。更客观的结论是:ZONOS3-Mini 在效率和部署灵活性上表现领先,但其质量领先地位尚未得到验证。
哪些团队现在值得切换
| 团队类型 | 建议 | 理由 |
|---|---|---|
| 离线、端侧或隐私敏感场景(游戏、阅读器、自助终端) | 现在就测试 | Apache 2.0、默认下载仅 1.2 GB、2.4 GB 显存可运行、CPU 也可用、没有按分钟计费 |
| 需要大量角色声音的有声书或 NPC 工作流 | 先试点 | 词级控制和生成后编辑可减少重渲染成本,但需逐个验证说话人的克隆相似度 |
| 非英语生产场景,尤其是中文 | 等完成自己的评测再决定 | 厂商没有分语言成绩;在测试多音字和声调前,词错误率与韵律相关说法仍偏向英语 |
| 高并发托管 TTS | 自托管或维持现状 | 云端套餐限制为 1 路并发、每天 100 次生成;真正适合生产的路径是 SGLang/vLLM |
| 需要水印或审计链路的团队 | 暂缓 | 发布材料未说明参考音频的水印机制或数据保留政策 |
推荐按这个顺序测试:浏览器 Playground、性能最弱设备上的本地部署、最后才是托管 API。只有当你的硬件满足 2.4 GB 显存和 WebGPU 要求,并且你的语言通过盲听测试时,才考虑切换;否则继续使用现有闭源 API,等独立多语言基准测试出现后再重新评估。
常见问题
ZONOS3-Mini 需要多少显存?
在已测试的 RTX 5080 环境中,总占用约为 2.4–2.5 GB;使用完整解码器时为 4.2 GB;Mac 首次克隆的内存峰值约为 16 GB。
它能在浏览器或 CPU 上运行吗?
可以。浏览器通过 WebGPU 运行,首次访问需下载约 920 MB;已公开的一项测试中,CPU 单独合成算上启动时间约为实时长度的三分之一。
声音克隆质量如何?
支持最长 60 秒的零样本克隆,无需转录文本;一项独立测试报告词错误率为 0–4%,但不同说话人的相似度仍需自己盲听验证。
可以用于商业用途吗?
权重采用 Apache 2.0,代码采用 MIT 许可;但克隆任何声音前,你都必须拥有相应权利或获得本人同意。
API 端点和价格是多少?
使用 OpenAI 兼容的 POST https://api.zyphracloud.com/api/v1/audio/speech,模型为 zyphra/zonos3-mini;价格为每 100 万 UTF-8 字节 $10,并限制 1 路并发、每天 100 次生成。
延伸阅读:Best Text-to-Speech API、Best Voice Cloning API 2026、Kokoro 82M TTS Local Guide