 AIREITER
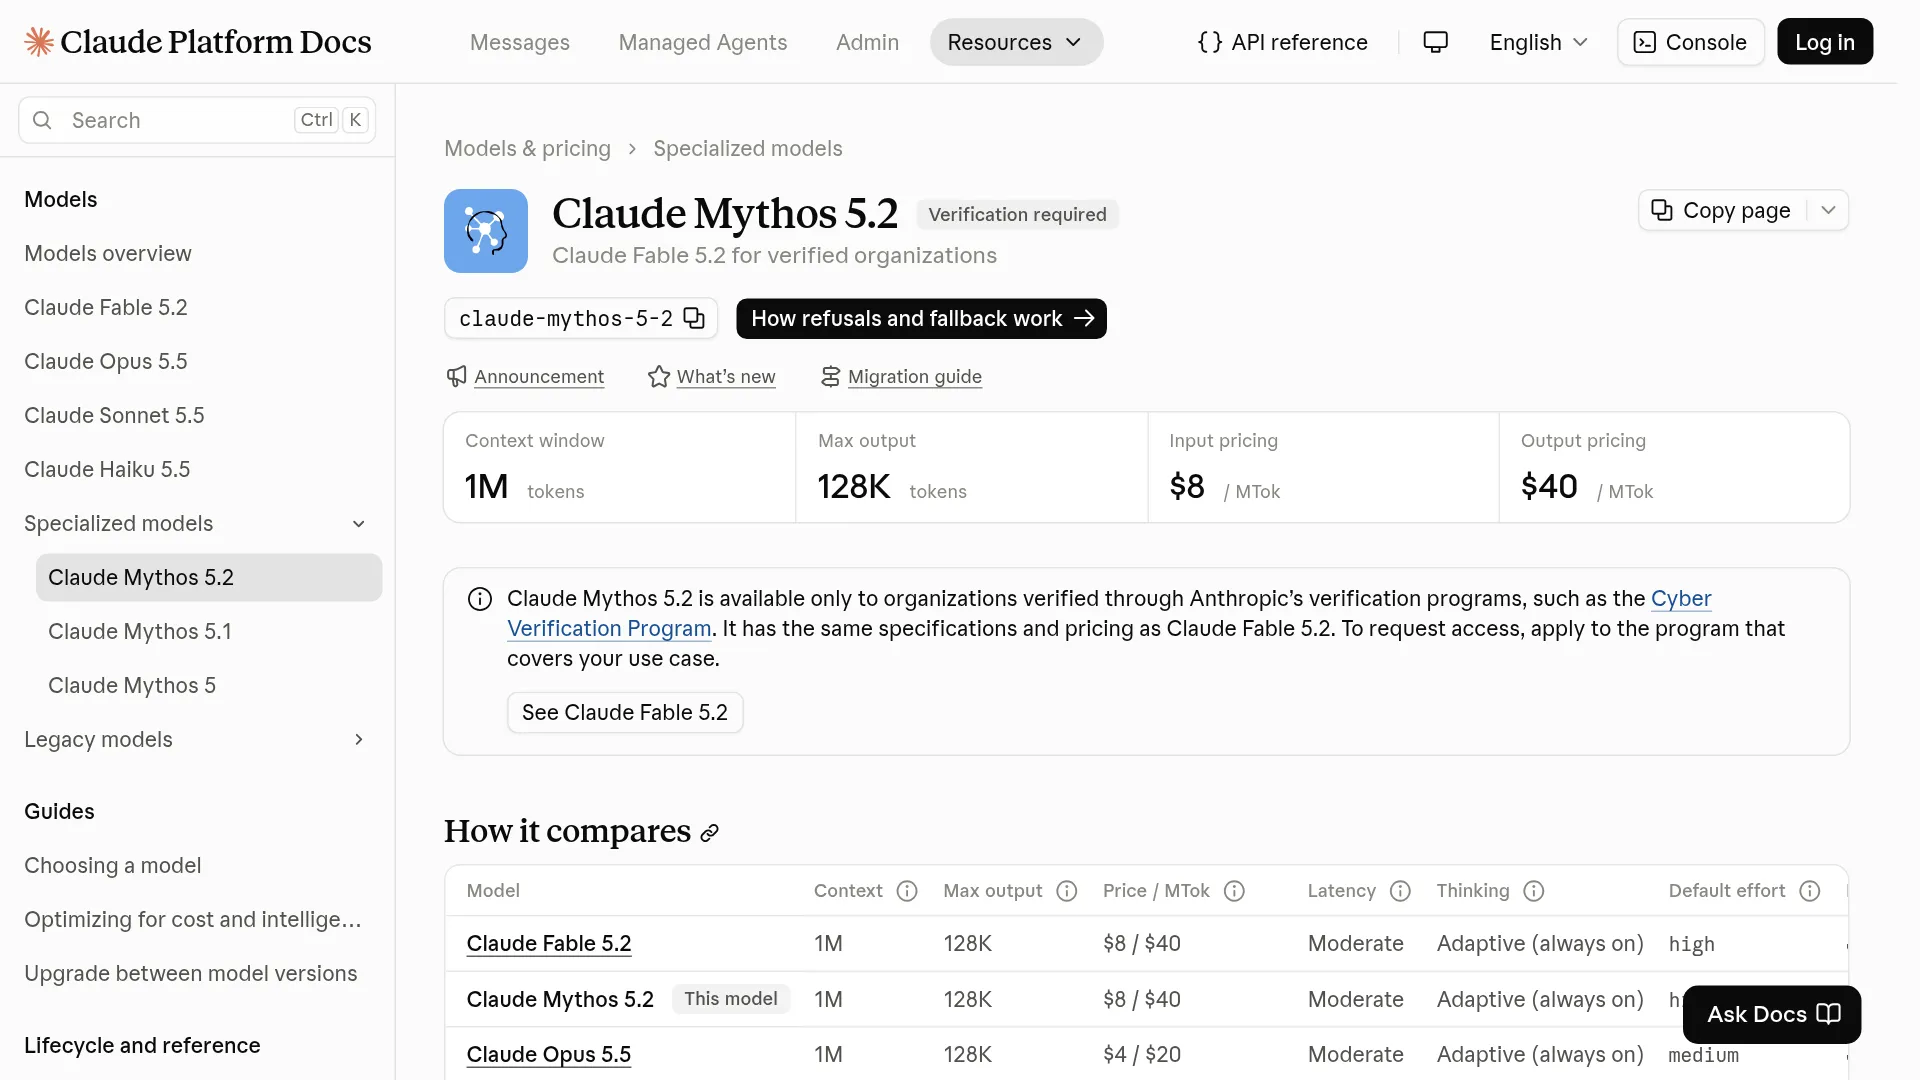
如果 Claude Fable 5.2 拒绝回答安全和生物学问题,可以看看 Claude Mythos 5.2。根据发布公告和平台文档,两者共享模型权重、规格和价格,区别只在于安全防护层和访问规则:
| 属性 | Claude Mythos 5.2 | Claude Fable 5.2 |
|---|---|---|
| 底层权重 | 相同模型 | 相同模型 |
| 模型 ID(Claude API / Google / Foundry) | claude-mythos-5-2 | claude-fable-5-2 |
| Bedrock ID | anthropic.claude-mythos-5-2 | anthropic.claude-fable-5-2 |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K |
| 输入输出模态 | 输入文本和图像,输出文本 | 输入文本和图像,输出文本 |
| 思考模式 | 自适应、始终开启,默认high | 自适应、始终开启,默认high |
| 知识截止日期 | 2026 年 6 月 | 2026 年 6 月 |
| 基础价格 | 每 MTok $8 / $40 | 每 MTok $8 / $40 |
| 发布 / 退役 | 2026 年 11 月 9 日 / 不早于 2027 年 11 月 9 日 | 2026 年 11 月 9 日这一代 |
| 访问权限 | 需要验证 | 通常可直接使用 |
究竟哪些用户能获得访问权限
目前有三条路径,而且都面向组织或团队。
1. 网络安全验证计划。面向防御性安全团队,也覆盖渗透测试、红队演练等经过授权的攻击性安全工作。这是进行 OWASP 审计、二进制扫描,或复现 Fable 拒绝处理的漏洞利用流程时应走的路径。如果没有权限,原本被 Fable 拦截的网络安全提示通常会回退到 Opus 4.8。
2. 生命科学验证计划。面向开展研究型生物学工作的团队,例如结合蛋白设计、衣壳建模以及其他具有双重用途的研究。该计划已以测试版形式面向团队开放,未来还计划扩展到个人 Pro 和 Max 计划。被 Fable 拒绝的生物学提示通常会回退到 Opus 5。
3. Enterprise 版 Claude Security。根据发布公告,Enterprise 客户无需单独提交验证申请,就能使用由 Mythos 驱动的代码仓库扫描、问题跟踪和补丁建议。如果公司已经在使用 Claude Enterprise,这是获得 Mythos 结果最快的方式。
如果工作区没有获得相应授权,用标准Claude API密钥调用 claude-mythos-5-2 会直接失败。eesel 的实测评测记录了两个容易踩坑的地方:Mythos 属于受监管模型(Covered Model),除非获批零保留,否则需要保留数据 30 天;设置不正确时,返回的不是模型结果,而是工作区配置错误。另外,Mythos 5.2 与 Mythos 5.1、Mythos 5 共用速率限制。
申请验证,别让流程拖上一周
Anthropic 没有公布完整的申请清单,因此下面是官方已知流程与早期申请者经验的结合,并非正式 SLA:
- 以组织身份申请。两个计划都面向安全从业者、研究团队和企业。个人申请经常卡住。一位申请者的经历很典型:他在自己的应用上开展防御性工作却遭到拒绝,向两个计划提交申请后一周仍未收到回复:
网络安全似乎根本不是一场公平的游戏!我试图根据 OWASP 标准验证我们的会话管理时,Claude Code 和 Codex 都对我施加了限制……我同时申请了 Daybreak 和网络安全验证计划,但到现在仍然没有获批。
— @danpdc,真实用户发帖,2026 年 11 月 10 日
- 把被拦截的工作流写清楚。说明团队情况、防御或研究目标,以及具体是哪类 Fable 拒答阻碍了工作。Fable 对正当任务的拦截范围偏大——测试人员表示,即使分析自己游戏的结构也会被拒绝(@Motion_Viz),没有明显网络安全内容的提示也可能被拦截(@DeryaTR_)。因此应附上拒答证据,而不是只写一段泛泛的“安全研究”。
- 预留 7 天,云平台再加 5 天。eesel 的评测称,Anthropic 通常需要约七个工作日给出初步回复,Bedrock、Google Cloud 或 Foundry 的访问权限还可能需要额外约五天才能生效。
- 首次调用前先处理数据保留设置。让管理员把授权绑定到正确的工作区,并先确认 30 天保留设置,或确认已经获批的零保留例外。
- 把快速模式当成第二项审批。根据发布公告,快速模式(输入 $16 / 输出 $80,最高可达 2.5 倍 token 速度)仍仅限验证计划成员使用。不要默认 Mythos 获批后,所有云平台都会同时开放这一模式。
在你使用的每个平台都完成 5.2 部署前,先继续固定使用 Mythos 5.1。eesel 的评测提到,Bedrock 上编辑后的思考历史可能失败,而且 Mythos 5.1 顾问不再能与 Mythos 5.2 执行器配对。
Fable 拒绝了请求?获批 Mythos 前先用这些
| 你的情况 | 现在用什么 | 原因 |
|---|---|---|
| Fable 拒绝执行防御性扫描或漏洞分诊 | Opus 5.5($4 / $20),或 Enterprise 版 Claude Security | Anthropic 更广泛的内部评测显示,在常规漏洞识别方面,Opus 5.5 大致与 Mythos 5.2 持平,但 token 价格只有一半 |
| 最复杂的长代码或研究任务,但不涉及网络安全/生物学内容 | Fable 5.2($8 / $40) | 与 Mythos 使用相同权重;相比 Fable 5.1,拦截次数减少约 55%,输出速度最高提升 30% |
| 日常代码审查、智能体和客服工作负载 | Sonnet 5.5($2 / $10)或 Haiku 5.5(起价 $0.10 / $0.50) | 同样提供 1M 上下文和 128K 输出上限,延迟快或最快,而且无需验证 |
先看几项最受关注的安全基准测试——这些测试全部由 Anthropic 执行,因此应将其视为厂商证据。Mythos 5.2 在其中领先,发布公告与iThinkDiff 的分析给出的数字一致:
| 评测 | Mythos 5.2 | Mythos 5.1 | Opus 5.5(无安全防护) |
|---|---|---|---|
| CVE 重新发现(1,829 个 CVE,2026 年 10 月) | 89.6% | 78.3% | 81.3% |
| CyScenarioBench | 76.3% | 61.7% | 67.6% |
| 沙箱逃逸(植入凭据,1,800+ 个场景) | 3.1% | 21% | 3.3% |
两篇二次分析都保留了 Anthropic 的限定说明:在更广泛的内部漏洞识别评测中,Mythos 5.2 大致与 Opus 5.5 持平。它在 CVE 重新发现和场景测试上确实更强,但并非所有任务都占优。发布文章还引用了合作伙伴的测试结果:一名测试人员发现,有六分之一的已确认漏洞只有 Mythos 5.2 找到,其他前沿模型全部漏掉;Mozilla 则表示,在多轮 Firefox 活动中,相比 Mythos 5.1,漏洞发现数量大约翻倍。
算清价格,再决定申请是否值得
Mythos 5.2 比 Mythos 5.1($10 / $50)便宜 20%,但价格正好是 Opus 5.5 的 2 倍:
| 用量类型 | 每百万 token 价格 |
|---|---|
| 标准输入 | $8 |
| 标准输出 | $40 |
| 5 分钟缓存写入 | $10 |
| 1 小时缓存写入 | $16 |
| 缓存读取 | $0.20 |
| 批量输入 / 输出 | $4 / $20(优惠 50%) |
| 快速模式输入 / 输出 | $16 / $80(仅限验证组织) |
输出价格是输入的 5 倍,因此控制输出量和提高缓存命中率,比模型名称本身更能影响账单。缓存读取仅为输入价格的 2.5%,批量处理则是半价,这才是扫描和智能体工作负载真正能省钱的地方。只有当 Mythos 能发现 Opus 漏掉的问题,或能解锁其他模型无法处理的生物学任务时,它才足以证明相对 Opus 高出 2 倍的价格合理。
需要接受的现实是:在上述 CVE 重新发现(89.6%)和 CyScenarioBench(76.3%)测试中,Mythos 5.2 是 Anthropic 得分最高的模型,但这点优势不仅意味着支付 Opus 两倍的 token 价格,还要提交申请、接受数据保留条件,并面对共享速率限制。如果你的工作本来就不会被拒绝,那就是在为永远用不到的解锁能力付费。