 AIREITER
同一段 200,000 token 的上下文读取 100 次,在 Claude Fable 5 的缓存费率下要花 $20;换成 Fable 5.1 后则只需 $5。此次调价的重点就在这里:输入仍是每百万 token $10、输出仍是 $50,但重复读取上下文的成本降低了 75%。
Claude Fable 5.1 API 最新价格一览
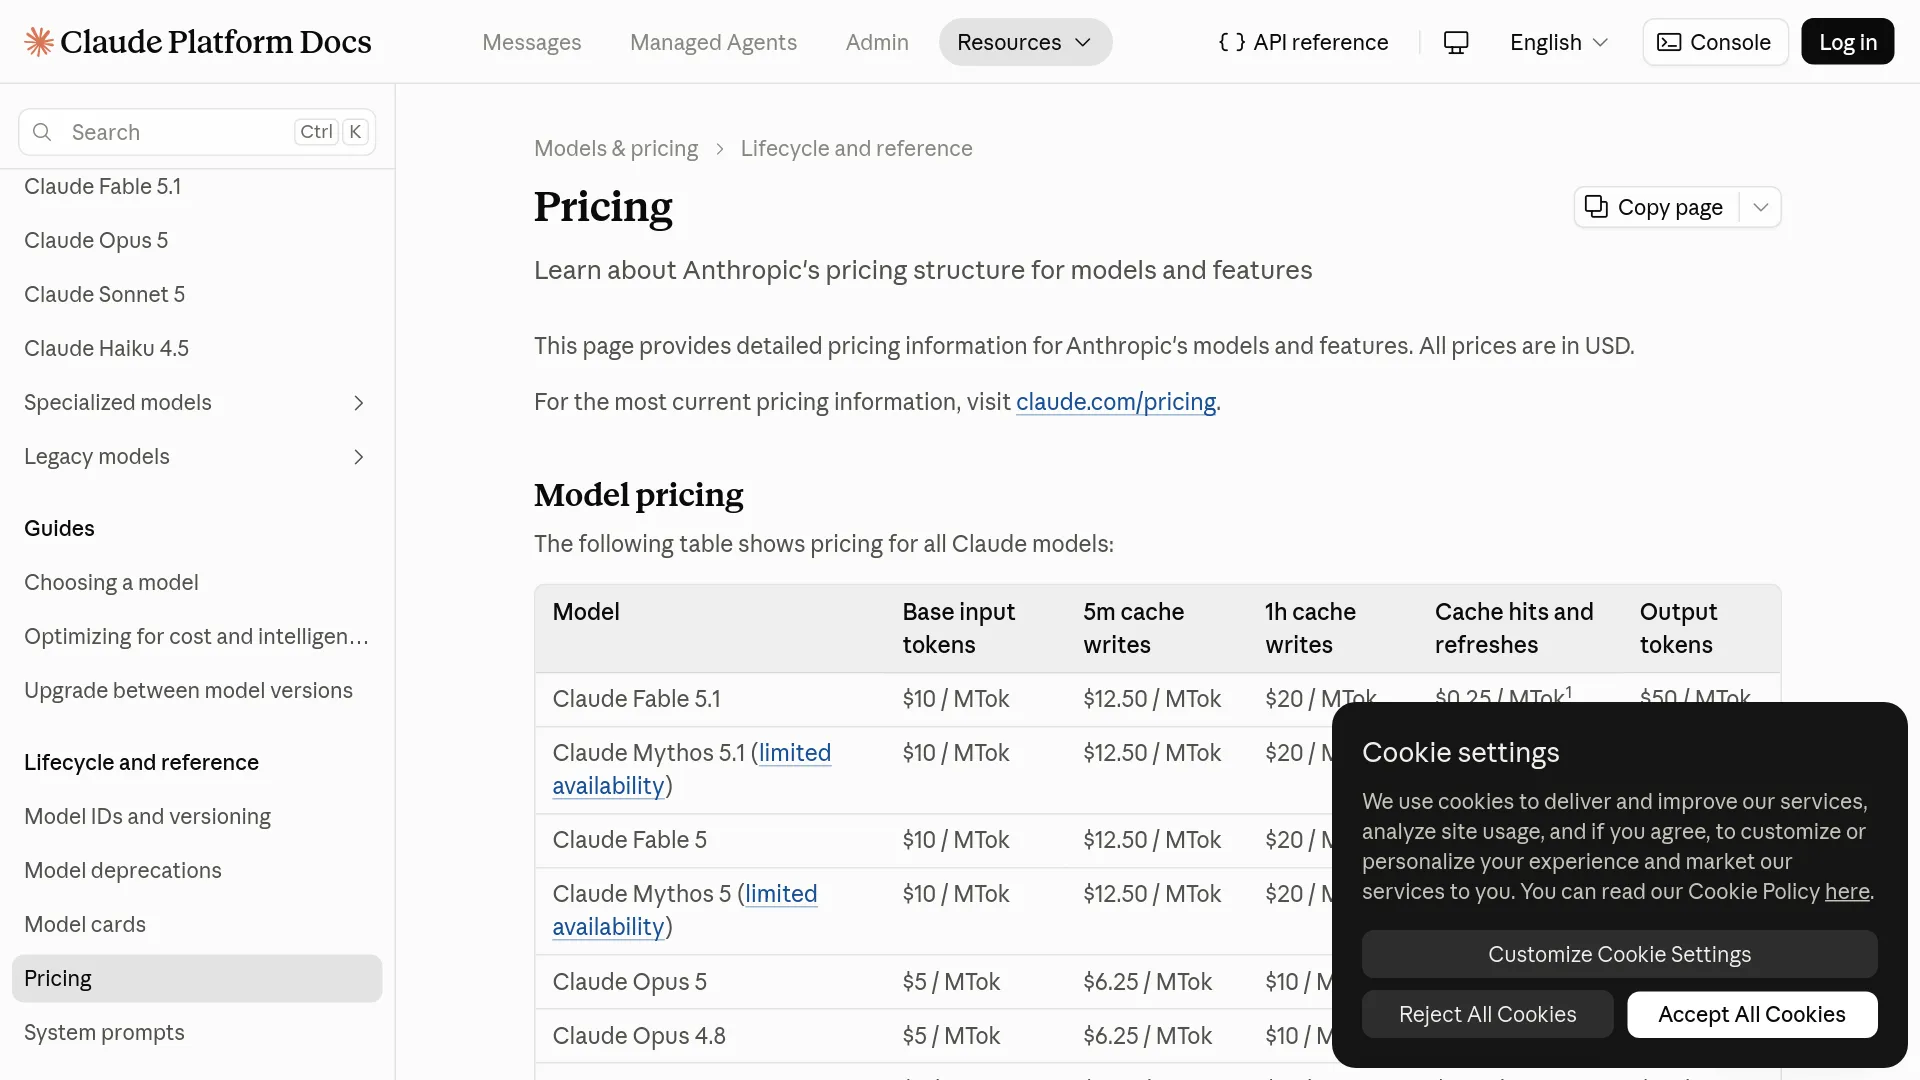
Claude Fable 5.1 的价格为:输入每百万 token $10,输出每百万 token $50。5 分钟和 1 小时缓存写入价格维持不变,分别为每百万 token $12.50 和 $20;缓存读取则降至每百万 token $0.25。
Anthropic 已在官方 Claude Fable 5.1 发布公告及实时更新的 Claude Platform 定价文档中列出该模型。其 API 模型名称为 claude-fable-5-1。
| 模型 | 输入 / MTok | 5 分钟写入 / MTok | 1 小时写入 / MTok | 缓存读取 / MTok | 输出 / MTok |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $12.50 | $20.00 | $0.25 | $50.00 |
| Claude Fable 5 | $10.00 | $12.50 | $20.00 | $1.00 | $50.00 |
| Claude Opus 5 | $5.00 | $6.25 | $10.00 | $0.50 | $25.00 |
| Claude Sonnet 5 | $2.00 | $2.50 | $4.00 | $0.20 | $10.00 |
表中价格单位均为美元/百万 token,即 MTok。Fable 5.1 的缓存读取费率是 Anthropic 常规 0.1× 缓存读取系数之外的例外:$0.25 相当于其 $10 基础输入价格的 0.025×。
相比 Claude Fable 5,到底变了什么
Claude Fable 5.1 并非全面降价 75%。输入、输出和缓存写入价格都与 Fable 5 一致,唯一调整的是缓存读取:从每百万 token $1 降至 $0.25。
这一差别很关键,因为输出仍按每百万 token $50 计费。即使可复用提示词获得大量缓存命中,包含长推理过程、大型代码补丁或反复工具结果的工作负载,成本依然可能很高。
只有当较大的稳定前缀在多轮模型调用中被反复读取、形成缓存命中时,节省才会显现。短提示词的一次性请求几乎不会受益;而持续重读相同上下文的长运行智能体,则能显著降低输入侧账单。
缓存读取 $0.25:哪些场景省得最明显
Anthropic 的提示词缓存文档定义了以下几类操作:
| 操作 | Fable 5.1 价格 | 缓存时长或条件 |
|---|---|---|
| 未缓存输入 | $10.00 / MTok | 按常规方式处理 |
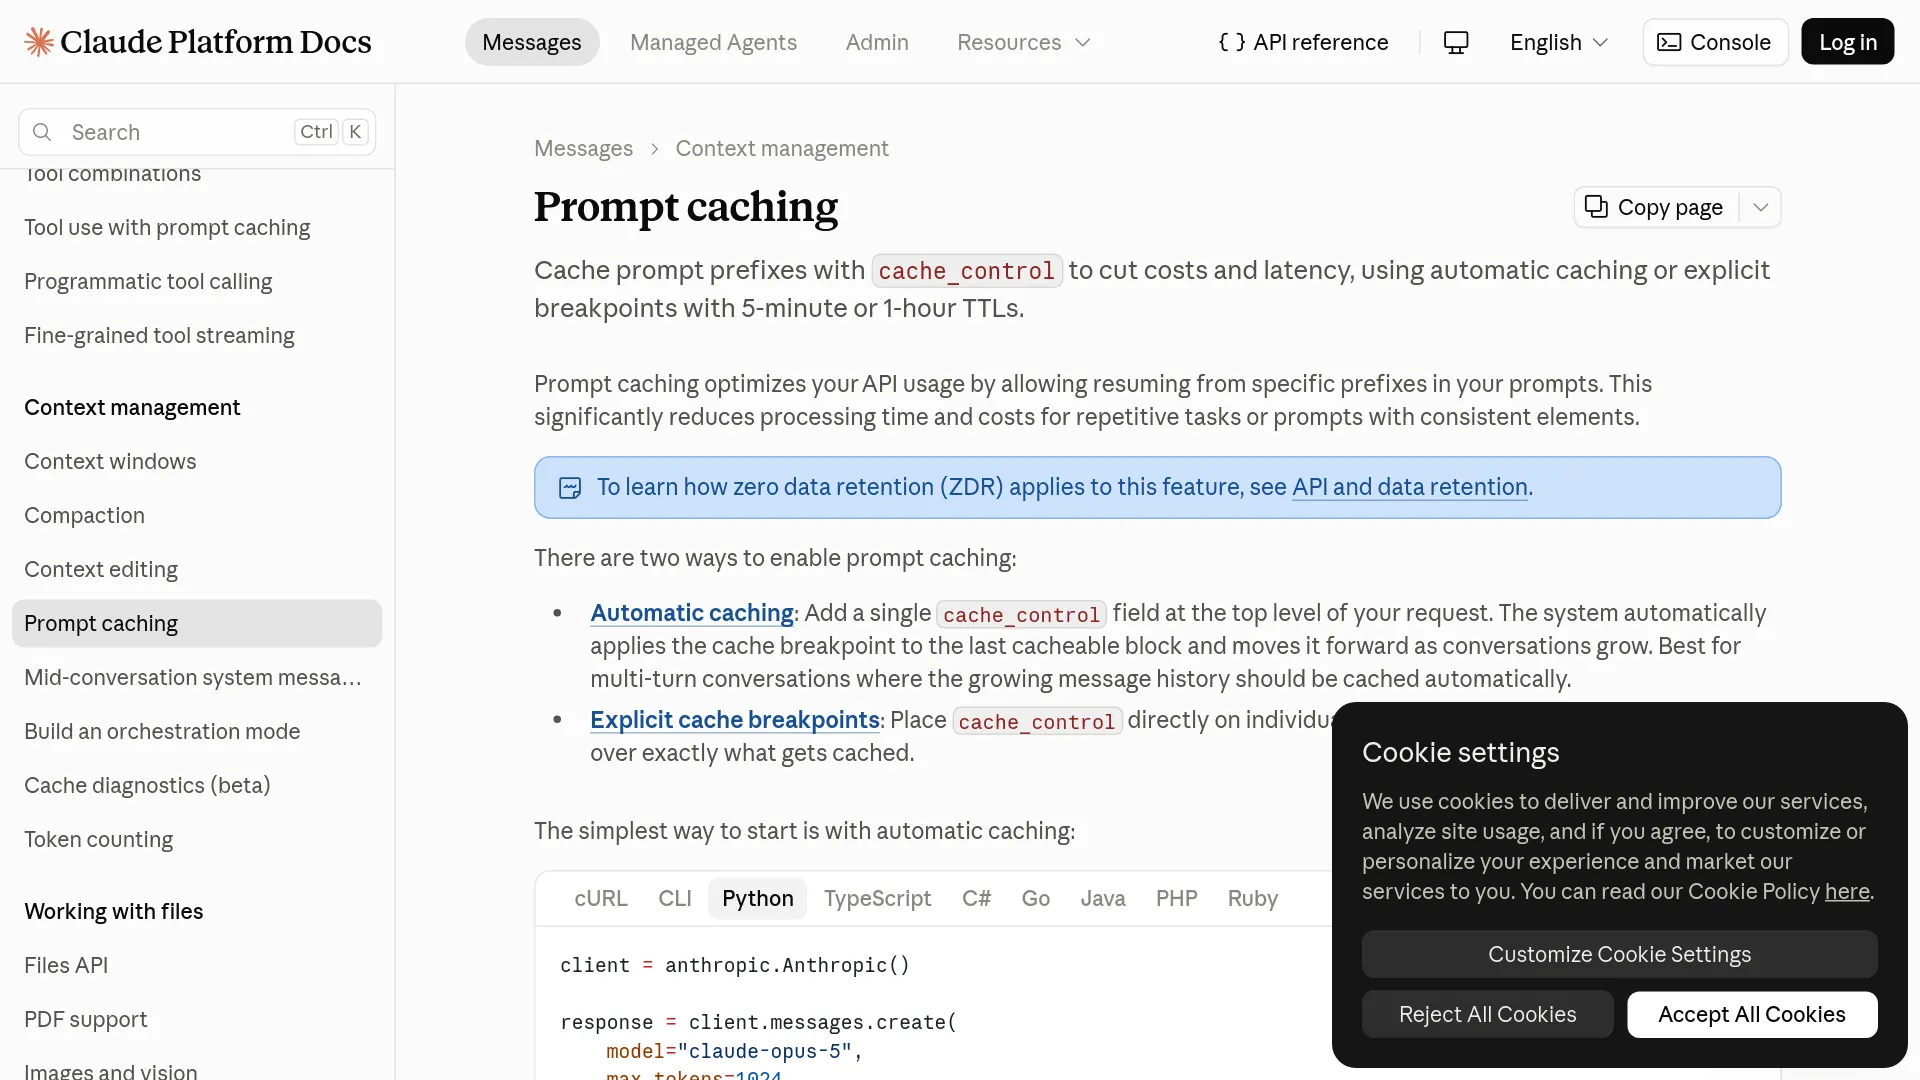
| 5 分钟缓存写入 | $12.50 / MTok | 基础输入价格的 1.25× |
| 1 小时缓存写入 | $20.00 / MTok | 基础输入价格的 2× |
| 缓存读取或刷新 | $0.25 / MTok | 基础输入价格的 0.025× |
默认缓存时长为 5 分钟。读取缓存会刷新条目,且不会额外收取刷新费用;Anthropic 也支持时长为 1 小时、但写入价格更高的缓存。Fable 5.1 的可缓存提示词最短长度为 512 token:不足该长度的提示词会不经过缓存直接处理,而不是报缓存错误。
缓存断点会覆盖此前可复用的前缀内容。稳定不变的工具定义、系统指令、示例和背景上下文,应放在每次变化的用户请求之前。如果把时间戳或单次请求专用指令放进缓存前缀,变化的内容就可能导致缓存未命中并产生新的写入。
计算示例:200,000 token 读取 100 次
假设一个智能体在后续 100 次请求中反复使用一段 200,000 token 的前缀,那么缓存读取总量为 2,000 万 token。
| 缓存读取费率 | 计算方式 | 缓存读取成本 |
|---|---|---|
| Claude Fable 5 | 20 × $1.00 | $20.00 |
| Claude Fable 5.1 | 20 × $0.25 | $5.00 |
仅缓存读取这一项可节省$15,即 75%。本例不包括首次缓存写入、未缓存的请求内容、输出 token、工具费用、税费、区域系数和重试费用。这只是一个成本组成部分的对比,并不意味着整个智能体任务一定会少花 $15。
一位用户的讨论也聚焦于这一工作负载层面的影响:
“缓存读取现在便宜了 75%,即每百万 token $0.25。这影响大得多……” — u/ProfessionalJackals,r/ClaudeAI
缓存写入用得不当,省下的钱也会被吃掉
对于同一段 200,000 token 的前缀,按 Fable 5.1 公布的费率,5 分钟缓存写入需 $2.50,1 小时缓存写入需 $4.00。如果缓存会在下一次请求到来前失效,就可能再次触发写入。
对这段前缀而言,只要在 5 分钟内有一次后续缓存命中,使用缓存就比两次未缓存读取更便宜。1 小时选项从第二次后续复用开始更划算:$4.00 的写入费加上两次各 $0.05 的读取费,低于三次未缓存读取各 $2.00 的成本。
缓存时长应当匹配实际流量模式:
- 相同前缀会在短暂交互间隔内复用时,选择 5 分钟时长。
- 请求之间间隔较长、但仍属于同一工作会话时,选择 1 小时时长。
- 对于一次性请求,或间隔过长而无法在过期前再次读取前缀的请求,跳过缓存。
- 不要想当然地认为标记了缓存的区块就会命中;应在使用数据中检查
cache_creation_input_tokens和cache_read_input_tokens。
别只看标价:完整账单还包含什么
Claude Fable 5.1 API 按 token 计费,但工具调用请求的可见回答只是成本的一部分。Anthropic 表示,工具定义、工具调用区块、工具结果区块以及专用的工具系统提示词,都会增加输入 token;服务端工具还可能产生单独的使用费用。
| 成本因素 | Fable 5.1 预算中应纳入的内容 |
|---|---|
| 未缓存输入 | 系统提示词、对话记录、文件、工具 schema 和新增上下文,按 $10 / MTok 计费 |
| 缓存输入 | 在使用数据中被记录为缓存读取的可复用合格前缀,按 $0.25 / MTok 计费 |
| 输出 | 可见输出,以及可计费的推理/输出 token,按 $50 / MTok 计费 |
| 网页搜索 | 每 1,000 次搜索 $10,另加搜索上下文的 token 费用 |
| Batch API | 异步任务的输入和输出 token 价格享受 50% 折扣 |
| 仅限美国的推理 | 适用的输入、输出、缓存写入和缓存读取费用乘以 1.1× |
| 云平台路由 | AWS、Google Cloud 和 Microsoft Foundry 可能采用各自公布的计费机制 |
根据 Anthropic 的定价文档,Batch 折扣、缓存价格与数据驻留系数可以叠加。Fast mode 是面向受支持 Opus 模型的独立研究预览功能,并不是 Fable 5.1 的加速捷径。
估算成本时,不能只盯着最终生成的文字,还要计算输出、推理、工具和上下文 token。比如输出 500,000 token,仅输出部分就需 $25,可能高于前述 $15 的缓存读取节省。
生产环境中可使用如下估算公式:
预估成本 = 未缓存输入
         + 缓存写入
         + 缓存读取
         + 输出/推理 token
         + 服务端工具费用
         + 路由或地域系数
API 接入与迁移前检查
请使用准确的模型 ID:claude-fable-5-1,并确认当前供应商已开放该模型。官方公告称 Fable 5.1 可通过 Anthropic 平台和主流云平台路由使用,但模型出现在 Anthropic 目录中,不代表每个合作伙伴路由都提供完全相同的可用性、限制或计费方式。
在调整生产集成前,建议先在预发布环境完成以下检查:
- 通过供应商的实时模型目录或路由专属文档,确认返回的模型 ID。
- 针对固定测试集,记录输入、缓存写入、缓存读取、输出和工具使用量。
- 测试既有的
tool_choice设置与结构化输出路径。 - 测试包含先前 thinking 区块的多轮对话。
- 测试从 Fable 5.1 回退到低成本模型的路由,确保不会悄然丢失所需状态。
- 测试任何会在轮次之间修改历史消息、系统提示词或工具定义的代码。
- 迁移后比较每个被接受任务的成本,而不只看 token 单价。
Anthropic 指出,新 API 账户无法在保留 Claude 先前 thinking 记录的同时手动编辑历史上下文。应在预发布环境验证这一行为;不要假定每个 Fable 5.1 请求都会失败。
Fable 5.1 什么时候值得多花钱
如果工作负载会反复处理大上下文,能获得足够多的缓存命中,并且评测中被接受任务的改进足以抵消更高的基础 token 价格,那么可以选择 Claude Fable 5.1。对于一次性、输出密集、对延迟敏感,或 Sonnet 5 已足够胜任的任务,则应继续使用成本更低的模型;Opus 5 的名义成本也更低,输入为每百万 token $5、输出为 $25。
使用一组具有明确验收标准的小型评测集,并对比以下指标:
| 指标 | 为何会影响决策 |
|---|---|
| 成功运行次数 | 一次更便宜但失败的运行,未必意味着完成工作更便宜 |
| 输出 token | Fable 5.1 的输出价格是其基础输入价格的五倍 |
| 缓存读取占比 | $0.25 费率只适用于被记录为缓存命中的部分 |
| 工具调用轮次 | 额外轮次会增加 token、延迟及潜在的服务端工具费用 |
| 人工修正时间 | 需要更少返工的模型,任务总成本可能更低 |
| 路由与地域 | 合作伙伴计费和仅限美国的推理都会改变最终账单 |
不要将 API 价格与 Claude Pro 或 Max 的订阅限额混为一谈。$0.25 是 API 的缓存读取费率;Anthropic 的公告并未表示订阅消息限额或使用额度会降低 75%。
常见问题
100 万 token 上下文窗口,是否意味着有 100 万免费 token?
不是。上下文窗口只是容量上限,其中的 token 仍会按供应商规定的输入、缓存和输出类别计费。
缓存折扣适用于 Claude Pro 或 Max 吗?
不适用。除非有针对具体计划的说明,否则不应将 API 定价规则套用到订阅计划。$0.25 是 API 缓存读取价格,不是已公布的 Pro 或 Max 限额变更。
如何确认请求是否用了缓存?
检查响应中的使用量字段,尤其是 cache_creation_input_tokens 和 cache_read_input_tokens。仅有 cache-control 标记,并不能证明请求满足最短长度要求,或与此前的缓存前缀匹配。
应该立刻用 Claude Fable 5.1 替换 Claude Fable 5 吗?
不应该。先运行一套固定的预发布评测,测量缓存命中率和输出 token,再与现有模型及路由比较每个被接受任务的成本,之后再切换生产流量。