 AIREITER
一个能读取文件、运行测试并反复修改的编码 Agent,每解决一个问题通常会消耗 50,000 到 200,000 个 token。按 GPT-5.6 Sol 每百万输出 token 30 美元的价格计算,光输出 token,一项任务就要花费 1.50 到 6 美元。DeepSeek V4 Pro 的标价是每百万输出 token 0.87 美元,成本约为前者的 1/34;不过,它在多步骤任务中的可靠性,还没有像 Claude 或 GPT 那样经过同等深度的独立基准测试。下面将从公开编码基准、已核实的 API 价格、上下文限制,以及适合的 Agent 工作流几个维度,对六款模型进行比较。
2026 年阵容:适合编码 Agent 的六款模型
每款模型都结合了官方或榜单来源的基准数据,以及 2026 年 8 月核实的 API 价格。如果目标模型没有公开的准确得分,文中会引用最接近的可用版本,并明确标注为代理数据。
1. Claude Opus 5——质量上限
Claude Opus 5 延续了 Claude 家族在官方 SWE-bench Verified 榜单上的领先地位。前代 Claude 4.5 Opus 在 mini-SWE-agent 测试框架下拿到 76.8%,这个成绩可以作为 Opus 5 预期水平的参考,不过目前还没有 Opus 5 专属的 SWE-bench Verified 得分。Opus 5 提供 100 万 token 上下文窗口,最大输出为 128K token。它的价格是每百万输入 token 5 美元、输出 token 25 美元,是本文主流选项中最贵的一款。如果一次失败的多文件重构会耗费更多工程师时间,而不是更多 token 费用,Opus 5 值得优先考虑;但对于高频、常规的修改任务,它并不划算。
2. GPT-5.6 Sol——终端任务专家
GPT-5.6 Sol(模型 ID 为 gpt-5.6-sol)的价格是每百万输入 token 5 美元、输出 token 30 美元,并配备 105 万 token 上下文窗口。根据 xAI 发布的基准对比,GPT-5.6 Sol Max 在 Terminal-Bench v3.0 中以 34.6% 领跑(Grok 4.6 为 26%),在 DeepSWE v1.1 中则达到 73%。对于依赖终端操作的 Agent 循环,这两项测试尤其值得参考。代价也很明确:Sol 的输出价格为每百万 token 30 美元,是本次阵容中最贵的模型。OpenAI 还公布了 Sol 64.6% 和 Terra(中端版本)63.4% 的 SWE-bench Pro 得分;如果任务没那么复杂,后者可以作为更便宜的 OpenAI 选项。
3. Grok 4.6——适合长时间运行的高性价比选择
Grok 4.6 于 2026 年 8 月 12 日发布,定位就是长时间运行的 Agent 工作流。根据 xAI 的公告,它在 Artificial Analysis Intelligence Index 上以 61 分追平 GPT-5.6 Sol Max,并在 CursorBench v3.2(69.9% 对 67.2%)、FrontierCode v1.1(61.3% 对 60.6%)和 APEX-Agents(57.5% 对 56.7%)中超过后者。它的价格为每百万输入 token 2 美元、输出 token 6 美元;基准表现接近 GPT-5.6 Sol Max,但输出成本约只有后者的五分之一。短板在于纯终端执行能力:它在 Terminal-Bench v3.0 中的得分为 26%,明显落后于 Sol Max 的 34.6%。如果你的 Agent 主要在 IDE 中工作(例如 Cursor、Grok Build),而不是以终端为中心,Grok 4.6 是本文性价比最突出的选择。“fast”版本会将价格提高到 4/12 美元,以换取更低延迟。上下文窗口为 500K token。
4. DeepSeek V4 Pro——预算型主力
DeepSeek V4 Pro 是目前可通过 API 使用的最便宜前沿级模型:每百万输入 token 0.435 美元、输出 token 0.87 美元,缓存输入价格更低至每百万 0.003625 美元。它拥有 100 万 token 上下文窗口和 384K token 最大输出,足以应对仓库级任务。目前还没有公开的多步骤 Agent 基准,以同等测试框架深度将 DeepSeek V4 Pro 与 Claude 或 GPT 进行比较。因此,在把它用于复杂重构前,最好先在自己的环境中验证长时间会话里的工具调用可靠性。对于预算紧张的团队,或作为路由架构中的首轮模型,它的经济性非常强;但面对最复杂的多文件重构,如果可靠性比 token 成本更重要,仍应准备好升级到其他模型。
5. Gemini 3.1 Pro——超大上下文阅读器
Google 的 Gemini 3.1 Pro Preview 在提示词低于 200K token 时,价格为每百万输入 token 2 美元、输出 token 12 美元;超过这一门槛后,价格上升到 4/18 美元。它最突出的能力是上下文容量:Gemini 的 200 万 token 上下文窗口是本文所列模型中最大的,适合一次性加载整个代码库进行整体阅读。作为 3.1 Pro 预期水平的参考,Gemini 3 Flash 在 Tembo 于 2026 年 6 月发布的快照中,SWE-bench Verified 得分为 75.8%,仅次于 Claude 4.5 Opus。目前,Gemini 在长时间 Agent 循环中的工具调用一致性,还没有经过与 Claude 或 GPT 同等深度的测试;部署多步骤工作流前,应先在自己的测试框架中验证。
6. Kimi K3——开放权重 Agent 方案
Moonshot AI 推出的 Kimi K3 在同一份 2026 年 6 月快照中取得 70.8% 的 SWE-bench Verified 得分,在开放权重模型中低于 GLM-5(72.8%)和 MiniMax M2.5(75.8%)。作为开放权重模型,它可以部署在团队自己的环境中,适合源代码不能离开内网的场景。Moonshot 也提供 K3 的托管 API,但具体价格取决于部署配置。对于拥有足够 GPU 硬件的本地 Agent 环境,K3 搭配 OpenCode 这样的轻量级框架,可以在不按 token 支付 API 费用的情况下,提供有能力的编码 Agent。
API 价格与单个已完成任务的成本
只看每个 token 的价格还不够。真正值得关注的是单个已完成任务的成本:让 Agent 循环完整解决一个真实 GitHub Issue,到底要花多少钱。
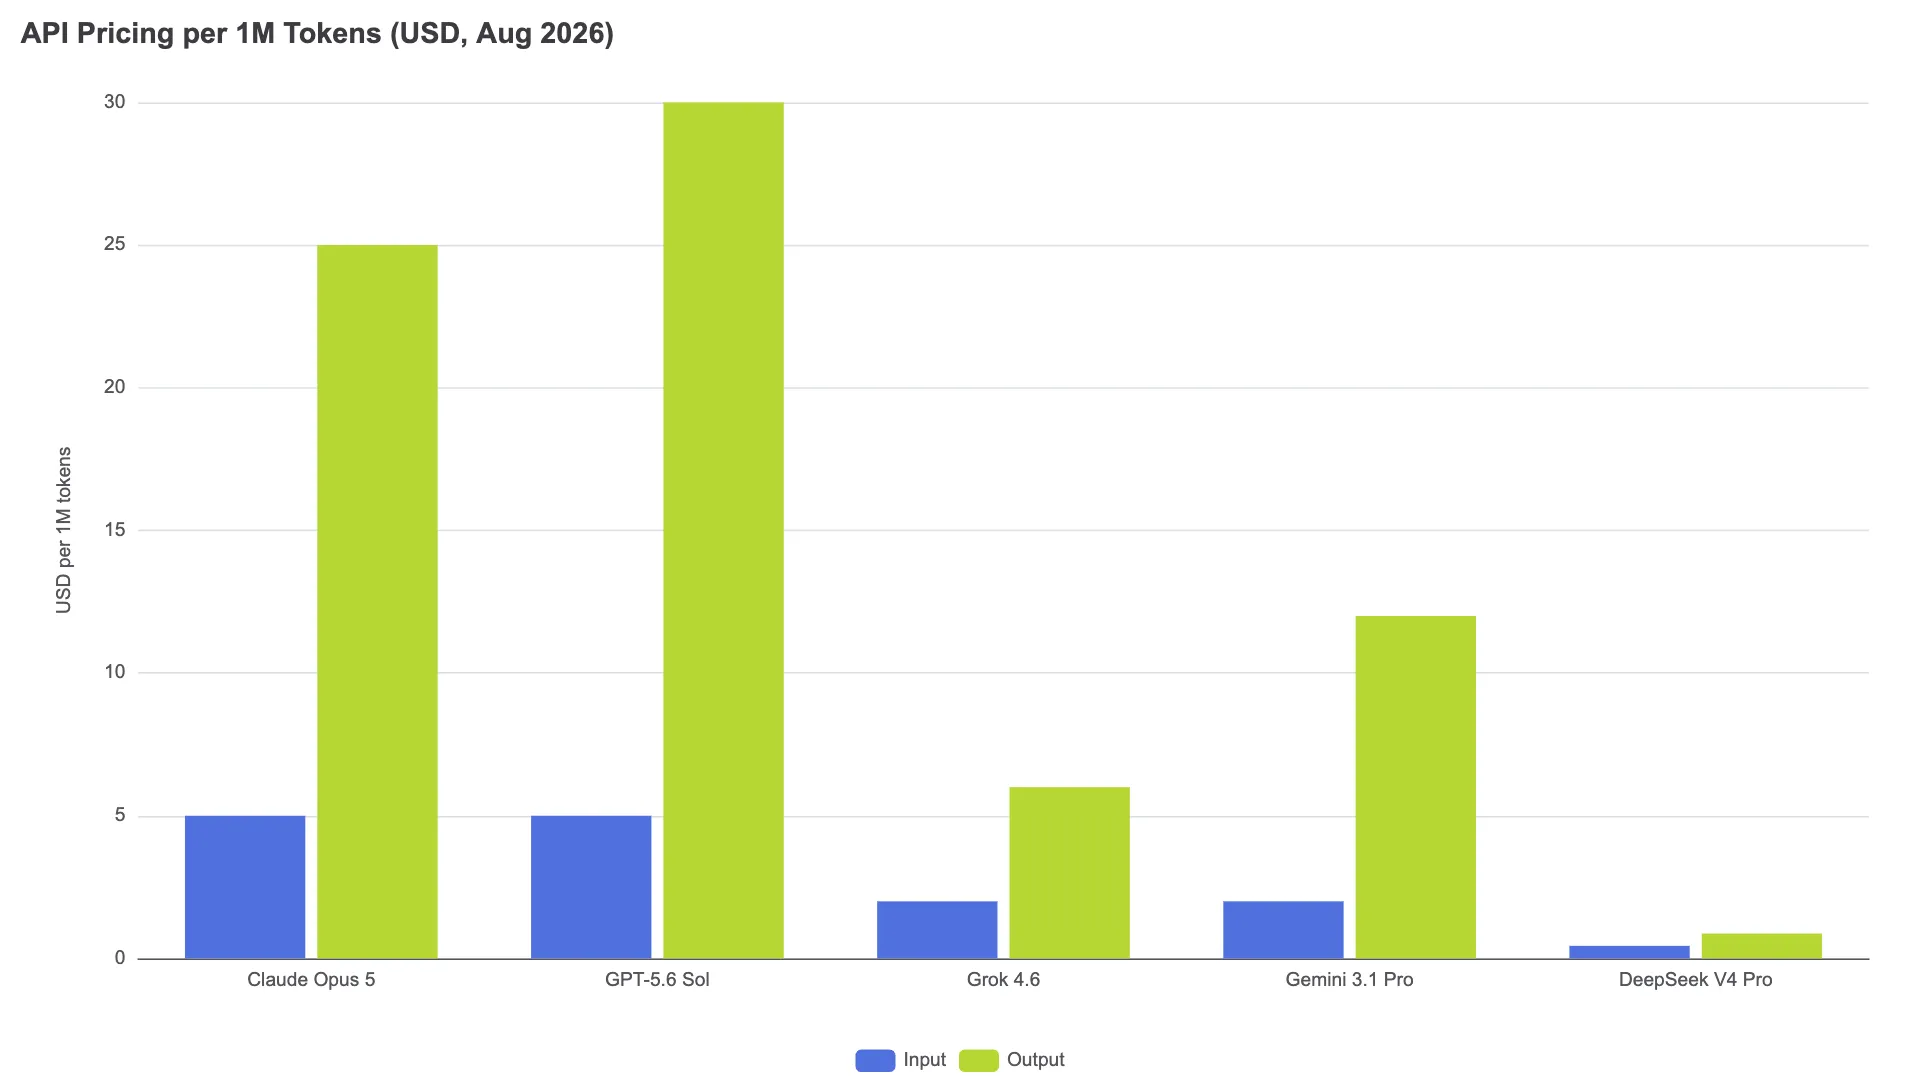
一次典型的 Agent 循环包括读取文件、制定计划、修改代码、运行测试和修复失败,解决一个问题大约会消耗 50K–200K token,其中输出通常占总 token 的 30–50%。这些数字是根据 Tembo 等机构对 Agent 循环的分析整理出的行业估算;实际用量会受到代码库大小、测试套件耗时和框架效率影响。以总量 125K token 的中位数估算(75K 输入、50K 输出),每款模型解决一个问题的成本如下:
| 模型 | 输入成本 | 输出成本 | 单任务总成本 |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 没有列入这张表,因为它的成本完全取决于使用 Moonshot 托管 API,还是部署在自己的 GPU 上;两种方式没有一个统一的标价可以直接比较。Grok 4.6 的单任务成本为 0.45 美元,处于一个很有吸引力的位置:它在 Artificial Analysis Intelligence Index 上追平 GPT-5.6 Sol Max,但单任务成本约为 Sol 的四分之一。
以上估算不包含重试、缓存 token 折扣、工具调用开销和基础设施成本。如果某个模型每项任务需要更多重试或人工修正,实际花费就会高于单纯按 token 价格计算的结果。因此,与其押注一款模型,不如采用路由策略:常规工作交给 DeepSeek 或 Grok,遇到困难的重构任务再升级到 Opus。
不同编码 Agent 工作流的最佳选择
没有一款模型能覆盖所有工作流。下面是更适合各类 Agent 任务的搭配方式。
快速循环与常规修改。 对于错误解释、小型函数添加、测试桩和文档更新等高频低风险任务,可以使用 Gemini 3.5 Flash(每百万 token 1.50/9 美元)或 Claude Sonnet 5。
深度重构与架构设计。 如果任务涉及多文件修改、跨模块依赖或架构决策,Claude Opus 5 是更稳妥的选择。此类任务一旦判断失误,可能带来数小时的调试成本。它的核心优势在于更精确地遵循指令,以及在长时间会话中持续保持上下文连贯性。
长时间运行的自主 Agent。 Grok 4.6 正是为这一场景设计的。根据 xAI 的公告,它的开发重点是持续运行的 Agent 轨迹和自检行为。按每项任务 0.45 美元计算,即使让它运行更长时间,成本压力也低于 GPT-5.6 Sol 每项任务 1.88 美元的水平。如果工作流高度依赖终端操作,GPT-5.6 Sol 在 Terminal-Bench 中以 34.6% 领先,因此是更稳妥的选择。
预算有限与自托管。 对成本敏感的团队,可以优先通过 API 使用 DeepSeek V4 Pro,单任务成本约为 0.077 美元。对于不能把代码发送到外部 API 的组织,可以自托管 Kimi K3(SWE-bench Verified 得分 70.8%)或 MiniMax M2.5(75.8%)这样的开放权重模型。在 SWE-bench Verified 上,开放权重模型与闭源权重领先模型之间的差距已经缩小到几个百分点以内。
别忽视 Agent 框架:工具链可能限制模型上限
无论使用 Claude Code、Codex CLI、Cursor,还是 OpenCode 这样的开源工具,Agent 所依赖的框架都会控制四件模型本身无法控制的事情:上下文管理(何时压缩、保留哪些内容)、工具定义与路由、错误恢复方式,以及审核和确认流程。正如 Tembo 的分析指出的那样,模型在 mini-SWE-agent 这类受控框架下的基准得分,不一定能代表它在另一套配置中的真实问题解决率。因此,相比把模型和框架收益混在一起的厂商自测分数,固定框架后进行的基准测试,更适合用来比较模型本身。
在更换模型之前,先检查自己的 Agent 框架:它是否能有效压缩上下文,工具定义是否清晰,以及遇到错误时是否会合理重试,而不是陷入循环。
常见问题
哪款 LLM 最适合编码 Agent,价格也最低?
DeepSeek V4 Pro 是最便宜的前沿级选项,输入价格为每百万 token 0.435 美元、输出价格为每百万 token 0.87 美元,解决一个 Agent 任务的成本约为 0.08 美元。
如何在自己的代码库上测试编码 Agent 模型?
从实际待办列表中挑选 20–30 个有代表性的问题,涵盖 Bug 修复、功能开发和重构。让每个模型在你选定的同一套框架中处理完全相同的任务,并跟踪三个指标:解决率(Agent 提交的补丁是否通过测试)、每项任务的 token 消耗,以及完成所需时间。相比任何公开基准,这种针对自身代码库的评估结果更有参考价值。