 AIREITER
如果只是想尽快把决策模型接入业务,托管 API 依然是最省心的路径:每百万输入 token 仅 $0.04。与此同时,新发布的开放权重检查点也让本地推理变得可行。不过,3B 与 600M 两个模型之间的实际质量差距相当明显。
Liquid d1 的三个版本,不能混为一谈
Liquid AI 目前有三个值得关注的选择:专有的托管 d1 服务、开放权重的 d1-3B,以及仍处于实验阶段的开放权重 d1-omni-600M。Liquid AI 并未说明托管模型是否与任一可下载检查点完全一致,因此,基准成绩和延迟数据都应严格对应到产生它们的具体模型。
| 选择 | 获取方式与价格 | 输入 | 公开上下文长度 | 适合场景 |
|---|---|---|---|---|
托管 d1 | Liquid API;每 1M 输入 token $0.04,不收输出 token 费用 | 通过 Liquid 直接输入文本和图像 | Vercel 列为 66K | 快速集成、推理账单几乎可忽略、不想运维模型 |
d1-3B | 可下载权重;不收按 token 计的模型费用 | 文本、JSON 和图像 | 32,768 tokens | 本地质量优先、视觉任务、生产评估 |
d1-omni-600M | 可下载的实验性权重;不收按 token 计的模型费用 | 文本加图像,或文本加音频 | 16,384 tokens | 小体积、语音命令实验、资源受限的边缘设备 |
这三个模型都用于回答带类型的决策问题,而不是生成长篇文本。noul 返回“是”的概率,choice 返回指定选项的概率分布,score 则根据有序评分标准给出带概率权重的位置。它们适合路由、内容审核、检查、护栏和评分,不是聊天模型或编程模型的替代品。
建议很明确:试点项目直接用托管 d1;数据必须留在本地,或延迟不能承受网络往返时,选 d1-3B;除非音频能力或模型体积是决定性条件,否则应将 d1-omni-600M 视为实验选项。
托管 API 便宜到什么程度,本地部署又在为何买单
Liquid AI d1 API 的价格是每百万输入 token $0.04。因为服务输出的是决策而非生成文本,所以没有输出 token 费用。处理 1 亿输入 token 的成本为 $4,尚未计入可能的网关费用;10 亿输入 token 则为 $40。
按 $0.04/M token 计算,自托管几乎不会仅凭推理成本取胜。本地部署的理由通常是隐私、离线使用、端侧延迟、定制化需求,或持续的高利用率。
两个开放检查点均没有官方托管的按 token 定价。评测时,它们的 Hugging Face 页面也没有显示推理服务提供商,因此不能把托管 d1 的价格当作 d1-3B 或 d1-omni-600M 的价格。
托管服务对图像同样按输入计费。Liquid AI 规定,每个 32×32 像素图块计为 1.5 token,因此一张 1024×1024 图像在问题文本之前就会占用 1,536 token。按 $0.04/M 计算,图像部分约为 $0.00006144;每一个问题都作为单独的提示词计费,并包含其关联图像。
开放权重,不等于无限制或零成本
两个仓库使用的都是 Liquid AI 的 lfm1.0 许可证,而非 Apache 2.0 或 MIT。Liquid AI 的通用定价条款指出,年公司收入低于 $10 million 时,其可下载模型可免费用于商业用途;规模更大的组织应核实当前商业条款,不能仅因“开放权重”这一说法就自行推断授权范围。
估算本地部署预算时,还应计入 GPU 或设备购置、闲置容量、监控、更新和人力时间。托管账单是很小的可变成本,本地成本则主要是固定成本。
d1-3B 看质量,omni 看体积
官方的 Open d1 公告给出的 Decision Index v0.2.1 成绩中,d1-3B 为 48.57,d1-omni-600M 为 15.95。Liquid AI 使用官方评分器测试了两者,但这些结果并非官方排行榜提交成绩。
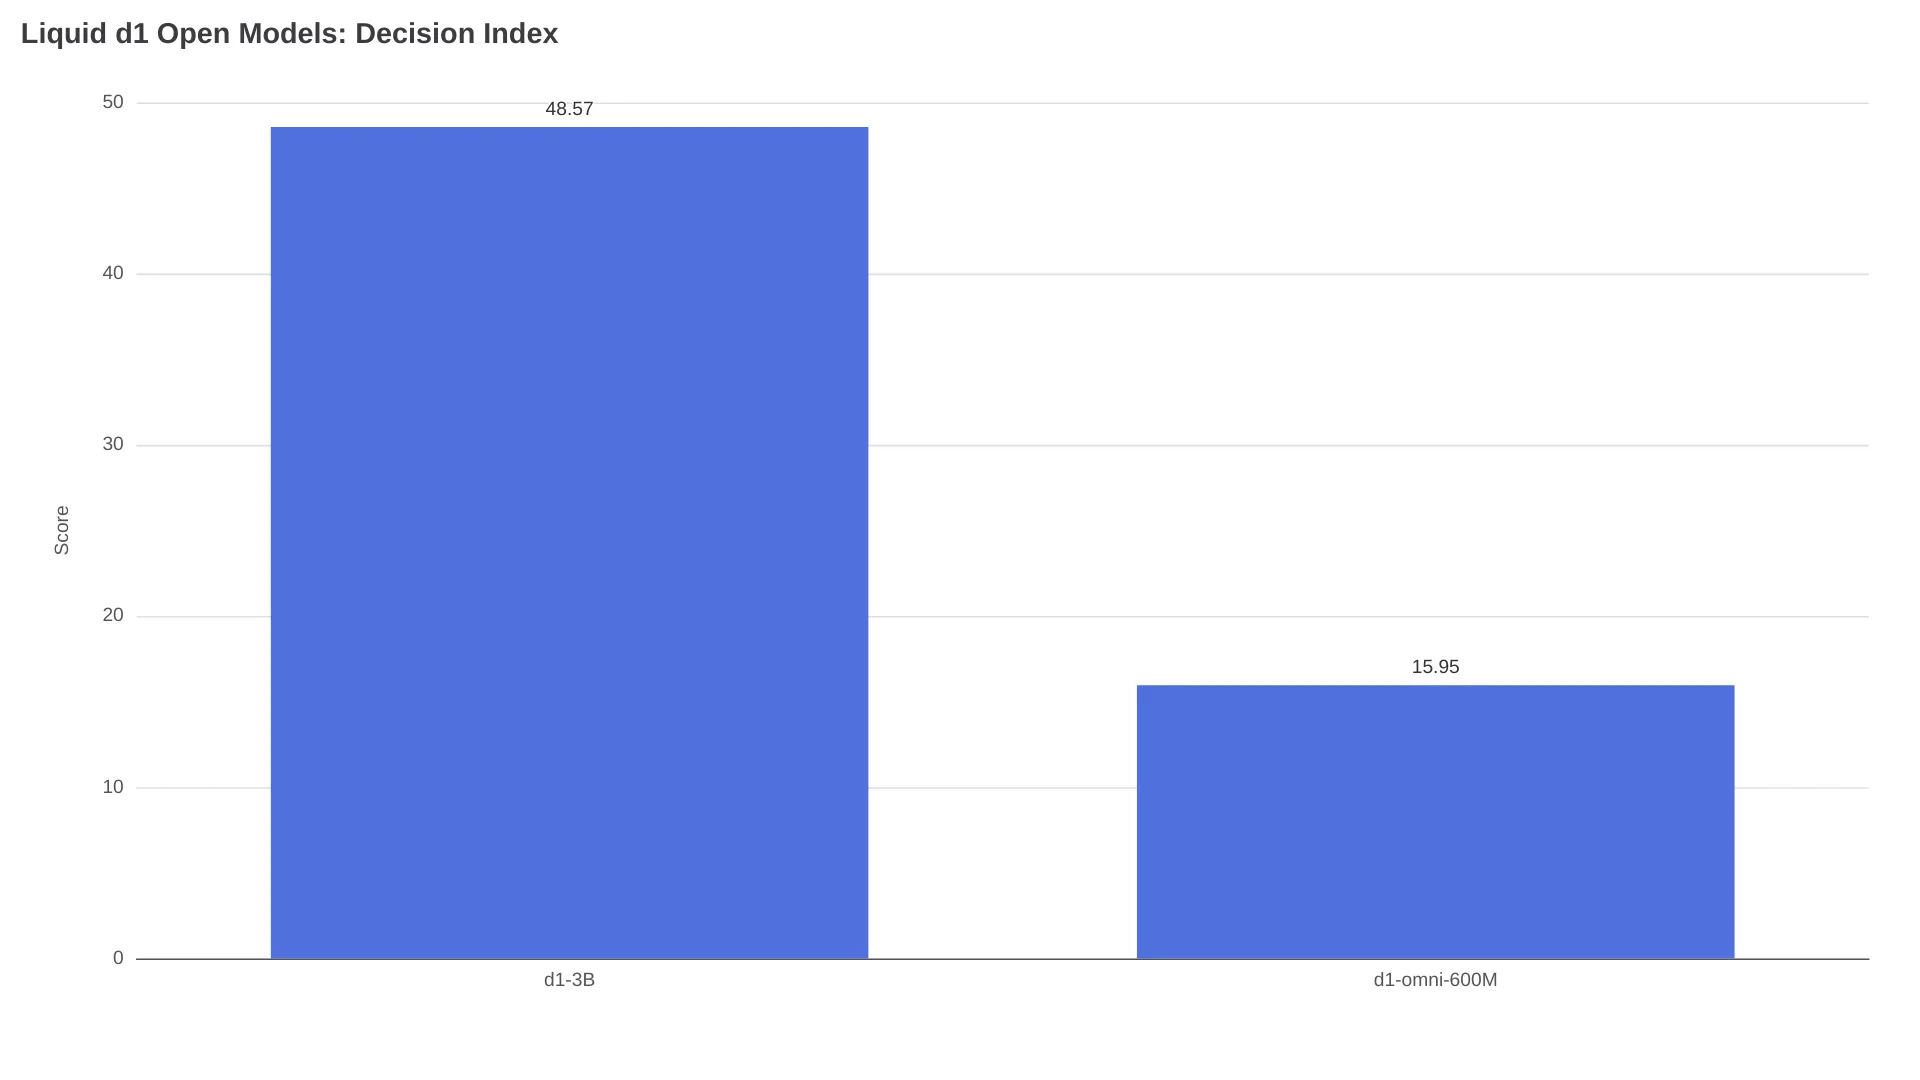
小模型也并非全面落后。Liquid AI 报告称,在七项公开文本基准上,d1-3B 平均分为 82.9,d1-omni-600M 为 78.4。Omni 在 Civil Comments(95.8 对 93.0)和 PAWS-X(79.5 对 76.9)上领先,3B 则在另外五项列出的任务中领先。Decision Index 上更大的分差说明:即便 600M 在少数分类切片表现突出,也不能将其视为 3B 的通用替代方案。
| 规格 | d1-3B | d1-omni-600M |
|---|---|---|
| 详细参数量 | 3.12B | 587M |
| 全精度仓库/权重体积 | 仓库 6.27 GB;权重 6.25 GB | F32 模型,约 0.6B 参数 |
| 上下文 | 32,768 | 16,384,所有模态共用 |
| 图像场景下的文本额度 | 计入模型上下文 | 使用图像时,状态和问题文本限制为 896 tokens |
| 音频 | 不支持 | 一段 16 kHz 单声道音频,最长 30 秒 |
| 图像与音频同时输入 | 不适用 | 不支持;会抛出 ValueError |
| 官方速度表 | 有 | 没有;属于早期研究版本 |
d1-omni-600M 模型卡显示,该模型以 float32 训练。Float16 在 243 条文本、214 条图像和 416 条音频记录上均保留了最高答案;而 bfloat16 令 0.8% 的文本记录和 1.7% 的音频记录发生了最高答案变化。因此,数据类型并不只是优化开关,也是一项需要验证的变量。
本地部署上手很快,验证工作却远未结束
两张模型卡均提供单状态调用 system_one 和打包请求调用 system_one_batch。部署 d1-3B 的最短路径需要 Transformers 5.14 或更高版本、PyTorch、TorchVision、Pillow,以及仓库提供的自定义代码。
- 安装文档列出的依赖:
pip install "transformers>=5.14" torch torchvision pillow- 启用远程仓库代码并加载模型:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- 提交具名决策问题,而非聊天提示词:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True 意味着仓库中的 Python 代码会在服务进程中执行。进入生产环境前,应固定到已审查的提交,而不是直接加载持续变动的分支。d1-3B 仓库还链接了适用于 llama.cpp、Ollama 和 LM Studio 兼容运行时的量化版本;社区量化产物与官方 BF16 权重相比,是另一项独立的软件供应链和准确性决策。
d1-3B 模型卡给出的热调用耗时为:RTX 4090 上单个问题 8 ms、Apple M5 Pro 上 30 ms、Jetson Orin Nano 上 50 ms。对于 3.4K-token 的状态,同样三台设备的耗时分别是 102 ms、640 ms 和 1,640 ms。GPU 数据是 20 次运行的中位数;4090 的 8 ms 成绩采用了编译后的 CUDA 图,而新的输入形状会产生编译或内核选择开销。
官方尚未提供 d1-omni-600M 的速度表。一项浏览器端移植报告称,完成四个决策时,每条评论约需 180 ms:
“I didn't test it against other machines yet, just my MBP M4 Pro.” — u/FinancialAd1961 on Reddit
这一单设备结果只能证明浏览器中可行,不能代表不同浏览器、GPU、量化方式或批量大小下的性能。
API 接入更简单,但模型身份仍不能忽略
直接使用托管服务时,模型名为 d1,端点是 https://api.liquid.ai/decisions/v1/systemone。Vercel 使用的名称为 liquid/d1,其页面列出 66K 上下文和相同的 $0.04/M 输入价格。Liquid 在 10 月 5 日的公告中称,当时 Vercel 和 OpenRouter 仅支持文本,而 Liquid 的直连 API 已可接收图像。
开放检查点通过本地 Python 方法提供相同的决策概念,但接口相似不代表行为等价。它们输出的概率可能差异大到足以让某个案例跨过自动化阈值。对每一个经过评估的分支,都应记录确切模型 ID、revision、dtype、概率和阈值。
因此,迁移最好按四步进行:
- 从真实生产分布中构建带标签的数据集,纳入模糊案例和代价高的错误。
- 将相同的状态、问题结构和判定标准输入每个候选模型。
- 依据误报和漏报的成本选择阈值,而不是依据全局基准分数。
- 在允许模型执行破坏性、财务、访问控制或安全相关操作前,先进行影子运行。
Liquid d1 到底该选哪一个?
对大多数团队而言,托管 API 是默认推荐。它的 token 价格低到小规模试点不足以支撑另起一个本地服务项目,同时还能省去驱动、量化、预热和容量管理工作。
| 需求 | 推荐选择 | 原因 |
|---|---|---|
| 最快上线 | 托管 d1 | 托管端点,输入价格明确 |
| 数据不能离开设备或网络 | d1-3B | 最强的开放检查点,可在本地执行 |
| 公开成绩最好的开放决策模型 | d1-3B | Decision Index 为 48.57,对比 15.95 |
| 音频命令分类 | d1-omni-600M | 这里唯一支持音频的选择,最长 30 秒 |
| 最小的实验性体积 | d1-omni-600M | 587M 参数,但没有官方延迟表 |
| 开放式解释或生成操作 | 都不适合 | 在决策阶段之后加入生成模型 |
除非 600M 的体积或音频链路不可替代,否则应优先选择 d1-3B 而不是 omni。参数量缩小五倍很有吸引力,但无法抹平 32.62 分的 Decision Index 差距,也改变不了 omni 的实验性定位。
Liquid AI d1 常见问题
Liquid AI d1 免费吗?
托管 d1 服务的价格是每百万输入 token $0.04,且不收输出 token 费用。开放检查点可以下载,不收按 token 计的费用,但仍受 LFM 1.0 商业条款约束,也需要承担本地算力成本。
d1-3B 和 d1-omni-600M 就是托管 d1 API 使用的模型吗?
Liquid AI 尚未说明任一检查点与托管 d1 完全相同。应将它们视为相关但独立的产品,它们的模型 ID、上下文、基准成绩和部署路径各不相同。
Liquid d1 可以通过 Ollama 运行吗?
d1-3B 模型页面链接了面向 llama.cpp、Ollama、LM Studio 及兼容应用的量化版本。在替换官方 Transformers 路径前,应验证量化者、来源 revision、决策 API 支持情况以及准确性。
d1-3B 支持音频吗?
不支持。d1-3B 接受文本、JSON 和图像。d1-omni-600M 接受文本加图像,或文本加一段最长 30 秒的音频,但不能在同一次请求中同时输入图像和音频。
本地运行 d1 需要多少显存?
Liquid 为 d1-3B 发布了一个 6.25 GB 的 BF16 权重文件,但没有给出统一的显存需求。运行时开销、图像编码器状态、上下文长度、批量大小、精度和量化方式都会影响总量;应测量目标配置,而不能把文件大小直接等同于峰值显存。
无论选择哪条路线,在自动化会带来重要后果的决策前,都应先用带标签的生产数据验证概率阈值。
延伸阅读:托管 Liquid AI d1 API 评测更详细介绍了直连端点、图像计费和类型化请求契约。