 AIREITER
モバイル操作のベンチマークだけを見ると、Qwen-UI-Agentは圧倒的です。実機で測るMobileWorld-Realで92.2%、AndroidDailyで97.5%を記録しています。ただし、この数字を支える27Bモデルの重みは確認済みの形で公開されておらず、APIもありません。現時点で入手できるのは技術レポートとデモ、そしてより小型の前世代モデルMAI-UIです。華々しいスコアと実際の入手性には大きな隔たりがあります。この記事では、公式スコアを一通り整理したうえで、今すぐ手にできるものと、まだ公開されていないものを切り分けます。
Qwen-UI-Agentの公式スコアをまとめて確認
Qwen-UI-Agentは、AlibabaのTongyi-MAIチームが2026年7月30日に技術レポートとして発表したGUIエージェントの基盤モデルです(arXiv 2607.28227)。モバイル、コンピューター操作、Web、DeepSearchにまたがる単一モデルで、GUI操作、CLI実行、アクションのバッチ処理をひとつの行動空間で扱います。公式結果ページに掲載された範囲では、モバイル系とグラウンディング系の全ベンチマークで首位、OSWorld-Verifiedで2位、長時間タスクを測るOSWorld-v2で3位です。レポートでは27B、35B-A3B、4Bの各バリエーションを評価していますが、以下の数値はフラッグシップの27Bモデルによるものです。
モバイル:最先端をうたうだけの差はある
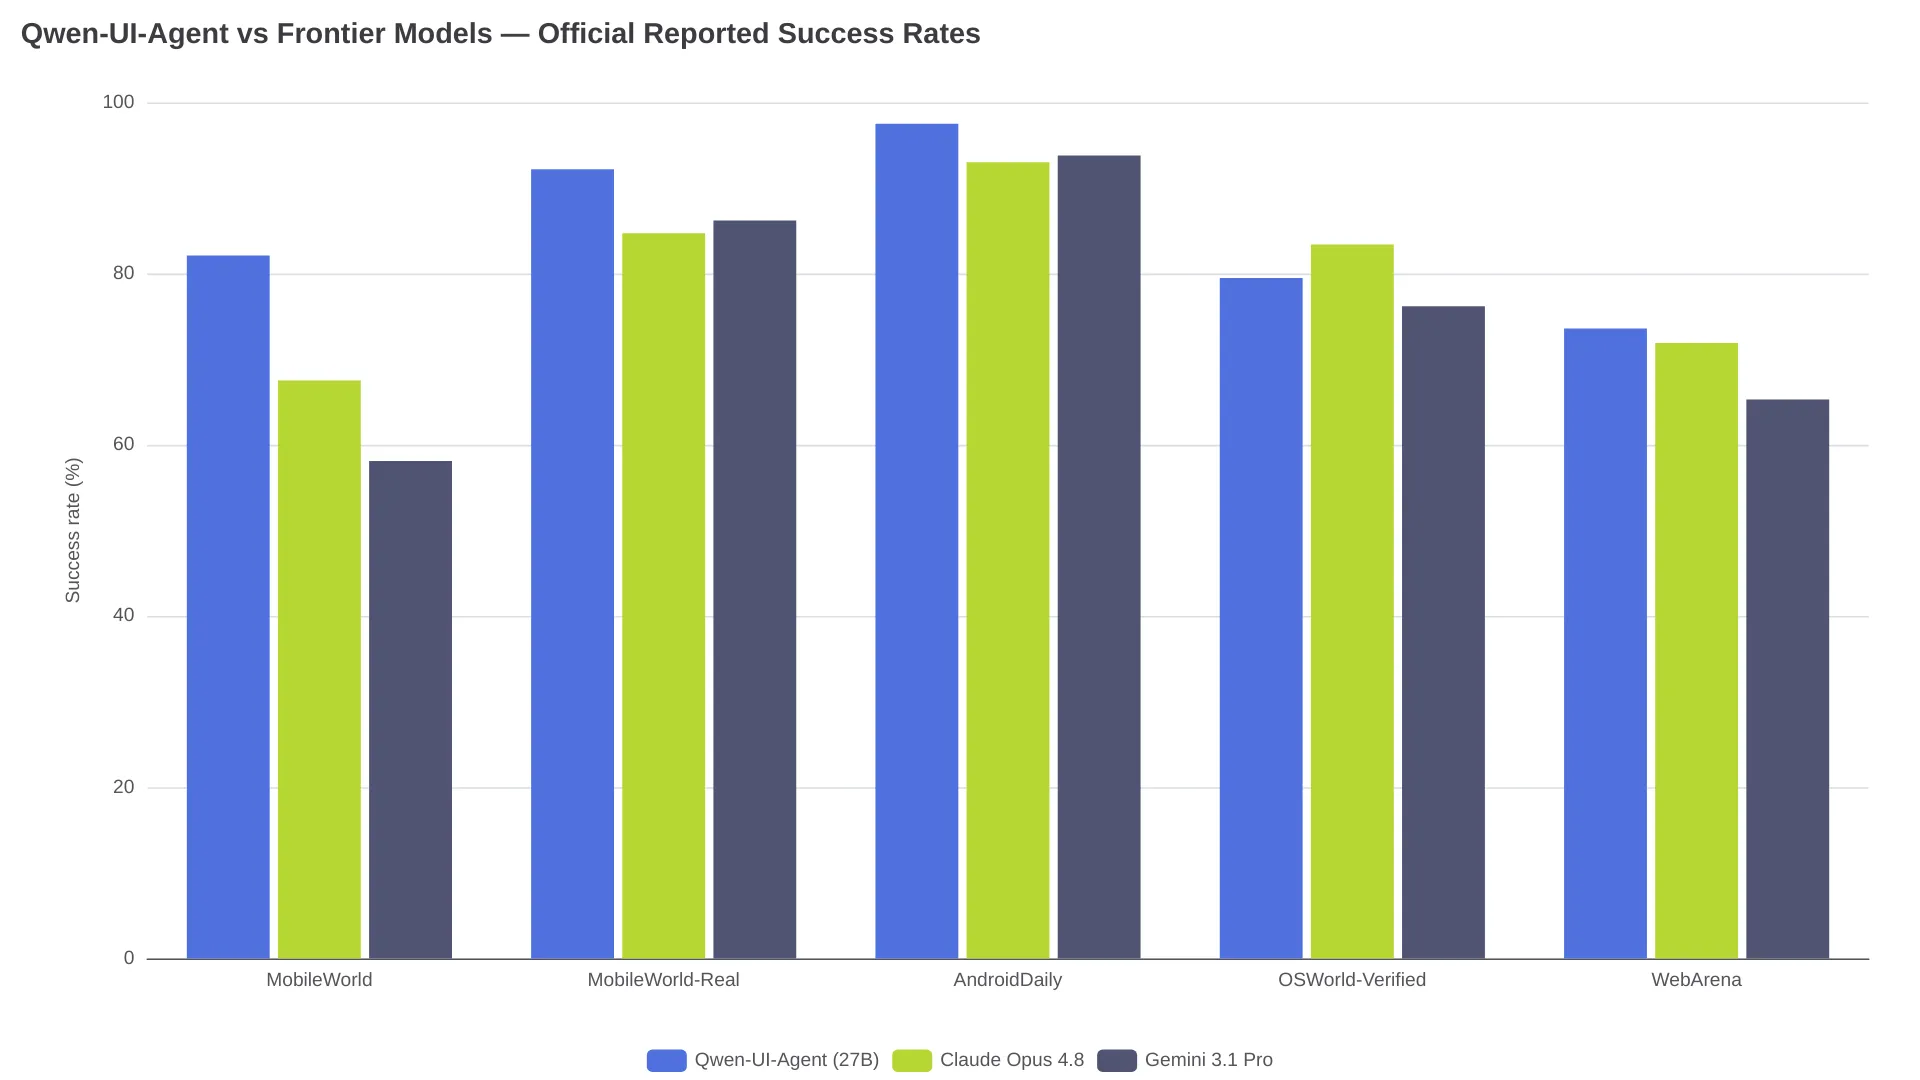
このレポートが最も強く打ち出しているのがモバイル性能です。MobileWorldのGUI専用分割では82.1%を記録し、次点の汎用モデルSeed 2.1 Pro(73.2%)を8.9ポイント上回りました。GUIに特化したモデルとの比較でも、最高値のGUI-Owl-1.5-32B-Instruct(43.9%)に38.2ポイント差をつけています。
| モデル | MobileWorld(GUI専用) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent(Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro(ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8(Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro(Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus(Alibaba) | 62.3 | 72.7 | 79.8 |
なお、公式表でモバイルの比較対象になっているGPTはGPT-5.6 Solで、スコアは70.1 / 85.4 / 92.6です。デスクトップ側はGPT-5.5なので、単に「GPT」とだけ書かれた数値を引用する際は注意が必要です。
なかでもMobileWorld-Realは、このチームが独自に構築した中心的なベンチマークです。日常利用に近い7分野、104本の実Androidアプリを使い、実機上で409件のエンドツーエンドタスクを実行します。実アカウントや現実世界で起こる割り込みも含め、5つのVLMによる多数決判定でスコアを算出しています。
コンピューター操作:強いが、首位ではない
デスクトップ領域では、レポートが使う「競争力がある」という表現の意味が見えてきます。OSWorld-Verifiedでは79.5%で2位。Claude Opus 4.8の83.4%には3.9ポイント届きません。長時間タスクのOSWorld-v2では、部分進捗が40.0%ですが、タスク完了を二値で判定した場合は13.9%にとどまります。Claude Opus 4.8(54.8)とGPT-5.5(49.5)は、いずれも大きく上回っています。
| モデル | OSWorld-Verified | OSWorld-v2(部分進捗) | OSWorld-v2(二値判定) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | 未報告 |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | 未報告 | 未報告 |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | 未報告 | 22.3 | 未報告 |
一方、効率面では明確な強みがあります。アクションをまとめて処理することで、1タスクあたりの平均ステップ数は135.8。MiniMax M3の326.7、Qwen 3.7 Plusの173.5より少ない値です。それでも部分進捗では、すべてのオープンウェイトモデルを17ポイント以上上回りました。OSWorld-v2ではCLIコマンドがエージェントの操作の50%超を占めており、GUIとCLIを組み合わせる設計が実際に効いています。
ブラウザー操作とDeepSearch
WebArenaでは73.6%で、Claude Opus 4.8(71.9)、GPT-5.5(69.5)、Gemini 3.1 Pro(65.3)を上回りました。調査タスクでも、BrowseCompは64.1%でQwen3.5-27Bのベースライン61.0%を超え、BrowseComp-ZHでは75.0%対62.1%です。単に画面上の座標を指定するだけでなく、DeepSearchの訓練効果が調査能力にも移っていることがうかがえます。
GUIグラウンディングは全項目で首位
視覚的な指示から正しいピクセル位置を見つけるグラウンディングでは、公式結果ページに掲載されたすべてのベンチマークでQwen-UI-Agentが1位でした。
| ベンチマーク | Qwen-UI-Agent | 競合最高値 |
|---|---|---|
| ScreenSpot-Pro(ズームなし) | 76.6 | 72.9(GUI-Owl-1.5) |
| ScreenSpot-Pro(ズームイン) | 81.5 | 80.7(Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6(Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3(MAI-UI) |
| OSW-G-R | 78.5 | 78.2(Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0(Qwen 3.7 Plus) |
汎用モデル化による性能低下は小さい
GUI特化モデルは、通常の言語モデルとしての能力を失いがちです。Qwen-UI-Agentではその低下がほとんど見られません。MMLU-Proは86.5で、Qwen3.5-27Bの86.0を上回り、IFEvalも90.2対90.4とほぼ同水準です。専用モデルと比べても、差は一部のベンチマークを除けば大きく開いています。
| ベンチマーク | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | 未報告 | 未報告 | 未報告 |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
自らのベースラインに負けた項目はQwenClawBenchで、44.2対48.5でした。また、これらの汎用能力に関するスコアは、公式ページ上で著者側の評価環境における再現結果と記載されています。
Qwen-UI-Agentの訓練方法
技術レポートによると、訓練データは100台超の実機をそろえたデバイス群から収集されています。150以上のアプリをカバーし、エージェント自身がタスクを作成・診断するデータフライホイールを回します。教師ありファインチューニングの後には、100ターンを超える軌跡を使った複数段階の強化学習を実施し、1万超の環境で同時にロールアウトしています。
このスコアボードをどこまで信頼できるか
公式ページには、数値を引用する際に押さえておきたい注意点が3つあります。1つ目は、MobileWorld-Realが著者チーム独自のベンチマークであること。2つ目は、短剣符の付いたベースラインのスコアが、著者側の環境で再現された値だということです。評価ハーネス、判定役、シミュレーター、タスクのサブセットが、各ベンダーの公式評価と異なる可能性があります。3つ目は、OSWorld-v2の40.0%が成功率ではなく部分進捗の数値だという点です。(出典:公式結果ページの注記および技術レポート)
「Alibabaの新しいGUIエージェントはスマートフォンでは勝つが、デスクトップでは足踏みしている」— Xの@Daily_AI_Brief。同アカウントは「Alibabaはすべてのベースラインを自分たちの環境で評価した」とも指摘しています。
X上の第三者の見方も、おおむね同じ方向です。@itarutomyによる日本語の解説は、実機モバイルでの優位性を取り上げる一方、デスクトップでは2位にとどまる点を強調しています。リリースそのものについては、Tongyi LabのPengxiang Li(@oliverlee1999)による公式発表スレッドが一次情報です。結論として、MobileWorld-Realは再現待ちの有力な主張として扱い、より比較に使いやすい指標としては、著者チームが新設したものではないOSWorld-Verifiedを重視するのがよいでしょう。
今すぐQwen-UI-Agentにアクセスする方法
Qwen-UI-Agentは現時点では研究リリースです。論文、プロジェクトページ、コードリポジトリは公開されていますが、モデル本体の公開チェックポイントは確認できません。公開されている各アーティファクトの中身を整理すると、次のようになります。
公開物を点検する
| 公開物 | リンク | 含まれるもの |
|---|---|---|
| 技術レポート | arxiv.org/abs/2607.28227 | 2026年7月30日提出の論文全文。PDF、HTML、TeXソース |
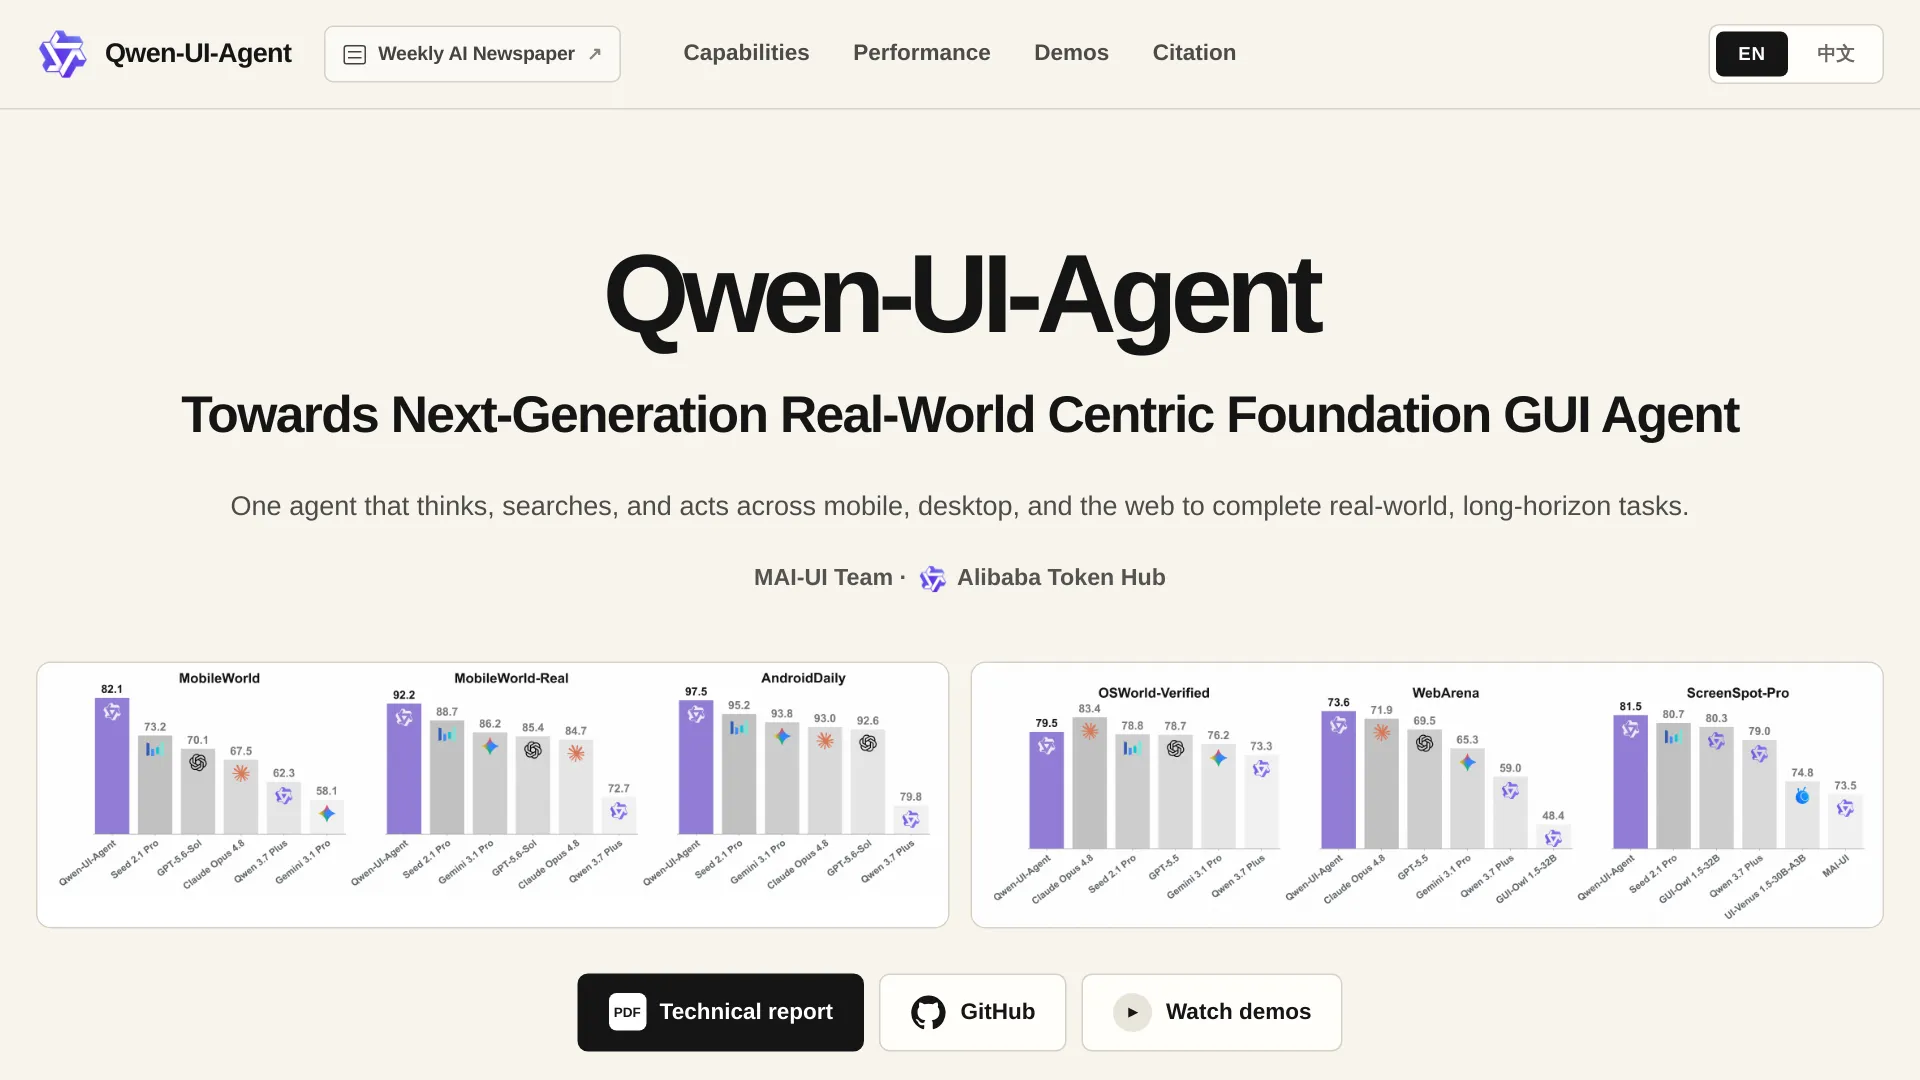
| プロジェクトページ | tongyi-mai.github.io/Qwen-UI-Agent | 機能デモ、ベンチマーク全体のチャート、引用情報 |
| MAI-UIリポジトリ | github.com/Tongyi-MAI/MAI-UI | Apache-2.0のリポジトリ。Qwen-UI-Agent向けに名称変更されており、2025年12月に公開されたMAI-UI-8BとMAI-UI-2BのHugging Faceチェックポイントへのリンクを掲載 |
| Qwen-UI-Agentリポジトリ | github.com/Tongyi-MAI/Qwen-UI-Agent | Webサイトのソースのみ。モデル、訓練コード、エージェント実装は含まないとリポジトリに明記 |
MAI-UIリポジトリが、この系譜における公式の継続拠点です。2026年7月30日にQwen-UI-Agentを告知しており、現時点でダウンロードできる唯一のチェックポイントもここから案内されています。
モデルの重みはどうなっているのか
ダウンロードできるのは、2025年12月に公開された前世代モデルのMAI-UI-8BとMAI-UI-2Bだけです。いずれもMAI-UIリポジトリからHugging Faceのリンクをたどれます。Qwen-UI-Agent 27B、35B-A3B、4Bのチェックポイントが一般公開されたことは確認できません。ここでの公開状況は2026年8月下旬に公式リポジトリとプロジェクトページを確認したもので、リリースは見つかりませんでした。MAI-UIのチェックポイントやWebサイトのソースリポジトリを、Qwen-UI-Agentのモデル重みと混同しないようにしてください。
APIもセルフホスト環境も、まだない
公式チャンネルには、Qwen-UI-Agentの公開APIエンドポイント、ホスト型サービス、vLLM/Ollama向けパッケージはいずれも見当たりません。今すぐデスクトップ操作を実運用に組み込みたいなら、報告されたOSWorldの結果ではClaude Opus 4.8が有力です。オープンウェイトでGUIエージェントを試す場合は、MAI-UI 2B/8Bと自前のハーネスを組み合わせるのが現実的な選択肢になります。ただし、これはQwen-UI-AgentではなくMAI-UIです。リリース情報はTongyi-MAIの公式リポジトリとQwenの公式チャンネルで確認してください。APIが利用できる汎用Qwenシリーズについては、AIReiter Qwenモデルカタログで現在のエンドポイントと料金を追跡できます。
Qwen-UI-Agentの系譜における位置づけ
Qwen-UI-Agentは、AlibabaのGUIエージェント系列における第3世代です。2025年にUI-TARSがQwenのGUIアプローチを切り開き、MAI-UI(arXiv 2512.22047、2025年12月)が実世界を重視したデータフライホイールと2B/8Bのオープンウェイトを導入しました。Qwen-UI-Agentは、その手法を27Bへ拡張し、GUIとCLIを組み合わせた実行に対応しています。なお、上の表にあるOSWorldの2指標ではClaude Opus 4.8が首位です。
Qwen-UI-Agent FAQ
Qwen-UI-Agentはオープンソースですか?
コードリポジトリはApache-2.0で公開され、レポートも読めます。しかし、モデル本体がオープンウェイトとして公開されたことは確認されていません。ダウンロードできるのは前世代のMAI-UI-8BとMAI-UI-2Bのチェックポイントだけです(Hugging Face、2025年12月)。この記事の執筆時点で、Qwen-UI-Agentの27B、35B-A3B、4Bチェックポイントに確認済みの一般公開版はありません。
現在、Qwen-UI-Agentをローカルで動かせますか?
確認済みのローカル実行手順はありません。チェックポイント、GGUFやOllama向けパッケージ、vLLM用のレシピはいずれも存在しません。ローカルで試すなら、MAI-UI 2B/8Bを自前のハーネスで動かす形に限られます。
Qwen-UI-AgentのAPIはありますか?
公開エンドポイントやホスト型サービスは発表されていません。リリース情報はTongyi-MAIの公式GitHubリポジトリとQwenチームの公式チャンネルを確認してください。
コンピューター操作ではClaude Opus 4.8と比べてどうですか?
OSWorld-VerifiedではClaude Opus 4.8が83.4対79.5、OSWorld-v2の部分進捗では54.8対40.0でリードしています。一方、WebArenaではQwen-UI-Agentが73.6対71.9で上回り、掲載されているモバイル系ベンチマークでもすべて首位です。長時間のデスクトップ操作は現時点でClaudeが優勢で、モバイル中心の用途ではQwen-UI-Agentの公表値が最も強くなっています。
MobileWorld-Realとは何ですか?
Qwen-UI-Agentの著者チームが構築した実機Androidベンチマークです。日常利用に近い7分野、104本の実アプリを使って409件のタスクを評価し、5つのVLMによる多数決判定でスコアを出します。結果は自己申告によるもので、独立した再現検証を待っている段階です。
評価を変える可能性があるもの
今後、次の3つが確認されれば、現時点での評価は大きく変わる可能性があります。
| シグナル | 重要な理由 |
|---|---|
| Tongyi-MAIのHugging Face上でQwen-UI-Agentのチェックポイントが公開される | 研究リリースが実際にビルドできる選択肢へ変わり、第三者による数値検証につながる |
| Alibaba以外のハーネスでOSWorld-Verifiedが再現される | 79.5%という結果が著者側の環境を離れても維持されるかを確かめられる |
| API、Qwenアプリへの統合、プレビューなどの製品面が登場する | 比較の軸が論文上の表から、実運用におけるトレードオフへ移る |
それまでは、ひとつの未解決なトレードオフが残ります。これまで公開された比較でモバイル操作の首位に立っている一方、その結果は同じチームが構築したベンチマークによる自己申告なのです。
関連記事:Alibabaの新しい汎用フラッグシップとオープンウェイトの状況については、Qwen3.8-Maxのオープンウェイト解説で紹介しています。エンドポイントのコストはQwen3.8-Max API料金ガイドをご覧ください。