 AIREITER
2.4兆パラメータのモデルを「オープンウェイト」と聞くと、自宅のGPUで試せるものを想像するかもしれません。しかしQwen3.8-2.4T-A95Bは、4ビット量子化してもVRAMをおよそ1.2 TB必要とします。実行できるのはほぼデータセンター環境に限られるモデルです。3週間にわたる「coming soon」を経て、ウェイトは2026年8月12日にModelScopeで公開されました。総パラメータ数は2.4兆ですが、トークンごとに有効化されるのは950億です。公開内容、利用料金、そしてAPIを選ぶべきケースを整理します。
Qwen3.8-2.4T-A95BのウェイトがModelScopeで公開
Qwen3.8-2.4T-A95Bのチェックポイントは公開済みです。AlibabaのQwenチームは8月12日遅く、ModelScopeのコミュニティアカウントを通じて配布を開始しました。Qwen-Maxクラスでオープンウェイトとしてリリースされた初のモデルです。これまでのQwen3.5-Max、Qwen3.6-Max、Qwen3.7-MaxはいずれもAPI専用でした。
まず押さえておきたいのは、「Qwen3.8」という名前が2つの異なるものを指す点です。
| 名称 | 内容 | 入手先 |
|---|---|---|
| Qwen3.8-2.4T-A95B | オープンウェイトのベースモデル | ModelScope(ダウンロード可能なチェックポイント) |
| Qwen3.8-Max | 追加の本番向け機能を備えたクラウドホスト版 | Alibaba Token Plan、Qoder、QoderWork |
Qwen3.8-Maxはオープンウェイト版のA95Bを土台にしつつ、ポストトレーニングで強化されています。Alibabaは、実環境でのスケーリング、統一された報酬シグナル、オンラインデータバランシングから成る3段階のシステムと説明しています。公開ウェイトで得られるのはベースモデルであり、Maxの本番向けスタック一式ではありません。
「ウェイトは予告されているが未公開」とするガイドは、すでに古い情報です。Alibabaが示していた「8月10日の週」という公開予定の範囲内でリリースされました。
確定した仕様:95Bアクティブ、ネイティブ256Kコンテキスト
7月19日のプレビュー公開後、最も求められていた未公表仕様がアクティブパラメータ数でした。複数のサードパーティガイドも「未公表」と明記していましたが、現在は確定しています。2.4兆の総パラメータのうち、トークンあたり950億パラメータがアクティブです。
| 仕様 | 確認済みの値 |
|---|---|
| 総パラメータ数 | 2.4T |
| トークンあたりのアクティブパラメータ数 | 95B |
| アーキテクチャ | MoE(Qwen3.5のハイブリッド設計を継承) |
| MoEレイヤーあたりのエキスパート数 | 512 |
| トークンあたりのルーティングされるエキスパート数 | 10 |
| トークンあたりの共有エキスパート数 | 1 |
| ネイティブのコンテキストウィンドウ | 262,144トークン(256K) |
| 拡張可能なコンテキスト | 1,010,000トークン(1.01M) |
| 学習手法 | Multi-Token Prediction(MTP) |
| 初のオープンウェイトQwen-Maxリリース | はい(2026年8月12日) |
注目すべき点は2つあります。1つ目は、ネイティブのコンテキストウィンドウが広く想定されていた100万トークンではなく、256Kであることです。1.01Mという数値は拡張モードを指しており、その品質上のトレードオフについてAlibabaはまだ説明していません。2つ目はMoEのルーティングが非常に疎であることです。トークンごとに動作するのは512エキスパート中わずか11個、つまりルーティングされる10個と共有の1個です。約4%というパラメータ有効化率(2.4T中95B)により、総規模が2.4Tでも入力100万トークンあたり$2という価格が成立します。
MTP(Multi-Token Prediction)で学習されているため、対応する推論エンジンでは1回のフォワードパスで複数トークンを予測でき、スループット向上が見込めます。どのエンジンが対応するかはAlibabaから明示されていません。
自前運用の現実:2.4Tパラメータで必要になるもの
仕様は魅力的ですが、実際にロードしようとすると事情が変わります。必要量を見ていきましょう。
2.4兆パラメータは4ビット量子化でも、およそ1.2 TBのストレージを消費します。KVキャッシュ、アクティベーションメモリ、ランタイムのオーバーヘッドは含まれていません。NVIDIA H200 GPUのメモリは141 GBです。H200を8枚使っても合計1,128 GBであり、ウェイトを保持した上で実用的なコンテキストウィンドウを提供するには足りません。
| デプロイシナリオ | 必要VRAM(推定) | ハードウェア | 現実的か |
|---|---|---|---|
| フル精度(16ビット) | ~4.8 TB | H200 GPU 34枚以上 | データセンター限定 |
| 4ビット量子化 | ~1.2 TB | H200 GPU 9枚以上 | データセンター限定 |
| 1.5ビット量子化 | ~450 GB | H200 GPU 4枚以上 | 余裕は少ない。品質低下は不明 |
| Qwen3.8-27B(代替案) | 4ビットで~27 GB | コンシューマーGPU 1枚 | 可能 |
950億というアクティブパラメータ数は、トークンあたりの推論スループットには有利です。各フォワードパスで経由するエキスパートが一部に限られるためです。ただし、512個すべてのエキスパートネットワークを保存するためのメモリ量は、アクティブパラメータ数によって減りません。GEO Toolboxの表現を借りれば、「スパースな有効化は大規模運用を安くするのであって、所有を安くするものではない」ということです。
ローカルまたは単一サーバーでの運用なら、現実的な選択肢はQwen3.8-27B variantです。Qwen3.8と同じ学習系譜を共有し、4ビットならコンシューマーGPU 1枚に収まります。2.4Tモデルは研究用途とデータセンター向けのモデルです。
自前運用よりAPIが合理的な理由
2.4TのMoEモデルを自前でホストすることは、ほとんどのチームにとって現実的ではありません。実用的なアクセス手段はAPIです。AlibabaのModel StudioではQwen3.8 Maxの料金を、入力100万トークンあたり$2、出力100万トークンあたり$6としており、前世代モデルと最も近い中国競合の両方より安価です。
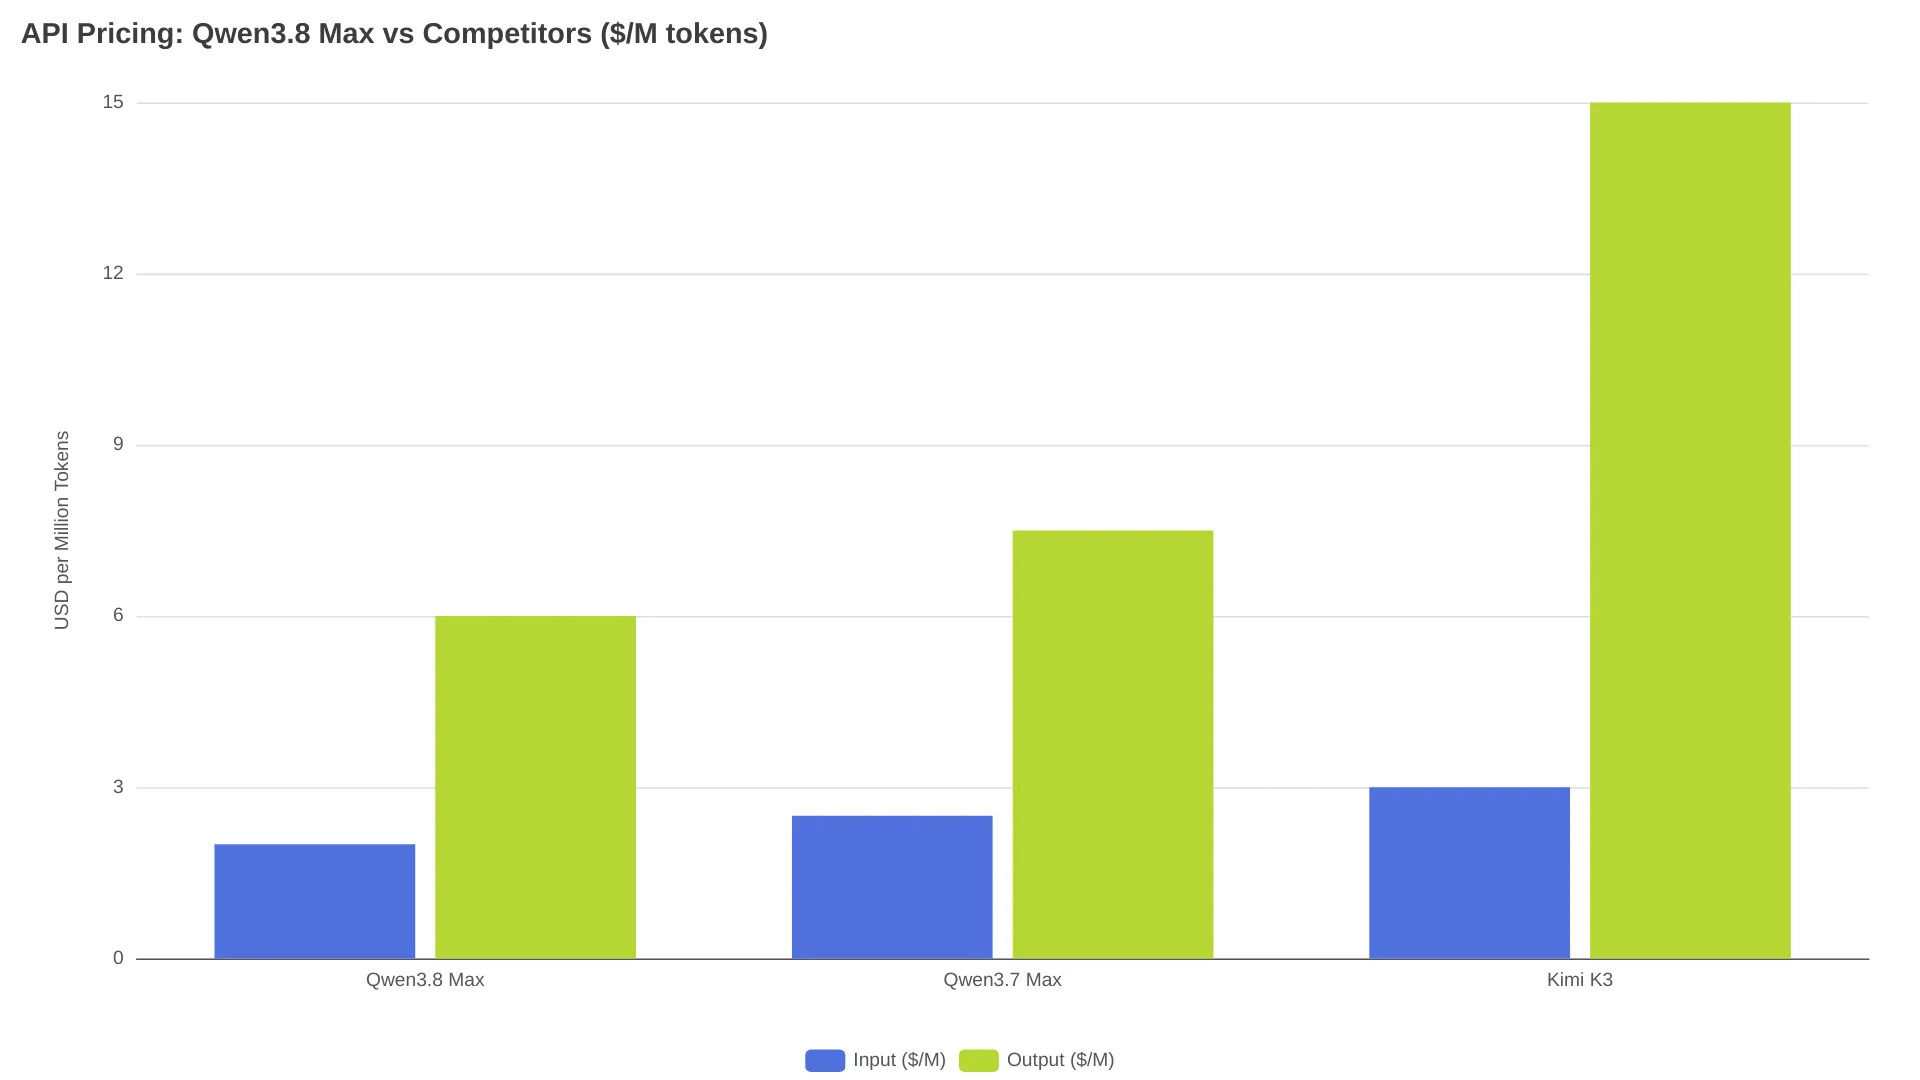
| モデル | 入力($/M) | 出力($/M) | コンテキスト |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | ネイティブ256K(1.01Mまで拡張可能) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
トークン単価のAPIに加え、Alibabaは3つのサブスクリプションプランを用意しています。
- Lite:$6/月(約10,000クレジット)
- Standard:$18/月(約40,000クレジット)
- Pro:$68/月(約160,000クレジット)
Token PlanのエンドポイントはOpenAI互換とAnthropic互換の両方のAPI形式をサポートしているため、Claude Code、Cursor、OpenCodeなどはクライアント側を変更せずに利用できます。Alibabaのコーディング製品であるQoderでは、オフピーク時間帯(14:00-00:00 UTC)に通常料金の0.01倍まで下がるプロモーション用クレジットレートも提供されています。ただし、これはローンチ時の割引であり、恒久的な料金ではありません。
サブスクリプションには注意点もあります。Qwen3.8 Maxの推論モードは出力が長くなりやすく、クォータの消費が速いというコミュニティ報告も一貫しています。
「Qwenはとにかく考えすぎる傾向がある。」 - u/darko、r/Qwen_AI
同じRedditスレッドでは、Lite契約者の1人が約5,000万トークンを使い、2日未満で週次枠を使い切ったと報告しています。Proプランのユーザーは、キャッシュヒット率94%の状態で7つの並列エージェントを動かし、1日で5億トークンを消費したと説明しています。reasoning_effortパラメータはlow、medium、xhighに設定でき、モデルが生成する推論出力の量、ひいてはクレジット消費の速さを直接左右します。あるユーザーのテストでは、lowに設定するとリクエストあたりの思考時間はおよそ10秒まで短縮されました。
コストの詳細な内訳は、Qwen3.8 Max API pricing guideを参照してください。
ベンチマークで見える強みと弱み
Alibabaは、Qwen3.8 MaxをFable 5およびGPT-5.6 Solと比較したベンチマーク結果を公開しています。評価は一様ではなく、ベンダー公表値と独立評価の差も無視できない大きさです。
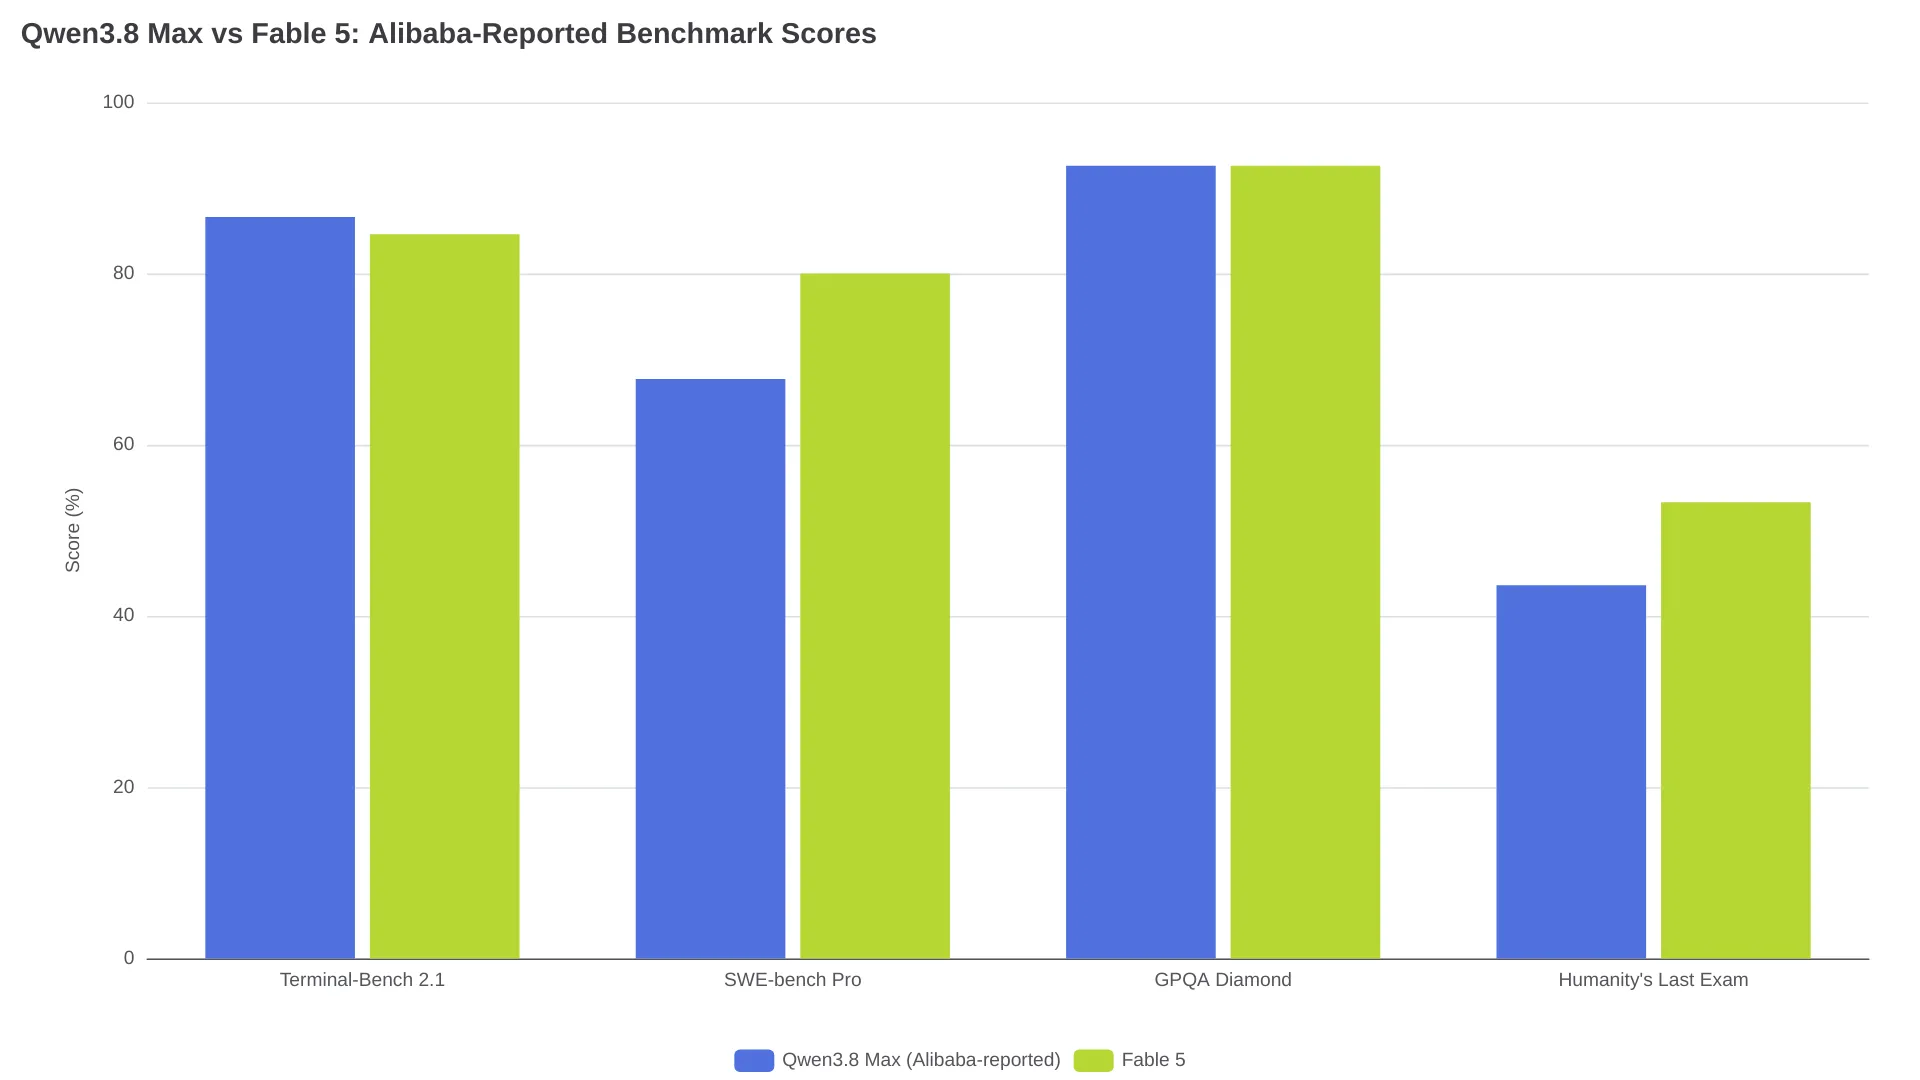
| ベンチマーク | Qwen3.8 Max(Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Qwenより高い(正確なスコアは未公表) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Qwenより高い |
| Humanity's Last Exam | 43.6 | 53.3 | 未公表 |
独立評価では異なる結果が出ています。Artificial AnalysisはQwen3.8 MaxのTerminal-Bench 2.1を81.3%と測定しており、Alibaba公表の86.6%から5.3ポイント低い値です。この独立スコアでは、QwenはFable 5(84.6%)およびKimi K3(85.0%)の後ろで、およそ全体10位となります。
一方でQwen3.8 Maxが優位を保つ領域もあります。SWE-bench Proの67.7%はGPT-5.6 Solの64.6%を上回り、マルチモーダルのスコアも強力です。MathVisionは95.2でFable 5の92.7を上回り、LogicVistaも91.9対85.7です。またDeepSWE 1.1ではQwen3.7 Maxの21.6から56.6へ大幅に改善しており、ソフトウェアエンジニアリングのエージェントタスクで実質的な進歩があったことを示しています。
コミュニティの反応も、この評価の分かれ方を反映しています。考えすぎを指摘する同じRedditスレッドには、次のような声もありました。
「出力の品質は神レベルだった。」 - u/TangerineLogical9779、r/Qwen_AI
速度については、負荷や時間帯に応じて毎秒8トークンから60トークンまで変動し、安定しないと報告されています。Kimi K3との詳細な比較は、Qwen3.8 Max vs Kimi K3 comparisonを参照してください。
よくある質問
Qwen3.8-Maxのウェイトはダウンロードできますか?
はい。Alibabaは2026年8月12日、ModelScopeでQwen3.8-2.4T-A95Bのチェックポイントを公開しました。これは初のオープンウェイトQwen-Maxクラスモデルです。クラウドホスト版のQwen3.8-Maxには、このベースモデルに加えて本番向けの追加機能が含まれます。
オープンウェイトのライセンスは何ですか?
執筆時点では正確なライセンスは確認されていません。Qwen3.6がApache 2.0で提供された前例から同ライセンスの可能性はありますが、Qwen3.7 Maxはクローズドのままでした。商用利用を前提に構築する場合は、ModelScopeリポジトリ上の実際のライセンスファイルを確認してください。
Qwen3.8-2.4T-A95BとQwen3.8-Maxの違いは?
Qwen3.8-2.4T-A95Bは、2.4Tパラメータ、95Bアクティブ、MoEアーキテクチャ、ネイティブ256Kコンテキストを備えるオープンウェイトのベースモデルです。Qwen3.8-Maxはこのモデルをベースに、統一報酬システムやオンラインデータバランシングを含む本番環境向けポストトレーニングを加えたAlibabaのクラウド版です。オープンウェイトで得られるのはベースモデル、APIで利用できるのは強化版です。
Qwen3.8-Maxをローカルで動かせますか?
実用上は困難です。4ビット量子化でもモデルにはおよそ1.2 TBのVRAMが必要で、ウェイトだけでH200 GPUを9枚以上使います。コンテキストキャッシュ用の余地はありません。1.5ビット量子化しても数百GBが必要です。コンシューマーGPU 1枚に収まるQwen3.8-27B variantが、現実的なローカル向け代替案です。
Qwen3.8 Max APIの料金はいくらですか?
Model Studio APIの料金は、入力100万トークンあたり$2、出力100万トークンあたり$6です。サブスクリプションはLiteの$6/月からProの$68/月まで用意されています。Qoderではオフピーク時間帯に最大98%オフのプロモーション用クレジット割引を提供していますが、これはローンチ時の価格であり、変更される可能性があります。