 AIREITER
MiniMax自身がH3のモデルカードで「最終出力の品質にとって重要」と位置づける前処理レイヤー。一方、H3のプロンプトを巡る220アップボートのRedditスレッドでは、意味不明な会話が出るという不具合報告が並んでいます。本稿では、MiniMax H3の公式形式をクリエイターの検証例・失敗報告と照らし合わせます。結論から言えば、カメラや参照素材の制御は比較的安定している一方、会話と音声は不安定です。そして、意図的に公式構文から外したほうが良い結果になるケースもあります。
MiniMax H3の公式プロンプト形式とは
MiniMax H3の公式プロンプトは、integrated_multimodal_description、overall_soundscape、non_diegetic_musicの3フィールドで構成される構造化ドキュメントです。タイムコード付きショット、継続的な話者ID、<d>の会話タグを含めます。これは、通常はホスト型の前処理機構が生成する構造化中間表現、H3-Context-IRをH3が前提としているためです。この機構はオープンウェイト版には含まれていません。ホストAPIでは曖昧な自然言語の依頼を自動で書き換えてくれますが、ローカルで33Bのオープンウェイトを動かす場合(SGLang、vLLM、Diffusers、ComfyUI)は、この構造を自分で記述する必要があります。
MiniMaxは公式GitHubリポジトリで、持ち運んで使えるh3-prompt-writingスキルも提供しています。base-en.txtとref-en.txtという2つのガイドファイルで構成され、外部APIを呼び出さず、任意のコーディングエージェントから読めます。クリエイターはこれをClaudeやCursorに読み込ませ、自然言語の企画を完全なH3形式へ変換しています。映画的なクリップを作るこのワークフローは、@AI__TSUBAKIがまさにそのまま記録しています。
プロンプト作成前に押さえる制約
| 制約 | 値 | プロンプトへの影響 |
|---|---|---|
| クリップ長 | 4~15秒、24 FPS | タイムスタンプは厳密に昇順とし、動画尺の範囲内に収める |
| 音声 | 32 kHzステレオ、映像と同時生成 | サウンドスケープとBGMのフィールドは必須。N/Aは使用可能 |
| 解像度 | 標準は768p。2KはH3-Regenerate-2K経由(API限定) | まず768pで検証し、プロンプト確定後に2Kへ回す |
| タスク種類 | T2VA(テキスト)、I2VA(0.00秒の開始フレーム)、FL2VA(開始・終了フレーム)、L2VA(終了フレーム)、Ref2VA(オムニリファレンス) | 各形式に固有のアラインメント文がある |
| 参照上限 | 画像9枚+動画3本+音声3本、合計12ファイル。メディア種別ごとに合計15秒以下 | 参照を増やせば制御が良くなるとは限らず、ルーティングが増えるだけの場合もある |
| プロンプト量 | 公式例は300~700語。純粋なテキスト動画生成は約7,000文字まで | 参照なしで短すぎるプロンプトは、公式マニュアルでも失敗要因として挙げられている |
3フィールド、カメラ指示1つ、画面に映る話者と引用符付きの台詞、BGMなし。これだけなら、実用最小限のプロンプトは10行で書けます。
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/Aフィールドごとの詳しい構文、タグ、アラインメント文、テンプレートは、こちらのMiniMax H3プロンプトガイドで解説しています。本稿で確認したいのは、その構文を守るコストに見合う効果があるかどうかです。
公式形式が約束する3つのことを検証する
公式ガイドには、明示されてはいないものの3つの約束があります。引用した報告を見る限り、前半2つには比較的良い結果が出ていますが、音声の追従性は別問題です。
約束1:構造化すれば、狙った出力に近づける
この点の裏付けはもっとも強力です。Xのクリエイター@AIWarperは、公式形式へ切り替えた前後比較を投稿し、次のように述べています。
「MiniMaxが公開したプロンプトガイドには、強く従うことをおすすめします。期待どおりの結果を得るうえで、本当に大きな助けになります。……私の前の投稿は、推奨されたプロンプト構造に従っていませんでした。」— @AIWarper、306 likes
第三者によるテストログにも、細部レベルで同じ傾向が見えます。00:05.000ちょうどでのカットを指定し、その通りに切り替わったこと。台本化した商品レビューの台詞を一語一句そのまま発話したこと。さらに、6秒のI2VAクリップで開始フレームの構図を安定して維持したことです。絵コンテでも同様で、@aimikodaのボードはショットを順番に導く指示として追従され、@nanyuan0412のボードも即興的な解釈を挟まずに再現されました。例外は記述を忘れた音声フィールドで、そこはほぼ無音になっています。
繰り返し報告される問題は、拒否ではなく尺とテンポです。u/Relevant_One_2261は「最大の問題はペーシングだった」と書いています。動画尺に収まらない台詞や、間隔が詰まりすぎたタイムスタンプが、典型的な構造上の失敗になります。
約束2:欲しい結果を書くより、カメラの動きを書くほうが通る
これは、構図崩れを修正した事例で確認できます。r/StableDiffusionのユーザーは、歩く被写体の全身を画面に収めるため「entire subject remains visible throughout」と素直に指示しましたが、何度試しても失敗しました。そこで結果の説明を、H3が理解しやすいカメラ文法に置き換えます。
「被写体が前方へ歩くのと同じ速度で、カメラは大きな振幅で引いていく。全身構図を維持する。」— u/Powerful-Goal52、元投稿者が成功を確認
これはH3のカメラ制御にある3つの軸、すなわち動作タイプ・振幅・速度にそのまま対応します。また、1ショットにつきカメラ指示は1つというルールにも沿っています。欲しい画と、H3が追従しやすい命令の対応は次の通りです。
| 欲しい結果 | H3が追従しやすい命令 |
|---|---|
| 歩いている人物を常に全身で映す | 被写体の歩行速度に合わせて、大きな振幅でPull Out |
| 構図を崩さず、穏やかに強調する | 小さな振幅・遅い速度でPush In |
| 静止した被写体の周囲の環境を見せる | 中程度の振幅でTruck LeftまたはTruck Right |
| チルトせずにカメラ高を変える | 遅い速度でPedestal Up / Pedestal Down |
公式プロンプトガイドは、Zoom、Push、Pull、Pan、Tilt、Truck、Pedestal、Arc、Tracking、Static、Shake、Roll、POVという13系統の動作タイプを挙げています。それぞれに振幅と速度を指定します。Zoomは焦点距離を変える動き、Pushはカメラ自体を物理的に動かすこと。この違いは実際の生成で効くため、同じ意味の言葉として扱うべきではありません。
約束3:音声を分離すれば、きれいに制御できる
ここが最も弱い層です。劇中音のサウンドスケープと、劇伴であるノンダイジェティック音楽を分ける設計自体は理にかなっています。しかし、指示への追従は一貫しません。
「これを使っているけど、20%くらいの確率でなぜか音楽が追加される(笑)」— u/TheElectriking、
non_diegetic_music: N/Aについて
この引用元である220アップボートのスレッドには、ほかにも典型的な問題が並びます。クリップ境界で出る音声アーティファクト、キャラクターがランダムな意味不明の言葉を話す現象、台詞を言う人物の取り違えです。u/krigeta1はカスタム音声参照を3つ渡したにもかかわらず、「ランダムな声になるか、キャラクターに割り当てた音声にならない」と報告しています。別のスレッドでは、本来は画面上の人物が話すべき台詞をオフスクリーン音声として読んでしまう問題が、話者IDを画面内の人物へ明示的に紐付けることで解決しました。
画面内テキストにも同じ脆さがあります。コミュニティWikiは「完全一致のテキストは不安定」と表現しており、ブランド上重要な文字は画像参照として渡すか、後処理で合成したほうがよいとしています。反対の評価もあります。@web4mikoは自身のテストで、テキストと文脈理解に関してH3は「Seedance 2.0にすら勝てない」と述べています。引用した報告全体を見ると、音声ルーティング、厳密な文字列、情報量の多い文脈が繰り返し弱点として現れます。
公式構文をあえて崩すべき場面
公式形式からの逸脱で有効だった例は、比較検証や一次報告のなかで3つ見つかります。完全な構造化に時間をかける前に、知っておく価値があります。
<d>タグより引用符が効くことがある。 r/StableDiffusionに投稿された比較検証(約105アップボート、81コメント)では、投稿者がガイド指定の<d>[Language]...台词...</d>タグを外し、通常の引用符付き台詞にしたところ、きれいな発話が得られました。一方、タグ形式では頼んでもいない音声が追加されたといいます。類似テストを行ったコメント投稿者も同意しています。
「公式の会話プロンプトはひどくバグっている。……引用符を使う方法も完璧ではないが、
<d></d>タグよりははるかに問題が少ない。」— u/networking_noob
実務的には、学習済みの正規ルートである<d>をまず試すべきです。ただし、発話が崩れる、不要な音声が増えるといった症状が出たら、プロンプト全体を書き直す前に、同じ台詞を引用符形式で再生成してみるのがよいでしょう。
non_diegetic_music: N/Aだけでも有効な制御になる。 u/Nextilは、「ほかの構造をほとんど無視しても」これで音楽を防げると報告しています。ほかに何も構造化しないとしても、ここだけは書く価値があります。不要なBGMは、引用した報告で繰り返し見られる不満です。
参照素材が多い案件では、テキストは増やすより減らす。 画像がキャラクターの同一性を担保し、動画が動きを担うなら、プロンプトに残る仕事は参照先の指定と新しいアクションだけです。@aimikodaの拡散されたテンプレートの一つは1,300以上のブックマークを集めていますが、まさにこの理由でミニマルに作られています。また、@CharaspowerAIは、MiniMax自身のDesignエージェントが「act as an expert FPV director and turn this into something viral」という1行を自動的に完全な構造化プロンプトへ展開する様子を示しました。参照素材のルーティングブロックは、たとえば次のようになります。
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
ここまで指定したら、残りのプロンプトでは新しいショットだけを説明します。これらの報告から見える実用的な流れは、まず静止画を固め、参照素材に大部分を任せ、変化させる部分だけに言葉を使うことです。
マニュアルでは解決しない失敗の切り分け
公式プロンプトガイドが扱うのは構文までです。生成結果が壊れたとき、何を確認すべきかまでは教えてくれません。以下の表は、先述した失敗報告をもとに整理したものです。
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
N/Aを指定しても音楽が入る | あるユーザーは、実行の約20%で漏れが起きると観測 | 再生成する。プロンプトのどこにも音楽の「ムード」を求める記述を入れない |
| 別のキャラクターが台詞を話す | 話者と音声のルーティング競合 | 話者IDを、画面に映っているキャラクターへ明示的に紐付ける |
| 画面内の台詞がオフスクリーンのナレーションになる | リップシンクとの関連付けがない | 話者が画面に映っていると記述する。純粋なナレーションなら「lips remain closed」を追加する |
| 音声参照が無視される | 3クリップ・15秒の上限超過、または役割未指定 | 各クリップに役割を割り当て、参照音声の合計尺を短くする |
| ローカルモデルが中国語の会話を無視する | ComfyUIがQwenトークナイザーを再利用している、またはシェルのエンコーディングでテキストが壊れる | リポジトリのトークナイザー(公式要件)+Unicodeを安全に扱える送信+<d>[Chinese] 台词</d>を使う(コミュニティ報告の修正法) |
| 長いワンショット(>15秒)が崩れる | 4~15秒の設計範囲外。物体が平板化し、連続性が漂流する | 15秒単位に分割し、セグメント間の連続性を計画する |
ローカル導入に関する行は、特に見落としやすい点です。@eternityspringの報告では、「H3が中国語を話さない」原因はプロンプトではなく、トークナイザーの再利用とエンコーディングでした。
トークン、試行回数、移植性というコスト
構造化にコストがないわけではありません。公式リポジトリは、再現可能な3ケースについてContext-IRのトークン使用量を公開しており、参照数が増えるにつれ数値は急増します。
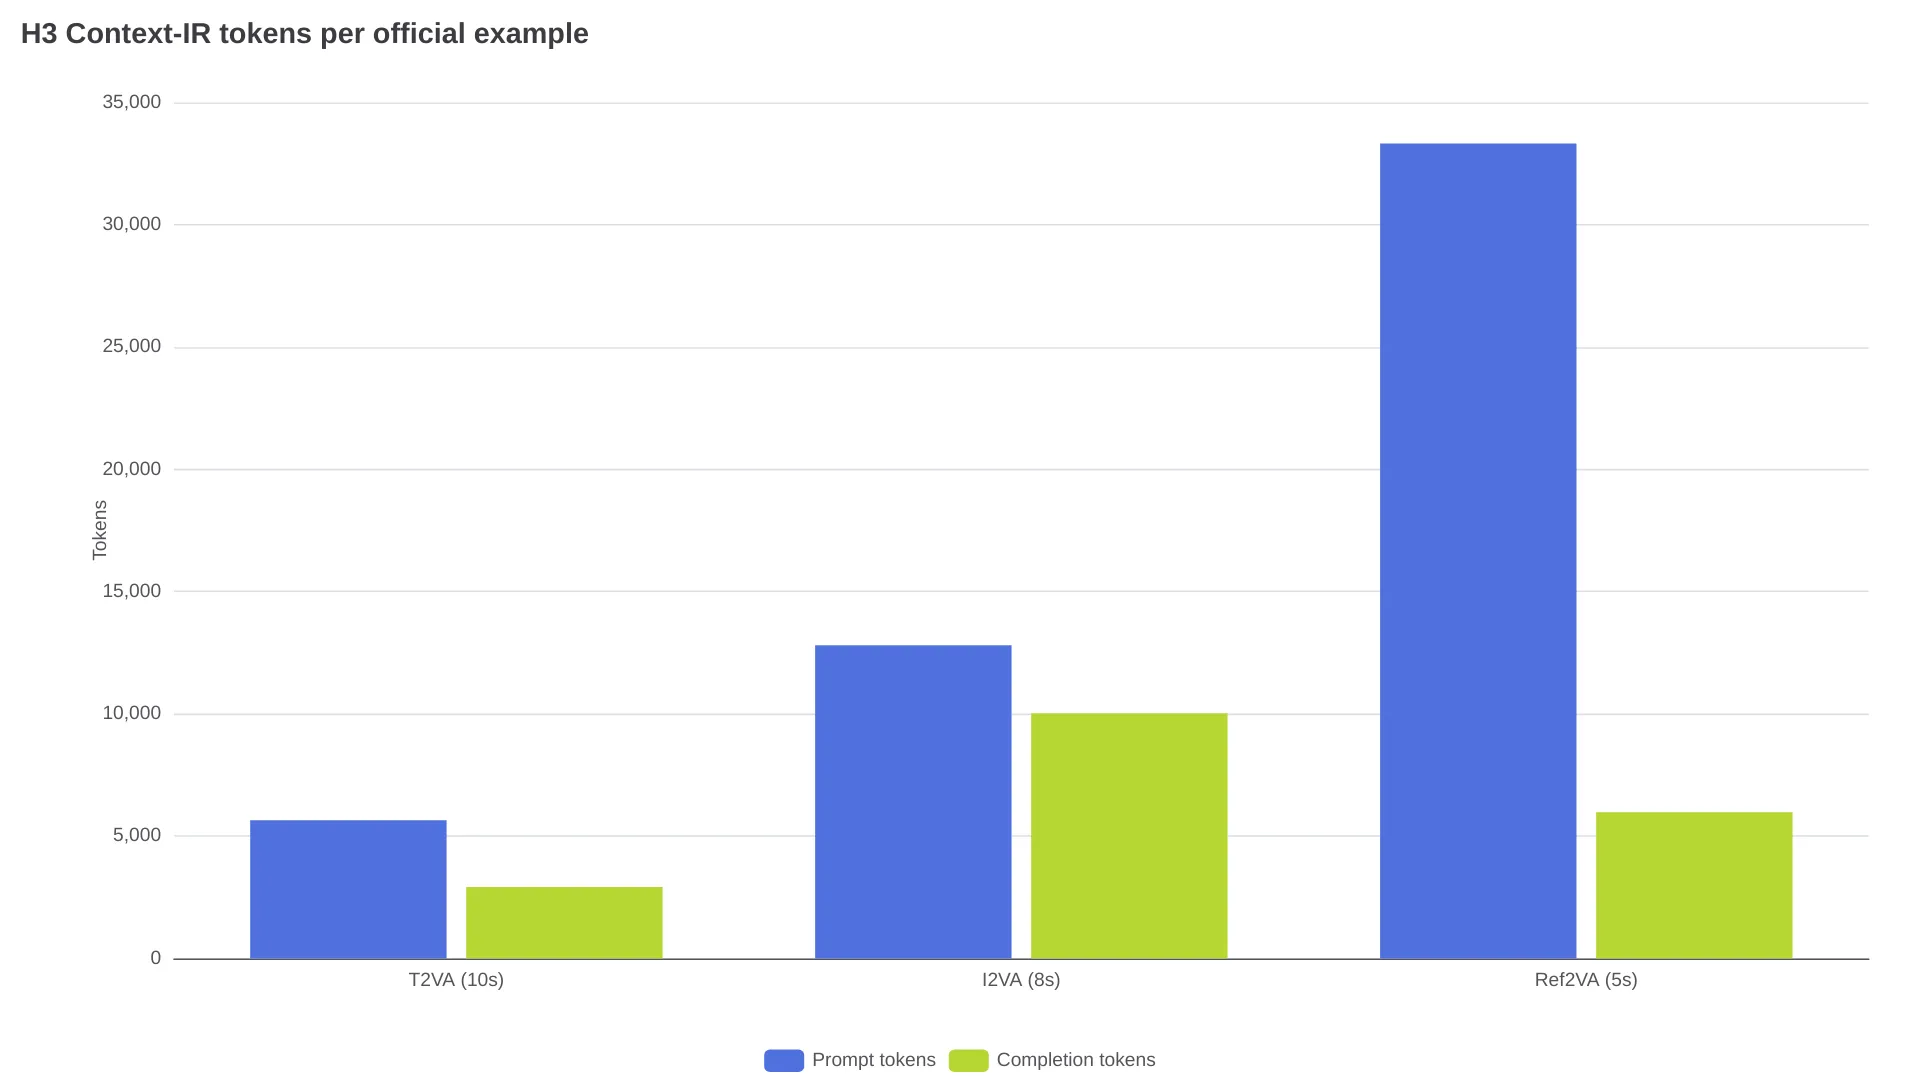
テキストのみの生成では前処理に8,565トークンを使います。マルチモーダルの参照案件では39,299トークンに達し、そのうち33,323トークンがプロンプト側です。ローカル実行ではこれが前処理の待ち時間になり、生成秒単価で価格が示されるホスト型ワークフローでも、処理オーバーヘッドとして効いてきます。時間的コストも無視できません。Xのあるクリエイターは、3人の人物を周回するカメラプロンプトを完成させるまで48時間を費やした記録を公開しています(@LoveUolanda)。安く反復するなら、まず768pで作業するのが妥当です。6秒のテストは約$0.68で、プロンプトが固まってから2Kへ送ります。リレーのモデルページでは、MiniMax H3の料金として768pは$0.1125/秒、2Kは$0.1825/秒と掲載されています。
もう一つの隠れたコストが移植性です。H3のフィールド、話者ID、タグは標準規格ではなく、H3固有の方言です。クロスモデル比較の解説によれば、Veo 3.1はインラインのSFX:ラベルを含む通常の段落形式を求め、Seedance 2.0は6スロットの説明形式を使います。どちらもH3のフィールド、話者ID、タグを受け付けません。H3向けに作ったプロンプトライブラリは、ほかのモデルではコピー&ペーストではなく、書き直しになります。
MiniMax H3プロンプトのFAQ
MiniMax H3では構造化プロンプトが必須ですか?
いいえ。ホストAPIではContext-IRが自然言語の依頼を内部表現へ書き換えます。構造化の重要性が高いのは、ローカルでオープンウェイトを使う場合や、正確なカット、タイムスタンプ、話者ルーティングが必要な場合です。
MiniMax H3が勝手にBGMを入れるのを止めるには?
末尾にnon_diegetic_music: N/Aを指定し、プロンプト内のほかの場所で音楽のムードを求めないようにします。それでも漏れることはあるため、再生成は通常の対応になります。
MiniMax H3のプロンプトはどのくらいの長さにすべきですか?
MiniMaxの公式例は300~700語で、純粋なテキスト動画生成は約7,000文字まで受け付けます。ただし、同一性や動きを参照素材が担っている場合、プロンプトは長くするのではなく短くすべきです。
H3用プロンプトをSeedanceやVeoで流用できますか?
できません。H3の名前付きフィールド、話者ID、タグはモデル固有です。Seedanceは6スロット形式、Veoは通常の段落形式を使うため、対象モデルごとに書き直す必要があります。
ローカルのH3で英語以外の会話が無視されるのはなぜですか?
多くの場合、原因はモデルではなくツールチェーンです。Qwenトークナイザーを再利用している構成や、Unicodeを壊すシェル環境では、生成前に台詞が壊れます。リポジトリ公式のトークナイザーと<d>[Language]形式の会話指定を使用してください。
結論:公式形式を学ぶべき人
| やりたいこと | 判断 |
|---|---|
| 会話を含むマルチショット映像 | 完全な形式を学ぶ価値あり。音声の再試行と引用符への切り替えも見込む |
| 商品・静止画のアニメーション(I2VA) | 簡易版で十分。アラインメント文+動き+音声フィールドを使う |
| 絵コンテやキャラクター一貫性のあるシリーズ | 推奨。参照素材が大部分を担うので、プロンプトは最小限かつルーティング可能に保つ |
| 単発の短いクリップ、カジュアル用途 | 大半は不要。通常の説明文+non_diegetic_music: N/Aで対応できる |
| 複数モデル共通のプロンプトライブラリ構築 | 非推奨。モデルごとの方言に合わせたバージョンが必要なので、モデル別に書く |
マルチショット、タイムスタンプ指定、参照素材を軸にした制作なら、公式形式を学ぶ意味があります。そこでは追従性が確認され、再現もしやすいからです。単発クリップでは大部分を省略してよく、会話中心の音声では完全な追従より再試行を前提にしたほうが現実的です。
コミュニティ内でも、このトレードオフへの評価は割れています。同じ月に、カメラプロンプトを48時間磨き込んだ例がある一方で、880アップボートの投稿では、あるコメント投稿者が「マニュアルを読むのが実際に楽しかった」と書いています。モデルの音声フィールドへの追従がカメラ制御に追いつくまでは、実用的な落としどころは明確です。構造はエージェントに下書きさせ、音声フィールドは自分で確認し、2Kに進む前に768pで安くテストしましょう。