 AIREITER
検索では「3-5」と入力されがちですが、GoogleのモデルIDはgemini-3.5-transcribeとgemini-3.5-transcribe-liveです。API自体は実在し、料金も安価です。ただし選ぶべきかどうかは、読みやすい文章が欲しいのか、発言を追跡できる記録が必要なのか、あるいはライブ字幕を求めているのかで決まります。
Gemini 3.5 Transcribe APIレビューの結論を早見表で確認
録音ファイルの文字起こし、音声入力、短時間のライブ字幕体験を試すなら、Gemini 3.5 Transcribeは有力な候補です。一方、完全に忠実な逐語録や長時間のライブ記録にそのまま使うのはおすすめしません。Smart transcriptionは発話を編集し、ライブセッションには話者ラベルと単語単位のタイミング情報がなく、サービス自体もパブリックプレビューの段階にあるためです。
| 必要なもの | 使うもの | レビュー判断 |
|---|---|---|
| アップロードした会議、通話、ポッドキャストの文字起こし | gemini-3.5-transcribe | 使ってよい。発言内容が重要なら逐語モードを選ぶ |
| 整った音声入力や読みやすい会議メモ | Smartモードを有効にした録音モデル | 編集を許容できるなら確認付きで使う |
| 話している最中の字幕 | gemini-3.5-transcribe-live | 短いインタラクティブセッションのプロトタイプに使う |
| 話者ラベルと単語単位のタイミング情報 | 逐語注釈を付けた録音モデル | 制限を理解したうえで使う。30分制限と3人以上の話者対応は実験的 |
| 法務、医療、コンプライアンス、アーカイブ用の原本 | 人手確認を組み込んだ逐語文字起こしパイプライン | 唯一の原本としては使わない |
この記事は、管理されたWERベンチマークではなく、公開情報をもとに実運用上の判断材料を整理したAPIレビューです。Gemini 3.5 Transcribe APIのセットアップと料金ガイドではリクエストの流れを解説していますが、こちらでは最初の呼び出しに成功した後に問題になりやすいトレードオフに焦点を当てます。
モデルファミリーの正体は、仕様の異なる2つのAPI
gemini-3.5-transcribeはInteractions API経由でアップロード済み、または録音済みの音声を処理します。一方、gemini-3.5-transcribe-liveはLive API経由でストリーミング音声を処理します。
録音音声の文字起こし:gemini-3.5-transcribe
保存性の高い文字起こしを作るなら、録音向けのこちらがより高機能です。Googleの音声文字起こしドキュメントでは、85以上の言語に対応した自動言語検出、カスタム語彙、Smart出力と逐語出力、話者ダイアライゼーション、単語単位のタイムスタンプが案内されています。
通常の音声処理では最大1時間まで対応します。話者ダイアライゼーションまたは単語単位のタイムスタンプを有効にすると上限は30分に下がります。また、モデルリファレンスには最大8人の話者が記載されていますが、3人以上の話者の識別は実験的機能です。
音声入力、インタビュー、短い通話には適しています。ただし、話者の割り当てと時間情報が必要な長時間の会議では、アプリケーション側で分割してから結合する必要があります。
ライブ文字起こし:gemini-3.5-transcribe-live
ライブ版は、録音版をWebSocketで再現するためのものではなく、逐次表示する字幕向けに設計されています。Googleのライブ文字起こしのドキュメントでは、中間結果と確定済み文字起こしイベント、自動言語検出、カスタム語彙、Smartモード、自動・ハイブリッド・手動の音声区間検出が説明されています。
ライブセッションは連続10分までで、ライブストリーミングには話者ダイアライゼーションも単語単位のタイムスタンプもありません。音声形式も、16-bit PCM、16 kHz、モノラル、リトルエンディアンのraw音声に限定されます。字幕のプレビューには向いていますが、長時間の通話記録では、再接続、セッション間の結合、確定前テキストの扱いをアプリ側で実装しなければなりません。
レビューの評価を分ける機能上のトレードオフ
Gemini 3.5 Transcribeの特徴は、発話を「インテリジェント」に整える点です。ただし、この機能を使うと精度の意味が変わります。音声入力では整った文章のほうが便利でも、発言を文字どおり残したい用途には不向きになり得ます。
Smartモードは編集機能であり、原本ではない
GoogleのSmartモードは、フィラー、どもり、言い直しの途中で止まった発話を取り除き、話し言葉による訂正を解決します。さらに、句読点、数字、箇条書き、段落も整形します。「火曜日、いや水曜日に会いましょう」という発話は、言い直しを残さず「水曜日に会いましょう」と出力される可能性があります。
下書きメール、ボイスメモ、読みやすい会議メモには便利です。しかし、ためらい、元の言い間違い、発言された順序そのものに意味がある場合はリスクになります。
公式の文字起こしガイドにも境界は明記されています。Smartモードは、話者ダイアライゼーションや単語単位のタイムスタンプと併用できません。APIの仕様上、読みやすい文章と追跡可能な注釈のどちらかを選ぶ必要があります。
原本には逐語文字起こしを保存し、読者向けにはSmartモードの出力、または後処理で整えた別版を作るのが安全です。この非互換性はプロンプトで解決できません。出力仕様そのものによる制約だからです。
タイムスタンプと話者ラベルは追跡性を高めるが、使える条件を狭める
録音音声では、逐語モードで設定すると、単語のテキスト、オフセット、話者IDを含むword_info注釈を返せます。字幕、再生位置へのシーク、話者ごとの発話時間の計算、証拠確認などに役立つ情報です。
| 要件 | 録音版 | ライブ版 |
|---|---|---|
| 話者ダイアライゼーション | 対応。ドキュメント上は最大8人、3人以上は実験的 | 非対応 |
| 単語単位のタイムスタンプ | 対応 | 非対応 |
| 注釈付きのSmart出力 | 非対応 | 単語注釈との併用は非対応 |
| 時間の上限 | 通常1時間。話者ダイアライゼーションまたは単語タイムスタンプ使用時は30分 | 連続セッションごとに10分 |
| 精度に関する注意点 | 単語タイムスタンプによって精度が下がる可能性があるとGoogleが警告 | 確定前のテキストは確定時まで変わる可能性がある |
したがって、「タイムスタンプに対応」というだけでは、導入判断の材料として不十分です。機能自体は存在しますが、音声ファイルの上限を下げ、認識精度とのトレードオフが生じる可能性があります。大規模な会議でドキュメント上の最大値をそのまま信頼性の保証とみなさず、実際の話者識別性能をテストしてください。
カスタム語彙と言語検出
どちらのAPIも、自動言語検出とカスタム語彙に対応しています。Googleは85以上の言語とコードスイッチングを案内しており、アプリケーション側ですでに言語が分かっている場合は、en-USのようなヒントを渡すことを推奨しています。
カスタム語彙には最大1,000語を登録できますが、Googleの実用上の案内では、最良の結果が得られやすいのは通常100語までです。登録するのは、製品名、略語、固有名詞、専門用語などに絞り、一般的な単語は含めないほうがよいでしょう。
「対応している」ことと、アクセント、方言、騒がしい部屋、文中での言語切り替えに対して高品質であることは別です。初期のReddit上の議論では、ライブ版が混在言語に対応できるかという質問も出ていました。これは失敗の証拠ではなく、テストケースとして参考になる話です。
「動画を少し遅らせてもいいので、字幕が話されている言葉と同期してほしい」 — u/WaterObjective5107、Reddit
このコメントが示しているのは、WERでは測れないライブ製品特有の問題です。字幕は言語的に正しくても、動画と同期していなければ体験としては不自然に感じられます。
公表された精度データから分かること
Googleが公開している数値は期待できる内容ですが、Gemini 3.5 Transcribe全体に当てはまる単一のスコアではなく、複数の評価条件における結果です。自社のマイク、アクセント、用語、話者構成でのテストを省略できるものではありませんが、本格的なパイロットを始める根拠にはなります。
| 評価条件 | 公表WER | 分かること |
|---|---|---|
| Artificial Analysis、ストリーミング | 4.0% | 引用されたストリーミング平均。遅延や話者識別のスコアではない |
| Artificial Analysis、非ストリーミング | 2.6% | 同社のテスト条件における録音音声の平均 |
| FLEURS、ストリーミング | 5.50% | 選定されたロケールを対象にした多言語ストリーミング結果 |
| FLEURS、非ストリーミング | 5.04% | 別条件での多言語録音音声の結果 |
これらの数値は、Googleのローンチ発表に掲載されています。同発表では、Chirp 3と比べて最終文字起こしまでの時間が70%改善したとも説明されています。ただし、これはGoogleによる主張であり、あなたのワークフローを第三者が検証した結果ではありません。
2.6%と5.50%の差は矛盾ではありません。APIの経路、データセット、言語構成、ストリーミング条件が異なるためです。集計WERだけに頼らず、氏名、注文ID、日付、金額、製品用語、話者の切り替わりなど、間違えるとコストが発生する項目を重点的に評価してください。
初期のコミュニティ報告では、言語切り替え、話者の割り当て、タイムスタンプの挙動、長時間録音の完了性がテスト項目として挙げられています。あるXのテスターは、20分のクリップを送ったところ5分しか返ってこなかったと報告しました。いずれも方向性を示す体験談であり、管理された製品評価の事実ではありません。(Xの報告)
セットアップガイドだけでは分からない本番運用の壁
ファイルのアップロードに成功した、あるいはWebSocket接続が確立したとしても、それは通信経路が動いたことを示すだけです。本番で問題になるのは、その後に現れる変化するライブテキスト、経路ごとの制限、認証情報の扱い、プレビュー版であること、そして信頼できる文字起こしをどう保存するかという方針です。
ライブ字幕には状態管理が欠かせない
ライブレスポンスには2つの役割があります。interim_input_transcriptionは字幕プレビュー用の変化する推定結果で、input_transcriptionは確定済みセグメントです。後者だけを永続的な文字起こしの状態に追加します。
状態管理は次のように設計します。
- 中間結果を受け取るたびに、画面上の字幕を置き換える。
- 確定済みテキストだけを確定済みの文字起こしに追加する。
- 10分のセッション上限に達する前に更新または再接続する。
- セッションの境界を明示し、重複除去ロジックを使ってセッション間のテキストを結合する。
- 確定前のテキストを、取り消しのできない処理に使わない。
ブラウザーやモバイルのクライアントでは、一時トークンを使い、長期間有効なAPIキーをフロントエンドのコードに露出させないでください。トークンを発行し、権限や有効範囲を制限するバックエンドが必要です。そのうえで、アーキテクチャに合うなら音声をクライアントからLive APIへ直接送ることもできます。接続エラー、確定までの遅延、重複セグメントを監視しましょう。
録音ワークフローには原本の扱いを決める必要がある
モードを選ぶ前に、必要な出力仕様を決めてください。読みやすい文章にはSmartモードを、発言内容、話者、オフセットを正確に残したい場合は逐語モードを使います。
逐語結果と注釈を保存し、検索、要約、顧客向けメモには別途クリーンアップ済みの文字起こしを生成します。処理工程は増えますが、削除されたフィラーや書き換えられた言い直しを後から復元しようとするより安全です。
プレビュー版であることが導入判断を左右する
GoogleはGemini 3.5 Transcribeを、2026年8月26日にパブリックプレビューのモデルファミリーとして発表しました。Googleのモデルリファレンスには機能と制限が記載されていますが、プレビュー版である以上、移行前に料金、クォータ、挙動、提供状況を再確認する必要があります。
まずは機密性のない小規模な評価セットと、保存済みの正解文字起こしを用意してください。重要エンティティの認識精度、話者の割り当て、確定までの遅延、再接続の挙動、レビュアーの修正率を分けて評価します。テスト前に合格基準を文書化し、すべての基準を満たした場合だけ対象範囲を広げましょう。
料金ではなく、受け入れ可能な文字起こしのコストで考える
表示されている試算を見る限り、Gemini 3.5 Transcribeは安価です。ただし、課金は固定の1分単価ではなくトークンベースです。Googleの公式料金表では、録音音声の入力が約$0.003/分、テキスト出力が$0.002で、混合した目安は約$0.005/分です。Liveは混合した目安で約$0.009/分となっています。
| 経路 | 音声入力の目安 | テキスト出力の目安 | 混合した計画用目安 | 100時間 |
|---|---|---|---|---|
録音 gemini-3.5-transcribe | $0.003/分 | $0.002/分 | $0.005/分 | 約$30 |
Live gemini-3.5-transcribe-live | 約$0.005/分 | 約$0.004/分 | $0.009/分 | 約$54 |
最初の予算感は、録音100時間でおよそ$30、ライブで$54です。ただし、再試行、ストレージ、音声変換、人手による修正、後段の要約処理は含まれません。出力の長さや追加コンテキストによって請求額は変わるため、利用状況を記録しておきましょう。
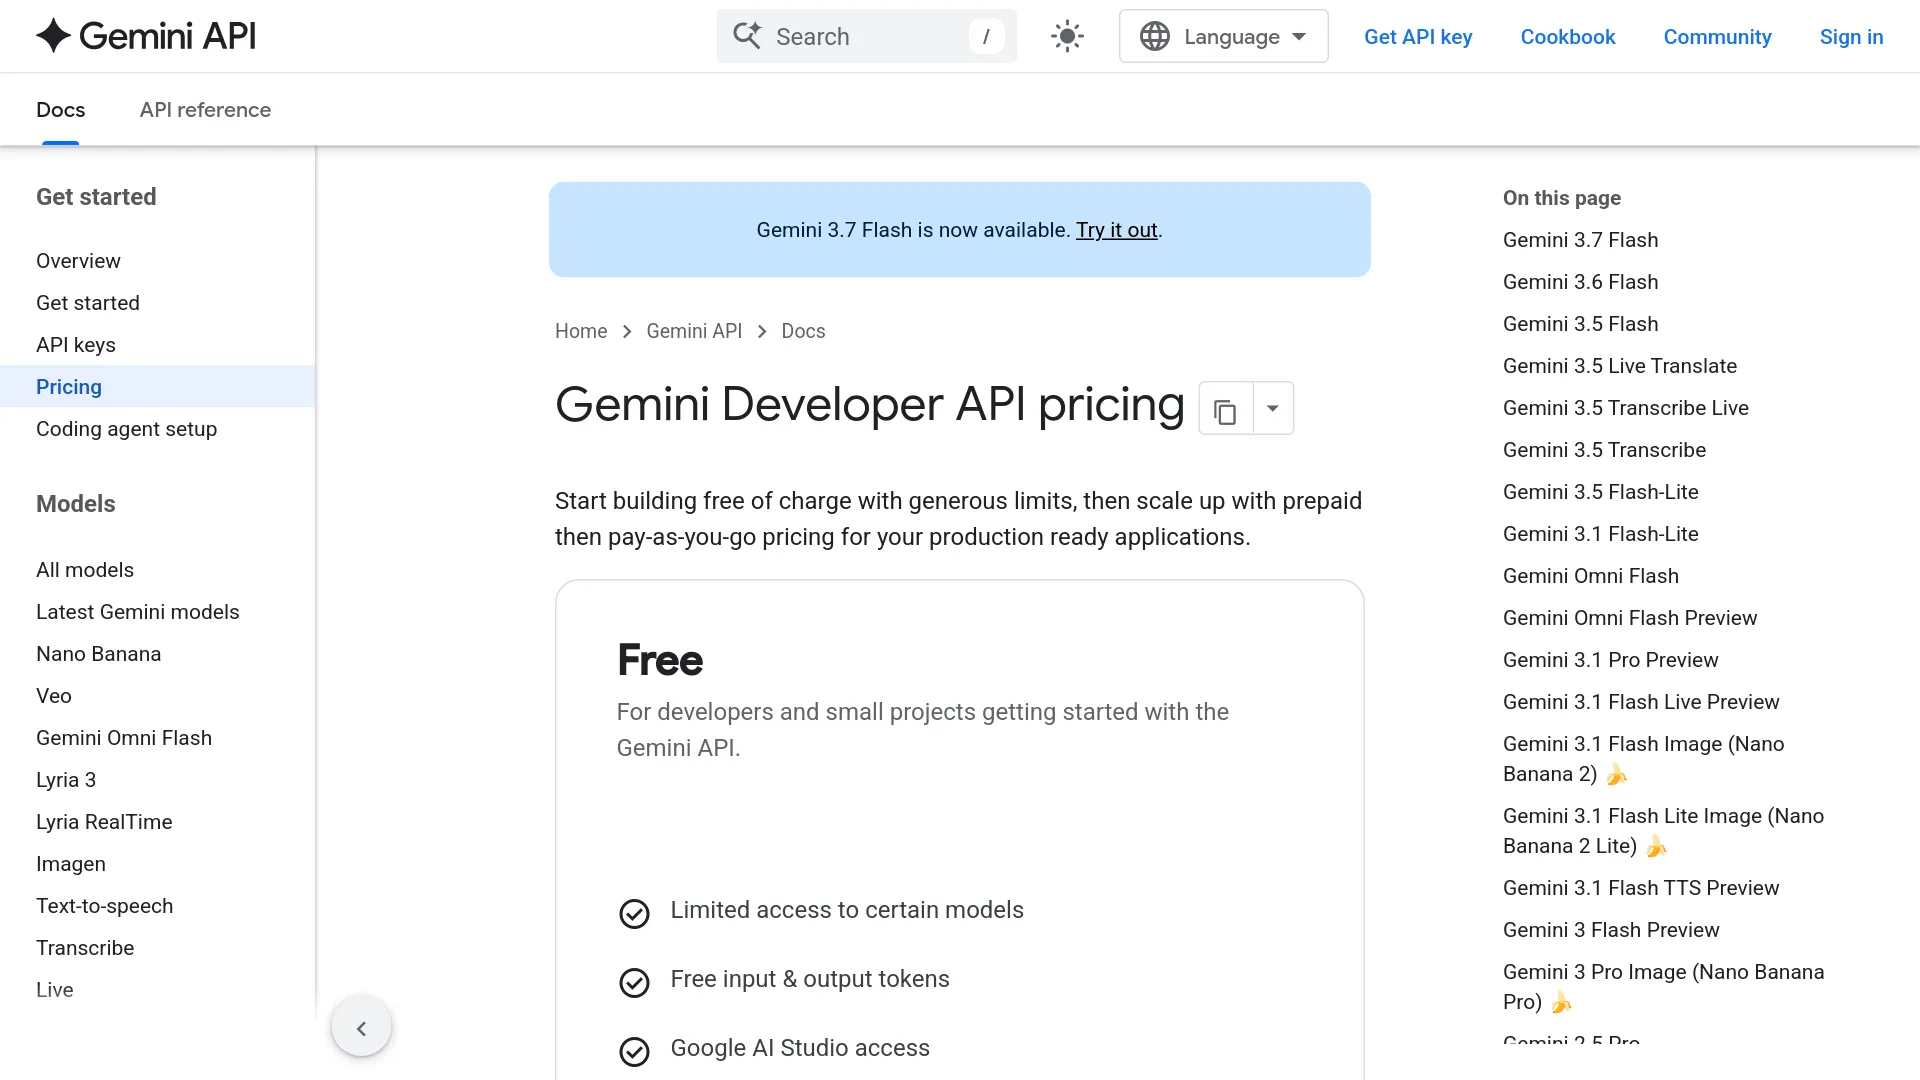
Googleの公開料金ページを撮影したスクリーンショットです。大量利用を決める前に、現在の料金表を確認してください。詳しくはGemini API公式料金ドキュメントを参照してください。
受け入れ可能な文字起こしのコストは、API利用料だけでなく、レビュー時間、レビュアーの単価、再試行、ストレージ、変換、後段処理を合算して計算します。Smartモードの修正や2回目の注釈処理によって手作業の修正が減るなら、API単価が高くても総額では安くなる可能性があります。
Gemini 3.5 Transcribe APIレビュー FAQ
Smart transcriptionで発言を正確に残せますか?
いいえ。Smartモードは言いよどみや自己訂正を編集するため、発言を正確に残す必要がある場合は逐語モードを原本として保存してください。
Live APIは話者ラベルや単語単位のタイムスタンプを提供しますか?
いいえ。話者ダイアライゼーションや単語単位のタイムスタンプが必要なら、録音版を使ってください。
Gemini 3.5 Transcribeで長時間の会議を処理できますか?
録音版の通常上限は1時間です。話者ダイアライゼーションまたは単語単位のタイムスタンプを使う場合は30分、Liveは連続セッションごとに10分までです。
法務、医療、コンプライアンス向けの文字起こしに適していますか?
逐語出力、重要項目のチェック、人手による確認を組み込んだ補助レイヤーとしてのみ使ってください。Smart出力を、高い正確性が求められる記録の唯一の原本にしてはいけません。
結論:プロトタイプには使える。ただし、気づかないうちに原本にしないこと
Gemini 3.5 Transcribeは、完全に逐語的な記録よりも、低コスト、多言語、文脈を踏まえた文字起こしに価値があるケースで有力です。まずは録音版から始め、自分の音声データでSmart出力と逐語出力を比較してください。注釈機能を使う場合は、30分の上限を受け入れられるかも確認しましょう。
字幕や音声UIを目的にするなら、クライアントが必要なPCM形式で安全にストリーミングでき、確定前のテキストと確定済みテキストを分離できるようになってからLiveへ進みます。重要な記録では、逐語ルートの出力を保存し、人手による確認を受け入れ基準に組み込んでください。Smartモードが原文を書き換えた後に、緊急対応で復元しようとする運用は避けるべきです。