 AIREITER
録音データを使えるテキストに変換したい。あるいは、マイク入力からリアルタイムで字幕を出したい。そんな用途なら、Gemini 3.5 Transcribeは有力な選択肢です。ノイズの少ない文章への整形、専門用語の補正、多言語対応が強みですが、ファイル処理とライブ処理では制限が大きく異なります。保存用の文字起こしにはファイルAPI、低遅延の短時間セッションにはLive APIを選ぶのが基本です。
結論:ライブ字幕が必要でなければ、まずはファイルAPI
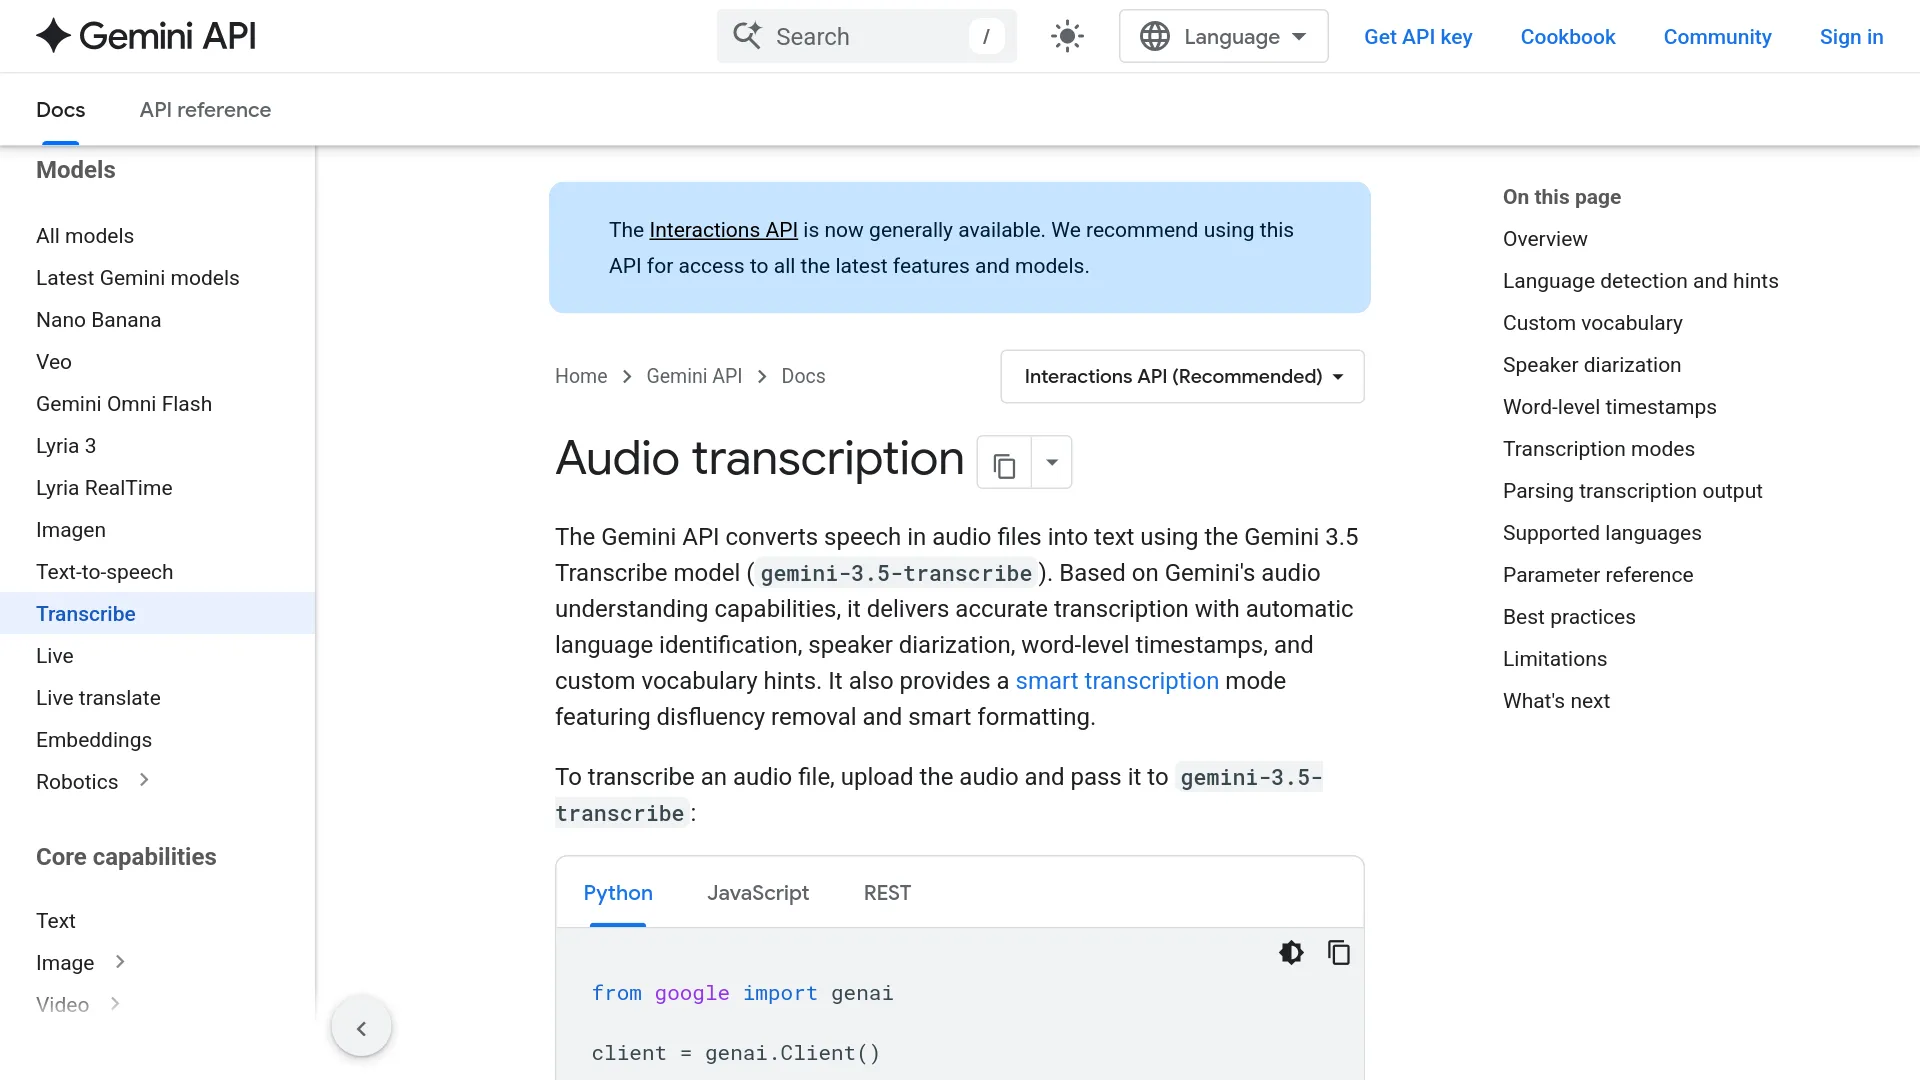
Gemini 3.5 Transcribeは、Googleが提供する音声認識専用モデルファミリーです。2026年8月26日時点でパブリックプレビューとして提供されており、録音済み音声とリアルタイム音声で、モデルID、通信方式、出力イベント、利用上限がそれぞれ分かれています。
| 用途 | モデルID | API経路 | 主な制限 |
|---|---|---|---|
| 会議、通話、アップロード済みの録音 | gemini-3.5-transcribe | Interactions API | 通常の単一リクエストは最長1時間。話者分離または単語タイムスタンプを使う場合は30分 |
| ライブ字幕、マイク入力、音声UI | gemini-3.5-transcribe-live | Live API | 連続セッションは10分。ライブ中の話者分離と単語単位のタイムスタンプには非対応 |
会議アーカイブ、通話分析、字幕作成が目的なら、まずはgemini-3.5-transcribeを選びましょう。字幕のプレビューやプッシュ・トゥ・トーク型のUIにはgemini-3.5-transcribe-liveが向いています。ワークフローの詳細は、Googleの録音音声の文字起こしガイドとLive APIガイドに分けて説明されています。
提供状況はまだプレビュー版
Googleは2026年8月26日にGemini 3.5 Transcribeを発表し、開発者向けAPIをGoogle AI StudioとGoogle Antigravityでパブリックプレビューとして提供しています。企業向けには、Gemini Enterprise Agent Platform経由のプレビュー提供も案内されています。一般提供の音声サービスとは異なり、プレビュー段階では地域ごとの提供範囲、クォータ、安定性に差が出る可能性があります。本番の大量処理に移行する前に、実際の用途に近い音声で検証しておくのが安全です。
Gemini 3.5 Transcribeの料金を実際の単位で見る
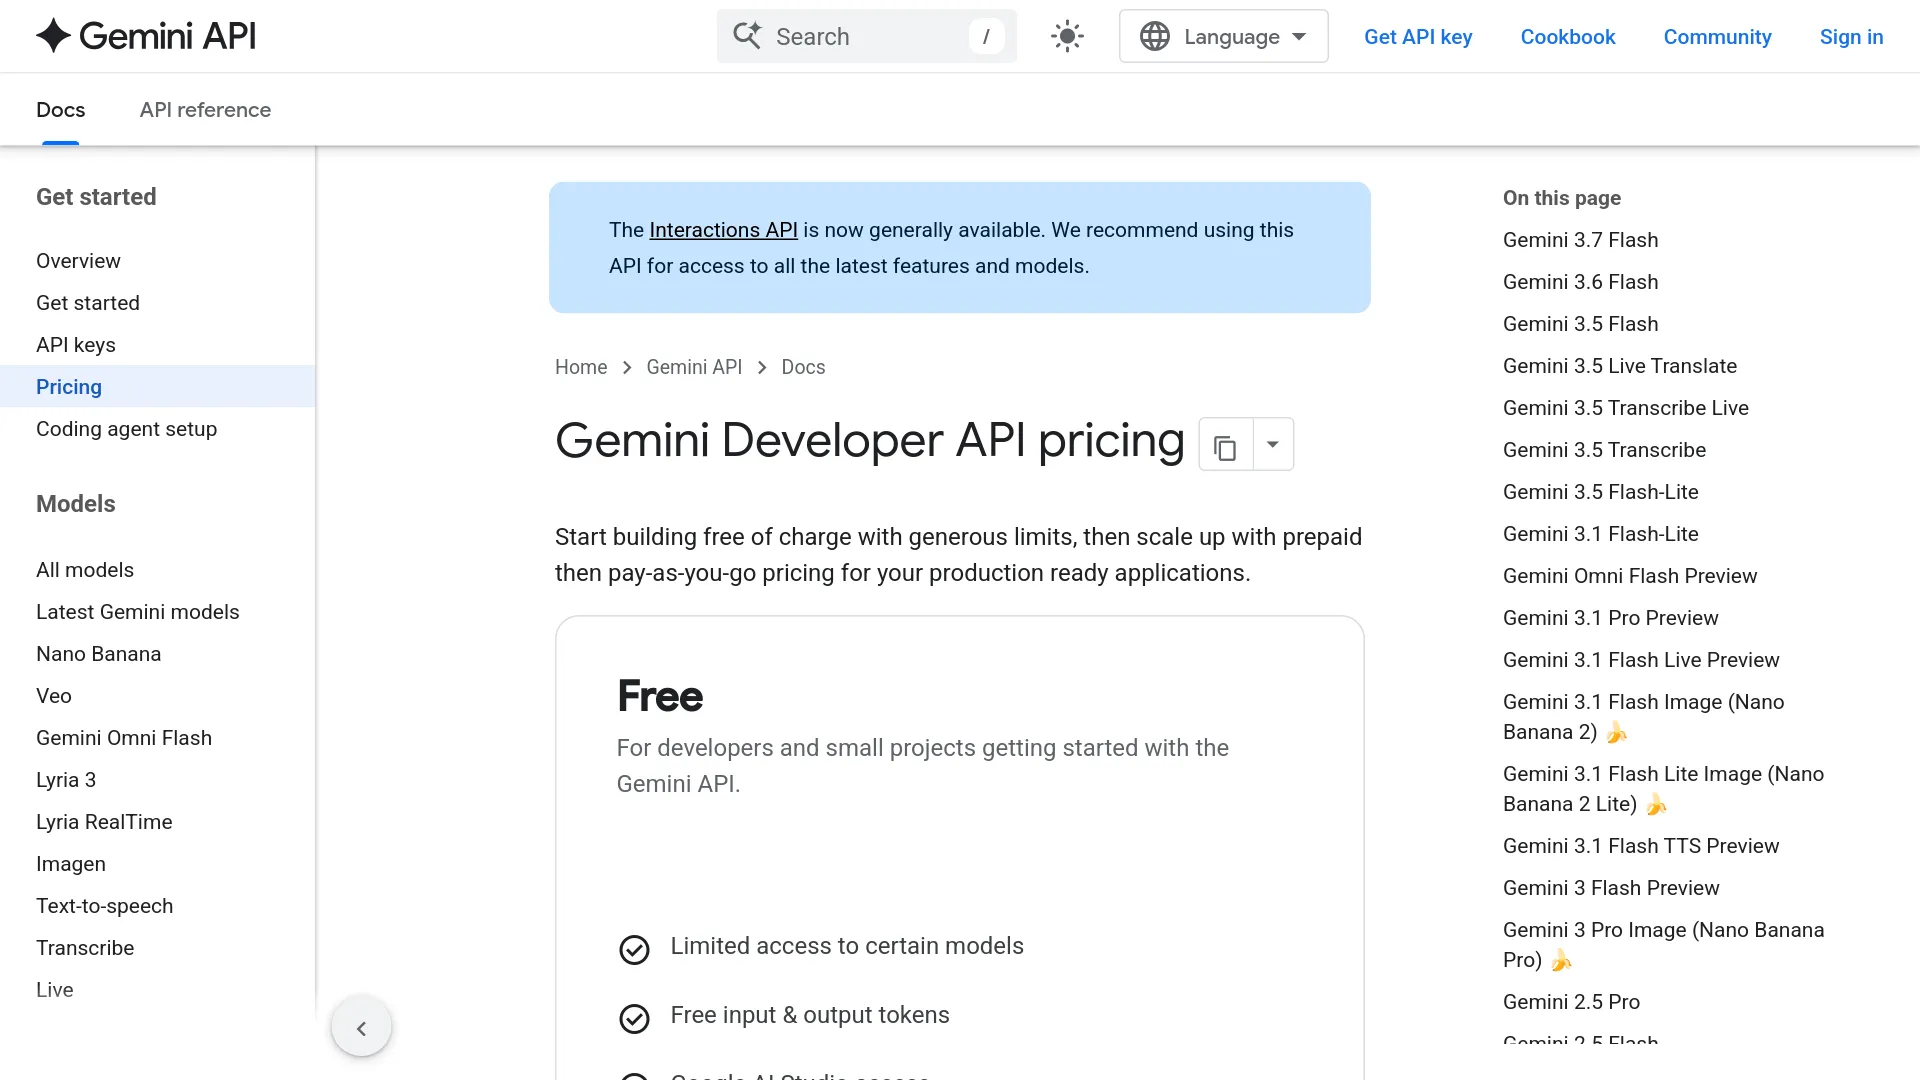
GoogleのGemini API料金ページでは、文字起こし専用の一律料金ではなく、トークン単位の料金が掲載されています。現在の料金表では、gemini-3.5-transcribeは音声入力トークン100万個あたり2ドル、テキスト出力トークン100万個あたり12ドルです。
Googleの音声ドキュメントによると、音声は1秒あたり32トークン、つまり1分あたり1,920音声トークンとして扱われます。そのため、音声入力分だけを見ると、100万トークンあたり2ドルの料金で1分あたり約0.00384ドルです。テキスト出力分や、そのほか課金対象となるトークンは別途加算されます。
| モデル | 公開されている料金体系 | 参考となる混合見積もり | 1時間あたりの参考見積もり |
|---|---|---|---|
gemini-3.5-transcribe | 音声入力トークン100万個あたり2ドル + テキスト出力トークン100万個あたり12ドル | 約0.005ドル/分 | 約0.30ドル/時 |
gemini-3.5-transcribe-live | ライブ音声とテキスト処理のトークンベース料金 | 約0.009ドル/分 | 約0.54ドル/時 |
混合見積もりは、出力される文字起こしの量によって変動します。1分あたりの固定料金ではなく、あくまで計画用の目安です。出力が多い音声、繰り返し送るコンテキスト、追加の指示などによって請求額は変わるため、大量利用を始める前には必ず最新の料金表を確認してください。プレビュー版の料金は変更される可能性があります。
本番運用で効いてくる機能の違い
忠実な文字起こしか、読みやすい文章か
Googleの文字起こしドキュメントでは、VERBATIMがデフォルトのモードです。フィラー、言い淀み、言い直し、間、途中で止まった発話、元の発言に含まれる訂正まで、そのまま残します。記録、証拠、字幕の元データ、品質管理用の入力として使うなら、こちらが適しています。
SMARTは、読みやすさを優先する整形モードです。言い淀みや自己訂正を取り除き、句読点や文章構造を補いながら、日付、通貨、数字、リスト、段落なども整えます。たとえば「火曜……いや、水曜」と話した内容が、整形後には「水曜」になることがあります。
Smartモードは、話者分離や単語単位のタイムスタンプとは併用できません。読みやすいメモと監査可能な記録の両方が必要なら、まずVERBATIMで出力し、そのコピーを別途整形するのが堅実です。
固有名詞の補正と複数言語の切り替え
Googleは85以上のロケールでの自動言語検出に対応しており、会話中の言語切り替えも扱えます。言語があらかじめ分かっている場合は、en-USやes-ESのようなBCP-47コードを指定すると、認識結果をその言語に寄せられます。
カスタム語彙には最大1,000語を登録できます。ただし、Googleの実用上の案内では、結果が安定しやすいのは100語以下です。登録するのは、特徴的な製品名、略語、人名、医療用語、技術用語などに絞り、一般的な単語を大量に並べるのは避けましょう。
話者ラベルと単語単位のタイムスタンプ
録音済み音声では、話者情報と単語単位のタイミングを返せます。APIドキュメント上の話者数の上限は8人です。一方、Googleの発表記事では、最大3人までの話者 attribution が強調され、3人以上の話者への対応は実験的機能とされています。
単語タイムスタンプはVERBATIMモードで有効になり、各単語の開始位置と終了位置を取得できます。ただしGoogleは、タイムスタンプを有効にすると文字起こし全体の精度が下がる可能性があると注意しています。話者分離やタイムスタンプを使う場合、通常の音声長の上限も1時間から30分に短くなります。
| 要件 | 対応 | 注意点 |
|---|---|---|
| 録音済み音声の話者ラベル | 対応 | ドキュメント上は最大8人。3人以上の attribution は実験的 |
| 録音済み音声の単語単位タイムスタンプ | 対応 | VERBATIMモードのみ。精度が下がる可能性あり |
| ライブ文字起こしの話者ラベル | 非対応 | 話者情報が必要なら録音済み音声を使う |
| ライブ文字起こしの単語単位タイムスタンプ | 非対応 | ライブ出力は逐次的で、発話単位を中心に返される |
| ラベルまたはタイムスタンプとSmartモードの併用 | 非対応 | これらの注釈が必要ならVERBATIMを選ぶ |
Gemini 3.5 Transcribe APIで録音ファイルを送る方法
Googleの録音音声ガイドでは、処理を3段階に分けています。まずファイルをアップロードし、返されたファイルURIをInteractions APIに渡し、完了した文字起こしをinteraction.output_textから読み取る流れです。
- Files APIで音声をアップロードします。数秒を超える録音や、あとで再利用するファイルにはこの方法を使います。
audio/mp3のようなMIMEタイプと、返されたファイルURIを保持します。- Interactions API経由で、
gemini-3.5-transcribeにURIを送信します。 - テキスト出力を読み取り、話者情報やタイミングデータを要求した場合は、
word_infoのアノテーションも確認します。
公式SDKを使ったアップロードから文字起こしまでの処理は、次のように書けます。
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Files APIへのアップロードが完了し、FILE_URIが返されたあとのRESTリクエストは、次のようにコンパクトに書けます。
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
読みやすく整えた文字起こしが欲しい場合は、次のようにSmartモードを指定します。
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
話者ラベルや単語タイミングが必要なら、代わりにVERBATIMモードを使います。
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Smartの設定と話者分離、タイムスタンプは組み合わせないでください。APIのモード規則上、これは単なる表示形式の選択ではなく、設計段階で決めるべきトレードオフです。
ライブ文字起こしの仕組み
Live APIでは、gemini-3.5-transcribe-liveを使い、双方向ストリーミング接続を確立します。クライアントが音声を連続して送信すると、次の2種類のテキストイベントが返ってきます。
interim_input_transcription:字幕やUIプレビュー向けの、低遅延で更新され続ける暫定認識結果。input_transcription:文字起こしやアプリケーションの状態に確定結果として保存するテキスト。
Googleのライブガイドでは、音声形式としてリトルエンディアンの16ビットPCM、16 kHz、モノラルを指定しています。チャンクはおよそ100ミリ秒、1チャンクあたり1,024〜2,048フレームが推奨です。ブラウザやモバイルのクライアントでは、通常のAPIキーを露出させず、制限付きのエフェメラルトークンを使うべきです。Googleのサンプルでは、1回限り利用でき、有効期限が30分のトークンを使っています。
ライブエンドポイントは、自動言語検出、BCP-47による言語ヒント、カスタム語彙、VERBATIMまたはSMART出力に対応しています。一方、ライブ中の話者分離と単語単位のタイムスタンプには対応していません。連続セッションの上限は10分なので、それ以上のストリームを扱う場合は、アプリケーション側でセッションを分割し、文字起こしをつなぎ合わせる必要があります。
発話の区切りを検出する方法は、Live APIでは次の3つです。
- 自動VAD:サーバーが発話の開始と終了を検出します。
- ハイブリッドVAD:クライアント側の検出器が発話終了を通知し、サーバー側の検出はフォールバックとして残します。
- 手動VAD:プッシュ・トゥ・トークUIなどで、発話の開始と終了イベントを明示的に送信します。
初期データから分かること、まだ分からないこと
GoogleはArtificial Analysisの結果として、平均WERをストリーミングで4.0%、非ストリーミングで2.6%と報告しています。さらに発表記事では、FLEURSにおけるストリーミングWER 5.50%、非ストリーミングWER 5.04%、Chirp 3と比べて最終文字起こしまでの時間が70%改善したことも示しています。
ただし、これらはGoogle自身が報告または引用したリリース時点のデータであり、Gemini 3.5 Transcribeを独立した条件で直接比較した結果ではありません。公開されているkoedesk STT benchmarkではGemini 3.5 Flashなど複数のエンジンが測定されていますが、Gemini 3.5 Transcribeは直接の測定対象になっていません。
初期ユーザーからは、ファイル処理とライブ処理の音声長制限、WERの参照用文字起こし、静かな場面で電話番号や注文IDを信頼できるかといった点に関する疑問が出ています。平均WERだけを頼りにせず、実際の音声で人名、ID、数字、話者交代、タイミング、遅延を検証してください。
Gemini 3.5 Transcribeを選ぶべきケース、待ったほうがいいケース
| 状況 | 適性 | まず試したい構成 |
|---|---|---|
| 読みやすい会議メモや音声入力 | 高い | File API、SMART、分かっている場合は言語ヒントを明示 |
| 法務、コンプライアンス、アーカイブ用の記録 | 条件付き | File API、VERBATIM。重要箇所は手動で確認 |
| 複数話者の録音通話 | 条件付き | File API、VERBATIM + 話者分離。セッションは30分以内にする |
| 単語単位で同期する字幕 | 条件付き | File API、VERBATIM + 単語タイムスタンプ。タイミングと精度を検証 |
| ライブ字幕 | 短時間なら有力 | Live API。確定イベントだけを保存対象にする |
| 長時間稼働する音声エージェント | 追加実装が必要 | 10分制限の前にセッションを分割し、再接続を管理 |
| オフライン処理や機密性の高いローカル処理 | 不向き | ドキュメント上のワークフローでは音声をGoogleのサービスに送信する。セルフホスト型のASRを検討 |
Gemini 3.5 Transcribeが最も力を発揮するのは、文字起こしをより大きなワークフローの入口として使う場合です。音声を整え、専門用語を保持し、話者を特定し、構造化したテキストを次の処理へ渡す、といった構成に向いています。一方、安価な逐語文字起こしだけが必要な場合や、オフライン処理が必須の場合は、別の選択肢のほうが適しています。
Gemini 3.5 Transcribe API FAQ
Gemini 3.5 Transcribeは無料ですか?
GoogleはGemini APIについて無料枠を提供していますが、クォータやモデルの提供状況は変更される可能性があります。有料利用はトークンベースで、料金ページには現在、録音済み音声の文字起こしが1分あたり約0.005ドル、ライブモデルが1分あたり約0.009ドルという混合見積もりが示されています。
ファイルモデルとライブモデルの違いは何ですか?
gemini-3.5-transcribeはInteractions API経由でアップロード済みの録音を処理し、録音音声に対する話者分離と単語タイムスタンプに対応します。gemini-3.5-transcribe-liveはLive API経由で生のPCM音声をストリーミングし、暫定イベントと確定イベントを返します。ただし、セッションは10分に制限され、ライブ中の話者分離と単語単位のタイムスタンプには対応していません。
3時間の録音を1回のリクエストで処理できますか?
専用の録音文字起こし設定ではできません。通常の単一リクエストの上限は1時間で、話者分離または単語タイムスタンプを使う場合は30分です。より長い音声を扱うには、アプリケーション側で分割し、コンテキストと話者の連続性を慎重に管理する必要があります。
Gemini 3.5 Transcribeをオフラインで使えますか?
ドキュメントに記載されたワークフローでは、音声をGoogleのサービスへアップロードまたはストリーミングします。GoogleはGemini 3.5 Transcribeのオフライン版やセルフホスト版について説明していません。
最初の統合で取るべき安全策
最初からきれいなデモ音声を使うのではなく、実際の業務で扱う音声の一部を小さく切り出して試しましょう。同じ音声を2回処理し、1回目は忠実度を確認するためにVERBATIM、2回目は読みやすさを見るためにSMARTを使います。固有名詞、数字、話者の交代、タイムスタンプのずれ、コストは、それぞれ分けて測定してください。
元の文字起こしは正本として保持し、ユーザー向けのメモにはSmart出力を使います。アップロード失敗やプレビュー版モデルの変更に備えたフォールバックも用意しておきましょう。Live APIへ移行するのは、クライアント側で100ミリ秒単位のPCMチャンク、暫定イベントと確定イベントの違い、エフェメラルトークン、10分のセッション境界を扱えるようになってからで十分です。