 AIREITER
どちらを選ぶべきかは、結局のところワークロード次第です。範囲が明確で出力中心の処理ならClaude Opus 5から始めるのが無難。一方、長時間動き続けるエージェントや、非常に大きく再利用性の高いコンテキストではClaude Fable 5.1を検証する価値があります。なお、Fable 5.1で目立つコストメリットは、入力・出力料金の安さではなく、キャッシュ読み取り料金の低さから生まれています。
Fable 5.1とOpus 5の選択は、まずワークロードから考える
多くのチームでは、まずOpus 5を使い、より深い推論が必要なタスクではeffortを引き上げ、それでも難しいケースだけをFable 5.1に振り分ける進め方が現実的です。AnthropicのFable 5.1ドキュメントも、おおむね同じ方針を示しています。まずは大半のワークロードでOpus 5を使い、高いeffort設定でも要件を満たせない場合にFable 5.1へ移行する、という考え方です。
| 主な制約が… | まず試すモデル | 理由 |
|---|---|---|
| 短い、または処理範囲が明確なリクエスト | Opus 5 | 入力・出力料金がFable 5.1の半額です。 |
| 出力の多い本番トラフィック | Opus 5 | Fableのキャッシュ読み取り料金が安くても、生成トークンは値引きされません。 |
| 仕様が固まった複数ファイルのコーディング | Opus 5 | 料金が低いため、再試行や高いeffort設定のコストを吸収しやすくなります。 |
| 長時間動作し、ツールを使い続けるエージェント | Fable 5.1—評価後に採用 | Anthropicが公開しているエージェント性能・ツール利用の比較でFableが優位です。 |
| ターンをまたいで大規模なコンテキストを繰り返し利用する処理 | Fable 5.1—コスト試算後に採用 | キャッシュ読み取り料金がOpus 5の半額です。 |
| フォールバックの影響を受けやすい本番ルーター | まずOpus 5 | Fable 5.1では思考ブロックと会話履歴の扱いが変わります。 |
比較すべきなのは、適切なeffortとコストで使うOpus 5と、適切なコンテキスト構成と信頼性の基準で使うFable 5.1です。
Fable 5.1とOpus 5は、実際には何が違うのか
Claude Fable 5.1は、難度の高い推論や長時間にわたるエージェント処理向けの上位モデルです。一方のClaude Opus 5は、本格的なコーディングやエージェント、業務用途に対応しながら、より低い料金で利用できるモデルとして位置づけられています。どちらもコンテキストウィンドウは1 million tokens、最大出力は128,000 tokensです。つまりFableの強みは、公開されているコンテキスト上限の大きさではなく、長い工程を伴う実行にあります。
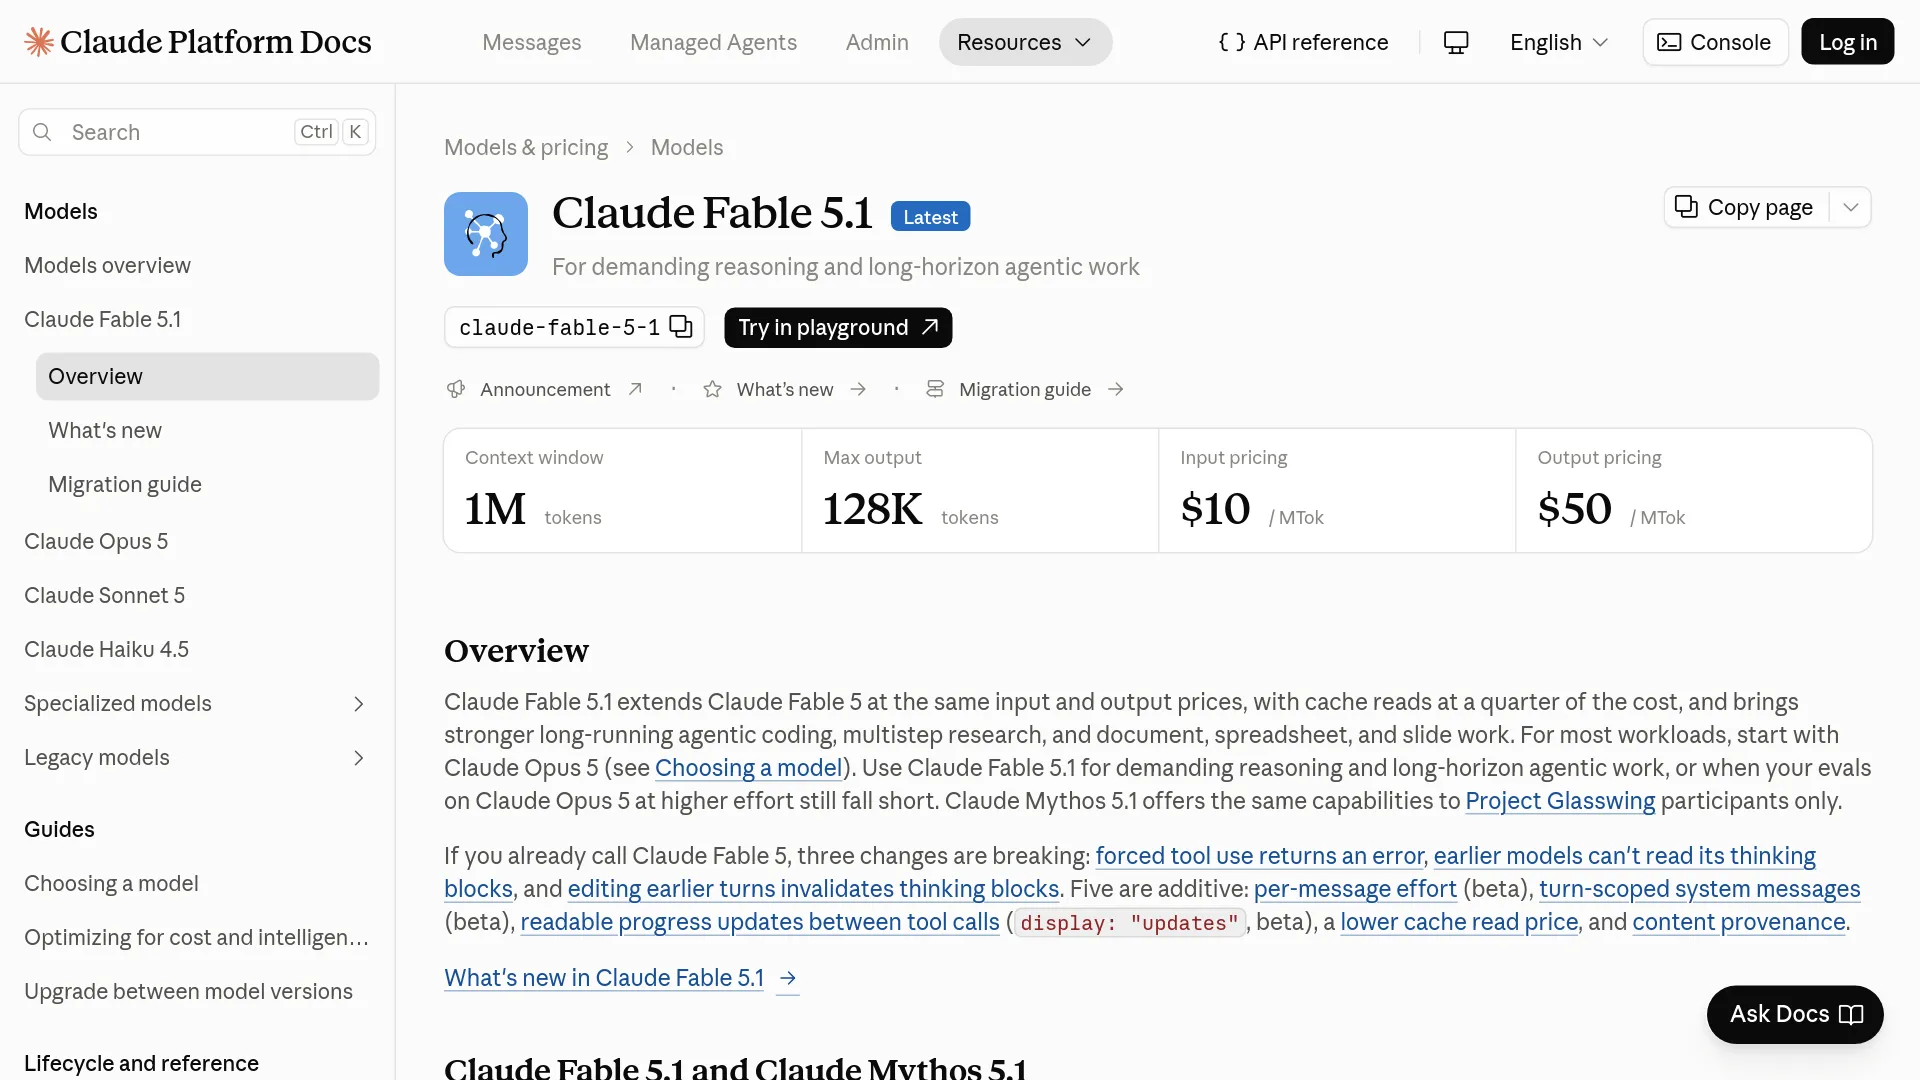
| 仕様 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| APIモデルID | claude-fable-5-1 | claude-opus-5 |
| コンテキストウィンドウ | 1 million tokens | 1 million tokens |
| 最大出力 | 128,000 tokens | 128,000 tokens |
| 入力モダリティ | テキストと画像 | テキストと画像 |
| 出力モダリティ | テキスト | テキスト |
| Thinking | Adaptive、常時有効 | effortで制御する推論 |
| effort設定 | low、medium、high、xhigh、max | 設定可能なeffortレベル |
| Anthropicによる位置づけ | 高度な推論と長時間動作するエージェント | 大半のワークロードと本格的なコーディング |
| リリース状況 | 現行・最新版、2026年9月1日リリース | 現行のOpusモデル、2026年7月24日リリース |
デプロイ先ごとのモデルIDや利用可否については、Fable 5.1のモデルページとClaude Opus 5の製品ページを確認してください。
Fable 5.1のベンチマークは強い。ただし、どの用途でも優位とは限らない
Anthropicが公開したベンチマーク表では、両モデルの結果が掲載されているすべての項目で、Fable 5.1がOpus 5を上回っています。ただし、これはベンダー自身が実施した評価です。モデルのリリース時評価を読み解く材料にはなりますが、本番環境での結果を保証するものではありません。
| Anthropicの評価 | Fable 5.1 | Opus 5 | Fable 5.1の差 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6ポイント |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5ポイント |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0、strict | 41.7% | 39.6% | 2.1ポイント |
| Humanity’s Last Exam、ツール使用 | 65.0% | 63.6% | 1.4ポイント |
| AutomationBench | 31.4% | 26.9% | 4.5ポイント |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4ポイント |
Anthropicによると、評価では本番向けの安全策を有効にしており、一部の介入によってスコアがゼロになったり、処理がフォールバックモデルへ振り分けられたりする場合がありました。また、Terminal-Bench-Science 0.1では、モデルごとの標準誤差はおよそ3.5〜4.5ポイントとされています。そのため、23.6ポイントの差は、Humanity’s Last Examにおける1.4ポイント差よりも意味のある結果と考えられます。
第三者によるCodeRabbitの評価では、既知の問題点が105件含まれる45タスクを対象に、Fable 5.1の再現率は61.0%、適合率は37.3%でした。Opus 5は再現率55.2%、適合率39.3%です。両モデルとも処理したコメント数は166件でしたが、評価条件が異なっていたと著者は注意を促しています。
「Fable 5.1は、専門性の高いレビュアーです」— CodeRabbitによる評価結果の説明(CodeRabbit)
API料金を入れると、実用上の比較は変わってくる
Fable 5.1は、キャッシュされていない入力と出力の料金がOpus 5の2倍です。一方、キャッシュ読み取りは半額。長く続く反復的なエージェントセッションでは損益分岐点が生まれますが、すべてのリクエストでFable 5.1のほうが安くなるわけではありません。
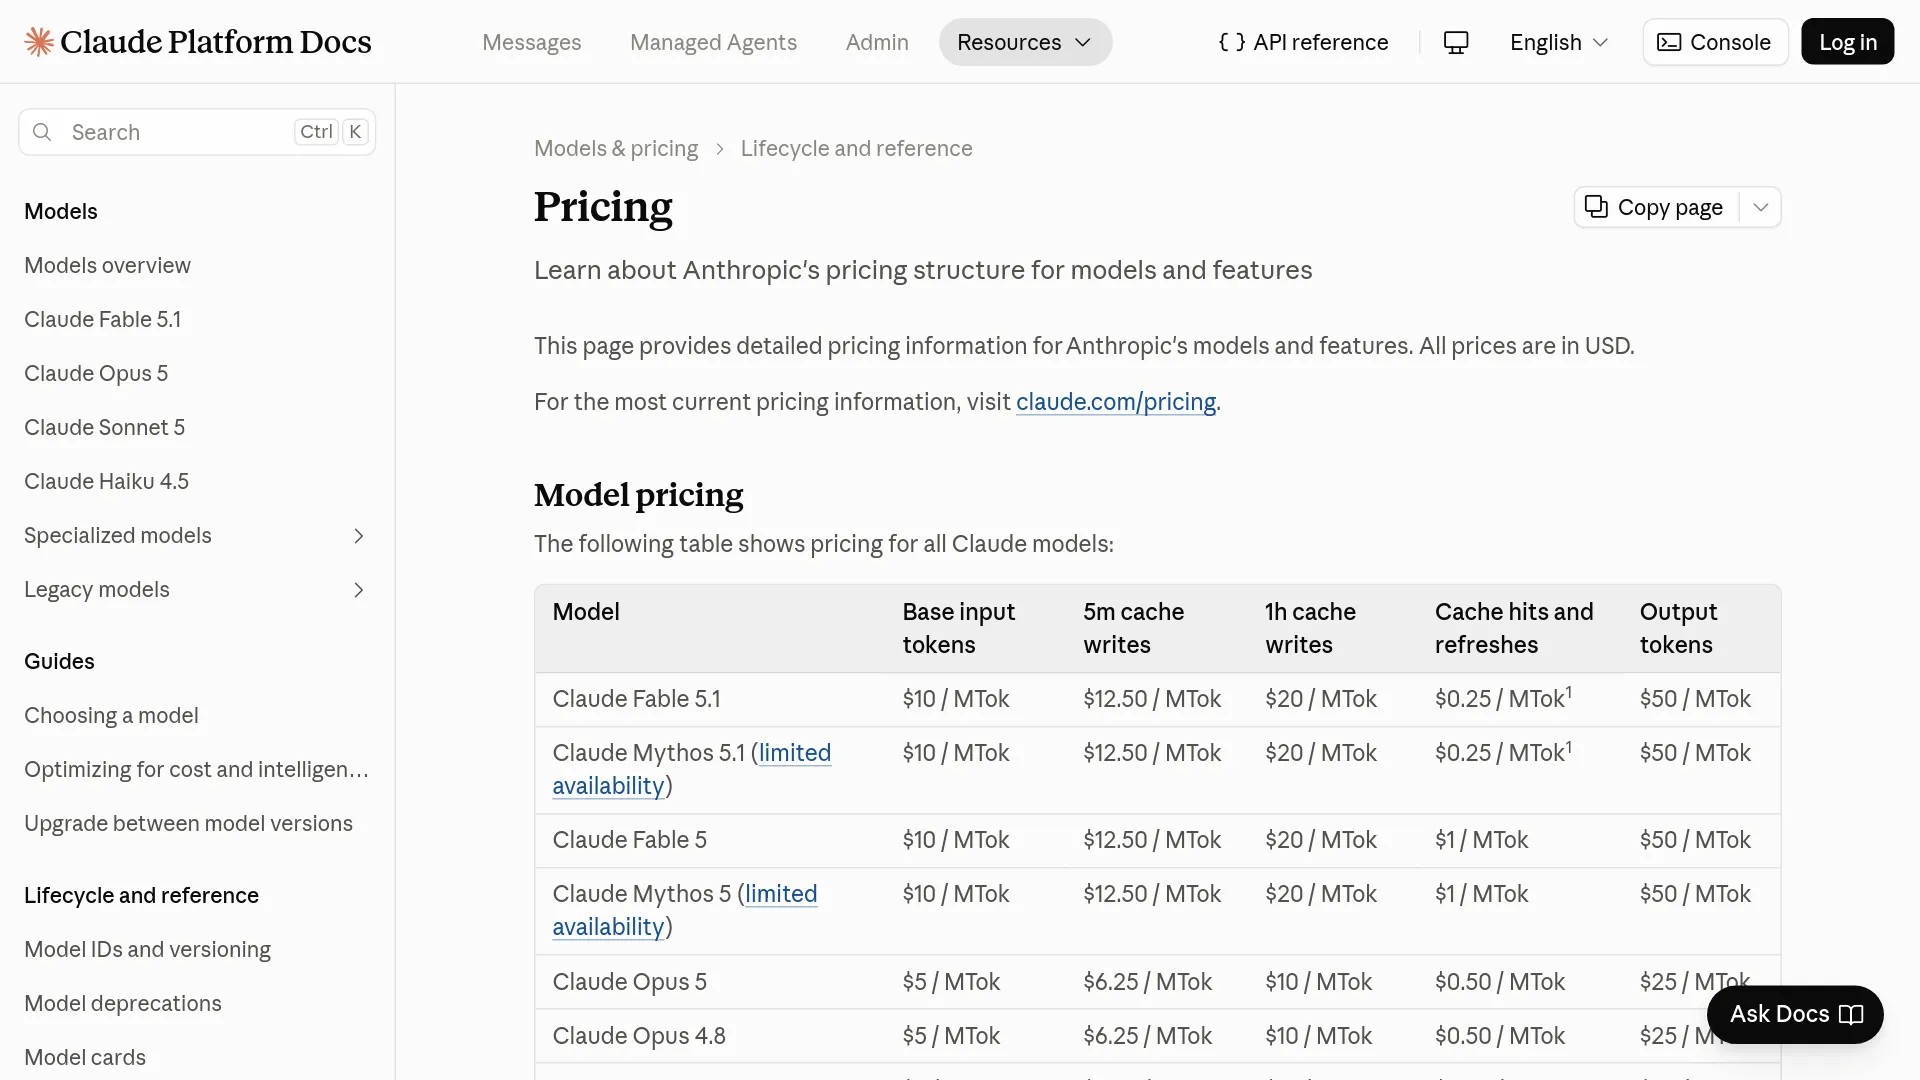
以下の料金は、Anthropicの現行API料金ドキュメントに記載された、100万トークンあたりの米ドル価格です。
| 課金項目 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| 通常の入力 | $10.00 | $5.00 |
| 5分間キャッシュへの書き込み | $12.50 | $6.25 |
| 1時間キャッシュへの書き込み | $20.00 | $10.00 |
| キャッシュ読み取り | $0.25 | $0.50 |
| 出力 | $50.00 | $25.00 |
| Batchの入力 / 出力 | $5.00 / $25.00 | $2.50 / $12.50 |
Fable 5.1の入力・出力料金はFable 5から変更されていません。今回のコストメリットを生む変更は、キャッシュ読み取り料金です。100万トークンあたり$0.25で、Fable 5の$1.00から引き下げられました。Anthropicは、一般的なワークロードで約25%、エージェント性の高いワークロードでは最大で約45%のコスト低下を見込んでいます。ただし、これはワークロードごとの推定値であり、一律の割引率ではありません。
ターンごとの計算に落とし込むと、違いが分かりやすくなります。Cをキャッシュ済みコンテキスト、Iを新規入力、Oを出力とし、それぞれの単位を100万トークンとします。キャッシュ書き込み料金を無視すると、Fable 5.1は10I + 0.25C + 50O、Opus 5は5I + 0.50C + 25Oです。
Fableのキャッシュ読み取り料金の安さが、新規入力と出力の高さを上回る条件は次のとおりです。
0.25C > 5I + 25O
新規プロンプトが2,000トークン、応答が1,000トークンの場合、I = 0.002、O = 0.001です。読み取りだけを比較した計算でFableが有利になるには、キャッシュ済みコンテキストがおよそ140,000トークンを超える必要があります。キャッシュ書き込み料金まで含めると、損益分岐点はさらに遠くなります。
そのため、短い情報抽出、分類、書き換え、一度きりのコーディング呼び出しを、料金を理由にFable 5.1へ切り替えるべきではありません。値引きの対象になる再利用可能なプレフィックスがほとんどないうえ、生成トークンはすべてOpus 5の2倍の料金で課金されるからです。
実際のワークフローでは、どのように使い分けるか
実用上の分かれ目は、範囲が明確な処理と長時間にわたる継続的な実行です。仕様が明確、または出力中心のタスクならOpus 5を選びやすいでしょう。エージェントが計画を維持し、何度もツールを呼び出し、失敗から復旧し、大きなコンテキストを多くのターンにわたって持ち回る必要がある場合は、Fable 5.1の検討余地が広がります。
コーディングエージェントは、ベンチマーク順位ではなく完了した仕事で判断する
一般的なリポジトリ作業なら、まずOpus 5を試すのが合理的です。対象範囲の限られたバグ修正、仕様の決まったリファクタリング、コードレビュー、そして低コストを生かして再試行やeffortの引き上げができるタスクが該当します。一方、複数ファイルにまたがる変更、マイグレーション、システムレベルのデバッグ、非同期で進むコーディングセッションでは、Fable 5.1を試す価値があります。応答が遅くても、終盤での失敗を避けられるなら、そのほうが安く済む可能性があるためです。
コミュニティの反応からは、運用上異なる2種類のリスクが見えてきます。大規模なr/ClaudeCodeの議論で、ユーザーのu/CyCoCyCoは次のように書いています。
「うまくいったのは、目標を示すプロンプトを作らせて、最初から最後まで一気に実行させた場合だけです」— Redditのu/CyCoCyCo
これはプロンプト設計やワークフローに対する不満を示す材料ではありますが、Opus 5があらゆるコードベースで失敗する証拠ではありません。同じ議論では、別のユーザーから、長くコンテキストを多用するタスクで指示から外れる、修正によって新たな不具合が生まれるといった問題も報告されています。
Fable 5.1には別の種類の不満があります。リリースに関する議論では、トークンやクォータの消費が異常に速いという報告がありました。これはあくまで逸話的な報告で、すべてのサブスクリプションに共通する制限を示すものではありません。ただし、パイロット導入では出力品質だけで判断せず、利用量も追跡すべき理由にはなります。
コーディングエージェントを試すなら、次の項目を記録しておくとよいでしょう。
- 人手の介入なしに完了したタスク数
- 成功報告の後に再オープンしたバグやリグレッション
- 入力、キャッシュ入力、出力の合計トークン数
- 所要時間とツール呼び出し回数
- 人間による修正時間と、終盤で失敗した実行にかかったコスト
調査やドキュメント中心の処理では、Fableのほうが導入理由を作りやすい
非常に大量の文書、繰り返し発生するツール呼び出し、図表の読み取り、複数段階の調査、何度も修正を重ねる成果物などが必要なら、Fable 5.1は有力な候補です。Anthropicも、文書、スプレッドシート、スライド、図、表、長時間にわたる調査を主な用途として挙げています。
Opus 5も同じ1-million-tokenのコンテキスト容量を持ち、複雑な文書や高度なエージェントに対応するとAnthropicは説明しています。1回の分析で大量のテキストを生成する仕事なら、FableのキャッシュメリットよりOpusの低い料金が効く可能性があります。Fableのベンチマーク優位を本番要件と見なす前に、代表的なサンプルで検証してください。
コンピューター操作や業務自動化は、一連の軌跡全体で評価する
AnthropicのOSWorldとAutomationBenchでは、Fable 5.1がOpus 5を上回っています。ただし、これらのタスクが測るのは単発の回答ではなく、一連のアクションです。ブラウザー操作や業務プロセスのエージェントでは、正しい最終状態まで到達できるか、復旧が必要になる頻度、途中の失敗で残りの処理全体が無効にならないかを評価しましょう。
見るべき単位は、100万トークンあたりの料金だけではなく、完了した成果1件あたりのコストです。長いワークフローで何度も再試行する必要を減らせるなら、単価の高いモデルでも経済的になり得ます。逆に、最終状態にたどり着く前に利用枠を使い切るモデルは、安いとは言えません。
切り替え前に確認したい統合上のポイント
Fable 5.1の移行ドキュメントでは、強制的なツール利用、思考ブロック、会話履歴のバリデーションに関する変更が説明されています。独自のメッセージルーターを使っているチームは、デフォルトモデルを変更する前に必ず確認しておきたいところです。
| 変更点 | 起こり得ること | 移行時の対応 |
|---|---|---|
| 強制的なツール利用 | tool_choice: {"type":"any"}や名前を指定したツール選択で、HTTP 400が返る場合があります。 | 明確なツール指示とともにautoを使うか、適切な場面では構造化出力を利用します。 |
| 思考ブロックの互換性 | 以前のモデルはFable 5.1の思考ブロックを読み取れず、フォールバック時のターンで失われる場合があります。 | モデル切り替えとフォールバックの経路を監査します。 |
| 会話の編集 | 過去のメッセージ、システムプロンプト、ツール一覧を編集すると、その後の思考ブロックが無効になる場合があります。 | 履歴を追記専用として扱うか、サポートされているターン単位の制御機能を使います。 |
| Thinkingの設定 | Fable 5.1はAdaptive Thinkingを使い、Opus 5と同じ方法でThinkingを無効化することはできません。 | effort設定で支出を管理し、トークン使用量を再検証します。 |
複数モデルを使うルーターでは、フォールバックの扱いが重要です。Fable 5.1のリクエストは推論コンテキストを維持したまま続行できる場合がありますが、Opus 5へフォールバックするとFable 5.1の思考ブロックを利用できません。ルーターがそれらを暗黙に削除すると、フォールバック側が計画を立て直すことになり、遅延とトークン消費が増える可能性があります。本番に近い履歴を使い、成功経路だけでなく失敗経路も検証してください。
大きなモデル比較より、小さな評価のほうが役に立つ
両モデルに同じプロンプト、ツール、コンテキスト、effort方針、受け入れテストを適用してください。条件がそろっていなければ、モデル比較ではなく評価ハーネスの比較になってしまいます。
- 範囲限定のレーン:対象範囲の限られたバグ修正、情報抽出、構造化文書の作成、コードレビューを実行します。有用な出力、修正時間、コストを記録します。
- 長時間実行のレーン:複数ファイルの機能追加、マイグレーション、調査タスク、ブラウザワークフローを実行します。最終状態への到達、復旧、リグレッション、所要時間を追跡します。
- キャッシュ多用のレーン:安定したシステムプロンプト、ツールセット、リポジトリまたは文書のプレフィックスを繰り返し使います。キャッシュヒット率と、キャッシュ書き込み・出力を含む総額を記録します。
まず、実際にデプロイする予定のeffortレベルでOpus 5を実行します。その後、タスクをFable 5.1へ移す前に、Opusのeffortを上げた場合も試してください。Fableでは少なくともmediumとhighを検証しましょう。モデルが違えば、同じeffort名でも意味がそのまま対応するとは限りません。Anthropicによると、effort設定は推論の深さとコストのバランスを制御します。また、第三者のテストでは、推論を高めてもコードレビュー全体の結果が自動的に改善するわけではないことが示されています。
Fable 5.1 vs Opus 5:よくある質問
コーディングにはどちらが向いていますか?
Anthropicが公開したTerminal-BenchとCursorBenchでは、Fable 5.1がOpus 5を上回っています。ただし、範囲が明確でコストを重視するコーディングなら、まずOpus 5から始めるのが現実的です。Fableの完了品質が、料金とレイテンシの増加に見合うかどうかは、実際のリポジトリを使った評価で判断してください。
Fable 5.1はAPI料金が2倍でも使う価値がありますか?
最初からそうとは限りません。入力・出力料金はOpus 5の2倍ですが、キャッシュ読み取りは半額です。大きなコンテキストを繰り返し再利用し、出力は比較的少ないワークロードであれば、Fableの料金面が意味を持ちやすくなります。
Fable 5.1のコンテキストウィンドウは大きいのですか?
いいえ。Anthropicの仕様では、両モデルともコンテキストウィンドウは1-million tokens、最大出力は128,000 tokensです。Fableの違いは、公開ウィンドウの大きさではなく、より長い推論やエージェントの軌跡を想定した位置づけにあります。
切り替える前にOpus 5のeffortを上げるべきですか?
はい。Anthropicのモデルガイダンスでも、Fable 5.1へ移行する前に、effortを高めたOpus 5を評価することが推奨されています。すべてのリクエストを最大effortで実行するのではなく、追加のトークンコストに対して品質がどれだけ改善するかを比較しましょう。
Fable 5.1からOpus 5へ安全にフォールバックできますか?
フォールバックの仕組み自体は構築できますが、会話状態に互換性があるとは考えないでください。以前のモデルはFable 5.1の思考ブロックを読み取れません。また、Fable 5.1の履歴バリデーションによって、過去のターンを編集するルーターの問題が表面化する可能性もあります。実際のツールスキーマとメッセージ履歴を使って、フォールバックを検証してください。
Fable 5.1とOpus 5はどこから利用できますか?
Anthropicは、Claudeの各プランに加え、自社プラットフォームやクラウドマーケットプレイス統合を通じた開発者向けアクセスで、両モデルを提供しています。正確なモデルIDと利用可否はプロバイダーによって異なる場合があるため、Fable 5.1のドキュメントまたはOpus 5の製品ページでデプロイ先ごとの識別子を確認してください。
実際に必要なのは恒久的なアップグレードではなく、振り分けルール
| 判断項目 | Opus 5を使う場合 | Fable 5.1を使う場合 |
|---|---|---|
| 混在トラフィックのデフォルトモデル | はい | 評価後のみ |
| 短い一度きりの呼び出し | はい | 料金面の理由なし |
| 出力の多い生成処理 | はい | 通常は不要 |
| 大規模なキャッシュ済みプレフィックス | 慎重に比較 | コスト面で有利になる可能性 |
| 長時間の自律的なコーディング | まずパイロット | 有力候補 |
| 厳密に範囲を限定したリファクタリング | 通常はこちら | Opusが受け入れテストを通過できない場合 |
| ブラウザ操作や複数段階の自動化 | まずパイロット | ベンチマーク上は有力 |
| 独自フォールバックルーター | よりシンプルな基準 | 移行テストが必要 |
Opus 5をベースラインとして維持し、範囲限定タスクと長時間実行タスクの両方を同じ条件で比較してください。そのうえで、1ドルあたりに完了できる仕事が改善する場合に限り、Fable 5.1へ振り分けるのがよいでしょう。
モデルごとの料金の詳細はClaude Fable 5.1 API pricingを、モデル全体のリファレンスはClaude Opus 5をご覧ください。