 AIREITER
DeepSeekが2026年8月13日に正式リリースしたV4 Pro GAでは、詳細なベンチマーク結果とMITライセンスのオープンウェイト、3段階の推論強度が公開されました。API利用者が特に押さえておくべき変更は料金です。公式の料金ページによると、2026年8月16日16:00 UTCからピーク・オフピーク課金が始まります。V4 Proの出力料金は、従来の100万トークンあたり$0.87から、オフピークで$1.98、ピーク時には$3.96へ上がります。
V4-Pro-0813の正式版で追加された内容
deepseek-v4-pro APIエイリアスの実体は、現在DeepSeek-V4-Pro-0813です。DeepSeekアプリ、Web、APIで利用できます。DeepSeekは8月13日の発表で、4月24日のプレビュー版と比べて「Agent機能を大幅に強化した」と説明しています。
アーキテクチャと主要仕様:
| 項目 | DeepSeek-V4-Pro-0813 |
|---|---|
| 公表モデル規模 | 1.7Tパラメータ(モデルカード。プレビュー版は1.6T) |
| コンテキスト長 | 100万トークン |
| 最大出力長 | 384Kトークン |
| Thinkingモード | 非Thinking/Thinking(デフォルトはThinking) |
| 推論強度 | low、high、max |
| 新デコードモジュール | DSpark speculative decoding(推測トークン数7) |
| API互換性 | OpenAI ChatCompletions、Responses API、Anthropic API、Codex |
| 同時実行数の上限 | 500 |
| ライセンス | MIT |
モデルカードでは、エージェント用途の推奨値としてtemperature = 1.0とtop_p = 0.95が示されています。highおよびmaxでは、出力長を最大384Kトークンまで設定できます。
公式モデルカード掲載のベンチマーク
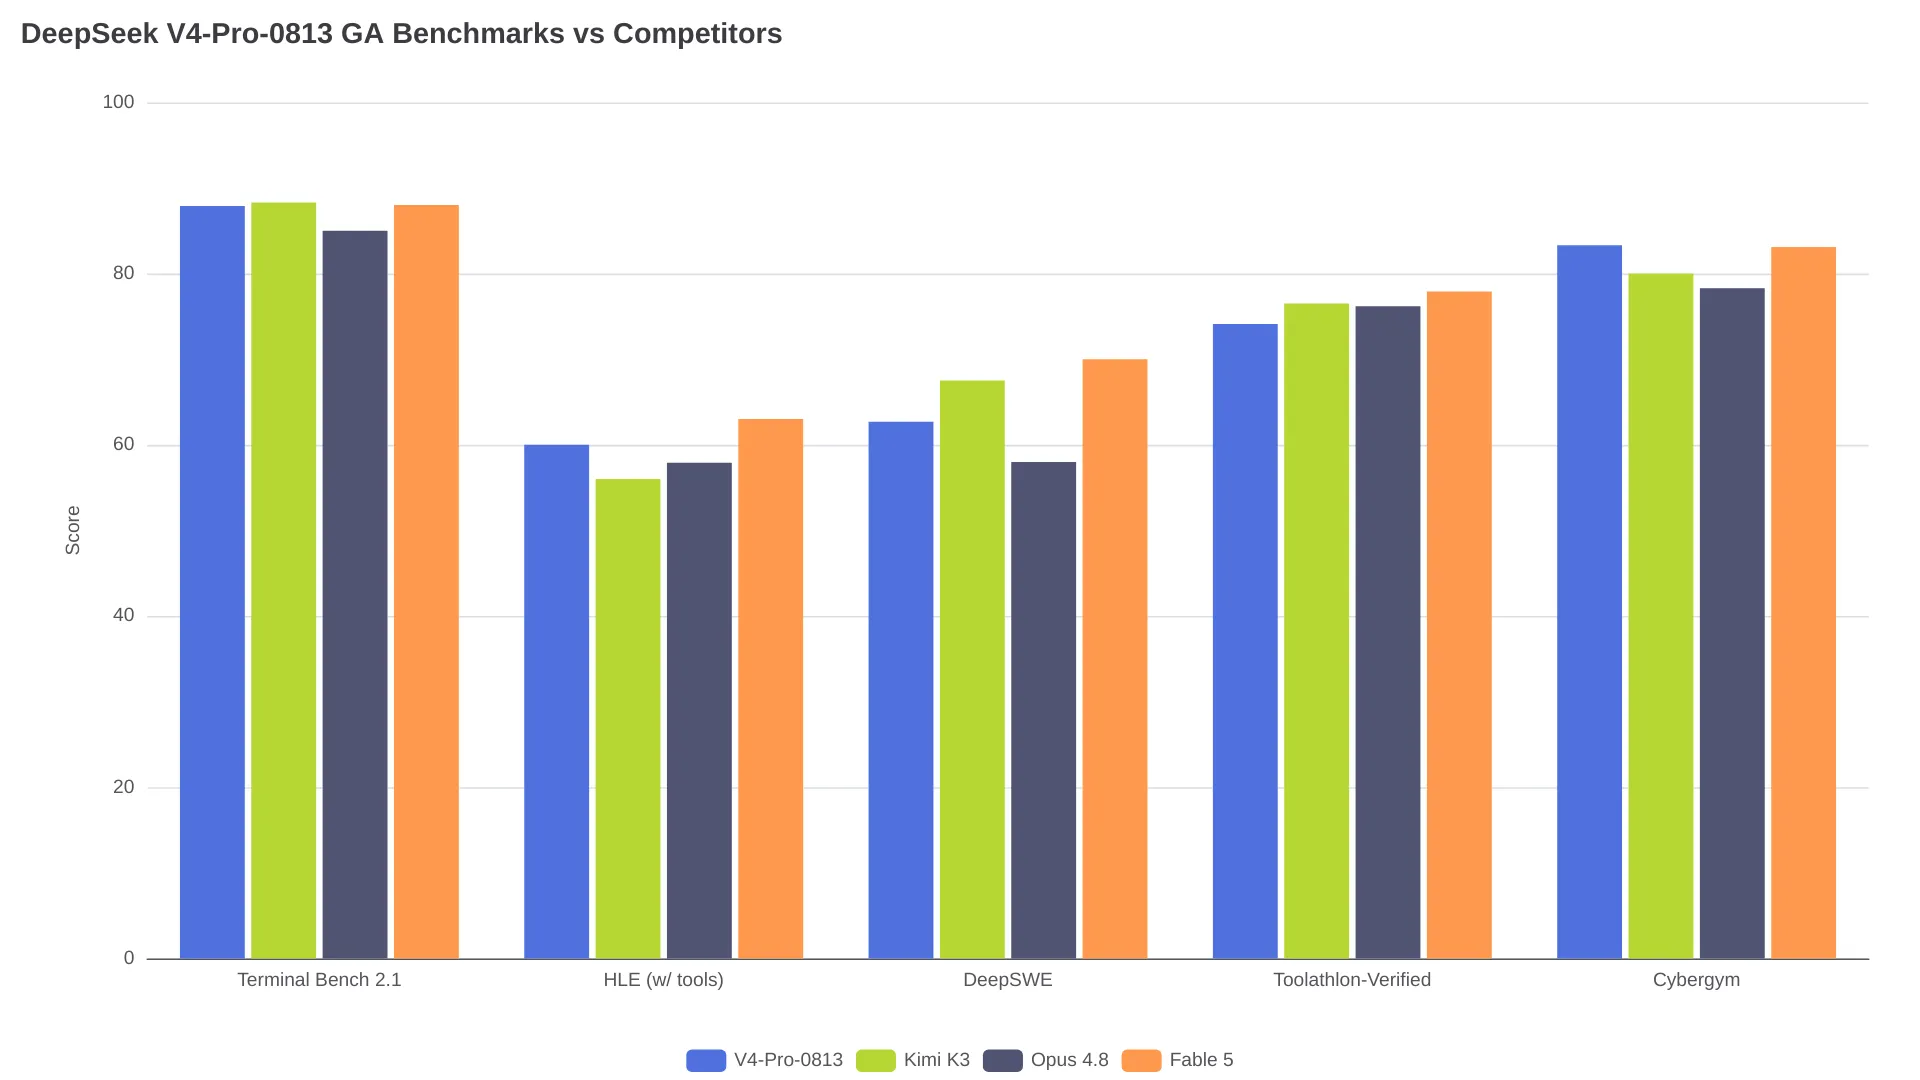
DeepSeekはモデルカードで、10種類のベンチマーク比較を公開しています。コードエージェント系タスクでは、DeepSeek Harnessのminimalモードをmax推論強度で使用しています。最後の2行にあるDSBenchはDeepSeek社内のテストセットです。以下のスコアはいずれもモデルカード掲載値です。
| ベンチマーク | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE(ツールなし/あり) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench(公開版) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack(社内) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard(社内) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
プレビュー版からの伸びは大きく、DeepSWEは12.8から62.7、AutomationBenchは12.8から31.8になりました。競合との比較では、HLEのツール使用ありで60.0を記録し、Kimi K3の56.0、Opus 4.8の57.9を上回っています。一方、DeepSWE、Terminal Bench、Toolathlon-VerifiedではKimi K3とFable 5に及びません。なお、DSBenchの2項目はベンダー社内ベンチマークであり、独立して維持されるベンチマークと同じ重みで評価すべきではありません。
MITライセンスで公開されたウェイト
0813のウェイトはHugging Faceで公開済みで、ライセンスはMITです。vLLMとSGLangによるデプロイに対応しています。モデルカードには、DSpark speculative decoding、FP8 KV cache、単一の4x GB300ノードを使ったvLLMサービングの例も掲載されています。
「現在利用できる最強クラスのプロプライエタリモデルと幅広く競合できる」— DeepSeek V4-Proモデルカード、Hugging Face
8月16日からのAPI料金:現行料金と新料金を比較
料金ページには、現在の一律料金と、2026年8月16日16:00 UTCから適用されるピーク・オフピーク料金が併記されています。ピーク時間は01:00〜04:00 UTCおよび06:00〜10:00 UTCで、北京時間では09:00〜12:00と14:00〜18:00です。それ以外はオフピークとなります。オフピーク料金はピーク料金のちょうど半額です。
DeepSeek V4 Pro(DeepSeek-V4-Pro-0813)
| 課金区分 | 現行の一律料金 | オフピーク(8月16日〜) | ピーク(8月16日〜) | ピーク時の変化 |
|---|---|---|---|---|
| 入力・キャッシュヒット | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| 入力・キャッシュミス | $0.435/M | $0.66/M | $1.32/M | +203% |
| 出力 | $0.87/M | $1.98/M | $3.96/M | +355% |
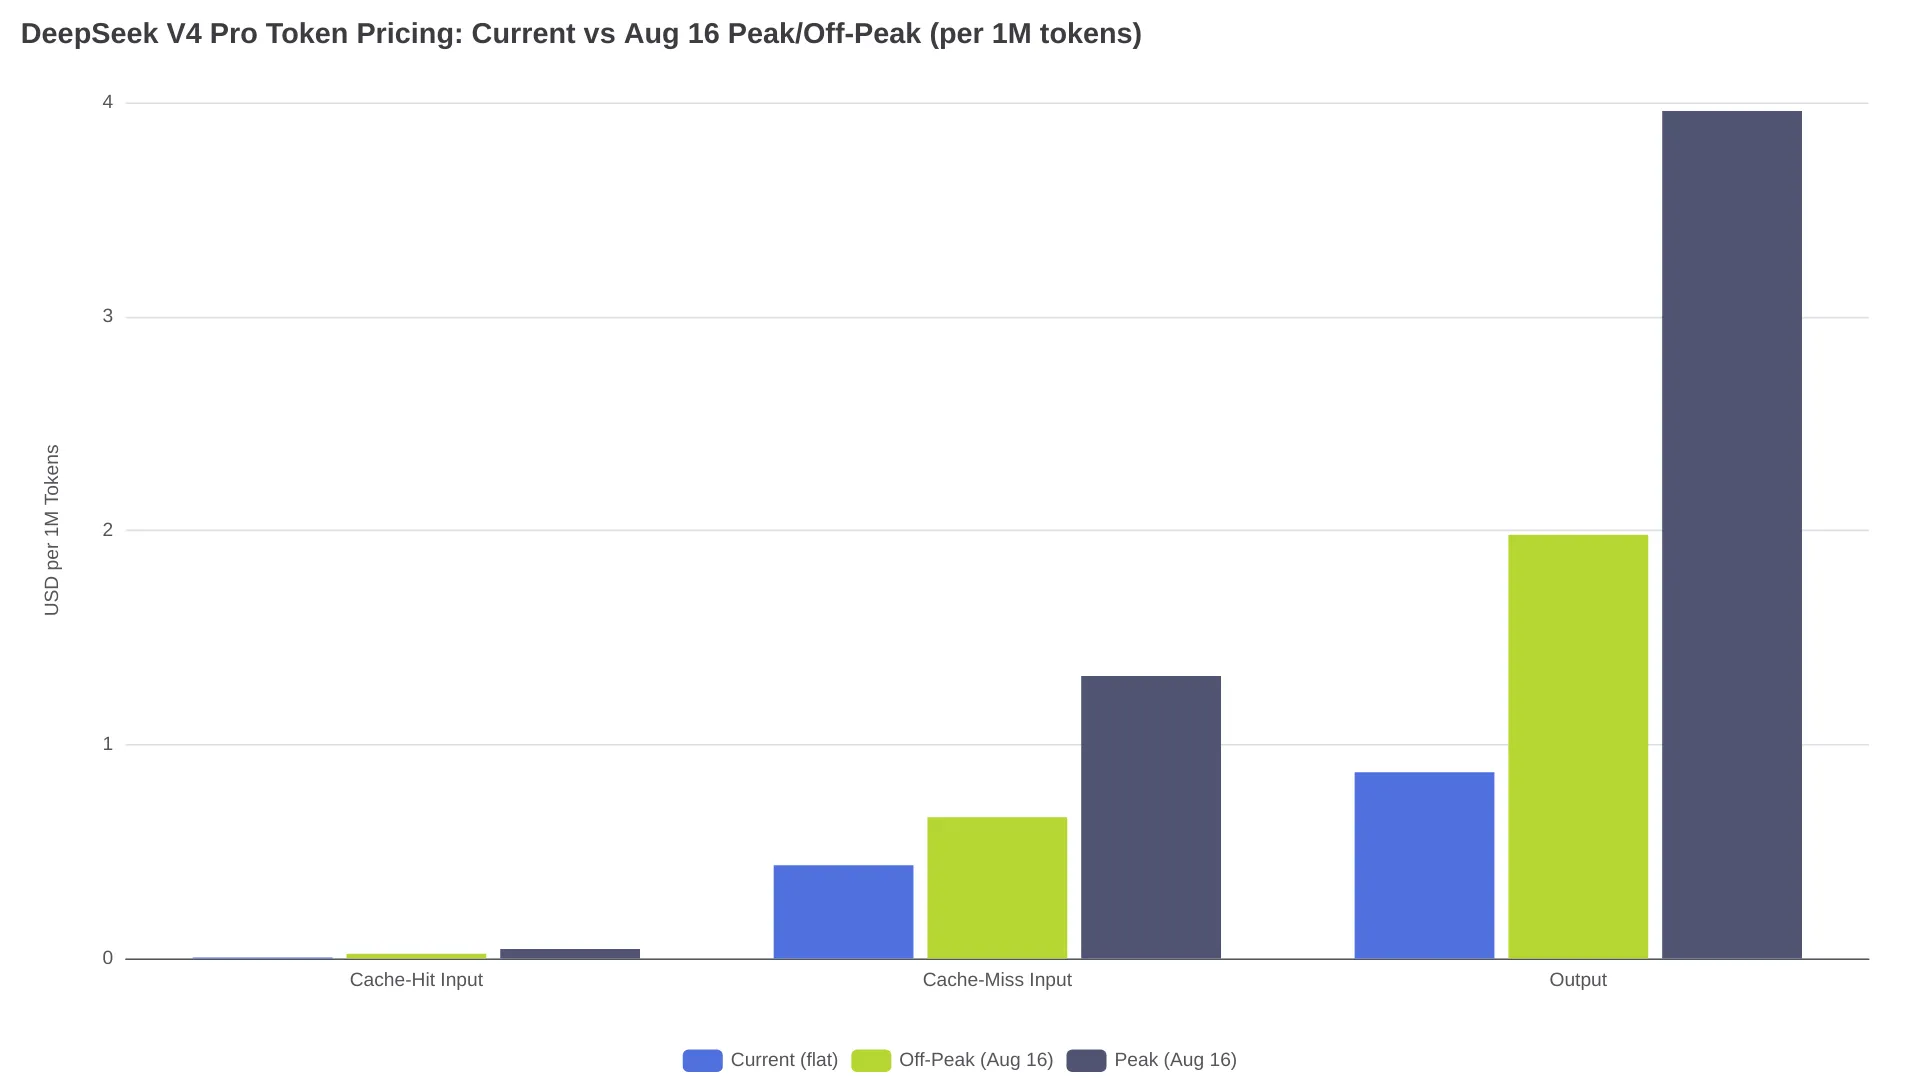
ピーク時の出力料金は4.6倍になります。実運用のエージェントワークフローでは、キャッシュヒット料金の変更がより大きな影響を及ぼします。従来の$0.003625/Mはキャッシュミスよりおよそ120倍安価でしたが、8月16日以降、その比率は両料金帯で30倍まで縮小します。オフピークでは0.022対0.66、ピークでは0.044対1.32です。キャッシュヒットの絶対コストは6〜12倍に上がります。
DeepSeek V4 Flash(DeepSeek-V4-Flash-0731)
| 課金区分 | 現行の一律料金 | オフピーク(8月16日〜) | ピーク(8月16日〜) | ピーク時の変化 |
|---|---|---|---|---|
| 入力・キャッシュヒット | $0.0028/M | $0.007/M | $0.014/M | +400% |
| 入力・キャッシュミス | $0.14/M | $0.22/M | $0.44/M | +214% |
| 出力 | $0.28/M | $0.66/M | $1.32/M | +371% |
同時実行リクエスト数の上限は2,500で、Proの5倍です。
タイムゾーン別:ピーク時間はいつか
| タイムゾーン | ピーク枠1 | ピーク枠2 |
|---|---|---|
| 北京(UTC+8) | 09:00〜12:00 | 14:00〜18:00 |
| ロンドン(UTC+1) | 02:00〜05:00 | 07:00〜11:00 |
| ニューヨーク(UTC-4) | 21:00〜00:00(前日) | 02:00〜06:00 |
| サンフランシスコ(UTC-7) | 18:00〜21:00 | 23:00〜03:00 |
米国を拠点とするチームでは、ピーク時間の大半が夜間から深夜にかけてです。一方、中国や東アジアのチームでは、標準的な業務時間とピーク時間が重なります。
1日1万コールならいくらか:Proの試算
1リクエストあたり、50Kトークンのキャッシュ済みプレフィックスと2Kトークンの応答を送る本番エージェントを想定します。1日あたりの呼び出し回数は10,000回です。
| コスト項目 | 現行一律料金 | オフピーク | ピーク |
|---|---|---|---|
| キャッシュヒット入力(500Mトークン) | $1.81 | $11.00 | $22.00 |
| 出力(20Mトークン) | $17.40 | $39.60 | $79.20 |
| 1日合計 | $19.21 | $50.60 | $101.20 |
| 30日合計 | $576 | $1,518 | $3,036 |
実際のワークロードではピークとオフピークの呼び出しが混在するため、費用はこの範囲内に収まります。同じワークロードをFlashで実行した場合、現行一律料金では$7.00/日、オフピークでは約$16.70/日、ピークでは約$33.40/日です。Flashのピーク料金($33.40/日)はProの現行一律料金($19.21/日)を超えますが、Flashのオフピーク料金($16.70/日)はそれを下回ります。
移行時の確認点:モデルID・推論設定・バージョン固定
廃止されたエンドポイントと後継ID
4月24日のプレビュー発表では、deepseek-chatとdeepseek-reasonerについて、「2026年7月24日15:59(UTC)以降、完全に廃止されアクセスできなくなる」と案内されていました。これらの文字列を参照しているコードは更新が必要です。
| 旧エンドポイント | 接続先 | 置き換え先 |
|---|---|---|
deepseek-chat | V4 Flash、非Thinking | deepseek-v4-flash |
deepseek-reasoner | V4 Flash、Thinking | deepseek-v4-flash(Thinking)またはdeepseek-v4-pro |
deepseek-reasonerはPro相当の推論を提供すると考えていたチームも多いはずです。しかし実際には、ThinkingモードのFlashへルーティングされていました。deepseek-v4-proへ移行すると、出力品質も請求額も変わります。
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}ベースURLはhttps://api.deepseek.comのままです。リクエスト構造にほかの変更はありません。
推論強度の3段階設定
V4-Pro-0813では、単純なタスク向けのlow、日常的なエージェント作業向けのhigh、複雑な問題向けのmaxという3段階の推論強度を導入しています。Thinkingモードはデフォルトで有効であり、Thinkingトークンも出力トークンとして課金されます。たとえば、200トークンの回答を出す前に3,000トークンの思考を行うプロンプトでは、ピーク料金で3,200出力トークン分、すなわち1コールあたり$0.0127が請求されます。回答だけなら$0.0008です。DeepSeekは、長い思考が価値を生まない単純なタスクではlowを使うよう案内しています。
バージョンの固定
deepseek-v4-proは最新ビルドを指すエイリアスであり、DeepSeekが将来のバージョンをリリースすれば更新される可能性があります。本番環境で再現性のある挙動を求めるなら、利用中のプロバイダーが日付付きモデルIDをサポートしているか確認してください。一部のサードパーティゲートウェイは固定ルートを提供していますが、本番利用の前に、各ルートがどのビルドを提供するかプロバイダーのドキュメントで確認しましょう。
APIプロトコルの互換性
両モデルはOpenAI ChatCompletions形式とAnthropic API形式をサポートします。Anthropicエンドポイントはhttps://api.deepseek.com/anthropicです。Responses APIとCodex互換はGAビルドで新たに追加されました。移行後にエラーが出る場合は、両方のプロトコル経路をテストしてください。
値上げ後、ProとFlashはどう選ぶか
V4-Pro-0813は、公開済みの全10指標でV4-Flash-0731を上回っています。ただし、差の大きさはタスクの複雑さによって異なります。
| ベンチマーク | Pro 0813 | Flash 0731 | 差 |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2ポイント |
| DeepSWE | 62.7 | 54.4 | 8.3ポイント |
| AutomationBench | 31.8 | 25.1 | 6.7ポイント |
| Cybergym | 83.3 | 76.7 | 6.6ポイント |
V4 Proを選ぶケース:
- 安定した大きなプレフィックスをエージェントループで繰り返し送信する。ベース料金は上がったものの、キャッシュヒットによる節約は引き続き有効
- 複雑な推論、複数ステップのツール利用、大規模なコード生成にProの大きなパラメータ数が必要
- 同時実行リクエスト数の上限が500でもワークロードを処理できる
V4 Flashを選ぶケース:
- タスクが単純、高頻度、またはレイテンシ重視
- ファンアウト型ワークロードで2,500の同時実行リクエスト数上限が必要
- 出力料金が3倍高いことを品質差で正当化できない
モデル同士をより詳しく比較したい場合は、DeepSeek V4 FlashとProの比較記事を参照してください。APIキーを管理せずモデルを試すなら、V4 ProチャットページとV4 Flashチャットページからすぐに利用できます。
よくある質問
V4-Pro-0813のウェイトはセルフホスティングできますか?
はい。MITライセンスでHugging Faceから入手でき、vLLMとSGLangのデプロイ経路が用意されています(デプロイの詳細は上記「MITライセンスで公開されたウェイト」を参照)。
GA版に合わせてV4 FlashからV4 Proへ移行すべきですか?
コスト重視のワークロードの大半では、Flashの方が依然として費用対効果に優れます。ベンチマーク上の差は、Agents' Last Examの0.5ポイントから、ツール使用ありHLEの8.5ポイントまでです。一方、出力料金はFlashが3倍安価です。複雑な複数ステップの推論や大規模コード生成でフルパラメータ数が必要な場合に、Proへの移行を検討してください。
値上げの影響を抑えるには?
有効な手段は3つです。バッチジョブや延期可能なエージェントをピーク時間外(01:00〜04:00 UTC、06:00〜10:00 UTC)に実行すること、プロンプトのプレフィックスを安定させてキャッシュヒットを最大化すること、単純なタスクをFlashへ振り分けるか、Proではlowの推論強度を使うことです。
ピーク・オフピーク料金はDeepSeekアプリやWebサイトにも適用されますか?
公式料金ページに記載されているのはAPIトークン課金のみです。このスケジュールは直接API呼び出しに適用されます。ゲートウェイプロバイダーは料金をそのまま転嫁する場合もあれば、マークアップを加えたり、独自料金を採用したりする場合もあります。最新の詳細は料金ページで確認してください。