 AIREITER
语音实时交互模型已经不稀奇,真正值得关注的是它能否同时看懂、听懂,并在恰当的时机开口。字节跳动于 2026 年 8 月 5 日发布的 SeedRealtime,定位为原生音视频全双工大模型:音频和视频由一个端到端模型联合处理,不需要额外模块来判断该轮到谁说话。对开发者而言,现实限制也很明确:发布时它尚未提供公开 API 或价格信息,目前部署在字节跳动自有产品中。
SeedRealtime 到底是什么
SeedRealtime 由字节跳动 Seed 团队打造,在同一套架构中融合音频、视频与文本。它面对的是持续输入的多模态流,可完成感知、理解、决策和回应,而不是让数据在多个独立环节之间来回传递。
字节跳动对它的概括是“边看、边听、边说”:模型在实时互动中,将听到的内容与看到的画面共同纳入每一次回答。SeedRealtime 属于 Seed 模型矩阵,同列的还有 Seed2.1(为 Doubao 提供能力的大语言模型家族)、Seedance(视频生成)、Seedream(图像生成)、Seed Audio 1.0(音频生成)以及 Seed GR-RL(机器人)。
它并不完全落在传统分类里:不是单纯的 TTS 模型,因为它不仅生成语音,也理解语音;不是单纯的视觉模型,因为视觉能力服务于对话;更不只是又一个实时语音机器人。
全双工,才是核心差异
所谓“全双工”,指模型能一边听、一边回应,并持续判断当前是谁在说话、自己何时该插话,更接近真人对话的自然状态。SeedRealtime 的关键主张在于:它把声音、视觉、时序和表达统一到一个端到端模型里,而非通过拼接多个模块实现。
过去的实时 AI 交互,主要受限于两种旧范式。级联式方案会依次连接 ASR(语音转文字)、LLM 或 VLM,以及 TTS(文字转语音)。这种架构模块化程度高,方便调试,但每一次交接都会增加延迟、丢失信息;语气、重叠说话、口音和视觉上下文往往在 ASR 阶段就消失了。端到端语音模型省去了这些交接,因此听起来更自然,但大多数仍依赖外部语音活动检测器(VAD)来判断轮次,本质上依然接近半双工:问一句,答一句。
SeedRealtime 则把感知、理解、决策和表达收进一个模型中,在持续的音视频流上并行运行,也不依赖外部 VAD 来决定对话轮次。
| 方案 | 工作方式 | 双工模式 | 轮次判断 | 主要短板 |
|---|---|---|---|---|
| 级联式(ASR + LLM/VLM + TTS) | 多个模块按顺序串联 | 半双工 | 固定端点检测 | 每次模块交接都会带来延迟和信息损失 |
| 端到端 + 外部 VAD | 一个模型配合外部轮次检测器 | 半双工 | 外部 VAD | 仍然是“一问一答” |
| SeedRealtime | 统一的音视频端到端模型 | 全双工(官方宣称) | 内部多模态判断 | 产品较新,能力描述主要来自厂商 |
难点在于,视频不像语音那样存在天然停顿。模型必须持续判断该关注哪个物体、哪一个人的声音更重要、现在是否适合开口,同时还要避免被背景噪声误触发。
SeedRealtime 展示的三项能力
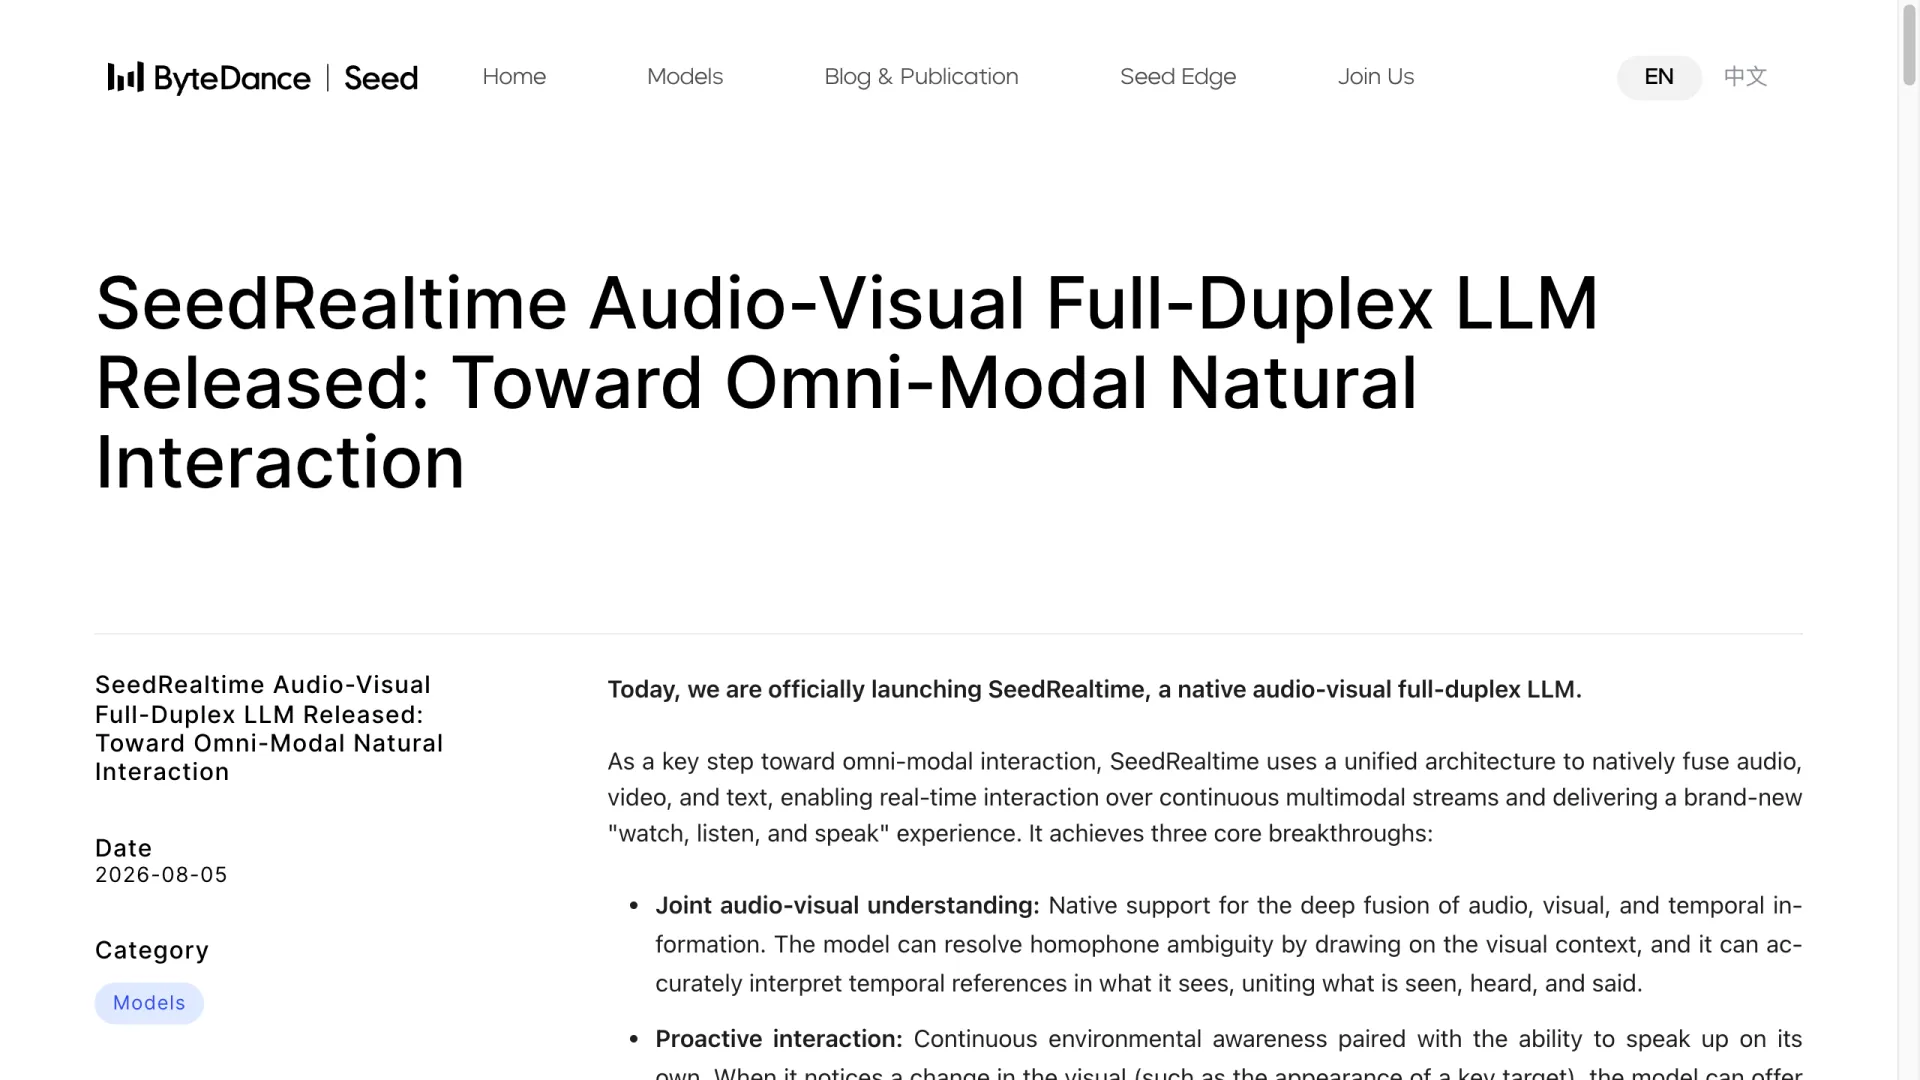
字节跳动在官方文章中将 SeedRealtime 的表现归纳为三类:音视频联合理解、主动交互和自然的对话节奏。其展示重点并非跑分表格,而是具体使用场景。
音视频联合理解
模型能用眼前正在发生的事,消解语音中的模糊指代。比如用户说“这个怎么弄”,SeedRealtime 会结合屏幕内容、手势、视线以及此前的操作,判断“这个”具体指什么。
在字节跳动的演示中,一位用户吃饭时依次介绍了四位朋友,SeedRealtime 将姓名与面孔对应起来,并在众人讨论旅行计划时持续将声音与身份关联:有人想去海边,有人怕热,还有人对海鲜过敏。在一家川菜馆里,它通过摄像头读取只有中文的菜单,用英语推荐菜品,并解释“鱼香肉丝”为何其实没有鱼。
能主动出声,而非被动等待
场景发生变化时,模型可以自行提醒,不必等用户再次提问。比如参观博物馆时,用户说“看到青铜虎噬鹿座时提醒我”,SeedRealtime 会持续观察摄像头画面,直到该文物出现,再给出提醒和相关背景。
它看到有人把整颗咖啡豆直接倒进手柄粉碗时,会主动打断并提示:要先磨成细粉。萃取完成后,它还会根据油脂颜色,建议下一杯将萃取时间缩短两到三秒。查询、预订等工具调用也被融入对话过程,而非作为额外步骤单独处理。
更自然的对话时机判断
SeedRealtime 会从多模态上下文中决定该说话、停顿还是保持安静,并尽量避免误触发。在拥挤的北京机场,它不会因为同行者随口提到“老李的航班”就插话;但在用户询问时,它能回忆起已经从屏幕滚动消失的航班信息,再联网查询行李转盘位置。在家中,当家长在背景里打电话时,它会继续专注于纠正孩子的英语发音。
字节跳动的端到端人工评测称,与级联模型相比,SeedRealtime 可将音视频对话节奏问题大致减半,包括句中被打断、停顿后响应迟缓、噪声导致误触发等情况;单轮对话顺畅且完整完成的比例也更高。不过,这些结果来自厂商自行评测,并非独立基准测试。
对比 GPT-4o Realtime、Gemini Live 与级联架构
对开发者来说,更实际的问题是:SeedRealtime 与现有可直接调用的实时系统究竟差在哪?简短而准确的答案是,多数现有“实时”API 以音频为核心;SeedRealtime 的差异化主张,则是以全双工方式联合建模音频和视频。
OpenAI 的 Realtime API,以及 Google 面向消费者的 Gemini Live 功能及其开发者接口 Live API,都提供低延迟实时对话体验,但核心仍是音频,即语音输入和语音输出;视觉通常单独处理,对话轮次也仍依赖端点检测或 VAD。SeedRealtime 的定位则是将原生音视频融合、由模型内部决定的全双工时机、主动提示,以及融入对话的工具使用结合在一起。
| 模型 | 原生模态 | 双工模式 | 轮次判断 | 主动交互 / 工具使用 | 公开 API |
|---|---|---|---|---|---|
| SeedRealtime | 音频 + 视频 + 文本(融合) | 全双工(官方宣称) | 内部多模态判断 | 有,融入对话 | 没有(发布时) |
| GPT-4o Realtime API | 音频 + 文本 | 实时,VAD 管理 | 外部端点检测 | 通过函数工具实现 | 有 |
| Gemini Live / Live API | 音频 + 文本(消费者应用支持摄像头) | 实时,VAD 管理 | 外部端点检测 | 有限 | 有(Live API,音频) |
| 级联架构 | 文本(通过 ASR/TTS 支持音频) | 半双工 | 固定 | 自行定制 | 自行搭建 |
SeedRealtime 的优势主要来自字节跳动自身的演示和评测,目前没有公开的材料将它与 GPT-4o realtime 或 Gemini Live 正面对比。因此,上述内容应视为架构定位,而不是已经测得的性能领先结论。
开发者现在能用 SeedRealtime 吗?
截至 2026 年 8 月 5 日发布时,SeedRealtime 尚未以开发者 API 的形式开放。字节跳动称其已“全面上线”,但这指的是部署在自家产品中,并不意味着任何人都可以调用一个开放端点。
发布时,SeedRealtime 没有公开 API、价格页面或开发者文档。字节跳动的商业 API 平台是 Volcengine(火山引擎),其中提供 Doubao 模型家族,包括 Seed 2.1 Pro 和 Turbo LLM、Seed-ASR、Seed-TTS 等。SeedRealtime 在发布时并未列入其中,第三方中转服务也没有可替代的实时音视频能力。
对于现在就需要实时接口的团队,短期内务实的选择仍是以音频为中心的方案:OpenAI 的 Realtime API、Google 的 Live API,或自行搭建级联架构。SeedRealtime 更适合作为值得持续关注的架构方向。字节跳动尚未公布其 Volcengine 或 BytePlus 实时 API 的上线日期。
常见问题
SeedRealtime 已经向公众开放了吗?
截至 2026 年 8 月 5 日发布时,它已部署在字节跳动自有产品中,但尚没有名为 SeedRealtime、可供用户注册使用的公开应用或端点。
SeedRealtime 有 API 吗?
发布时没有。字节跳动尚未提供 API 访问、定价或开发者文档;未来最可能的承载平台是火山引擎的 Doubao API 家族,但目前尚未列出 SeedRealtime。
SeedRealtime 与 GPT-4o realtime 有什么不同?
GPT-4o 的 Realtime API 以音频为核心,提供语音输入和语音输出。SeedRealtime 的主张是:在单一全双工模型中联合处理音频和视频,同时自行决定对话时机,并能主动交互。目前尚无独立的正面对比测试。
SeedRealtime 免费吗?
发布时它没有独立产品或 API 定价,因此暂时不适用“免费还是付费”的问题;它目前是字节跳动产品内部的一项能力。
AI 模型的“全双工”是什么意思?
它表示模型能同时倾听和回应,并持续建模对话状态,自主决定何时说话或停顿,而不是被锁定在一问一答的轮次中。
延伸阅读
- OpenAI Realtime API pricing —— 开发者目前真正可以调用的实时音频端点
- Qwen Audio 3 Realtime —— 另一款可供对比的实时语音模型