 AIREITER
先说结论:如果你制作英文或中文的短音频内容,Seed Audio 1.0 现在值得一试——但更现实的接入方式是第三方网关,而不是官方 API。ByteDance 的这款模型只需一条提示词,就能生成包含对白、背景音乐和音效的完整音频场景;多角色对话加上内置音乐混音,正是它区别于单一 TTS 或音乐生成工具的地方。不过,它目前也有三项硬限制:单次最长只能生成两分钟、仅支持中英文,官方 API 仍处于邀请制且尚未公布价格。下面逐项展开。
Seed Audio 1.0 到底是什么
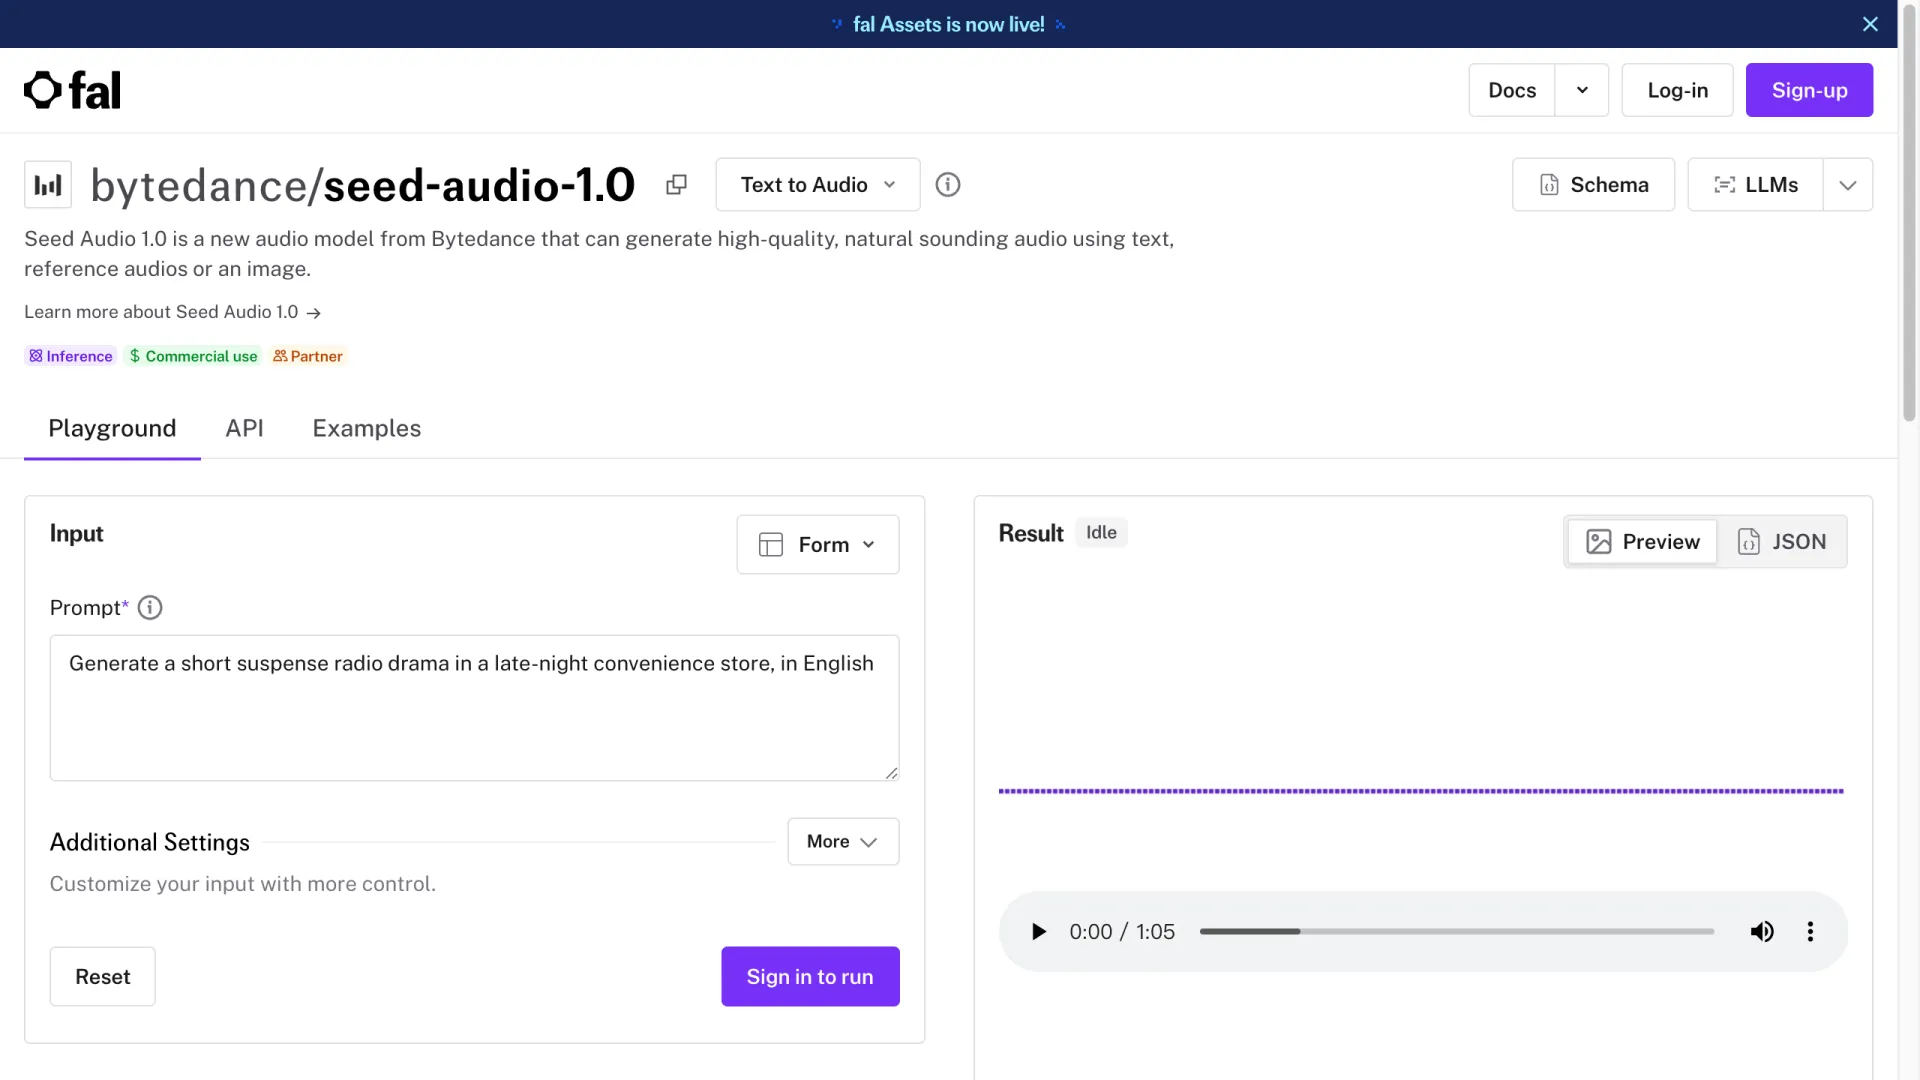
大多数音频工具只解决一件事:要么做文本转语音,要么生成音乐,要么生成音效。Seed Audio 1.0,全称 Doubao-Seed-Audio 1.0,则试图一次性完成这三件事,并将它们放在同一条时间线上输出。比如输入“深夜便利店里的悬疑广播剧”,它可以直接给出成品音频:台词、环境声和音乐铺底都已经混好。
它提供三种工作模式。文本转音频(T2A)根据文字描述生成完整场景;文本加音频转音频(TA2A)允许你同时提供参考音频和文本,用于引导声音与风格;常规 TTS 则面向只需要干净旁白的场景。该选哪种模式,取决于你给模型输入什么素材。
还有一个容易混淆的问题:它算不算声音克隆工具?Seed Audio 1.0 能让同一种声音演绎多个角色,也能模仿参考片段的语气与风格,但生成结果是合成语音,并非绑定某一位真实说话者身份的复刻。更准确地说,它属于零样本声音风格化,而不是可以绕过授权、克隆特定人物声音的工具。它建立在 ByteDance 此前的 Seed-TTS 与 Seed-Music 研究之上,因此能把富有表现力的语音和音乐生成能力整合进同一个模型。
先看这些规格,判断是否适合你的项目
在开始之前,先确认你的需求能否接受这些硬性上限。以下是综合 fal 和 EvoLink 模型页面交叉核对后,真正值得关注的数据:
| 规格 | 数值 |
|---|---|
| 单次生成最长输出 | 120 秒(2 分钟) |
| 文本提示词上限 | 约 1,500–2,000 个字符(不同来源存在差异,请以控制台为准) |
| 参考音频 | 最多 3 段,每段 ≤30 秒 |
| 支持语言 | 仅英语和中文 |
| 输出格式 | WAV、MP3、PCM、OGG Opus |
| 采样率 | 48K / 24K / 16K / 8K |
| 可调参数 | 语速、音高、音量(不支持 SSML) |
| 计费方式 | 按输出时长计费 |
最容易卡住实际工作的,是两分钟的时长上限。无论是完整播客节目还是长篇旁白,都需要拆分脚本、分段生成后再拼接,而这会带来不同片段之间音色和氛围不一致的风险。fal 的模型说明提到,后续计划将单次生成时长提升至接近十分钟,同时加入明确的时长控制和更多语言支持;如果你的核心工作就是长音频,或许值得等这一更新。
价格:官方尚未公布
目前没有官方定价。截至 2026 年 7 月,Volcengine 尚未公布 Seed Audio 1.0 的按秒费率:它在 Volcano Ark 上仍为邀请制,官方价格通常会在全面开放后推出。fal 和 EvoLink 这类网关也没有写死统一费率,而是按输出时长收费,也就是成本 = 生成秒数 × 费率;生成失败后重试,同样会产生计费。至于网上流传的按 token 计费数字,可以忽略——对于按时长输出的音频模型,token 计费逻辑并不适用。
现在如何实际用上 Seed Audio 1.0
目前有两条接入路径,但使用体验差别很大。
官方路径是 Volcano Ark。Seed Audio 1.0 在这里仍采取邀请制:你需要提交申请、等待开通,然后通过 ByteDance 自家的控制台使用。等到全面开放和正式定价落地后,这里也会是最权威的来源。
更实际的选择是第三方网关。fal 以 bytedance/seed-audio-1.0 托管该模型,不需要白名单;使用常规 API key 即可调用端点,EvoLink 也提供类似的接入方式。对于不想等待邀请的人来说,这就是目前生成该模型音频的主要途径。
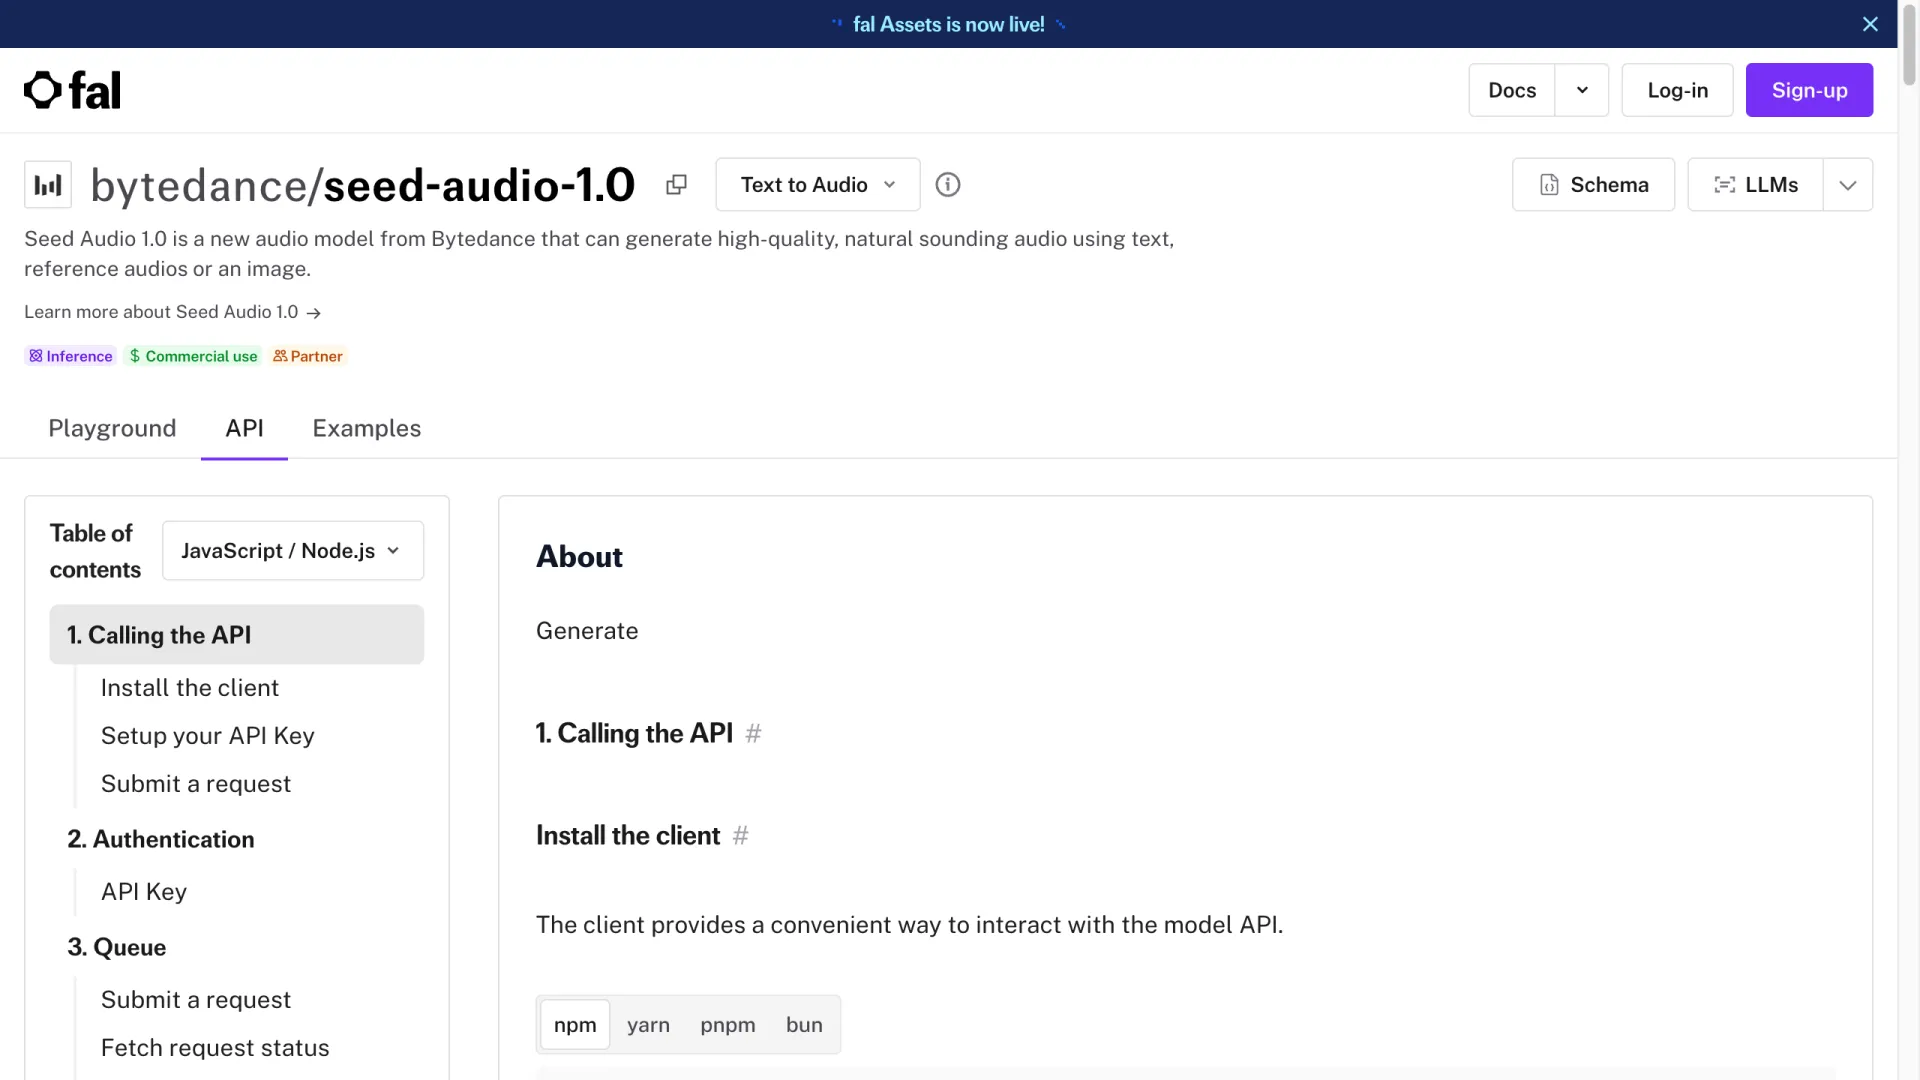
调用方式是典型的队列式 API:安装客户端、配置密钥、提交提示词,再轮询等待结果。如果你此前接入过任何托管式生成模型,这套流程几乎没有额外学习成本;关于开发者体验,欢迎查看我们的 fal.ai 评测。
第一次测试时,建议从一段短小的多角色场景入手,同时检验对白、环境声和节奏表现。比如:“一段 30 秒的深夜便利店悬疑广播剧,英语。”首条生成控制在 30 秒以内,即使结果不理想,试错成本也较低,同时你也能快速摸清模型如何理解提示词。
Seed Audio 1.0 对比 ElevenLabs、Stable Audio 与 AudioCraft
真正有意义的比较,不是谁单段音频的质量更高,而是每个工具到底为哪类任务而设计。
| 工具 | 核心优势 | 场景混音 | 语言 | 声音控制 |
|---|---|---|---|---|
| Seed Audio 1.0 | 完整音频场景(语音 + 音乐 + 音效) | 支持,单次完成 | 英语、中文 | 零样本风格化 |
| ElevenLabs | 语音与声音克隆 | 仅语音 | 30+ | 克隆能力最强 |
| Stable Audio | 音乐与声音生成 | 单轨 | 不适用(音乐) | 基于提示词 |
| AudioCraft | 开源音乐/音效生成 | 单轨 | 不适用(音乐) | 基于提示词 |
如果你追求最强的纯语音效果,或者要在多种语言中实现精确的声音克隆,ElevenLabs 仍然领先。如果你只需要独立生成音乐,Stable Audio 或 Meta 的 AudioCraft 更是为此而生。Seed Audio 1.0 的独特价值,在于将对白、音乐和音效组合为一个连贯且可编辑的完整场景;上述工具中,没有其他产品能在一次调用里做到这一点。
它擅长什么,又欠缺什么
优势:多角色对白,以及一次生成中完成音乐和音效混音,是它最核心的吸引力。根据 fal 的使用指南,其文档化编辑流程还包括延长片段、局部重绘和拼接不同生成结果,因此它不只是一次性出结果的玩具,更具备一定的制作工具属性。
不足:两分钟上限让长内容必须依赖拼接;仅支持英语和中文,也排除了大多数面向全球市场的语音工作。它属于离线生成模型,不适合实时语音代理;此外,官方接入至今仍受邀请资格限制。
现在值得用吗?
如果你的内容是英文或中文,并且属于短音频形式——例如配音、有声书片段、短视频配乐、音频剧原型——那么 Seed Audio 1.0 值得通过网关试用。一次生成完整场景,意味着你不必再手动叠加语音、音乐和音效。
但如果你需要实时交互、不支持的语言,或需要长时间且不中断的连续音频,建议先等等。全面开放和计划中的时长更新都会改变使用价值;在此之前,像 Qwen Audio 3 这样的实时模型,更适合直播和实时交互场景。对其他用户而言,现在更适合“通过网关测试,同时保留现有工作流”,而不是彻底迁移。
常见问题
Seed Audio 1.0 免费吗?
不免费。官方没有免费层级:Volcano Ark API 目前仅限邀请,获得访问权限后将按输出时长计费。第三方网关则采用各自的按量计费标准。
Seed Audio 1.0 能克隆我的声音吗?
它可以模仿参考片段的风格,也能让一种声音演绎多个角色,但输出的是合成语音,并不是对特定真实人物声音的固定克隆。不要把它当成可直接替代身份声音克隆的工具。
Seed Audio 1.0 支持哪些语言?
发布时仅支持英语和中文。根据 fal 的模型说明,更广泛的多语言支持已列入后续更新路线图。
生成的音频最长可以多长?
目前每次生成最长为 120 秒。计划中的更新将把单次生成时长提升至接近十分钟,并提供明确的时长控制。
有官方的 Seed Audio 1.0 API 吗?
有,位于 Volcengine 的 Volcano Ark,但目前仍为邀请制。如果想免白名单开放接入,可以使用托管 bytedance/seed-audio-1.0 的 fal 等网关。
Seed Audio 和 Seed Music 有什么区别?
Seed-Music 是 ByteDance 早期聚焦音乐的研究项目;Seed Audio 1.0 则将这项音乐能力与语音、音效整合在一起,成为统一的场景音频生成模型。