 AIREITER
Qwen Audio 3.0 Realtime 是 Qwen 当前产品线中的实时音频能力:你可以直接和模型对话,它也能几乎同步用语音回应,交互延迟低到接近打电话的感觉。在阿里云平台上,这项能力通过 Qwen3-Omni / Qwen3.5-Omni Realtime API 提供,模型 ID 包括 qwen3-omni-flash-realtime;纯文本转语音可用 Qwen-TTS-Realtime,语音转写则对应 qwen3-asr-flash。托管版 omni Realtime 模型支持识别 100 多种语言,可全双工交互、支持打断,每分钟对话成本低至不足一美分。
最快的上手方式,是通过 WebSocket 调用 qwen3-omni-flash-realtime。下面会说明各模型分别适合做什么、实际价格如何、与 OpenAI Realtime 和 Gemini Live 有何差异,以及怎样开始接入。文中的规格、价格和模型 ID 均链接至一手来源,主要参考阿里云的 Model Studio Realtime 文档和 Qwen3-Omni 模型卡。这个领域的更新很快,如果数字与本文不一致,应以链接中的最新资料为准。
先理清 Qwen 音频模型的命名逻辑
Qwen 的音频模型经历了几代演进,弄清它们之间的关系,选型会简单很多:
Qwen-Audio(2023)和Qwen2-Audio属于音频理解模型:输入音频,输出文本,不会直接开口说话。- 当前一代将音频能力整合进全模态模型。
Qwen3-Omni与Qwen3.5-Omni可接收文本、图像、音频和视频,并生成文本及自然语音。 - 实时能力本质上是一种服务形态:通过 Realtime API 调用同一套 omni 模型,模型 ID 以
-realtime结尾。
因此,无论写作 “Qwen Audio 3.0 Realtime” 还是其他类似形式,通常指的都是以实时方式运行的 Qwen3-Omni 系列;下文讨论的也是这套技术栈。
实时语音应用通常由这三层组成
与其把它理解为单一模型,不如把它看作一条音频处理链路。一个生产级语音应用通常会涉及三类 Qwen 模型;它们既能组合使用,也能各自独立调用。
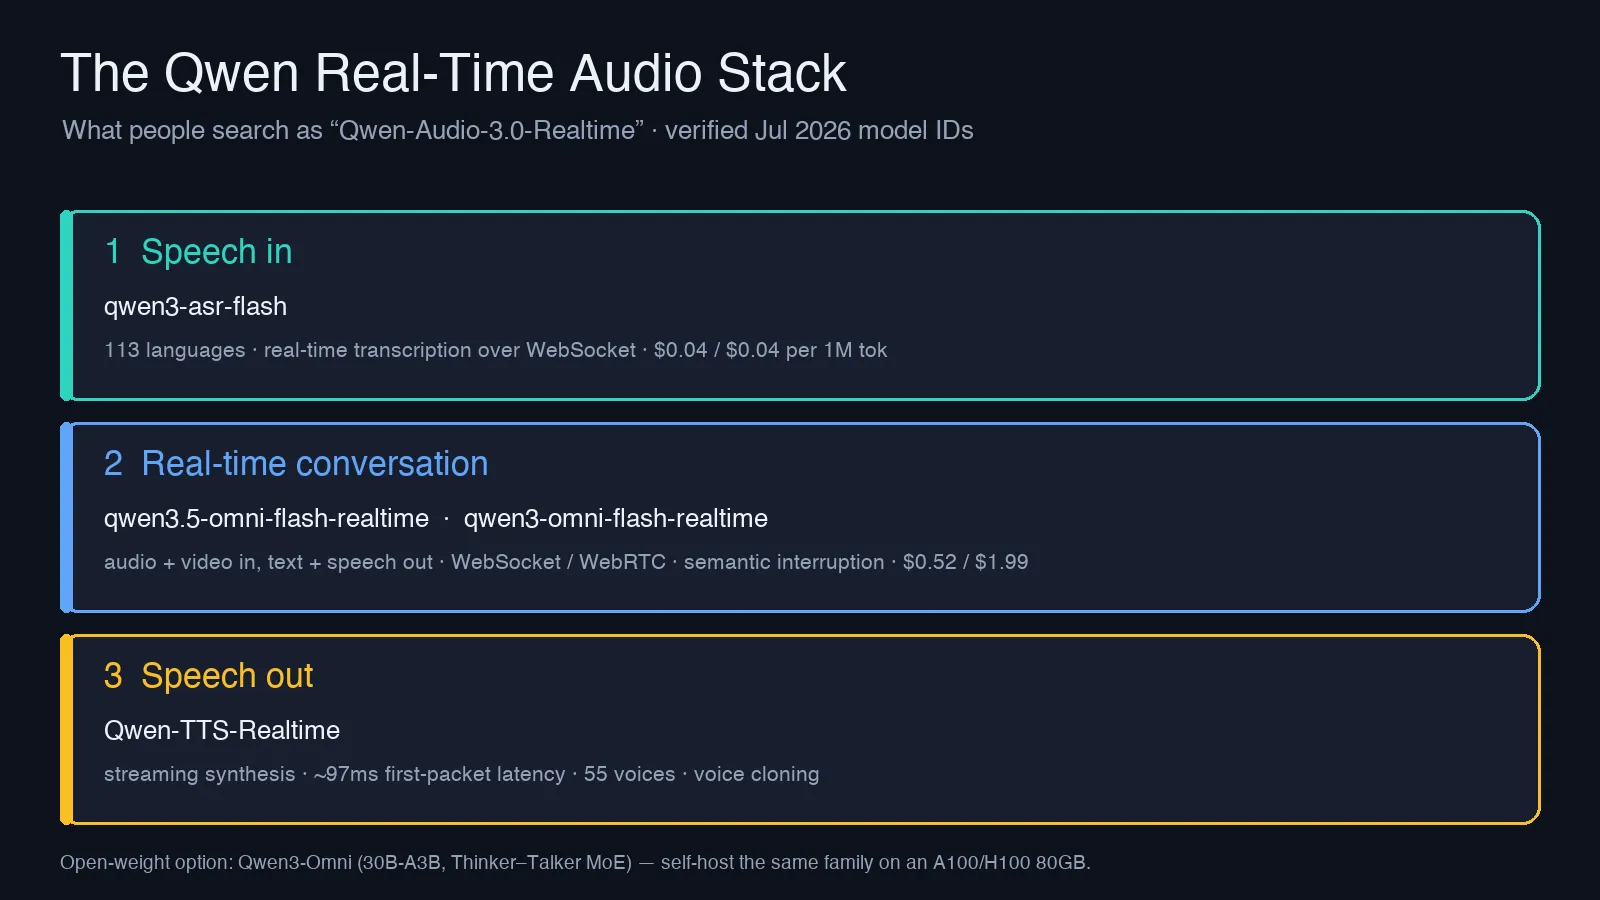
- 语音输入:
qwen3-asr-flash。 通过 WebSocket 进行流式语音识别,适用于实时字幕和语音智能体前端。它覆盖极广的语言范围,定位是低成本的转写主力模型。 - 实时对话:
qwen3.5-omni-flash-realtime、qwen3-omni-flash-realtime、qwen3.5-omni-plus-realtime。 这是核心环节:持续连接中输入音频和视频帧,输出文本与合成语音;每轮对话无需重新建立请求。 - 语音输出:
Qwen-TTS-Realtime。 专用的流式文本转语音模型,适合只需将文本转成语音的场景,例如朗读文本 LLM 生成的回答。
如果中间层直接使用 omni Realtime 模型,通常无需单独调用 ASR 和 TTS,因为它本身已覆盖端到端的语音输入与输出。独立模型的价值在于灵活组合,例如接入自己的 STT,再使用 Qwen TTS。
真正影响体验的规格参数
以下数据来自Model Studio Realtime 文档,不是营销页面上的宣传口径。
| 项目 | Qwen Realtime API(omni 系列) |
|---|---|
| 音频输入 | PCM,16 kHz |
| 音频输出 | PCM,24 kHz |
| 其他输入 | 图像 / 视频帧(JPG,最高 1080p,编码后不超过 256 KB) |
| 语音识别 | 113 种语言和方言(托管 API) |
| 语音生成 | 36 种语言和方言 |
| 音色 | 共 55 种(47 种多语言音色、8 种方言音色);3.5 模型还支持声音克隆 |
| 连接方式 | WebSocket(Bearer 鉴权,手动或服务端 VAD)与 WebRTC(SDP 协商) |
| 单次会话上限 | WebSocket 下为 120 分钟 |
| 附加能力 | 语义打断、函数调用、自主网页搜索、音量 / 语速 / 情绪等语音控制 |
其中几项尤其值得关注。语义打断意味着模型能区分用户真正想插话,与只是说一句“嗯嗯”表示在听;这正是语音助手听起来自然还是令人烦躁的关键。对于浏览器应用,WebRTC 支持同样重要,因为它会处理回声消除和网络抖动。还要注意,113 种语言的识别能力是托管 API 的数据;开源权重版本覆盖的语言范围更窄,后文会说明。
再看延迟:根据 Qwen3-TTS 流式文档,专用的 Qwen-TTS-Realtime 流式链路目标首包延迟约为 97 ms。决定语音是否显得即时的,正是这个指标;它指首个音频块到达的时间,并非完整回答生成完毕的时间。对于完整对话链路,Thinker–Talker 架构本就面向流式输出设计;Qwen3-Omni 技术报告介绍了一种旨在降低延迟的多码本设计,社区测试则显示,在支持全双工和可打断交互的情况下,音频到音频的响应可进入 250 ms 以下。实际表现仍取决于所在区域、网络和负载,别只看单一宣传数字,最好用自己的真实流量测试。
Qwen 实时音频怎么收费
Qwen 托管实时模型的价格明显低于封闭式实时 API。以下为每百万 Token 的输入 / 输出单价,数据来自 Portkey 的 DashScope 模型目录。该第三方聚合平台会同步阿里巴巴的价格;在正式投入前,仍应到 Model Studio 控制台确认实时价格:
| 模型 | 输入 / 100 万 Token | 输出 / 100 万 Token |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash(转写) | $0.04 | $0.04 |
换算到一次通话要多少钱。 音频属于 Token 密度较高的输入,大约每分钟 427 Token。假设一次语音对话持续 10 分钟,用户说了 5 分钟,模型回答 5 分钟,那么在 qwen3-omni-flash-realtime 上,大约会产生 2,135 个输入 Token 和 2,135 个输出 Token,费用约为$0.001 输入 + $0.004 输出 ≈ 每 10 分钟通话半美分。即便规模扩大,实时音频本身依然便宜;真正容易被低估的是输出端的说话时长,因为语音输出价格约为输入的 4 倍。
做预算前,还有两点需要留意:
- 有免费额度,但取决于区域。 新加坡(国际)端点曾提供90 天内 100 万输入 Token 和 100 万输出 Token 的免费额度;美国端点则没有。额度可能调整,在据此规划前,应先在对应区域的 Model Studio 控制台确认当前活动。
qwen3.5-omni档位按请求大小分档计费,并非统一固定单价。因此,一次大上下文请求的价格区间可能不同于多次小请求。正式选型前,应使用自己的真实流量形态进行验证。
与 OpenAI Realtime、Gemini Live 相比如何
在通用前沿 LLM 厂商中,到了 2026 年年中,较直接的实时语音到语音方案主要有三种:OpenAI 的 Realtime API、Google 的 Gemini Live,以及 Qwen 的 omni Realtime 系列。ElevenLabs、Deepgram、Cartesia、Hume 等专业语音服务商,在 TTS 和 STT 领域同样极具竞争力;但这里比较的是完整的多模态模型路径。竞争产品价格按月变化,与其列出很快过时的数字,不如从以下维度判断:
- 成本。 按照上文的单次调用成本,Qwen 的实时定价处于托管前沿模型方案的低位。作为对照,OpenAI Realtime 的音频价格曾约为输入每分钟 $0.06、输出每分钟 $0.24(价格拆解见此);据此计算,同一通 10 分钟电话,在
qwen3-omni-flash-realtime上约半美分,在 OpenAI 上则接近$1.50。依赖这个差距前,仍应确认双方实时价格,因为它们都会变化;不过价差很明显。Qwen 也是三者中唯一提供开放权重版本的选择,自己部署可将边际成本压向零。 - 开放性。 OpenAI Realtime 与 Gemini Live 都只提供封闭 API。Qwen3-Omni 则发布了开放权重,未来从托管服务迁移至自托管,无需围绕另一模型的行为重新改写应用。
- 质量。 第三方报道指出,顶级
qwen3.5-omni-plus档位在部分音频理解基准上可匹敌甚至超过 Gemini 3.1 Pro。但单项基准只能作为初步判断,最终仍应在自己的音频数据上测试。 - 生态。 目前 OpenAI 和 Google 在工具、SDK 与社区示例方面更加成熟。Qwen 的文档质量不错,但开发中会更依赖底层 WebSocket/WebRTC 规范。
实际选择很简单:如果成本或自托管能力很重要,Qwen 是最有竞争力的选项;如果更看重成熟的 SDK 体验,并愿意为此付费,OpenAI 和 Google 目前仍在产品打磨上领先。关于封闭方案的完整成本拆解,可参考文末的相关阅读。
不同需求该选哪个模型
| 你的场景 | 推荐选择 |
|---|---|
| 成本最低的托管式完整语音对话 | qwen3-omni-flash-realtime |
| 追求最佳托管质量、更长会话和声音克隆 | qwen3.5-omni-plus-realtime |
| 只需要语音转写 | qwen3-asr-flash |
| 只需要文本转语音 | Qwen-TTS-Realtime |
| 数据必须保留在自有硬件上 | 自托管开放权重 Qwen3-Omni(30B-A3B) |
3.5 档位增加了声音克隆能力,并提供更长的上下文与对话限制:最多 100 轮对话、保留 600 秒音频;精简的 qwen3-omni-flash 则为 8 轮。如果还在做原型,先从 Flash 开始;只有明确碰到具体限制时,再升级到 Plus。
接入方式:托管 API 与自托管
直接使用托管服务。 先在 阿里云 Model Studio 创建 API Key,然后通过 Bearer 鉴权建立 WebSocket 连接;浏览器应用也可以通过 SDP POST 协商 WebRTC。客户端向上流式发送 PCM 音频,向下接收 PCM 音频和文本。若不想自行管理 Socket,可以使用封装 Realtime 接口的 DashScope Python SDK。以下是最基础的连接示例,省略了错误处理:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. 配置会话:音色、输出格式与服务端轮次检测
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. 将麦克风音频以 base64 PCM 16 kHz 帧流式上传
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. 读取返回事件;response.audio.delta 携带可播放的 PCM 24 kHz 数据
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
使用服务端 VAD 时,模型会自行判断用户何时说完;如果希望自己控制轮次边界,可以切换为手动模式。事件流的结构与 OpenAI Realtime 很接近,因此已有的 Realtime 客户端通常只需少量修改即可迁移。正式上线前,请对照 Realtime 文档核实具体字段名、音色列表和区域端点地址;新加坡与美国部署存在差异,API 本身也会持续演进。
自托管。 开放权重版 Qwen3-Omni 采用 Thinker–Talker Mixture-of-Experts 架构,总参数量 30B,激活参数约 3B。阿里巴巴建议优先用 vLLM 部署,而非直接使用 Transformers。根据第三方部署指南,完整 30B 模型进行 BF16 推理的最低配置是一张80GB 显存卡(A100 或 H100);RTX 4090 这类 24 GB 显存卡无法容纳完整权重,不过量化版本可降低硬件门槛。
但实时服务比批量推理更难做。自托管用户反馈,在并发负载下需要限制 KV Cache,才能避免服务卡顿;单卡 Token 吞吐也落后于托管 API。不过,针对流式场景优化的服务栈可以缩小这项差距:参与 Red Hat AI 和 vLLM 开发的工程师报告称,通过让流水线阶段重叠执行,生成一段 3 秒语音的耗时可从约 8 秒降至约 0.5 秒。这是实打实的提升,但也意味着额外的工程投入。自托管免除了按 Token 计费,却增加了 GPU 与运维成本,更适合高且稳定的业务量,而不是原型验证。
目前要实现实时全模态语音,DashScope 端点仍是标准路径。如果技术栈已经通过统一网关接入多个供应商,也可以在前面增加聚合器;但应先确认其目录包含具体的 Qwen 实时模型 ID,因为不少中转服务只支持文本和图像模型,并未接入实时音频档位。
接入前需要知道的限制
- 会话最长 120 分钟。 客服热线、长时间辅导等更长场景,需要实现重连逻辑,并在不同 Socket 之间传递上下文。
- 区域会影响免费额度与可用性。 应在最终部署使用的端点上测试,而不是只测最初注册时选用的端点。
- 托管版与开放权重版并不完全相同。 托管 API 标称支持识别 113 种语言、生成 36 种语言;开放权重的 Qwen3-Omni 版本覆盖范围更窄,仅支持 19 种语音输入语言和 10 种语音输出语言。如果某一种语言是硬性需求,务必在计划上线的确切版本上验证。
- 实时服务的成本取决于说话时长,而不是请求次数。 音频 Token 密度较高,话多的用户成本高于简短回答的用户。建模账单时,应按对话分钟数而非调用次数估算。
常见问题
Qwen 3 支持音频吗?
支持。Qwen3-Omni 模型原生支持多模态输入,可接收音频、文本、图像和视频,并以实时文本或语音作答。
Qwen 能生成音频,还是只能理解音频?
可以生成。早期 Qwen-Audio 只能输出文本,而 omni Realtime 模型和 Qwen-TTS-Realtime 都能生成语音;3.5 档位还支持克隆音色。
Qwen 实时音频免费吗?
有免费试用额度。历史上,国际(新加坡)端点曾提供 90 天内 100 万输入 Token 和 100 万输出 Token;超出后按 Token 付费。完全开放权重的 Qwen3-Omni 如果使用自己的 GPU 运行,则模型本身免费。
如何在本地运行 Qwen 音频模型?
下载开放权重 Qwen3-Omni(30B-A3B),并用 vLLM 部署。完整模型以 BF16 运行大约需要一张 80GB 显存卡(A100 或 H100);较小的消费级 GPU 只能运行量化版本,无法承载完整权重。
相关阅读
一手资料:
其他方案的价格参考: