 AIREITER
有位 Claude Code 使用者把一個月的 Max 方案用量,按照 API 官方定價換算後,得到 7,470 美元;但他實際支付的方案費只有 200 美元。問題不在於每個 Token 的價格特別離譜,而是訂閱制原本替你設下了一道看不見的用量上限。改成按量計費後,上限消失了;而 Agent 工作負載反覆傳送的 Token,也遠比人類在聊天視窗裡逐句輸入多得多。
為什麼開發者會看到這麼大的價差
網路上分享的比例雖然不是正式審計結果,但數字大致呈現相同方向。一篇整理 Claude Code 工作階段紀錄的 r/ClaudeAI 討論串指出,一個月的 Max 用量若按照 API 官方價格計算,約為 7,470 美元,相較之下訂閱費是 200 美元。另一篇規模較小的訂閱方案與 API 比較討論則估算,200 美元方案所涵蓋的同等工作量,換成 API 每月可能要花 5,000–20,000 美元。
這些都是使用者自行估算的數字,但兩者都指向同一種最吃 Token 的模式:Agent 不斷在程式碼儲存庫裡迴圈工作。
「我公司使用的是企業版 API,平常透過 Claude Code 工作。親身經驗是,在較大型的專案裡正常寫程式,一個工作階段很容易就燒掉 100–200 美元的 API 費用。」— u/andywidjaja,r/ClaudeAI
付費方案和 API 金鑰,本來就是兩種產品
Anthropic 在說明文件裡講得很直接。其於 2026 年 3 月 16 日更新的說明中心文章,將 Claude 方案與 Claude Console 稱為「為不同目的而設計的獨立產品」,並明確表示付費訂閱「不包含 Claude API 或 Console 的使用權」。OpenAI 也是同樣的拆分方式,ChatGPT 與 API 平台採用兩套獨立的計費系統。
理解兩邊究竟賣的是什麼,會比直接比較月費更有幫助:
| 付費聊天方案 | API 金鑰 | |
|---|---|---|
| 販售單位 | 一個人類使用者席位 | Token 流量 |
| 上限 | 滾動 5 小時時段,加上每週限制 | 不含套餐配額;仍受速率與支出上限約束 |
| 使用方式 | 網頁、桌面與行動 App | 由你自己的程式碼呼叫 |
| 價格形式 | 固定月費 | 按 Token 浮動計費 |
| 用來驅動自己的產品 | 不是它的銷售定位 | 這正是 API 的用途 |
Claude 價格頁面列出的 Pro 方案為每月 20 美元,年繳則為每月 17 美元(一次支付 200 美元);Max 則從每月 100 美元起,分為 Pro 用量 5 倍或 20 倍兩種,每個 5 小時工作階段計算。Anthropic 沒有為這些級別公布訊息數量,因為實際消耗會隨對話長度、模型與功能而變化。換句話說,這裡比較的是一個可量測的數字,對上一個沒有明確量化的數字。
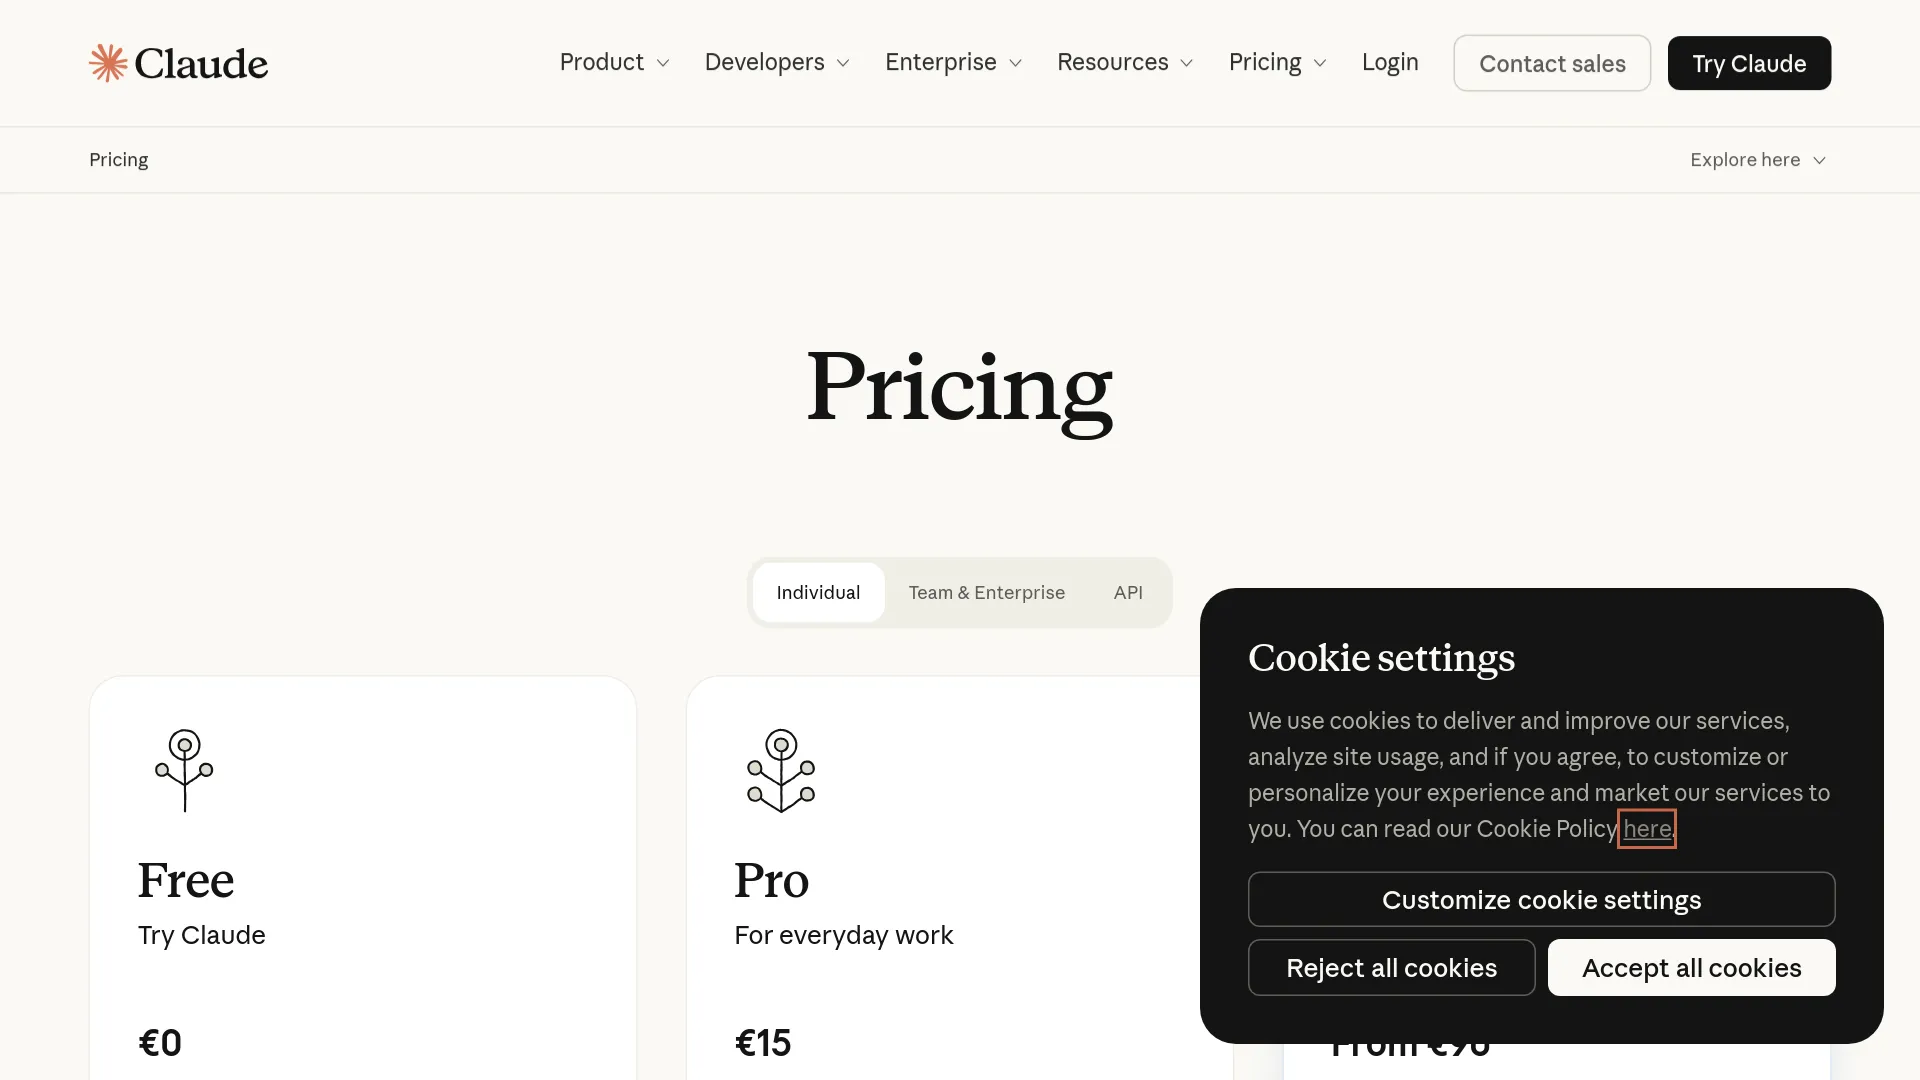
同一頁還透露了另一個關鍵細節:Claude Enterprise 每席每月收取 20 美元,但用量仍按照 API 價格計費。對高用量客戶來說,最後還是會回到按量計費的模式。
把訂閱費換算成官方價格,能買到多少 Token?
把方案費換算成 Token,價差就會變得非常具體。以下是來自 Claude 平台價格文件與 OpenAI API 價格頁面的官方每百萬 Token(MTok)價格,資料確認於 2026 年 10 月 1 日。
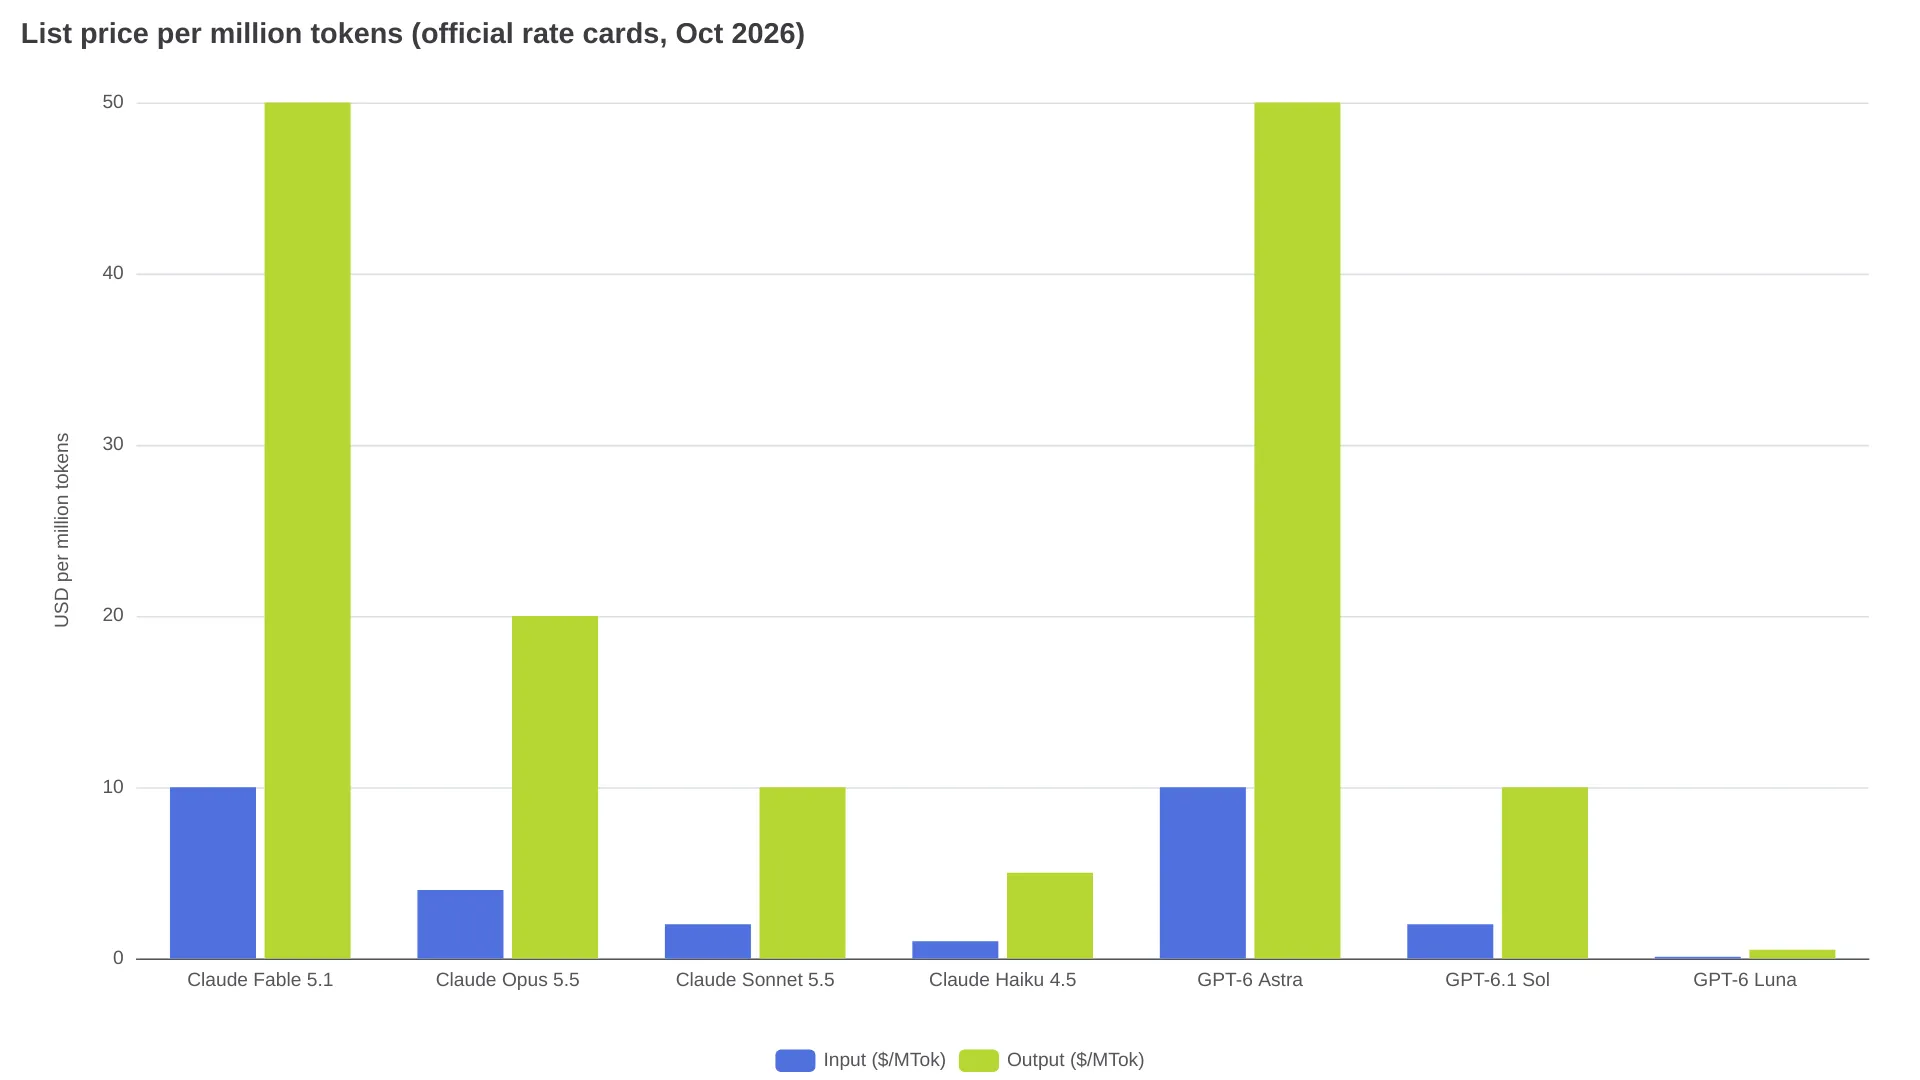
| 模型 | 輸入 | 輸出 | 快取讀取 | 批次(輸入/輸出) |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 | $5 / $25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $2 / $10 |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 | $1 / $5 |
| Claude Haiku 4.5 | $1 | $5 | $0.10 | $0.50 / $2.50 |
| GPT-6 Astra | $10 | $50 | $1.00 | $5 / $25 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $1 / $5 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.05 / $0.25 |
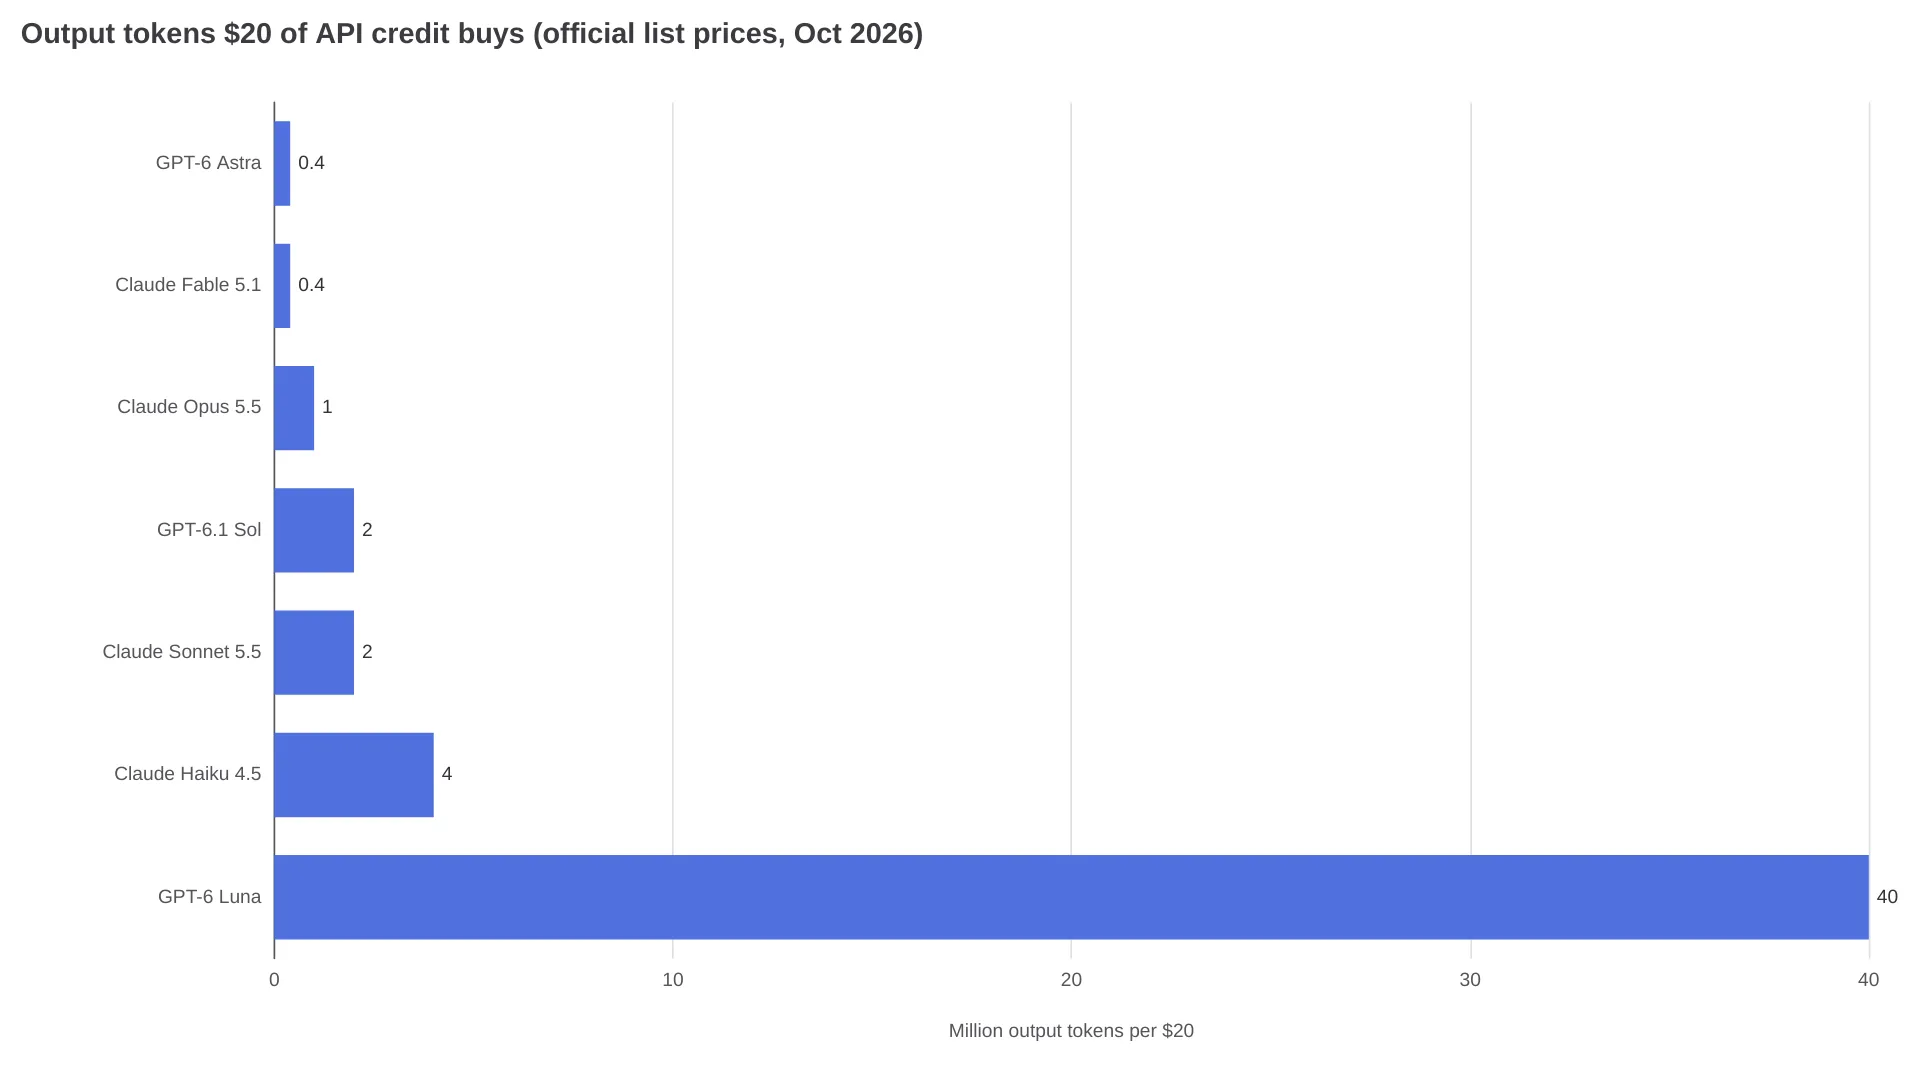
以聊天為主的工作負載來看,若每次帶入幾千字的上下文,再產生幾百字回覆,20 美元的 Sonnet 5.5 額度大約可支付 1,000 萬個輸入 Token,或 200 萬個輸出 Token。要算出你自己的實際成本,只要抓 API 回應裡的四個欄位:(新輸入 × 輸入價格) + (快取輸入 × 快取讀取價格) + (快取寫入 × 寫入價格) + (輸出 × 輸出價格),再加上批次、長上下文與區域等乘數。連續記錄每個端點一週的這四項數據,就能推算每月成本,拿來和一個使用者席位比較。
Token 到底花在哪裡?
價目表之外,還有四個常見來源會讓 Token 支出悄悄膨脹。後三項都有整理在 LLM Cost Lab 對價目表外成本的分析中。
- 每一輪都重新傳送的對話紀錄。在以請求為基礎的聊天整合裡,客戶端會重新傳送歷史訊息,因此第 20 輪請求會把第 1 到第 19 輪一起帶上。如果每一輪增加的上下文量大致相同,輸入量會隨對話長度近似平方成長。這也是該分析估算 20 輪工作階段成本為 0.163 美元的原因;若拆成彼此獨立的請求,原本預算是 0.063 美元,兩者相差 2.6 倍。
- 每次呼叫都會重複計算的系統提示。每個請求都帶上 2,000 個 Token 的系統提示,累積 100 萬次請求後,即使使用者什麼都還沒輸入,也已經產生 20 億個輸入 Token。
- 你看不到的推理 Token。對於會把隱藏思考過程按輸出計費的模型來說,這些 Token 可能比可見答案長好幾倍。若只根據回傳文字的字元數估算,就會低估實際帳單。
- 工具結果、重試與最後丟棄的生成內容。只要模型產生了內容,你就要付費,包括被 JSON 驗證器拒絕的回應,以及為了競速而平行發出的請求,即使最後把其中一個丟掉也一樣。
便宜的 Token 也可能成為帳單主力,這正是很多人查看用量儀表板時最困惑的地方。在那筆 7,470 美元的討論串裡,有留言者發現快取讀取佔了總量的 48%,儘管它是價目表上最便宜的 Token 類型。
「這已經是 API 上最便宜的 Token 類型了;套用官方價格後它仍然佔最大宗,代表實際工作負載主要是在每一輪重新讀取上下文。」— u/YoanEdwin,r/ClaudeAI
把 Opus 5.5 的價格套用到每一輪都帶著 150k Token 儲存庫上下文的 Agent 工作階段,成本結構就清楚了:
| Opus 5.5,60 輪工作階段,每輪 150k 上下文 + 2k 輸出 | 成本 |
|---|---|
| 每輪全新輸入,沒有快取命中(150k @ $4) | $0.60 |
| 每輪改用快取讀取,而非全新輸入(150k @ $0.20) | $0.03 |
| 每輪輸出(2k @ $20) | $0.04 |
| 每個工作階段寫入一次、快取 1 小時(150k @ $8) | $1.20 |
| 未使用快取的工作階段總計 | $38.40 |
| 使用快取的工作階段總計 | $5.40 |
每天兩個使用快取的工作階段,連續 22 個工作日,費用約為 238 美元,已經超過 200 美元方案。同樣的工作量若完全不使用快取,一個月則會超過 1,600 美元。價格沒有變,變的是 Token 數量。
其實不是二選一,而是三個價位層級
多數比較只談方案和 API,但第三種選項也存在,而且通常要等方案配額用完後才會遇到:直接在訂閱產品裡購買額外用量額度。
r/codex 上的使用者回報顯示,這個層級甚至可能比直接使用 API 更貴。一名 Pro 使用者追蹤到,透過購買額度消耗約 16M Token,成本約 40 美元;他估算相同用量若按 API 官方價格計算,約為 12 美元。
「這種額度價格幾乎可以說是掠奪性的。單一登陸頁收 50 美元太誇張了,因為用 API 算起來大概只要 2 美元。」— u/AbjectBug5885,r/codex
這些都是使用者估算,不代表所有供應商都採用相同價格;加購額度的費率也會隨供應商和方案不同。在上述 Codex 案例裡,加購額度的價格約是等量 API 官方費用的 3 倍。下次連續購買額度前,值得先拿自己的數字核算一次。
真正能改變帳單的五個槓桿
每一個槓桿都有官方費率可查,因此都能先對照供應商頁面,再自行驗算。
- 使用提示快取,但別忘了計入寫入成本。Anthropic 的價格文件指出,5 分鐘快取寫入費用是基本輸入價格的 1.25 倍,1 小時寫入則是 2 倍;讀取費用為基本價格的 0.1 倍(Opus 5.5 為 0.05 倍,Fable 5.1 為 0.025 倍)。5 分鐘寫入只要成功讀取一次就能回本,1 小時寫入則要讀取兩次。若寫入後從未讀取,反而會比完全不使用快取更貴。快取不只是開或不開的問題,內容排列也同樣重要:穩定內容要放前面,使用者變動內容放最後,否則前綴就無法匹配。關於命中率除錯,可參考這篇提示快取指南。
- 能延後的工作就使用批次處理。兩家供應商都針對非同步處理提供 50% 的官方價格折扣:Opus 5.5 降至 $2/$10,Sonnet 5.5 降至 $1/$5。但其他模型的支援情況並不一致:LLM Cost Lab 追蹤的 83 個模型中,只有 26 個提供折扣批次層級,因此在以此設計架構前,先確認你的模型是否支援。具體機制可參考我們的批次 API 價格解析。
- 讓模型能力與任務難度匹配。分類、路由與檢索決策通常不需要前沿模型。Haiku 4.5 的 $1/$5,相較 Fable 5.1 的 $10/$50,在只輸出十個 Token 的步驟上,價格差距就是 10 倍。
- 限制輸出內容,而不只是設定
max_tokens。上方表格幾乎每一列的輸出價格都是輸入的 5 倍。透過禁止前置說明的 Schema,可以用少量結構開銷,換掉原本會被計費的冗長文字;至於max_tokens,更適合當作安全上限,而不是排版工具,因為被截斷的答案可能迫使你再次付費請求。 - 留意疊加在價格上的各種乘數。OpenAI 的長上下文層級會讓短上下文輸入價格翻倍,Fast 模式又會在標準價格上再翻倍。Anthropic 對美國固定區域推理收取 1.1 倍費用,而其價格文件指出,Claude 4.7 及後續版本採用較新的 Tokenizer,處理相同文字時產生的 Token 約多 30%。你的提示沒有改變,改變的是計費方式。
還有一個不在上述清單裡的架構選項:讓程式流量都經過單一按量計費的端點,而不是每家供應商各自建立一套計費關係。這正是 AIReiter 的 Claude API 端點所要解決的問題。按照官方價格計算,若一個月有 40M 個 Sonnet 級輸入 Token,以及 8M 個輸出 Token,超額用量成本為 $80 + $80;拿它和第二個席位比較,大約一分鐘就能算完。
你該買哪一種?
| 你的情境 | 建議購買 | 理由 |
|---|---|---|
| 聊天、研究,以及偶爾在 App 裡寫程式 | 只買付費方案 | 支出有上限,包含相關 App,且用量遠低於方案限制 |
| 個人使用 Agent 寫程式,只有一台機器 | 先買方案,再用按量計費的金鑰處理超額用量 | 大部分工作由方案吸收,API 金鑰則能避免等待每週重置 |
| 推出給其他人使用的產品 | 只用 API | 一個席位只涵蓋一名人類使用者;你的使用者需要各自的流量 |
| 週期性批次工作:評測、回填、分類 | 使用支援批次層級的 API | 官方價格折扣 50%,延遲不重要 |
| 大多數週都在購買加購額度 | 把超額用量拿來和 API 金鑰比較價格 | 使用者回報的額度價格高於 API 官方價格 |
常見問題
付費 ChatGPT 或 Claude 方案包含 API 額度嗎?
不包含。Anthropic 說明中心明確表示,付費 Claude 方案「不包含 Claude API 或 Console 的使用權」;OpenAI 也透過獨立系統為 ChatGPT 與 API 平台計費。兩邊都付費,就代表帳單上會出現兩個項目。
我看不到的推理 Token 也要付費嗎?
如果使用的模型提供思考或延伸推理功能,就要付費。這些 Token 按輸出價格計費,但不會出現在回應本文中,因此要查看 usage 物件。
每一輪都要支付整段對話的費用嗎?
是,除非重複的前綴命中快取。若沒有伺服器端狀態功能,客戶端就必須重新傳送希望模型看見的歷史內容;這些歷史內容會按照模型價格以全新輸入計費,若前綴匹配,則按照快取讀取價格計費。
失敗或重試的請求也會收費嗎?
根據 LLM Cost Lab 的計費分析,只要請求已送達模型並完成回傳,即使應用程式因 Schema 驗證失敗或客戶端逾時而丟棄結果,仍然會被計費。唯一的例外,是在模型開始生成前就被拒絕的請求。
這個取捨目前沒有人真正解決
方案能限制支出,卻會限制使用權;按量計費的 API 金鑰則正好相反。由於方案配額沒有公布對應的 Token 數量,要回答「哪一種對我比較便宜」,最可靠的方法仍然是先記錄一週自己的實際流量,再按照上方表格計價比較。
延伸閱讀: 2026 年最便宜的 LLM API · Claude API 價格指南