 AIREITER
OpenRouter 推出儀表板時曾公布,全平台快取命中率達 82.8%(@OpenRouter)。但社群使用者看到的卻是另一番景象:命中率不到 1%(@miolini),或帳單比預期高出 10–32 倍(r/openrouter)。OpenRouter prompt caching 確實能降低輸入成本,但前提是先排除四種典型失敗模式;其中影響最大的,是讓連續請求持續落在同一個已暖機的供應商。還有一道不可突破的門檻:prompt 低於供應商規定的最低 token 數,無論怎麼設定都不會進入快取。
OpenRouter 怎樣才算 prompt cache 命中?
Prompt caching 會重用供應商先前已處理過的穩定 prompt 前綴,讓重複出現的輸入 token 以折扣價計費,而不是照原價計算。快取存在實際處理首個請求的特定供應商端點上,因此路由行為和 prompt 結構一樣關鍵。這和回應快取是不同層次的機制:後者會在請求被路由前,直接免費重播一個完全相同的完整請求。
| Prompt caching | Response caching | |
|---|---|---|
| 重用的內容 | 任何請求中的穩定前綴 | 位元組完全一致的請求(正規化 body 的 SHA-256) |
| 啟用方式 | 多半自動啟用;Anthropic、Qwen、Gemini 可用 cache_control | X-OpenRouter-Cache: true header 或 preset |
| 費用 | 快取 token 按輸入價格的 0.1–0.5x 計費 | 命中免費,未命中照一般費率計費 |
| 存活時間 | 通常 3–5 分鐘,Anthropic 最長可達 1 小時 | 預設 300 秒,可設 1–86,400 秒 |
| 失效原因 | 前綴變動、切換供應商、未達 token 下限 | 任何 JSON 變動、API key 輪替、帳戶 ZDR |
Response caching 特別適合重試、單元測試,以及 agent 工作流中重複發出的相同呼叫。不過 JSON 屬性順序也是快取鍵的一部分,光是無害的序列化變動就足以造成 miss。至於供應商端快取的運作細節,仍應以 OpenRouter 的 prompt caching 指南為準:
各家供應商的 OpenRouter prompt caching 怎麼收費
所有供應商的快取讀取費用都低於一般輸入費率,但建立快取的首次寫入可能另有溢價。Anthropic 預設 5 分鐘 TTL 的寫入費率是一般輸入的 1.25x,1 小時選項則是 2x。只有當相同前綴被重複讀取足夠次數、足以攤提寫入成本時,快取才划算;對一次性請求來說,啟用快取反而可能更貴。以 Claude Sonnet 4.6 為例,根據 OpenRouter 提供的試算數字,快取輸入每百萬 token 為 $0.30,未快取則是 $3.00。
以下是同一來源整理的各供應商快取寫入與讀取倍率:
| 供應商 | 快取寫入 | 快取讀取 | 備註 |
|---|---|---|---|
| Anthropic | 1.25x(5 分鐘)/2x(1 小時) | 0.1x | 每個 breakpoint 均可選 TTL |
| OpenAI,GPT-5.6 之前 | 免費 | 0.25–0.5x | 從 1,024 tokens 起自動啟用 |
| OpenAI GPT-5.6+ | 1.25x | 0.25–0.5x | 現已支援明確 breakpoint |
| Google Gemini | 免費 | 0.25x | 2.5+ 隱式快取,TTL 約 3–5 分鐘 |
| Grok | 免費 | 0.25x | 自動啟用 |
| Moonshot | 免費 | 0.25x | 自動啟用 |
| Groq | 免費 | 0.5x | 僅限 Kimi K2 models |
| DeepSeek | 1.0x | 0.1x | 寫入按一般輸入費率計費 |
| Alibaba Qwen | 1.25x | 0.1x | 必須明確設定 cache_control |
| Z.AI | 免費 | ~0.2x | 快取儲存標示為限時免費 |
OpenRouter 的教學以六輪對話、每輪 10,000 個重複 token 為例:未快取時成本相當於單輪的 6.0x;使用 Anthropic 5 分鐘快取並搭配 sticky routing,降為 1.75x;採用寫入免費、讀取 0.25x 的供應商則為 2.25x。這項模型沒有計入持續增長的訊息與輸出 token。
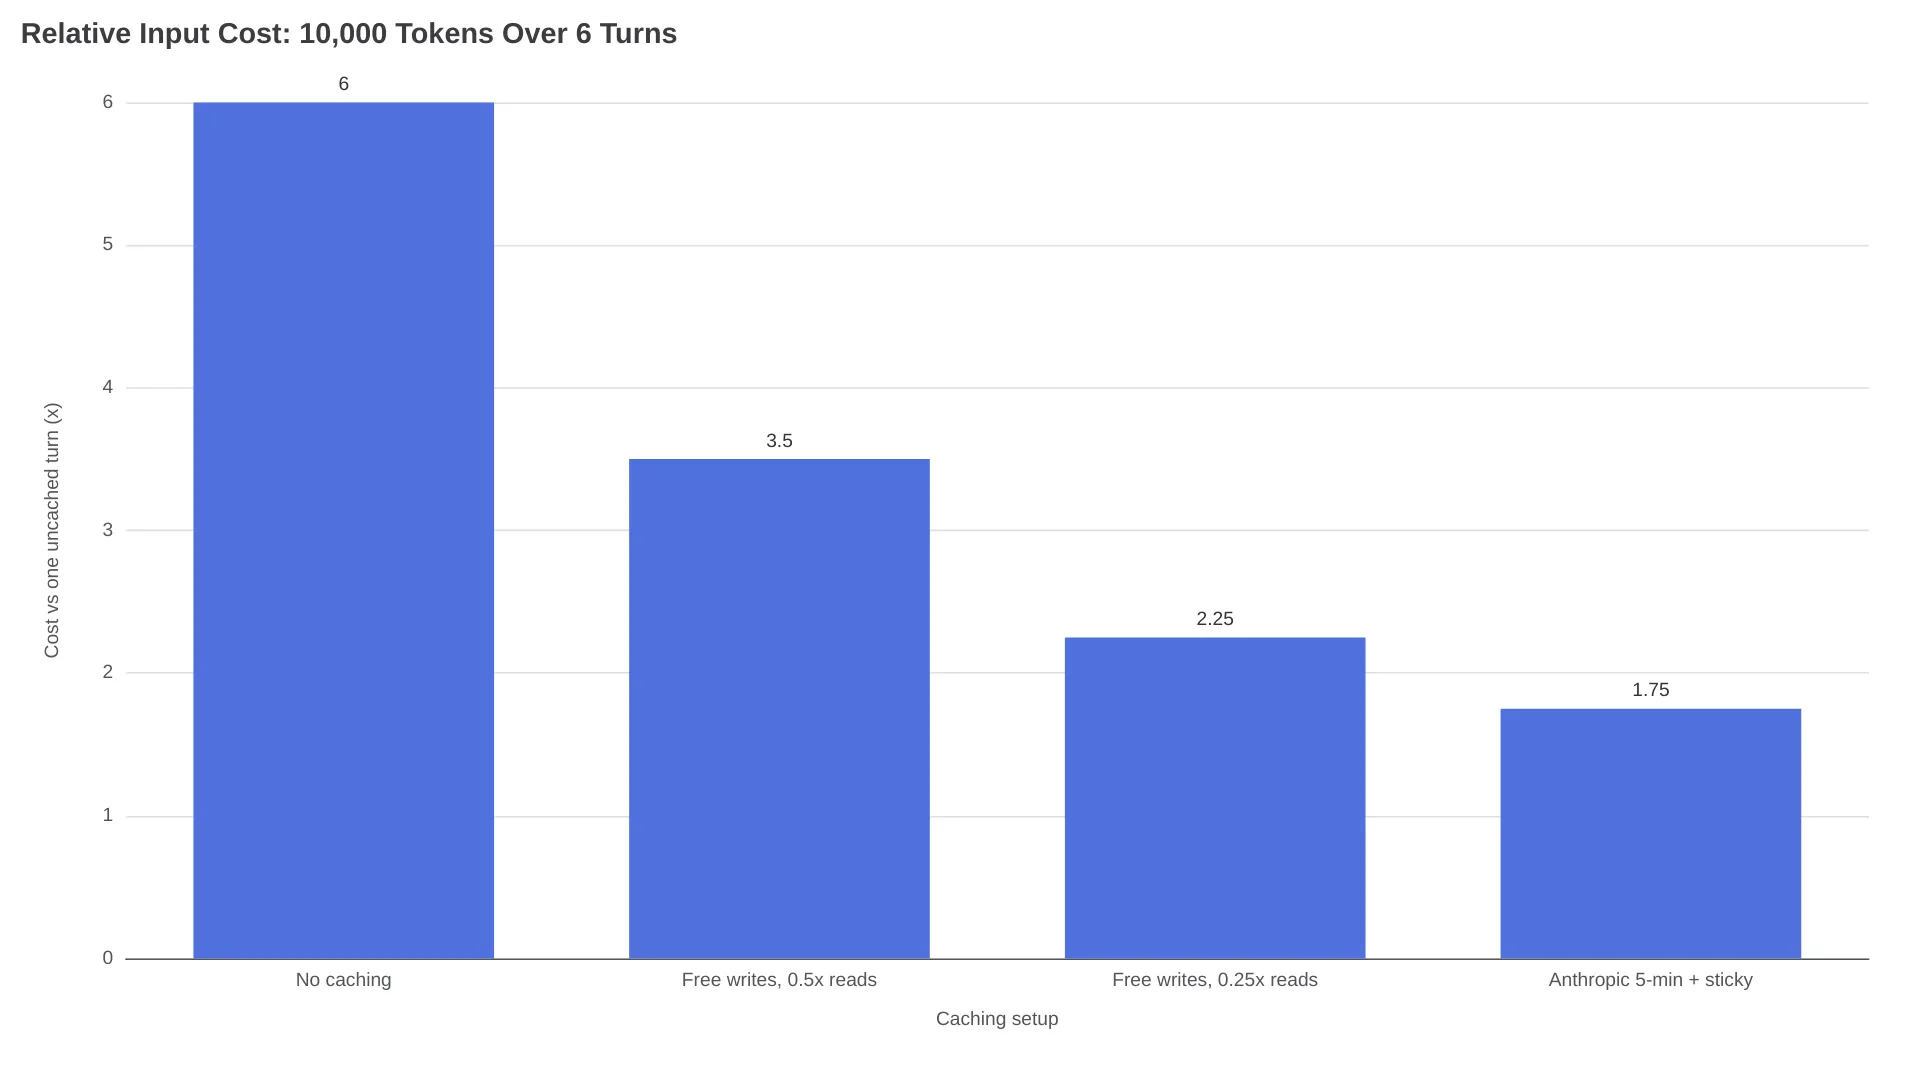
Anthropic 的首次寫入雖然昂貴,但從第二輪開始,0.1x 的讀取費率便占據優勢;對話輪數越多,差距越大。唯一會翻盤的情況,是每輪之間超過 5 分鐘 TTL:你會在每次請求都重新支付 1.25x 寫入費,六輪累積成 7.5x,比完全不用快取還差。相對地,寫入免費且輸入為 1.0x 的供應商,六輪也只是與未快取的 6.0x 持平。
先量測再除錯:三個數字確認是否真的命中
每一筆 OpenRouter 回應的 usage 物件都會給出答案,重點是 cached_tokens、cache_write_tokens 與 cache_discount;欄位意義可參考 OpenRouter 的 caching 指南。在改動任何設定前先讀懂這三個數字,才能區分真正的 cache miss 與單純的費率誤解。只要 cached_tokens 大於零,就代表請求命中了暖快取;若是零,不論 Activity 儀表板看起來如何,實際上就是沒命中。
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
這筆回應的命中率是 99.8%:10,339 個 prompt token 中,有 10,318 個來自快取。首次建立快取的請求會出現 cache_write_tokens;cache_discount 則顯示節省的金額。Anthropic 寫入時它甚至可能是負數,因為 1.25x 寫入溢價確實是一筆成本,要靠後續讀取才會回本。你也能在 Activity 的 generation detail 頁面,或透過 /api/v1/generation 取得相同數據;我們的 Activity 儀表板教學說明了該從哪裡查看。
原始 metadata 才是事實依據,不是 UI。一位 SillyTavern 使用者直到直接檢查日誌,才發現自己一直在追查不存在的快取問題:
「原始 OpenRouter metadata 直接寫著
native_tokens_cached: 0,而且usage_cache: null。」— u/HauntingWeakness
如果這三個數字日復一日都是零,通常就是下面四種失敗模式之一正在吃掉你的快取。
暖快取為何會失效:四種常見原因
OpenRouter 文件與社群案例都指向四個快取命中率崩跌的常見原因:prompt 未達最低長度、輪次間 TTL 到期、前綴被改動,以及供應商漂移。每一種都會在日誌中留下不同訊號,修法也各不相同。
1. Prompt 沒達到供應商的最低 token 門檻
支援 prompt caching 的供應商都會依模型設定 token 下限。一段 900-token 的 system prompt 在任何 Claude model 上都不會快取,而且 OpenRouter 教學明確不建議靠填充內容硬湊門檻:「不要只是為了觸發快取而在請求裡塞 filler text。」不同模型系列的最低門檻相差可達四倍:
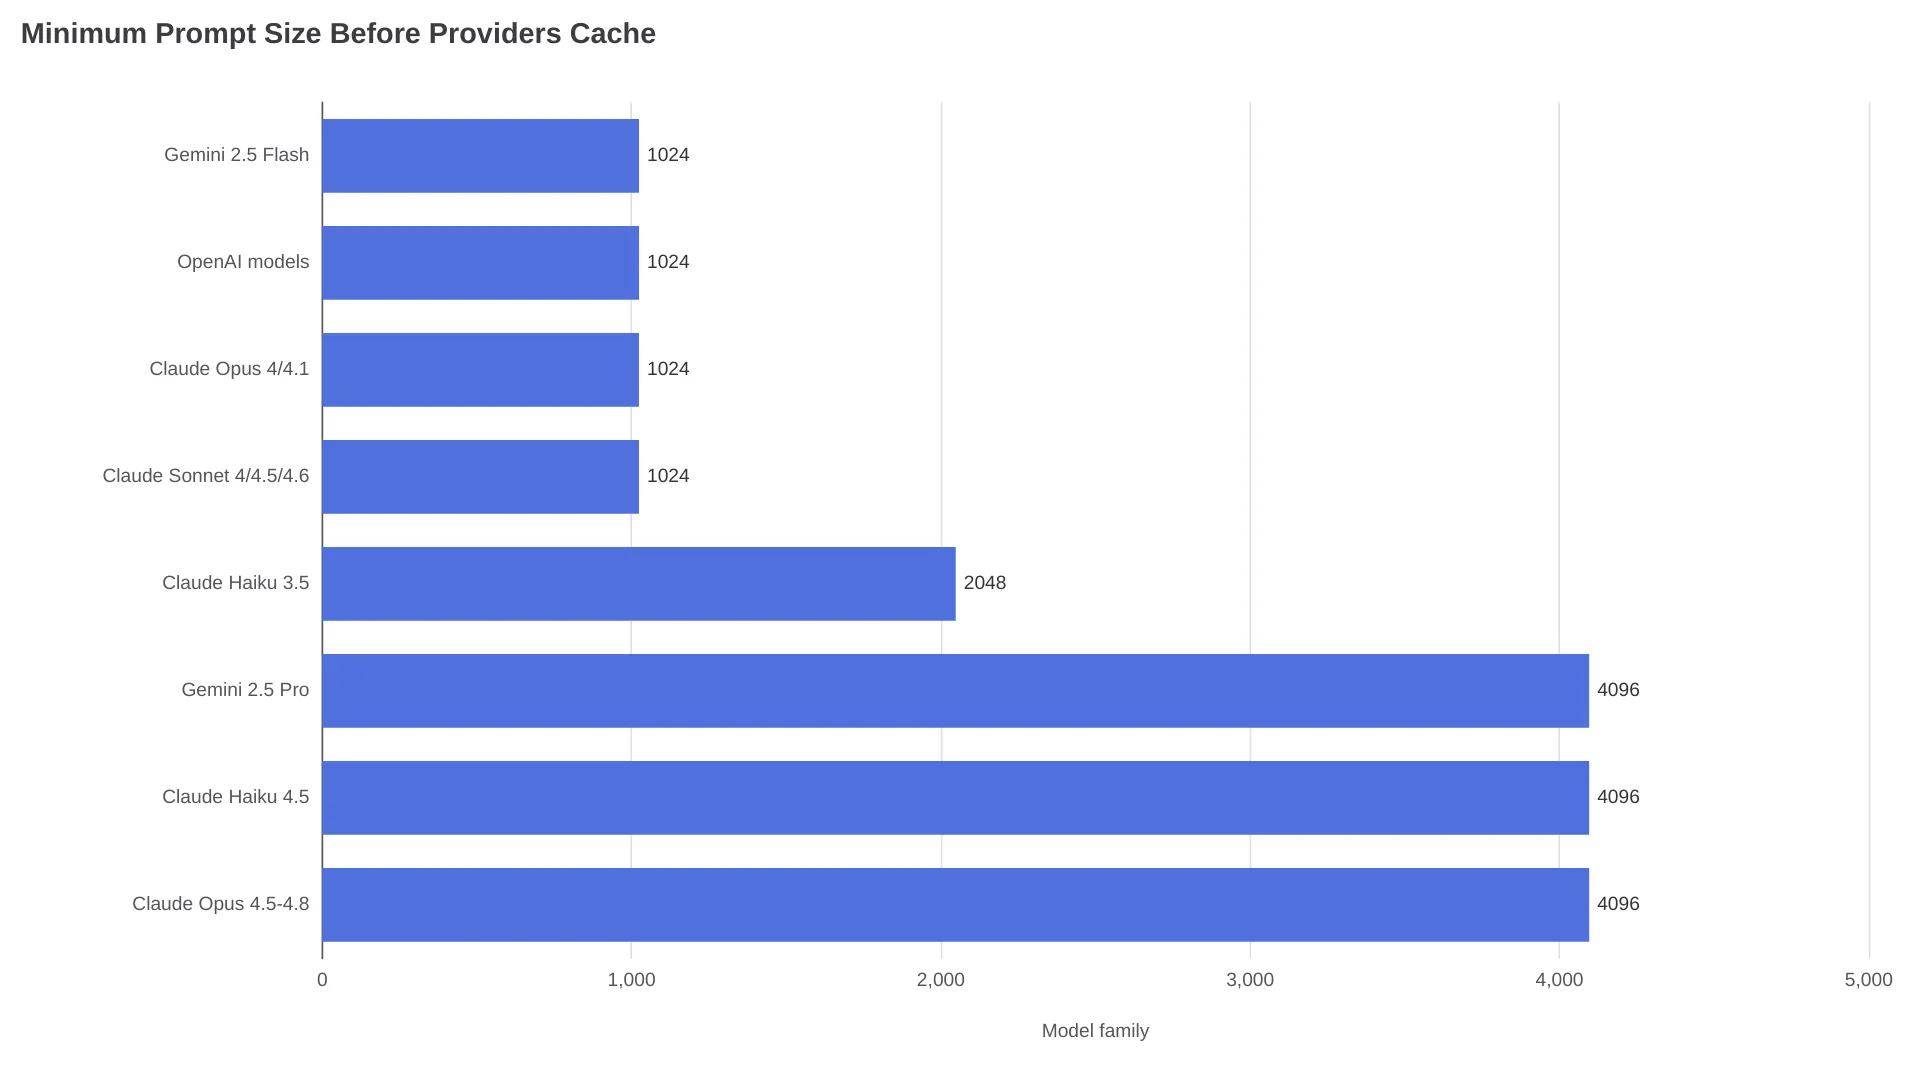
根據 OpenRouter 的供應商說明,Claude Opus 4.5–4.8 與 Haiku 4.5 必須達到 4,096 tokens 才會開始快取;Sonnet 4/4.5/4.6 與 Opus 4/4.1 的門檻是 1,024;Gemini 2.5 Pro 是 4,096,Gemini 2.5 Flash 則是 1,024;OpenAI models 也從 1,024 開始快取。若工作負載的 prompt 很短,卻使用 Opus 4.8,那從結構上就無法快取。可行解法是把靜態內容,例如 tool schemas、參考文件、few-shot 範例,整合成單一前綴;或改用門檻較低的模型。
2. 對話輪次之間快取已過期
Anthropic 預設快取存活 5 分鐘,1 小時 TTL 的寫入費率則是 2x。Gemini 的隱式快取約可維持 3–5 分鐘,且根據 OpenRouter 教學,讀取快取不會重設計時器。讓你留在同一供應商的 sticky session,則會在 10 分鐘無活動後失效。若 agent loop 每次呼叫前都思考 5–6 分鐘,這些時間窗幾乎都會被耗盡:
「OpenRouter 很適合測試模型,但對 production agents 來說其實很糟。骯髒的祕密是:在真實工作負載中,caching 幾乎等於零。」— @ran_cohenn,描述 agent 間隔 5–6 分鐘後,sticky affinity 失效,導致完整 cache miss 與昂貴快取寫入
只要 session 在一小時內持續進行,Anthropic 的 1 小時 TTL、2x 寫入仍優於每五分鐘重付一次 1.25x 寫入費。但若使用者每二十分鐘才互動一次,選單中的所有 TTL 都撐不住,快取只能在密集的一段連續輪次內帶來效益。
3. Prompt 前綴在不知不覺中變了
OpenRouter 預設會以第一則 system message 與第一則非 system message 雜湊出 conversation key。只要 prompt 開頭被修改,從該位置往後的快取就會失效。最常見的兇手包括:把 RAG context 插到 system prompt 前面、在第一則訊息加入時間戳或 request ID、每次呼叫都重寫 tool definitions,以及前端聊天應用程式在歷史訊息中間插入新內容。
「如果 prompt 開頭有內容持續變動,cache miss rate 就會上升。」— u/Exact_Law_6489
有時候,變動來自你沒有自己寫的工具。u/askchris 表示:「我發現 Claude Code 讓我的 cache hit 出問題,我想是它注入 tools 的方式造成的。」Gemini 還有兩個額外陷阱:OpenRouter 只會採用你送出的最後一個 cache_control breakpoint;而 system instruction 會被視為不可變的快取內容。動態資料必須放到後面的 user message,而不是接在 system prompt 後面。無論是哪種情況,原則都相同:先放靜態 system prompt、tool schemas 與參考文件;每次請求才變動的內容一律放最後。
4. 請求被路由到沒有快取的供應商
OpenRouter 會在 70+ 家供應商之間路由(依其官方教學),而 prompt cache 僅存在建立它的端點本機。Sticky routing 會把後續請求送回已有暖快取的供應商,但只有在該供應商的快取讀取費率低於一般輸入費率時才會這樣做;手動設定 provider.order 更會完全覆寫 stickiness。供應商發生錯誤時,pin 也會被解除。
社群數據對這種失敗模式的描述相當鮮明:
- @bruceforai 測量同一模型名稱在不同供應商的表現,快取命中率從 95.3% 一路低至 0%,部分第三方的快取定價更是官方價格的 10 倍。
- @Bryan_1269 經由 OpenRouter 使用 GLM 5.2 時命中率極低,但對相同 prompt 直接使用 Fireworks,命中率超過 85%。
- @miolini 對經 OpenRouter 路由的體驗總結是:「cache hit rate 真的很差,低於 1%。」
OpenRouter 的官方立場是 pin 確實有效:「當某個 model 或 provider 對你建立快取後,你會被 pin 在它上面,直到快取到期」(@OpenRouter)。這和文件內容一致,也表示真正需要管理的問題不是 pinning 本身,而是供應商之間的差異。
cache_control 該放在哪裡?哪些環節會把它移除?
OpenRouter 上的 Anthropic models 有兩種快取模式。一種是在頂層設定單一 cache_control 物件,會隨著對話成長自動往後推進,也是 OpenRouter 對多輪聊天的建議做法;另一種是在個別 content block 上設定明確 breakpoint,最多四個,適合大型固定資料,例如 tool schemas、RAG 文件、CSV dumps 或 character cards。頂層形式可跨 Anthropic native、Vertex、Azure 與 Bedrock 使用;由於 Bedrock API 不接受頂層欄位,OpenRouter 會將它轉為末端 breakpoint。若要明確設定 TTL,必須使用 Chat Completions 或 Anthropic Messages API,不能使用 Responses。
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens 的 tool schemas 與參考文件>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI 的運作方式不同:快取從 1,024 tokens 起自動啟用。只有 GPT-5.6 與更新版本提供明確的 prompt_cache_breakpoint marker,可設在 input_text 或 text block 上;若請求 TTL,最低為 30 分鐘。
依供應商說明,OpenRouter 會在不同格式之間轉換:Anthropic 的 cache_control marker 會變成 OpenAI breakpoint;OpenAI breakpoint 會變成 Anthropic 預設 5 分鐘 marker;TTL 值則永遠不會轉移。Qwen 必須使用明確的 cache_control marker,快取時間為 5 分鐘,而且僅支援特定 models,例如 qwen3-max、qwen-plus、qwen3-coder-plus 等;qwen3.5-plus-02-15 這類 snapshot 不在支援範圍內。
還有一種更隱蔽的失敗模式:你的應用程式與 OpenRouter 中間的某些 client 或 gateway,可能會在轉送前移除非標準欄位:
「anthropic prompt caching 在 gateways 後面掉到零,通常是 marshalling bug。……cache_control markers 在轉送到 openrouter 前被悄悄移除了。你不能一邊丟掉 provider 的 schema extensions,一邊宣稱抽象化 providers。」— @SiddharthInk_
務必確認 marker 有成功送達:可在 Activity generation detail 檢查原始 request metadata,或用 curl 發出一筆中間沒有任何環節干預的測試請求。若工具把 messages 壓平成單一 blob,無論 breakpoint 放得多正確都會失效。OpenRouter 的 examples repo 提供可執行的 TypeScript、Vercel AI SDK 與 Effect 範例,能保留這些 markers。
用 session_id 固定供應商,理解 provider order 的取捨
穩定的 session identity 是最強的路由控制手段。session_id 會從第一筆成功請求開始,把後續請求固定到同一供應商,甚至早於任何 cache hit 被觀察到之前。沒有它時,stickiness 只有在首次偵測到 cache hit 後才會開始;而預設 identity 是第一則 system message 與第一則非 system message 的雜湊,只要前綴有變動,就會被悄悄重算並改變路由,正如OpenRouter 的路由文件所述。
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}有幾項機制值得記住:session_id 可放在 request body 或 x-session-id header;若兩者都有設定,以 body 為準。長度上限是 256 個字元;若兩者都未提供,OpenRouter 會退回使用 OpenAI 風格的 prompt_cache_key。
文件還有兩個注意事項:供應商錯誤會解除 pin;Batch API 的各行會並行且無序執行,因此某一行建立的快取不會立即對下一行可見。請在 batches 間共用 "ttl": "1h" 前綴,或先用一筆同步請求暖機。(Auto Router 指南則介紹了 Auto Router 如何盡力重用已解析的 model。)
如果光靠 pinning 還不夠,可以直接限制供應商集合:
「我找到的解法,是設定一份偏好的 providers 清單,依偏好順序使用。」— u/nabil9506
將 provider.order 設成兩到三家快取讀取便宜的供應商,是以較少的 failover 範圍換取更好的快取在地性;對 agent 工作負載而言,這是合理的取捨。u/welcome_to_milliways 將手動設定的負擔稱為「OR 一個相當根本的缺陷」;是否認同見仁見智,但這就是目前的使用契約。
哪些情況下不該透過 router 做快取?
透過 OpenRouter 使用 prompt caching,在三種情況下通常不再划算:prompt 永遠達不到模型 token 下限、session 間隔長於所有可用 TTL,以及一次性請求無法靠折扣讀取攤提寫入溢價。還有第四種:你無法修改的工具在請求到達 router 前就移除了 cache_control。@grapeot 點出其中的嚴重性:若快取在 gateway 層失效,成本差距可能達到一個數量級,遠大於路由費本身。
如果工作負載極度依賴快取,而上述問題又都無法修正,固定使用單一 upstream 會比 router 更適合:快取行為可預測,也不必管理 pinning。當供應商漂移無法解決時,直接使用具備 Anthropic 原生快取的 Claude API endpoint,就是最直接的替代方案。
帳戶層級的 Zero Data Retention 會完全停用 response caching。至於 ZDR 下的 prompt caching,應參考 OpenRouter 對隱式快取是否構成資料保留的分析。
快取除錯與修復順序
依量測邏輯除錯,通常能以最少改動找回大部分節省效果:先驗證,再從 prompt、路由一路查到 TTL。
| # | 操作 | 能釐清什麼 |
|---|---|---|
| 1 | 檢查幾筆真實請求的 cached_tokens 與 cache_discount | 判斷是命中率問題,還是對計費的預期有誤 |
| 2 | 將 prompt 長度與模型 token 下限比較 | 優先排除「永遠無法快取」的可能性 |
| 3 | 固定前綴:靜態 system prompt、schemas、docs 放前面;時間戳與 RAG 放最後 | 消除悄悄造成失效的一整類問題 |
| 4 | 在同一段對話的每一筆請求都傳入 session_id | 從第一輪起固定供應商,而非等到首次命中後 |
| 5 | 將 provider.order 設為兩到三家快取讀取便宜的供應商 | 排除跨供應商漂移 |
| 6 | 加入 "ttl": "1h"(Anthropic),或為長 session 改用寫入免費的供應商 | 處理輪次之間的快取到期問題 |
步驟 1–3 處理的是你能在程式碼中控制的失敗類型;步驟 4–6 則能解釋並改善「不到 1%」的社群回報與 82.8% 平台數字之間的落差。延伸閱讀:想了解快取 token 如何反映在帳單上,可看 OpenRouter pricing guide;想掌握 model-pinning 行為,可看 auto router guide;若要長期監控命中率,請參考 activity dashboard guide。