Qwen4 Max API 現在已開放隨用隨付,不再只是 Token Plan 預覽版;輸入與輸出價格分別是每 1M tokens $1.50 和 $4.50,context window 則達 1M tokens。若要開始建置,現在應改用 qwen4-max,因為 qwen4-max-preview 將於 2026 年 11 月 25 日退役。
Qwen4-Max API 快速整理:2026 年 11 月 16 日正式上線
Alibaba 於 2026 年 11 月 16 日在 Alibaba Cloud Model Studio 正式推出 Qwen4-Max,模型 ID 為 qwen4-max。它先在 11 月 11 日以僅限 Token Plan 的預覽版亮相,之後才開放正式使用。@Alibaba_Qwen 宣布,這是一款採用全新 MoE 架構、原生支援視覺輸入並提供 1M-token context window 的模型,API 已在 QwenCloud 上線。QwenCloud 文件也同步了 Model Studio 的國際版資訊;請依所在地區使用對應的 Model Studio endpoint(QwenCloud 文件)。
| 項目 | Qwen4-Max(qwen4-max) |
|---|---|
| 狀態 | 2026 年 11 月 16 日起正式版;預覽版 qwen4-max-preview 執行期間為 2026 年 11 月 11 日至 11 月 25 日,之後退役 |
| 輸入/輸出 | 每 1M tokens $1.50/$4.50(新加坡國際區域) |
| 快取讀取 | 每 1M tokens $0.075 |
| 其他區域 | 美國(Virginia)、Frankfurt、Tokyo、Hong Kong 每 1M tokens $1.413/$4.24 |
| Context | 1M tokens;文件列出的最大輸入為 991K tokens |
| 最大輸出 | 關閉 thinking 時 131,072 tokens;開啟 thinking 時,思考加回答共 262,144 tokens |
| 輸入模式 | 文字、圖片、影片 |
| API 形式 | 相容 OpenAI 與 Anthropic;支援工具呼叫、結構化 JSON 輸出、網路搜尋、快取、批次處理、微調 |
| 區域 | Singapore、US(Virginia)、Frankfurt、Tokyo、Hong Kong、Beijing;批次工作僅限 Beijing |
| 試用 | 新的 Singapore 帳戶可在 90 天內獲得 1M 免費 tokens |
以上價格與限制來自 Alibaba Cloud Model Studio 文件,並由相關報導於 2026 年 11 月 16 日整理(價格資訊與 QwenCloud 文件)。以新加坡區域為例,100K input 加上 10K output 的費用約為 $0.15 + $0.045 = $0.195。
從 Qwen3.8-Max 升級,實際改變了什麼?
Qwen 引述 Artificial Analysis 的數據指出,Qwen4-Max 的 Intelligence Index 為 43,比 Qwen3.8-Max(xhigh)高 9 分,比 Kimi K3.1 Pro 低 3 分;平均每項任務成本為 $3.27,約只有 Qwen3.8-Max 的三分之一,輸出 tokens 也少了 39%。
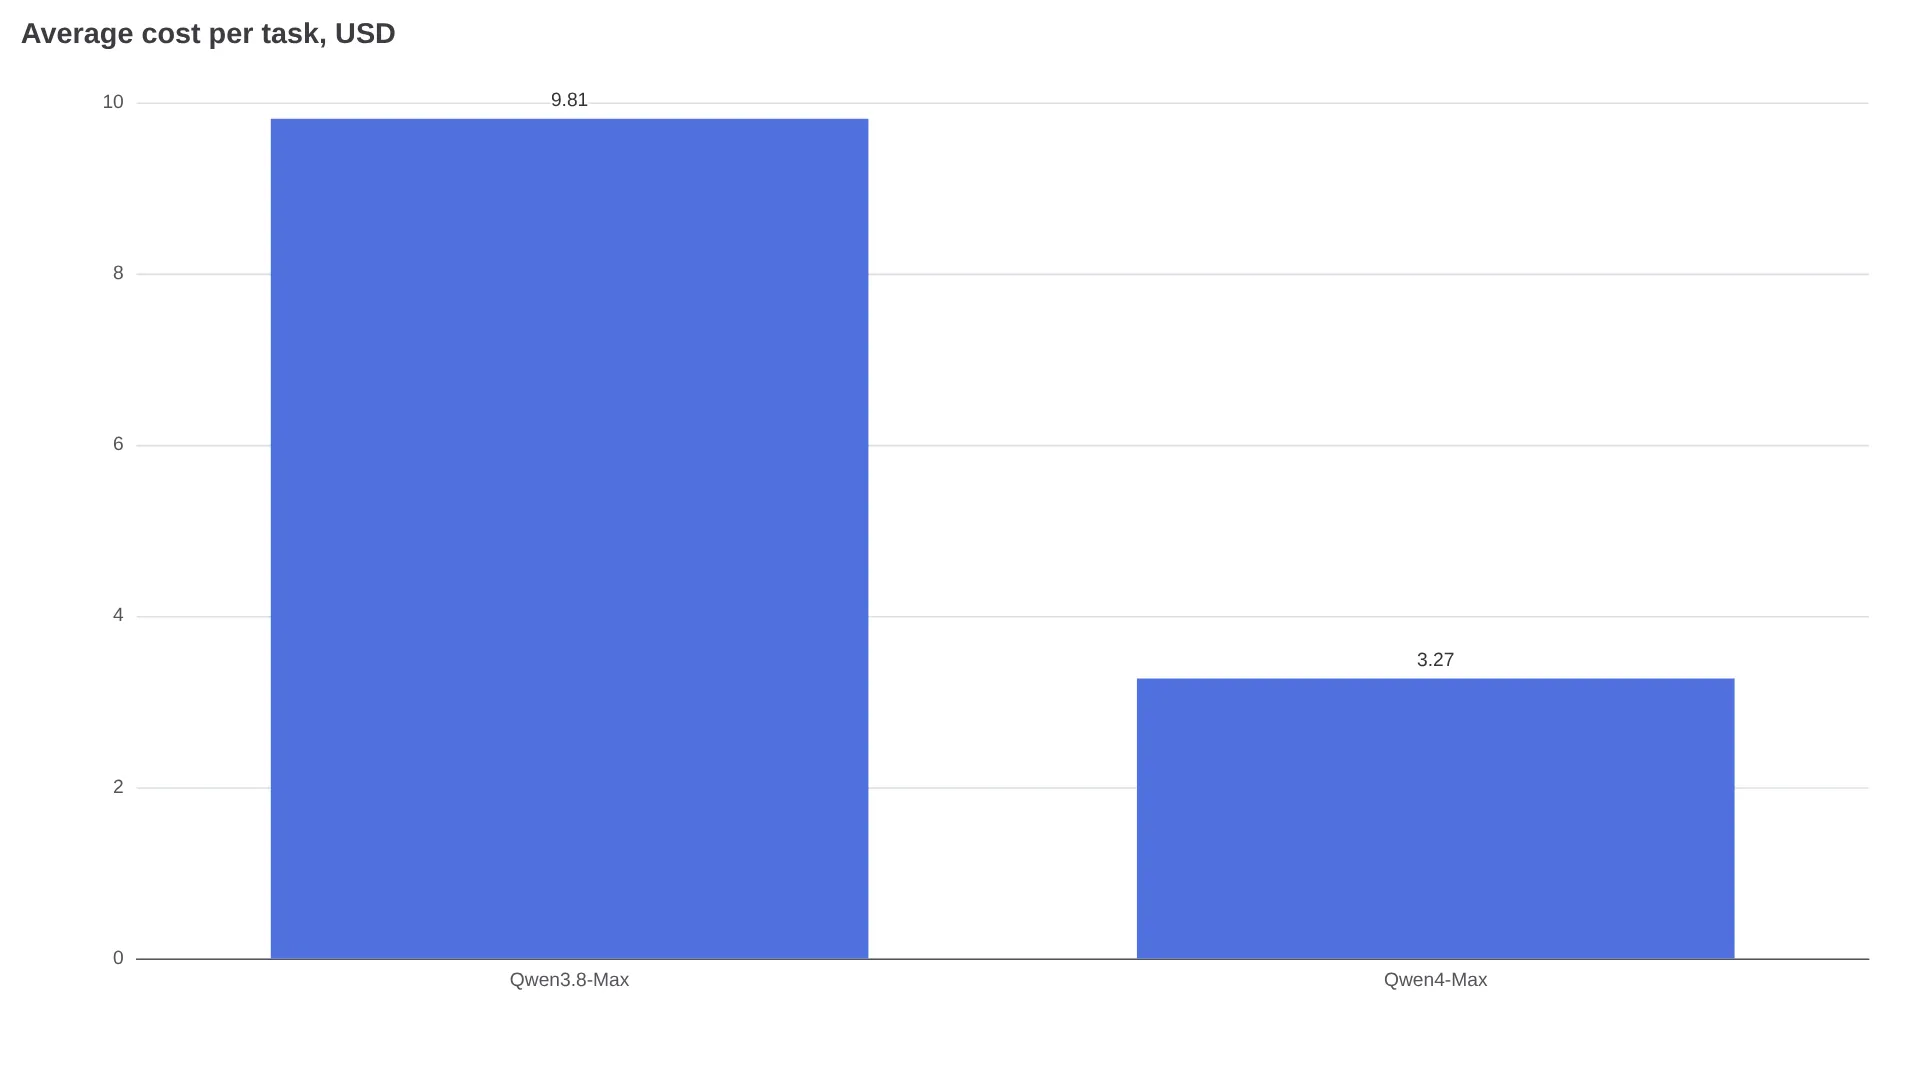
省錢效果來自兩個層面:一是前表所列的 token 單價,二是每項任務需要的 tokens 更少。Qwen 的內部評測顯示,最多可減少約 50%。如果是大量掃描 1M-token context 並重複使用快取,差異會更明顯,因為隱式快取讀取每 1M tokens 僅 $0.075,官方表示比 Qwen3.8-Max 的快取價格低 70%。
架構方面,Qwen4-Max 採用原生視覺 MoE backbone,總參數量 2.4T、啟用參數 71B,另有 328B N-gram embedding。Qwen 部落格雖然引用了 Artificial Analysis 的分數,但 AI First Look 與 AICoder 都指出,截至 11 月 16 日,完整 benchmark 表格與公開的 AA 排行榜資料尚未上線。
前代模型相關內容可參考:Qwen3.8-Max API pricing 與 Qwen3.8-Max vs Kimi K3。
會直接影響帳單的規格與限制
比起「1M context」這個 headline,以下三項限制更值得留意。
Context 不等於可用輸入量。 Context window 雖然是 1M tokens,但 QwenCloud 列出的最大輸入量為 991K tokens。實際應預留安全空間;如果工作高度依賴檢索,也建議測試模型在 context 中段位置的資訊回憶能力。
輸出與 thinking 共用同一個預算。 關閉 thinking 時,最大輸出為 131,072 tokens。開啟 thinking 後,思考內容與回答共用 262,144-token 預算,因此推理越複雜,留給最終答案的空間就越少。根據 XenoSpectrum 的預覽版規格整理,預覽版原本是思考與回答共用 393,216 tokens;因此不要把預覽版限制硬編碼到正式環境。
Thinking 預設值也改了。 Thinking 預設為開啟。正式版預設等級是 high,另有 low 與 xhigh 可選;根據 AI First Look 的規格表,預覽版預設則是 xhigh。如果延遲太高,建議先把 reasoning_effort 調低。
多模態輸入支援文字、圖片與影片。根據 XenoSpectrum 的預覽版規格整理,預覽版影片提交上限為 2 小時、2 GB,以及每次請求 64 部影片;這些是提交限制,不代表模型一定能完整理解內容。長影片仍應使用自己的檔案進行回憶測試。
若要控制成本,可以要求結構化 JSON 輸出,減少模型冗長發揮;長 context 則可透過快取讀取重複使用(新加坡每 1M tokens $0.075)。AICoder 的發布整理 另列出,在支援的區域中,建立五分鐘顯式快取的價格為每 1M tokens $1.875。
用 OpenAI SDK 呼叫 qwen4-max
根據 Alibaba Cloud 模型文件,Model Studio 支援 OpenAI Chat Completions、Responses,以及 Anthropic Messages API 格式。隨用隨付後端請使用 qwen4-max;qwen4-max-preview 僅限 Token Plan。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
API key 與 endpoint 必須對應同一個 Model Studio 區域。支援時可要求 response_format={"type": "json_object"} 或 JSON Schema,並對大型結構化輸出進行驗證。
隨用隨付、Token Plan 與聊天 App,該選哪條路?
| 方案 | 適合用途 | 主要限制 |
|---|---|---|
Model Studio 隨用隨付(qwen4-max) | App、後端、批次工作 | 按 token 計費;請確認區域 endpoint 與 API key |
Token Plan(qwen4-max-preview) | 在 Claude Code、Cline、Cursor、OpenCode 中互動式寫程式 | 僅限互動使用;不可用於正式環境自動化、批次腳本或嵌入後端;僅限 Singapore 區域;於 2026 年 11 月 25 日 24:00 UTC+8 結束 |
| Qwen Chat、QwenWork、QwenStudio、Qoder | 試 prompt、處理文件,以及不必自行串接 API key 的 agentic IDE | 可用性與點數比例以 App 內顯示為準;不等同於 API 合約 |
Token Plan 是提供互動式開發使用的月度點數池。Apidog 的 Token Plan 整理列出個人方案:Lite 為活動價 $3/牌價 $8,含 20,000 credits;Pro 為活動價 $43/牌價 $51,含 200,000 credits,相關 key 以 sb-sp- 開頭。分享 key、執行背景工作,或把 key 嵌入已發布的後端,都違反使用條款。若只是測試 prompt,Apidog 與 XenoSpectrum 都將 Qwen Chat、QwenWork、QwenStudio 與 Qoder 列為評估途徑;實際可用性會在 App 內顯示,並依帳戶而異。
請在 2026 年 11 月 25 日前完成遷移:
- 把模型字串從
qwen4-max-preview改成qwen4-max。 - 從 Token Plan 的 base URL 與 key,改用 Model Studio 的隨用隨付 key 及所在地區 endpoint。
- 重新測試 thinking 預設值(從
xhigh改為high)。 - 重新量測輸出預算(預覽版共用 393K 上限,正式版則為 131K/262K 上限)。
早期使用者回報:從零建置很快,Agent 表現不太穩
AI First Look 蒐集的小樣本測試顯示,Qwen4-Max 能用一個 prompt 完成部分建置;其中一項測試在約 2.5 分鐘內通過 20 個隱藏測試,相較之下 Qwen3.8-Max 需要 17 分鐘。不過同一份整理也提到,在一項遊戲測試中,Qwen4-Max 雖然完成速度更快,整體評價仍排在第二。
Trying to do any code generation 時一直遇到這些錯誤。
— @bijanbowen,貼文(2026 年 11 月 16 日的真實使用者初步體驗;截圖顯示程式碼生成反覆出錯)
一份早期中文測試者整理(@weconomypistis)認為,價格與單項任務成本是最大亮點,但在終端機與 Agent 操作方面仍落後 Kimi 一步,回應速度也較慢。
FAQ
Qwen4-Max 是開放權重模型嗎?
不是。根據 AI First Look 的追蹤資料,截至 11 月 16 日,Qwen4-Max 僅提供託管服務,尚未公布模型權重。Qwen 表示,較小型的 Qwen4 模型之後會開放權重,相關資訊可見 Qwen4-Max 公告;但目前尚未公布日期、模型大小或授權條款。