 AIREITER
兩個決策端點標示的輸入價格都是每 100 萬個 token $0.10,但同一份重複使用的政策文件,實際成本可能一邊是 $520、另一邊只要 $70。OpenAI Decisions API 適合帶有大量重複上下文的代理程式對話紀錄;Gemini Decisions API 則更適合音訊、影片,以及最多 1,000 條規則的檢查清單。
同樣是 $0.10,帳單卻可能差很多
OpenAI Decisions API 和 Gemini Decisions API 的未快取輸入 token 都是每 100 萬個 $0.10,輸出 token 則完全不另行收費。OpenAI Decisions API 於 October 22, 2026 在模型 gpt-6-luna 上正式 GA;Gemini Decisions API 則於 November 11, 2026 以 v1beta 形式、搭配模型 gemini-decision-1 推出。該選哪一家,關鍵不在品牌,而在輸入內容有多常重複,以及你需要處理哪些模態。
| 比較項目 | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| 模型 | gpt-6-luna | gemini-decision-1 |
| 狀態 | 自 Oct 22, 2026 起 GA(OpenAI 文件) | 自 Nov 11, 2026 起以 Preview v1beta 提供(Google 公告) |
| 每次請求的問題數 | 1–400(OpenAI 文件) | 1–1,000(Google 公告) |
| 上下文視窗 | 超過 272K tokens 後採用長上下文 2x 倍率 | 262,144 tokens |
| 輸入格式 | 文字、圖片、input_json、對話與工具呼叫 | 文字、圖片、音訊、影片、PDF |
| 輸出費用 | $0 | $0 |
| 輸入快取 | 每 100 萬個 token $0.01,前綴需 ≥1,024 tokens | 不支援 |
| 免費方案 | 未另列獨立免費方案 | AI Studio 提供,200 RPM / 50K TPM / 10K RPD |
| 已公布延遲 | 約比 Responses API 快 10 倍 | 模型運算 50–100 ms,最多 16K tokens 時端到端 150–250 ms |
| 企業功能 | ZDR、HIPAA、美國/歐盟區域處理(+10%) | Cloud 支援即將推出 |
實際發送請求時,兩者差在哪裡?
OpenAI Decisions API 透過 POST /v1/decisions 發送有順序的問題陣列,每個問題可選填 name。Gemini Decisions API 則使用 client.decisions.create(),以開發者自訂的 ID 作為 key 的 map。兩邊都有三種問題類型,但命名方式和支援範圍並不相同。
依據 OpenAI 指南,OpenAI 的問題類型包括 predicate(機率 0 到 1)、choice(無排序的分類),以及 score(2–10 個有順序的等級,並回傳按機率加權的平均值)。Gemini 則提供 noul(是/否,機率 0.01 到 0.99)、choice(2–255 個選項),以及 score(2–255 個等級,建議使用 2–10),詳見Google 公告。兩邊在同一個請求中的問題彼此獨立;如果要做鏈式邏輯,仍需交給應用程式或再發起第二次呼叫。
移植時最容易踩到的三個坑
Gemini 會先按照字母順序排列 choice 的 key,再進行評分。因此,名為 none_of_the_above 的兜底選項,可能會排在 shipping 前面(這是文件中記載的行為)。OpenAI 會在 answers 陣列中回傳問題的 name;Gemini 則回傳以問題 ID 為 key 的 map。Gemini 的 noul 永遠不會高於 0.99,因此設定 >0.99 的門檻永遠不會觸發。
拒答處理也不同。依據 OpenAI 指南,OpenAI 可以只對其中一個問題回傳 refusal,其餘問題仍照常回答。Gemini 遇到安全性或禁止內容觸發條件時,則會以 HTTP 400 拒絕整個請求,錯誤碼可能包括 safety 和 prohibited_content。
「有件奇怪的事:看起來 Decisions 和一般文字生成似乎走的是兩套不同的快取與推論路徑。」—— u/Balance-,r/OpenAI
如果產品必須同時支援兩個端點,最好先做一層精簡的 adapter。統一問題 ID、替 Gemini 的 key 改名以避免字母排序造成的結果偏差,並把 Gemini 的門檻限制在 ≤0.99。
支援的輸入不同,也代表你要自行補上的流程不同
Gemini Decisions API 可在同一個輸入中原生處理文字、圖片、音訊、影片和 PDF。OpenAI Decisions API 則支援文字、圖片、input_json、對話歷史、函式呼叫和工具輸出,但不支援檔案或音訊。這個差異,直接決定了前處理工作是可以省掉,還是必須自行建立。
例如,通話錄音加上帳戶資料可以直接交給 Gemini,不必先轉錄;掃描的理賠 PDF 搭配損害照片,也不需要先做 OCR。代理程式的對話紀錄與工具呼叫則能透過 call_id 對應,原生交給 OpenAI;若使用 Gemini,就得先把同一份紀錄攤平成文字。OpenAI 也支援把圖片放在問題的 instructions 中,用於候選項目與參考資料的比對。
圖片 token 的計算方式也因供應商而異。根據一次獨立實測(System Design Academy),一張 224×224 的雞蛋照片,在 OpenAI 搭配三個問題時算作 523 個輸入 token;Gemini Low 則估計為 390 tokens(其中 257 個是圖片 token),Medium 為 663 個,High 為 1,223 個。換算成每 1,000 張圖片,成本分別是 $0.039、$0.066 和 $0.122。
延遲數字都是供應商自行公布,不能直接當成 SLA。Google 表示端到端延遲為 150–250 ms,從 1 個問題增加到 100 個問題、直到 16K tokens,延遲幾乎維持平坦。OpenAI 則宣稱速度約為 Responses API 的 10 倍,但沒有提供絕對數字。實際使用者的回報並不一致:
「速度和成本。輸出幾乎是即時的,而且只要零頭成本。」—— u/zyeus-guy,r/OpenAI
在免費方案測試 Gemini Decision 1:路由 30/30 正確,中位數約 0.24 秒,重複執行結果也很穩定;但在缺少「其他」選項時,它很有把握地選了錯誤分類。—— r/GeminiAI 的實測
把供應商公布的延遲當成測試時要超越的上限,而不是生產環境承諾。
1M 次請求,實際要花多少錢?
兩個 API 都只會對每次請求中的共用輸入計費一次。增加問題只會多出指令 token;真正拉開帳單差距的,是跨請求重複出現的輸入,因為 OpenAI 能夠快取,而 Gemini 會完整計費。
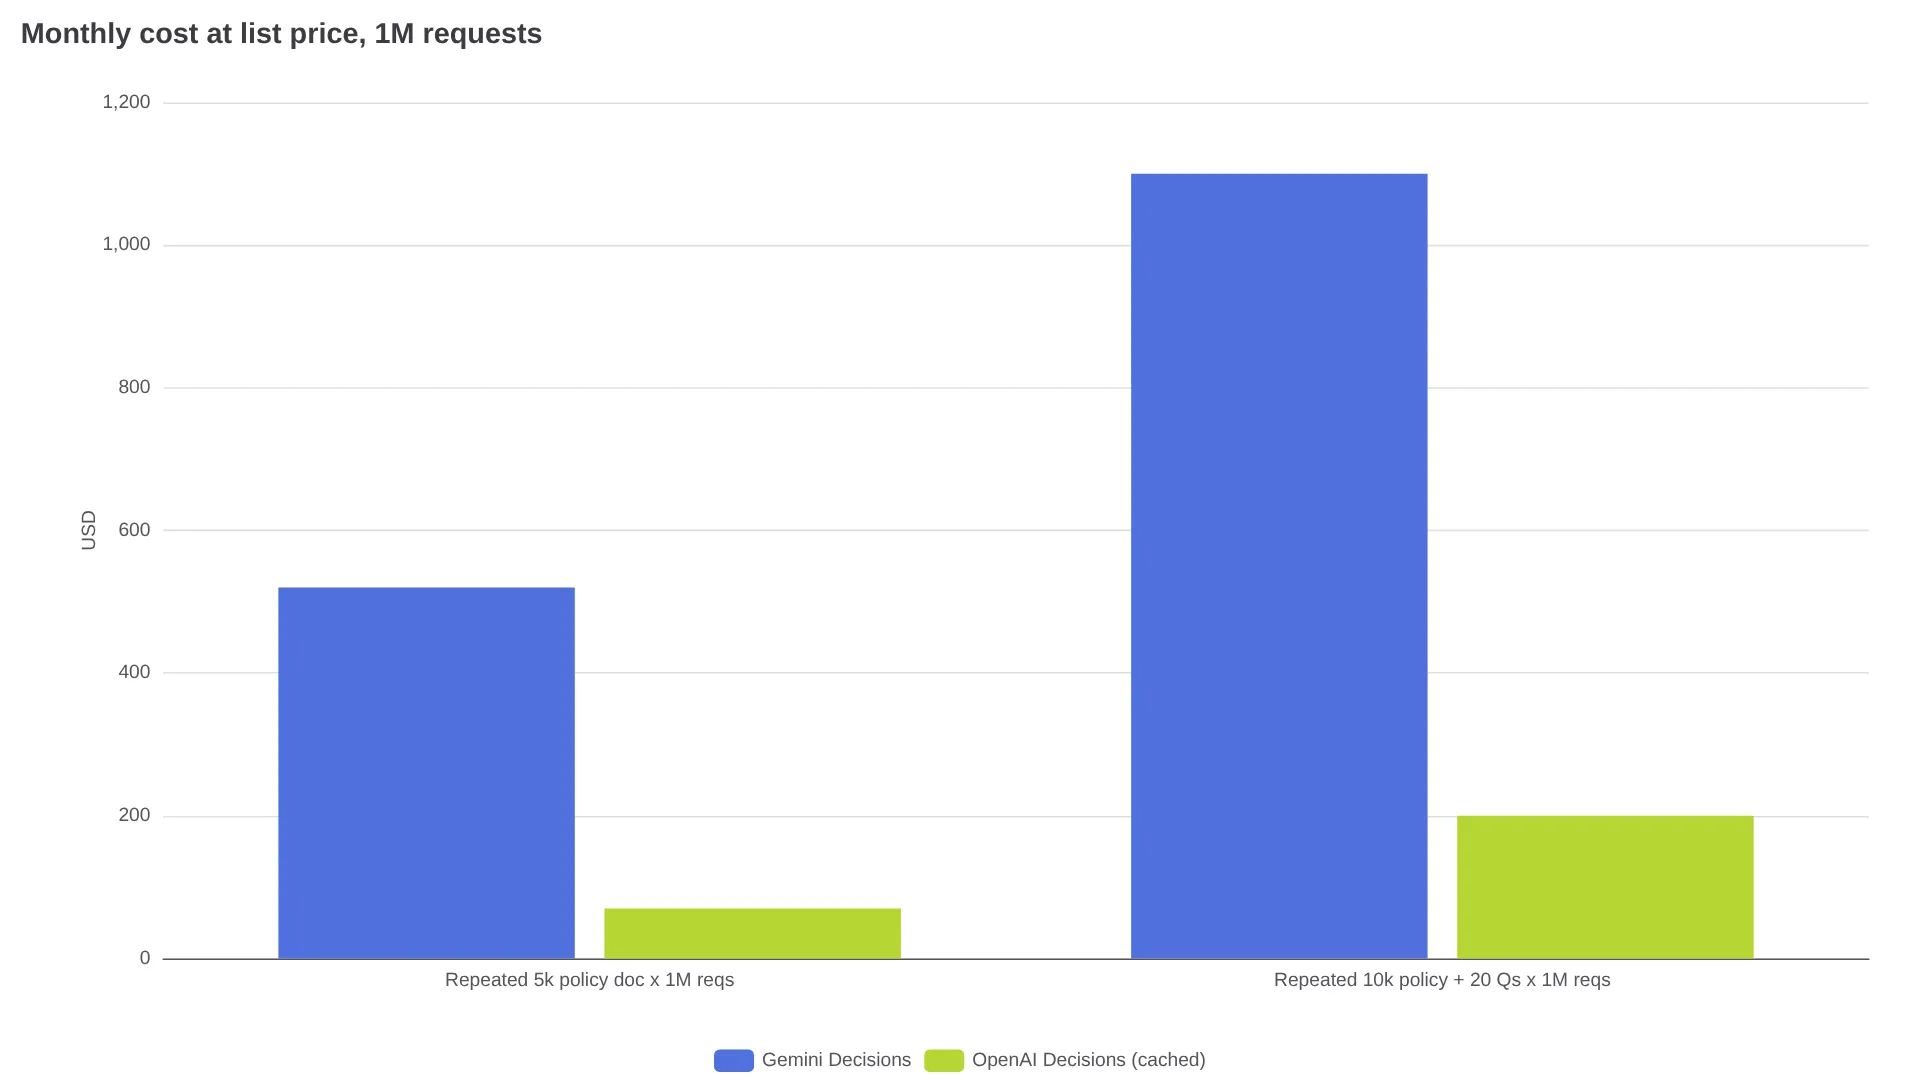
以下是依照公開價格計算的示意數字,參考 Apidog 與 BaristaLabs 發布的模式,並假設 OpenAI 在產生快取寫入費用前已命中快取:
- 1M 張工單,每張都包含相同的 5,000-token 政策文件,以及 200 個新 token:Gemini 約 $520,OpenAI 使用快取後約 $70。
- 1M 次請求,每次都包含相同的 10,000-token 政策文件,再加上 20 個各約 50 token 的問題:Gemini 約 $1,100,OpenAI 使用快取後約 $200,另加寫入費用。
如果每次輸入都是全新內容,這個差距就會消失:一段 400-token、沒有可重用前綴的訊息,在兩邊都是每 100 萬個 token $0.10。比起模型選擇,批次處理往往更重要:一個請求對一筆 4,000-token 紀錄執行 20 項檢查,每 1,000 筆紀錄約 $0.50;拆成 20 個獨立請求,則約為 $8.10。
每一輪都重新讀取長對話時,快取的優勢更明顯。以一個讀取 124,680 tokens 的 30 輪路由器為例,Gemini Decision 1 在沒有快取時,每 1,000 次對話約 $12.47;使用具備快取的聊天模型則約 $6.31。
它回傳的信心分數,值得相信嗎?
在 Google 公布、由 AIToolsReview 整理的表格中,Decision 1 在所有共同測試上都領先 Luna:top-1 ECE 為 0.0250,Luna 為 0.0721,Jev 1.14 則為 0.0494。JevBench 公開分割的結果是 Decision 1 92.2%、Luna 90.9%、Jev 1.14 90.0%。整套測試的成本則是 Decision 1 $0.88、Jev $0.68、Luna $0.93。
同一篇評測引用 Artificial Analysis 的獨立整理指出,Decision 1 的 Decision Index 為 66,與 Jev 1.14 並列第 9,在 18 個模型中約落後 Drex Max v1.1 7 分。在 When2Call 測試中,Decision 1 為 75.2%、Jev 為 80.8%、Drex Max 為 94.6%;Decision 1 每 1M 個任務 $345、延遲 211 ms,Jev 則是 $156、92 ms。
對門檻式自動化來說,校準比表面上的準確率更重要。信心分數 0.90,代表在部署時的資料分布中,理論上約 10 次有 9 次正確。請用 200–500 個已標註案例驗證門檻,並按信心區間統計準確率。
「信心分數:Jev 風格的校準機率,並不是每個 OpenAI 相容端點都會回傳。」—— u/xapep,r/LLMDevs
實務上反覆出現兩種失敗模式。早期使用者測試指出 OpenAI 有偏向第一個選項的問題(@NatashaTheRobot);前述 Gemini 實測則顯示,缺少兜底選項時,模型會選出「最不差」的分類,而不是暫不判斷。解法包括加入 other 選項、另外建立範圍檢查用的 predicate、使用簡短且彼此有區別的描述,並把低於門檻的結果交由人工審核。
正式上線前,這份清單先跑一遍
OpenAI 已 GA,具備快取、GET /v1/organization/usage/decisions 用量報告、符合資格客戶可用的 ZDR 與 HIPAA,以及美國/歐盟區域處理,後者需加價 10%。Gemini 目前仍是 v1beta,Cloud 支援尚未推出。兩家供應商都列出 OpenRouter、LangChain、Vercel 和 LiteLLM 等框架整合。
快取規則會直接影響架構設計。OpenAI 會重用至少 1,024 tokens 的共用輸入前綴;問題內容不計入這個最低門檻。Gemini 沒有 Context Caching、Batch、Flex 或 Priority 層級。免費方案適合用 Gemini 做原型,但免費方案中的內容可能會被用於改善 Google 產品,因此真實客戶資料應放在付費 key 上。要自動執行高風險動作前,至少先記錄一週的信心分布。
別看品牌,按工作負載選
如果是帶有工具呼叫、而且指令會反覆出現的代理程式對話迴圈,優先考慮 OpenAI Decisions API。需要 ZDR、HIPAA 或歐盟資料駐留時,答案也一樣偏向 OpenAI。
如果要處理通話錄音、影片片段,或包含數百項檢查的掃描 PDF,則適合 Gemini Decisions API。原生支援音訊、影片和 PDF,可以省掉轉錄與 OCR;每次最多 1,000 個問題,也能覆蓋超過 400 條規則的清單。輸入限制則是每次請求內嵌 100 MB、每個 PDF 50 MB、外部 URL 15 MB。
短而獨立的文字、問題數少於 400 個時,兩邊的牌價相同。可以先用 Gemini 免費方案搭配合成資料做原型,再用同一批 200–500 個已標註案例在兩邊重跑,比較各信心區間的準確率、p50/p95 延遲、每次請求 token 數和每月成本。
| 工作負載 | 建議選擇 |
|---|---|
| 重複使用 5K–10K 政策文件、高 QPS | OpenAI Decisions API,快取可節省 80%+ |
| 代理程式路由、包含工具呼叫歷史、GPT-Live 語音 | OpenAI Decisions API |
| 音訊 / 影片 / PDF 決策、>400 條規則 | Gemini Decisions API |
| 短而獨立的文字、<400 個問題 | 平手——選現有技術堆疊 |
| 免費原型開發 | Gemini AI Studio,再在付費方案上重新評估 |
Gemini 比 OpenAI 便宜嗎?
牌價同為每 100 萬個 token $0.10,且不收輸出費;遇到重複的快取上下文時 OpenAI 較划算,免費原型開發則是 Gemini 占優。
OpenAI 能讀取音訊、影片或 PDF 嗎?
不能。OpenAI 只支援文字、圖片、JSON 和工具呼叫對話;Gemini 則原生支援音訊、影片和 PDF。
每次請求能放多少個問題?
Gemini 是 1–1,000 個,限制在 262,144 tokens 內;OpenAI 是 1–400 個。
Gemini 已經適合正式上線了嗎?
Gemini 目前是 v1beta,Cloud 支援仍在等待推出;OpenAI 已 GA,提供 ZDR、HIPAA 和區域處理。
還需要 Jev 或本地分類器嗎?
Jev 的牌價是每 100 萬個 token $0.042,並在部分工具選擇測試中領先;如果每項任務的成本是主要考量,值得一起納入基準測試。
低信心結果應該怎麼處理?
用標註資料設定門檻,高於門檻就自動執行,中間區間交給更大型的模型,低於門檻則交由人工審核,而且務必提供 other 選項。
延伸閱讀: