 AIREITER
Qwen3.8-Max 已正式推出,API 每百萬 Input Token 收費 $2,Output Token 則是 $6。單看輸出價格,它比 Claude Opus 4.8、Claude Fable 5 與 GPT-5.6 Sol 至少低四倍。不過,預設的 reasoning_effort 是 xhigh,實際帳單從第一個請求開始,就可能和表面定價出現明顯落差。
Qwen3.8-Max 的 Token 收費一覽
Qwen3.8-Max 是 Alibaba 接替 Qwen3.7-Max 的旗艦模型,採用 2.4 兆參數的 mixture-of-experts 架構,每個 Token 有 950 億個活躍參數。以下是 Alibaba 模型頁面公布的價格;該頁面標示的更新日期為「Updated: Aug 2, 2026」:
| 項目 | 每百萬 Token 價格 |
|---|---|
| Input | $2.00 |
| Output | $6.00 |
| Input(隱式快取) | $0.25 |
| 顯式快取建立 | $2.50 |
| 顯式快取讀取 | $0.17 |
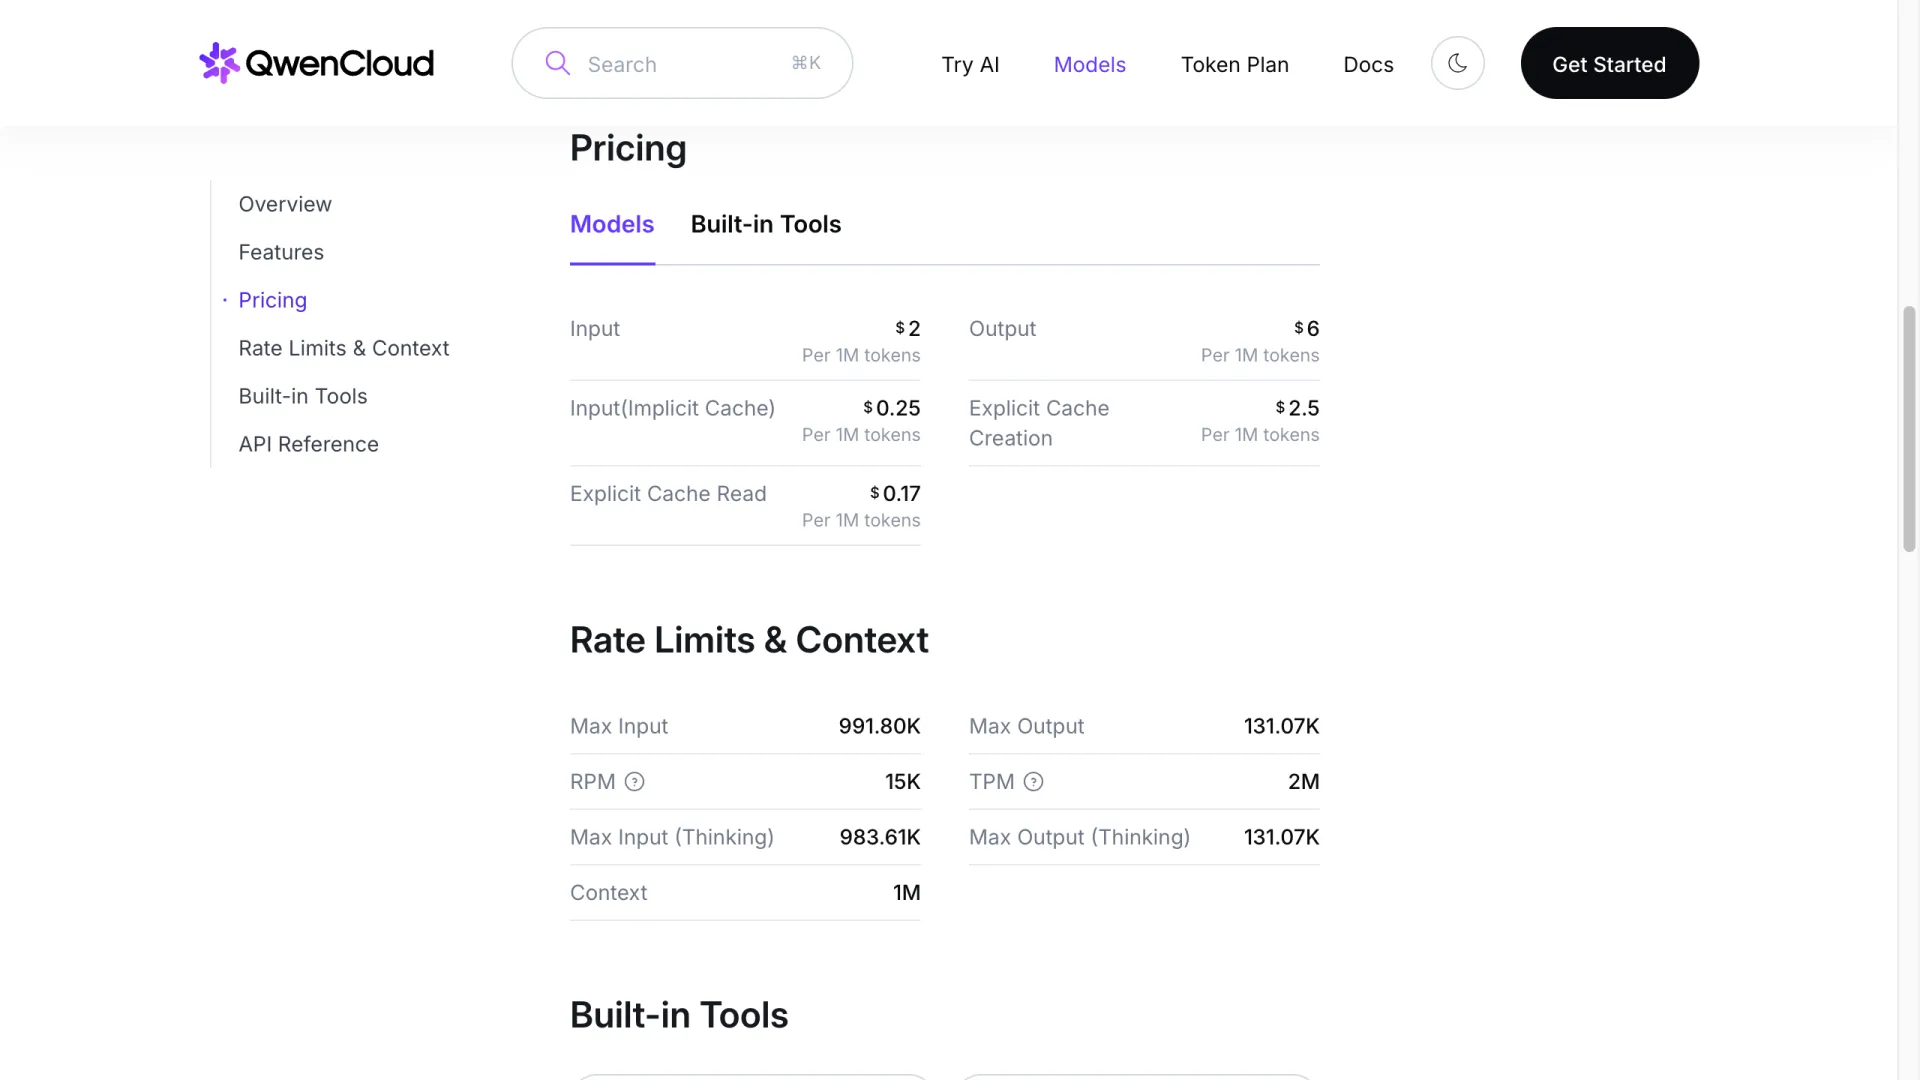
隱式快取不需要額外寫程式處理。重複的前綴內容會自動以每百萬 Token $0.25 計費,僅為標準 Input 價格的八分之一。顯式快取則需要自行取捨:寫入每百萬 Token $2.50、讀取 $0.17,從同一前綴的第二次讀取起就比未快取 Input 划算;但要到大約第 30 次讀取,才會勝過 $0.25 的隱式快取。對多數應用來說,顯式快取大可先不碰。
還有一項限制要注意:API 已開放,但權重尚未開放。Alibaba 的發布文章表示,Qwen3.8-Max 權重將於下週登上 Hugging Face 與 ModelScope;這是數週以來只寫著「coming soon」卻沒有日期後,首次給出的明確時程。截至 8 月 3 日,模型頁面的側欄仍標示 Open Source: No。
每百萬 Output Token $6,為何帳單可能不只如此
Alibaba 的發布文件為 reasoning_effort 提供三種設定,並將最高強度的 xhigh 設為預設值;另外兩種是兼顧準確度與速度的 medium,以及針對速度與成本最佳化的 low。所有情境下,preserve_thinking 也預設開啟。Thinking Token 會按 Output Token 計費,因此在你還沒寫任何提示詞前,這兩項預設就已把支出導向每百萬 Token $6 的費率。
換句話說,影響實際成本的兩個開關,出廠設定都不利於省錢;但它們都只差一個請求參數。改用 medium 或 low,差別就在於:你是為可能根本不需要的深度推理支付每百萬 Token $6,還是只在值得的任務上才付這筆錢。
一位早期測試者在 r/LocalLLaMA 討論串標題中直接給出這樣的評價:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
這不該被當成基準測試結果,而應視為一個提醒:在把預設設定標準化之前,先拿自己的工作負載逐一測試各種 effort 等級。
支援 1M Context,長上下文不另加價
Qwen3.8-Max 的模型頁面只列出一種 Input 與一種 Output 費率,完全沒有依 Context 長度分級。Gemini 3.1 Pro 與 GPT-5.6 Sol 則都會在超過特定 Context 門檻後,切換到更昂貴的價格帶:
| 模型 | Input(短 Context) | Output(短 Context) | Input(長 Context) | Output(長 Context) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00(至 1M) | $6.00(至 1M) |
| Gemini 3.1 Pro | $2.00(≤200K) | $12.00 | $4.00(>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Gemini 3.1 Pro 在 200K Token 以內的 Input 價格與 Qwen3.8-Max 完全相同,超過後就翻倍。GPT-5.6 Sol 一旦進入長 Context 價格帶,Input 費率翻倍、Output 再提高五成,而且這是在其已經重新調整過的價目表之上。
因此,Context 越長,價格差距不是維持不變,而是持續擴大。以 400K Token 的提示詞為例,Qwen3.8-Max 的 Input 成本是 $0.80,Gemini 3.1 Pro 為 $1.60,GPT-5.6 Sol 則是 $4.00。文件處理管線、長時間 Agent 工作階段,以及全程式碼庫掃描都會累積出可觀差異;短篇聊天回合則幾乎感受不到。
與 Alibaba 對比模型相比,成本差多少
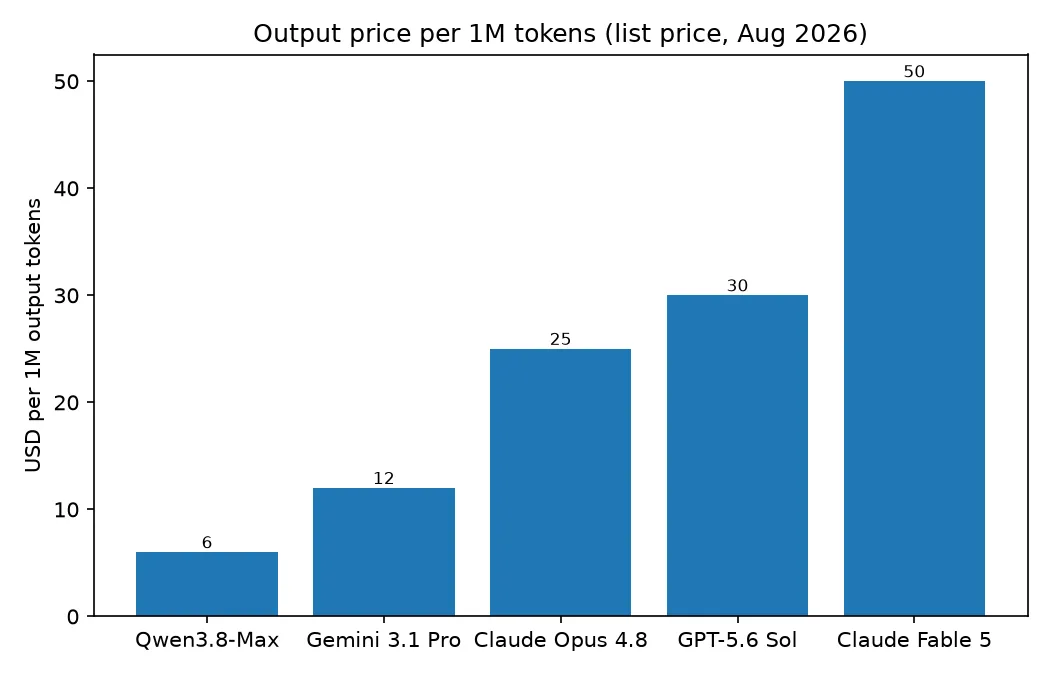
每百萬 Output Token $6,不到 Claude Opus 4.8 的 $25 四分之一,也只有 GPT-5.6 Sol $30 的五分之一。Claude Fable 5 的 $50 更超過八倍。這樣的價差是否值得犧牲能力,仍要看實際表現;Alibaba 用一份涵蓋 28 項的基準測試表主張,這筆交換是值得的:
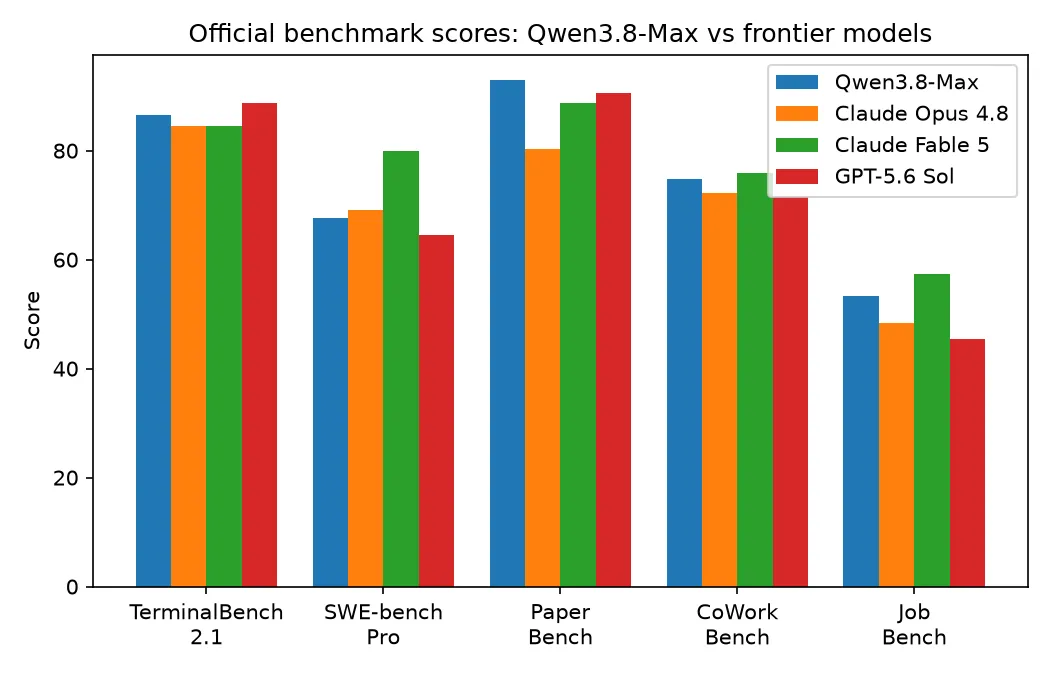
它在 PaperBench 以 93.0 領先,GPT-5.6 Sol 為 90.5、Fable 5 為 88.8;JobBench 取得 53.4,高於 Opus 4.8 的 48.4;Terminal Bench 2.1 則以 86.6 小幅領先兩款 Claude 模型。但在 SWE-bench Pro 上明顯落後,Fable 5 的 80.0 比它的 67.7 高出超過 12 分。這些數字全都是由供應商自行執行,並刊登在同一個供應商頁面上。
這讓選擇變得很清楚。對於 Output 比重高的 Agent 工作,例如長工具呼叫迴圈、文件生成,以及 PaperBench 衡量的研究重現類任務,4 至 8 倍的 Output 價差足以改變整個服務能否經濟運行。若是 SWE-bench Pro 所探測的程式碼庫規模軟體工程,折扣換來的是實際能力下滑,此時付出 Fable 5 的費率依然合理。
要在自己的工作負載上驗證並不難。Alibaba 的發布文章記錄了相容於 OpenAI 的 chat-completions、responses 呼叫,以及相容於 Anthropic 的介面;這正是 Claude Opus 4.8 與 GPT-5.6 Sol 接受的兩種請求形式。
現在應該在程式碼裡調整什麼
模型 ID 是 qwen3.8-max。截至 8 月 3 日,它是 Alibaba 模型目錄中唯一的 3.8 型號,預覽版識別碼 qwen3.8-max-preview 已經消失。因此,別直接假設轉接服務商仍保留 preview 時期的折扣,先確認其設定。
兩種介面皆透過三個區域 Base URL 提供服務:北京、新加坡與美國維吉尼亞州。以下是最可能先碰到的上限:
| 限制 | 數值 |
|---|---|
| Context window | 1M |
| 最大 Input | 991.80K |
| 最大 Input(thinking) | 983.61K |
| 最大 Output | 131.07K |
| 每分鐘請求數 | 15K |
| 每分鐘 Token 數 | 2M |
兩種 Input 上限相差約 8K Token,值得留意:開啟 thinking 不只會增加 Output Token,也會吃掉可用的 Input 空間。若下週權重真的釋出,950 億活躍參數這個數字,也會成為比較自行部署與 $2/$6 API 成本的起點。
常見問題
Qwen API 是免費的嗎?
不是。Qwen3.8-Max 採 Token 計費,每百萬 Input Token $2、每百萬 Output Token $6。Alibaba API platform販售的 Token Plan 訂閱,是另一種以額度為基礎的產品,和按 Token 計費的 API 是分開的。
Qwen Max 的費用是多少?
目前這一代的價格是每百萬 Input Token $2、每百萬 Output Token $6,隱式前綴快取則為 $0.25。Alibaba Cloud 文件中的舊 qwen-max 項目指的是先前世代,採用不同費率。
Qwen3.8-Max 的 1M Context window 要額外付費嗎?
不用。無論 Input 與 Output 是 5K Token 還是 900K Token,價格都一樣;這也是它與 GPT-5.6 Sol、Gemini 3.1 Pro 最明確的結構性差異。
Qwen3.8-Max 比 Qwen3.7-Max 便宜嗎?
從官方頁面無法判斷。Qwen3.7-Max 模型頁面雖標示 50% 折扣,但每 Token 的價格顯示為 --,並未公布實際費率,因此沒有可供比較的數字。
延伸閱讀
- Claude Fable 5 pricing:本文對比的 $10/$50 價格帶
- Cutting Claude Fable 5 token costs:另一家供應商同樣適用的 effort 與快取成本控制方法