 AIREITER
Qwen-UI-Agent 在官方比較中最亮眼的戰場是手機操作:實機測試 MobileWorld-Real 達 92.2%,AndroidDaily 更有 97.5%。不過,支撐這些成績的 27B 模型目前沒有確認公開的權重,也沒有 API 可用。現階段你能取得的是技術報告、展示影片,以及較小型的前代 MAI-UI 模型。排行榜成績與實際可用性之間的落差,正是這次發布最值得關注之處;以下會先整理全部官方分數,再逐一盤點目前究竟能拿到哪些資源。
Qwen-UI-Agent 官方成績一次看
Qwen-UI-Agent 是阿里巴巴 Tongyi-MAI 團隊推出的基礎 GUI agent,技術報告於 2026 年 7 月 30 日發布(arXiv 2607.28227)。它以單一模型涵蓋手機操作、電腦操作、網頁與 DeepSearch 環境,並以統一動作空間支援 GUI 操作、CLI 執行與批次動作序列。從官方結果頁來看,Qwen-UI-Agent 在列出的所有手機與 grounding 基準皆居第一,在 OSWorld-Verified 排名第二,在長時程測試 OSWorld-v2 則名列第三。報告評估了 27B、35B-A3B 與 4B 三種版本,以下分數均為旗艦 27B 版本的結果。
手機操作:領先幅度明顯
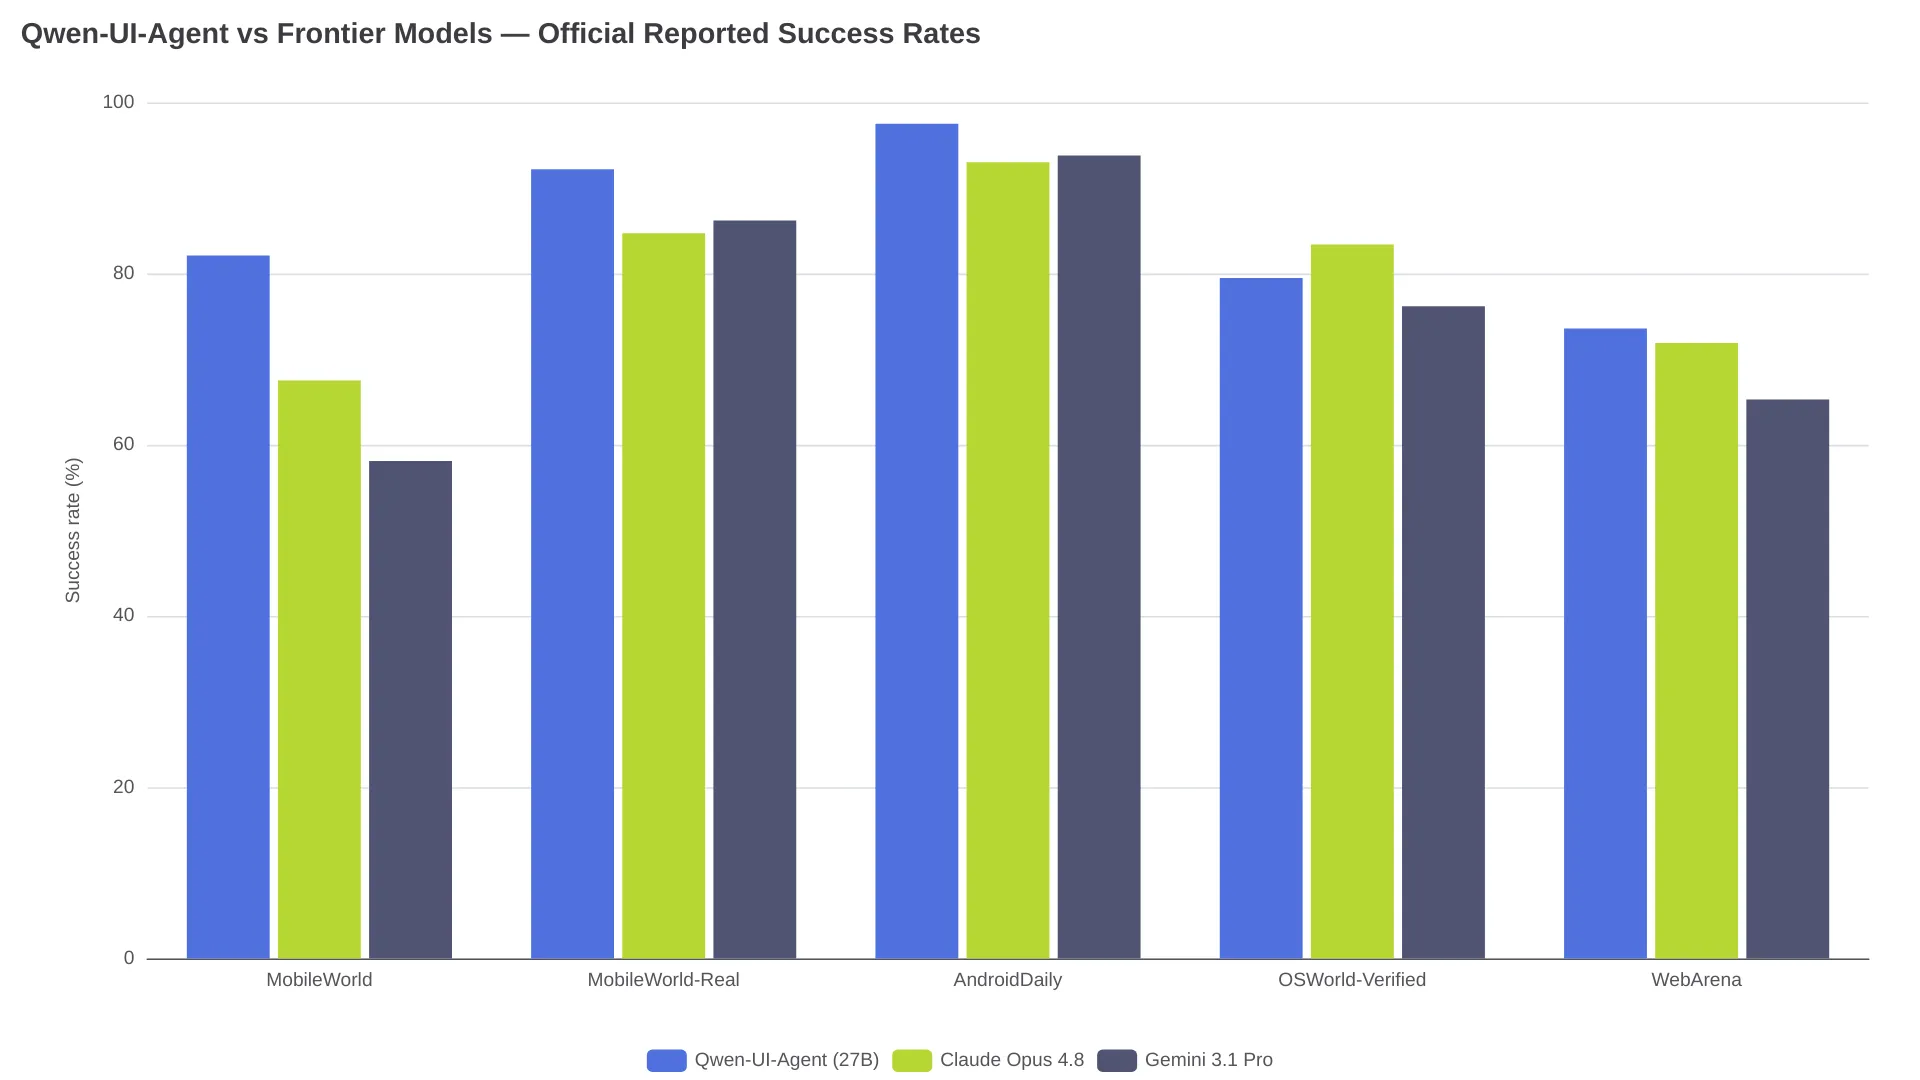
行動裝置是報告主張達到業界最佳表現的核心領域,而且優勢不小。在 MobileWorld 的純 GUI 分組中,Qwen-UI-Agent 拿下 82.1%,比第二高的通用模型 Seed 2.1 Pro(73.2%)高出 8.9 個百分點,也比表現最好的專用 GUI agent GUI-Owl-1.5-32B-Instruct(43.9%)高出 38.2 個百分點。
| 模型 | MobileWorld(僅 GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
官方表格的手機項目採用 GPT-5.6 Sol 作為對照,成績為 70.1 / 85.4 / 92.6;桌面項目則使用 GPT-5.5。引用任何一個「GPT」數字前,這項差異值得先確認。
MobileWorld-Real 是作者自行建立、也是此次最受矚目的基準:涵蓋七個日常使用領域、104 款真實 Android app 的 409 項端到端任務,測試在真實裝置上進行,使用真實帳號並納入現實世界的干擾情境,最後由五個 VLM 以多數決評分。
桌面操作夠強,但不是第一
桌面測試正是報告使用「具競爭力」一詞的原因。Qwen-UI-Agent 在 OSWorld-Verified 取得 79.5%,排名第二,落後 Claude Opus 4.8 的 83.4% 共 3.9 個百分點。至於長時程的 OSWorld-v2,40.0% 是部分進度分數,二元完成率僅 13.9%;Claude Opus 4.8(54.8)與 GPT-5.5(49.5)都明顯領先。
| 模型 | OSWorld-Verified | OSWorld-v2(部分進度) | OSWorld-v2(二元完成) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | 未報告 |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | 未報告 | 未報告 |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | 未報告 | 22.3 | 未報告 |
不過,效率方面確實有可看之處。透過批次動作,Qwen-UI-Agent 平均每個任務只需 135.8 步,低於 MiniMax M3 的 326.7 步與 Qwen 3.7 Plus 的 173.5 步;同時在部分進度上仍比所有開放權重模型高出至少 17 個百分點。在 OSWorld-v2 中,CLI 指令佔 agent 操作超過 50%,顯示 GUI+CLI 的混合設計帶來了可量化的效果。
瀏覽器與 DeepSearch 表現
WebArena 由 Qwen-UI-Agent 以 73.6% 拿下第一,領先 Claude Opus 4.8(71.9)、GPT-5.5(69.5)與 Gemini 3.1 Pro(65.3)。研究型任務方面,BrowseComp 為 64.1,相較 Qwen3.5-27B 基線的 61.0 有所提升;BrowseComp-ZH 則為 75.0,對比基線的 62.1。這表示 DeepSearch 訓練帶來的不只是點擊能力提升。
GUI grounding 全數奪冠
Grounding 指的是根據視覺指令,在畫面上點到正確像素位置。依官方結果頁,Qwen-UI-Agent 在列出的每一項 grounding 基準中都排名第一。
| 基準測試 | Qwen-UI-Agent | 最佳競爭者 |
|---|---|---|
| ScreenSpot-Pro(不縮放) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro(放大) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
泛用能力的代價不大
專攻 GUI 的模型,往往會犧牲原本的語言模型能力;Qwen-UI-Agent 大致沒有這個問題。MMLU-Pro 為 86.5,略高於 Qwen3.5-27B 的 86.0;IFEval 則為 90.2,與後者的 90.4 幾乎持平。至於和專用 GUI 模型相比,差距則相當懸殊。
| 基準測試 | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | 未報告 | 未報告 | 未報告 |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
唯一可見的基線失利出現在 QwenClawBench,Qwen-UI-Agent 為 44.2,低於 Qwen3.5-27B 的 48.5。此外,官方頁面也註明,這些較廣泛能力的分數是在作者自己的評測環境中重現。
Qwen-UI-Agent 的訓練方式
根據技術報告,Qwen-UI-Agent 的訓練資料來自真實裝置機群:超過 100 支實體手機、涵蓋 150+ 款 app,並透過 agent 驅動的資料飛輪自行建構與診斷任務。完成監督式微調後,模型再針對超過 100 輪的軌跡進行多階段 RL 訓練,rollout 分布於超過 10,000 個並行環境。
這些排行榜成績該怎麼看
官方頁面本身就列出三項注意事項,任何引用成績時都不該略過。第一,MobileWorld-Real 是作者自行建立的基準。第二,帶有匕首符號的基線分數由作者在自家環境中重現,測試 harness、評審器、模擬器與任務子集可能和其他廠商的官方評測不同。第三,OSWorld-v2 的 40.0% 是部分進度,不是成功率。(來源:官方結果頁註記與技術報告。)
「阿里巴巴的新 GUI agent 贏了手機,卻在桌面端停滯。」-@Daily_AI_Brief on X,該帳號也指出:「阿里巴巴是在自己的環境中為所有基線評分。」
X 上的獨立解讀也得出相近結論。日文解析作者 @itarutomy 一方面肯定其真實裝置手機測試的領先,同時強調桌面成績是第二名。Tongyi Lab 的 Pengxiang Li(@oliverlee1999)發布的官方公告串,則是本次發布的第一手來源。整體而言,MobileWorld-Real 可視為一項有力但仍待獨立重現的主張;OSWorld-Verified 則更適合作為跨團隊比較,因為它並非作者自行推出的基準。
目前如何取得 Qwen-UI-Agent
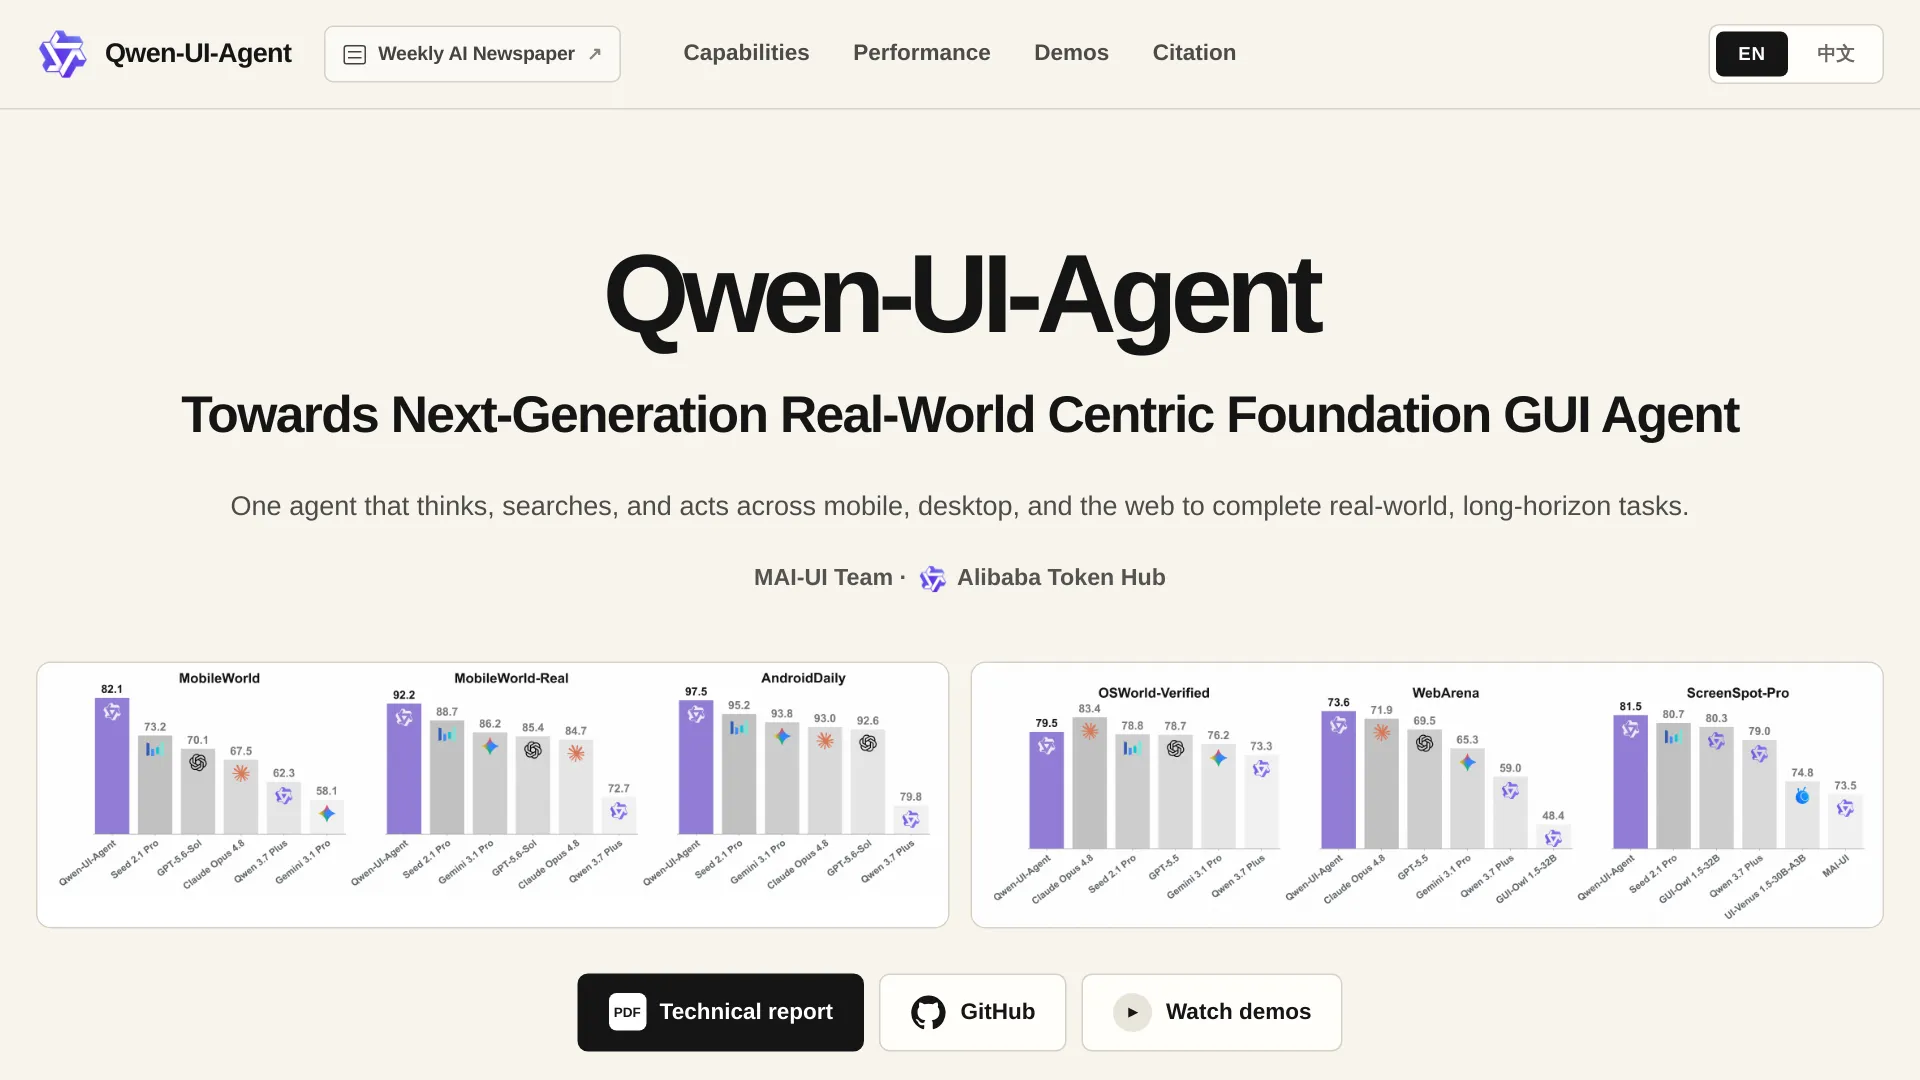
Qwen-UI-Agent 目前仍屬研究發布:有論文、專案頁面與程式碼儲存庫,但沒有確認公開的模型 checkpoint。以下整理各項公開資源實際包含的內容。
公開資源盤點
| 資源 | 連結 | 內容 |
|---|---|---|
| 技術報告 | arxiv.org/abs/2607.28227 | 完整論文,於 2026 年 7 月 30 日提交;提供 PDF、HTML 與 TeX 原始碼 |
| 專案頁面 | tongyi-mai.github.io/Qwen-UI-Agent | 能力展示、完整基準圖表與引用資訊 |
| MAI-UI repository | github.com/Tongyi-MAI/MAI-UI | Apache-2.0 repository,已改名配合 Qwen-UI-Agent;連結至 2025 年 12 月發布的 MAI-UI-8B 與 MAI-UI-2B Hugging Face checkpoints |
| Qwen-UI-Agent repository | github.com/Tongyi-MAI/Qwen-UI-Agent | 僅含網站原始碼;repository 明確表示不包含模型、訓練程式碼或 agent 實作 |
MAI-UI repository 是官方延續此專案的主要據點:它在 2026 年 7 月 30 日公告 Qwen-UI-Agent,目前也連結了這個技術脈絡中唯一可下載的 checkpoints。
權重目前的真實狀態
目前唯一可下載的是 2025 年 12 月推出的前代 MAI-UI-8B 與 MAI-UI-2B checkpoints,可從 MAI-UI repository 的 Hugging Face 參考連結取得。沒有任何 Qwen-UI-Agent 27B、35B-A3B 或 4B checkpoint 獲確認公開;此處的可用性狀態已於 2026 年 8 月下旬對照官方 repositories 與專案頁面查核,未發現任何發布。不要把 MAI-UI checkpoint 的連結,或只含網站原始碼的 repository,誤認為 Qwen-UI-Agent 模型權重。
暫無 API,也無法自行部署
官方管道中沒有出現公開的 Qwen-UI-Agent API endpoint、託管產品,或 vLLM/Ollama 套件。現階段的實務選項很明確:若你要交付桌面自動化工作流程,已公布的 OSWorld 成績更偏向 Claude Opus 4.8;若是想實驗開放權重 GUI 模型,能走的路是 MAI-UI 2B/8B 搭配自建 harness,但那是 MAI-UI,不是 Qwen-UI-Agent。發布消息可持續留意官方 Tongyi-MAI repositories 與 Qwen 相關頻道。至於已提供 API 的通用 Qwen 模型系列,AIReiter Qwen model catalog 會追蹤目前的 endpoints 與價格。
Qwen-UI-Agent 在產品線中的位置
Qwen-UI-Agent 是阿里巴巴 GUI agent 路線的第三代。UI-TARS 在 2025 年開創基於 Qwen 的 GUI 方法;MAI-UI(arXiv 2512.22047,2025 年 12 月)導入以真實世界為中心的資料飛輪,並開源 2B/8B 權重;Qwen-UI-Agent 則把這套做法擴展到 27B,加入 GUI+CLI 混合執行。至於上方表格中的兩項 OSWorld 指標,Claude Opus 4.8 均居領先。
Qwen-UI-Agent 常見問題
Qwen-UI-Agent 是開源的嗎?
程式碼 repositories 採 Apache-2.0 授權,技術報告也已公開,但模型本身尚未確認為開放權重。目前只有前代 MAI-UI-8B 與 MAI-UI-2B checkpoints 可下載(Hugging Face,2025 年 12 月)。截至本文撰寫時,沒有 Qwen-UI-Agent 27B、35B-A3B 或 4B checkpoint 獲確認公開發布。
現在可以在本機執行 Qwen-UI-Agent 嗎?
不行,目前沒有經驗證的本機部署方式:沒有 checkpoint、沒有 GGUF 或 Ollama 套件,也沒有 vLLM 配方。本機實驗僅限於 MAI-UI 2B/8B 搭配自建 harness。
Qwen-UI-Agent 有 API 嗎?
尚未公布公開 endpoint 或託管產品。請留意官方 Tongyi-MAI GitHub repositories 與 Qwen 團隊頻道的發布公告。
Qwen-UI-Agent 和 Claude Opus 4.8 的電腦操作能力相比如何?
Claude Opus 4.8 在 OSWorld-Verified 以 83.4 領先 Qwen-UI-Agent 的 79.5,在 OSWorld-v2 部分進度也以 54.8 領先 40.0;但 Qwen-UI-Agent 在 WebArena 以 73.6 領先 71.9,並在列出的所有手機基準中居首。長時程桌面操作目前較適合 Claude;手機優先的任務則是 Qwen-UI-Agent 公布成績最強的領域。
MobileWorld-Real 是什麼?
這是一套由 Qwen-UI-Agent 作者建立的實機 Android 基準,涵蓋七個日常使用領域、104 款真實 app 的 409 項任務,並以五個 VLM 的多數決評分。其結果為作者自行報告,仍待獨立重現。
哪些訊號會改變目前判斷
以下三個訊號若出現,將實質改變目前的評估:
| 訊號 | 重要性 |
|---|---|
| Tongyi-MAI Hugging Face 帳號下出現 Qwen-UI-Agent checkpoint | 讓研究發布轉為可實際建置的選項,也會帶動第三方測試數據 |
| 由阿里巴巴測試 harness 以外的團隊重現 OSWorld-Verified | 可確認 79.5% 是否能在作者環境之外成立 |
| 出現任何產品介面:API、Qwen app 整合或預覽版 | 讓比較從論文表格走向實際生產環境的取捨 |
在此之前,關鍵取捨仍未改變:目前比較中領先的手機操作成績,屬於同一團隊自行建立基準後所做的自我報告。
延伸閱讀:阿里巴巴較新的通用旗艦模型及其開放權重狀態,可參考 Qwen3.8-Max open weights;endpoint 成本則見 Qwen3.8-Max API pricing guide。