 AIREITER
等了三週的「即將推出」後,Qwen3.8-2.4T-A95B 權重終於在 2026 年 8 月 12 日於 ModelScope 上線。它的總參數量高達 2.4 兆,但每個 token 實際只會啟用 950 億參數。問題在於,即使壓到 4-bit 量化,模型仍約需 1.2 TB VRAM;除了資料中心,幾乎沒有人能在本機真正跑起來。以下整理這次釋出了什麼、使用成本如何,以及哪些情況下 API 才是唯一合理的選擇。
Qwen3.8-2.4T-A95B 權重已可下載
權重正式開放了。Alibaba 的 Qwen 團隊在 8 月 12 日稍晚透過 ModelScope 社群帳號發布 Qwen3.8-2.4T-A95B checkpoint,這也是第一款釋出開放權重的 Qwen-Max 級模型。此前三代 Qwen Max 模型——Qwen3.5-Max、Qwen3.6-Max 與 Qwen3.7-Max——都僅能透過 API 使用。
首先要分清楚:「Qwen3.8」其實可能指的是兩個不同東西。
| 名稱 | 定位 | 取得方式 |
|---|---|---|
| Qwen3.8-2.4T-A95B | 開放權重基礎模型 | ModelScope(可下載 checkpoint) |
| Qwen3.8-Max | 具備額外生產環境能力的雲端版本 | Alibaba Token Plan、Qoder、QoderWork |
Qwen3.8-Max 以開放權重的 A95B 模型為基礎,但再加入後訓練強化。Alibaba 將其描述為涵蓋真實環境擴展、統一獎勵訊號與線上資料平衡的三階段系統。換句話說,開放權重提供的是基礎模型,而非完整的 Max 生產環境堆疊。
如果你看到文章仍說權重「已承諾但尚未提供」,那已經過時了:這次發布確實落在 Alibaba 預告的「8 月 10 日當週」時程內。
關鍵規格確認:95B 啟用參數、原生 256K 上下文
自 7 月 19 日預覽版發表以來,最受關注卻始終缺失的規格,就是啟用參數量。許多第三方指南都明確標示為「尚未公布」。如今答案已確認:在 2.4 兆總參數中,模型每個 token 啟用 950 億參數。
| 規格 | 確認數值 |
|---|---|
| 總參數量 | 2.4T |
| 每個 token 啟用參數量 | 95B |
| 架構 | MoE(延續 Qwen3.5 的混合式設計) |
| 每個 MoE 層的專家數 | 512 |
| 每個 token 路由專家數 | 10 |
| 每個 token 共用專家數 | 1 |
| 原生上下文視窗 | 262,144 tokens(256K) |
| 可擴展上下文 | 1,010,000 tokens(1.01M) |
| 訓練方法 | Multi-Token Prediction(MTP) |
| 首款開放權重 Qwen-Max | 是(2026 年 8 月 12 日) |
有兩點特別值得留意。第一,原生上下文是256K,不是外界普遍以為的 100 萬 token。1.01M 指的是可擴展模式,而 Alibaba 尚未說明該模式的品質取捨。第二,MoE 路由極為稀疏:每個 token 在 512 個專家中僅啟用 11 個,也就是 10 個路由專家加上 1 個共用專家。大約 4% 的參數啟用比例——95B 對 2.4T——正是它在總模型規模達 2.4T 的前提下,仍能將輸入成本壓至 $2/M 的關鍵。
MTP(Multi-Token Prediction)訓練代表相容的推論引擎可在一次前向傳播中預測多個 token,理論上有機會提升吞吐量。不過 Alibaba 尚未指出哪些引擎支援此功能。
自架現實:2.4T 參數到底要花多少硬體資源
規格很吸睛,但真正嘗試載入模型後,現實很快就會浮現。先看最基本的算術。
以 4-bit 量化計算,2.4 兆參數約需1.2 TB儲存空間,這還沒算 KV cache、activation memory 與執行期額外負擔。單張 NVIDIA H200 GPU 配備 141 GB 記憶體;8 張 H200 合計只有 1,128 GB,不僅裝不下權重,也無法同時提供任何有實用價值的上下文視窗。
| 部署情境 | 預估 VRAM 需求 | 硬體 | 實際可行性 |
|---|---|---|---|
| 全精度(16-bit) | ~4.8 TB | 34+ 張 H200 GPU | 僅限資料中心 |
| 4-bit 量化 | ~1.2 TB | 9+ 張 H200 GPU | 僅限資料中心 |
| 1.5-bit 量化 | ~450 GB | 4+ 張 H200 GPU | 空間緊繃;品質損失未明 |
| Qwen3.8-27B(替代選項) | 4-bit 約 ~27 GB | 1 張消費級 GPU | 可以 |
95B 的啟用參數量確實有助於每個 token 的推論吞吐:模型每次前向傳播只會經過一部分專家。但啟用參數少,並不代表儲存全部 512 個專家網路所需的記憶體會變少。正如 GEO Toolbox 所說:「稀疏啟用讓模型大規模運行變便宜,並不會讓擁有它變便宜。」
若是本機或單機伺服器部署,較務實的選擇是 Qwen3.8-27B variant。它同樣承襲 Qwen3.8 的訓練脈絡,且在 4-bit 下能裝進單張消費級 GPU。至於 2.4T 模型,定位更接近研究與資料中心工作負載。
多數團隊該選 API,而不是自架
對幾乎所有團隊而言,自架 2.4T MoE 模型都不切實際,真正實用的存取方式自然是 API。Alibaba Model Studio 對 Qwen3.8 Max 的定價為:每百萬輸入 token $2、每百萬輸出 token $6,比前代模型與最接近的中國競爭對手都便宜。
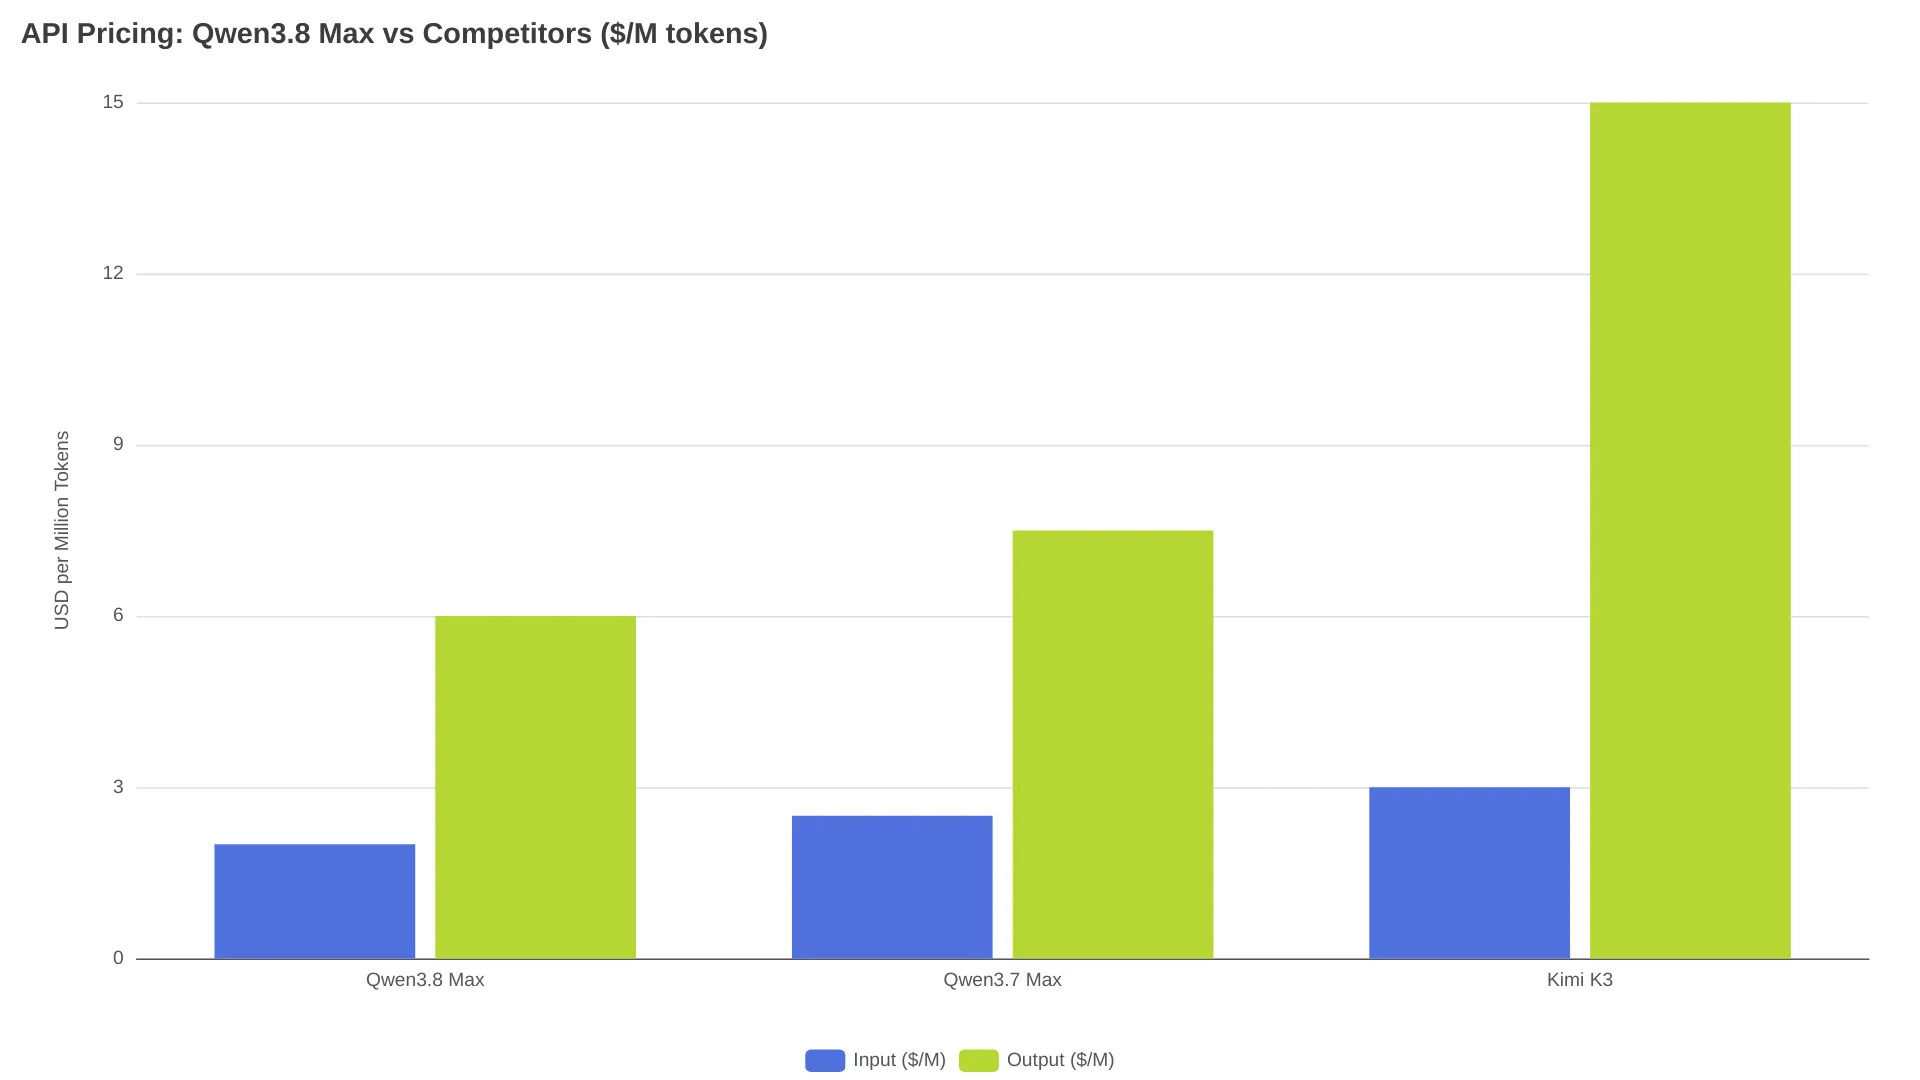
| 模型 | 輸入($/M) | 輸出($/M) | 上下文 |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 原生 256K(可擴展至 1.01M) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
除了按 token 計費的 API,Alibaba 也提供三種訂閱方案:
- Lite:$6/月(約 10,000 credits)
- Standard:$18/月(約 40,000 credits)
- Pro:$68/月(約 160,000 credits)
Token Plan endpoint 同時支援 OpenAI 相容與 Anthropic 相容 API 格式,因此 Claude Code、Cursor、OpenCode 等工具不必修改用戶端即可使用。Alibaba 的程式開發產品 Qoder,在離峰時段(14:00-00:00 UTC)提供最低僅標準費率 0.01 倍的促銷 credits;但這些是上市優惠,不能視為長期定價。
訂閱模式也有一個明顯問題:Qwen3.8 Max 的推理模式相當冗長,而社群回報的額度消耗情況大致一致。
「Qwen 非常容易想太多。」- u/darko,r/Qwen_AI
在同一串 Reddit 討論中,一名 Lite 訂閱者表示,約使用 5,000 萬 token 後,不到兩天就耗盡一週額度。另有 Pro 方案使用者表示,開啟 7 個平行 agents、cache-hit rate 達 94% 的情況下,單日就燒掉 5 億 token。reasoning_effort 參數可設定為 low、medium 或 xhigh,會直接控制模型產生多少推理輸出,也就決定 credits 消耗的速度。一名使用者測試發現,設為 low 後,每次請求的思考時間可降至約 10 秒。
想進一步了解成本拆解,可參考我們的 Qwen3.8 Max API pricing guide。
基準測試表現:Qwen3.8 Max 的優勢與不足
Alibaba 公布了 Qwen3.8 Max 與 Fable 5、GPT-5.6 Sol 的基準測試比較。整體結果並非一面倒,而且原廠數據與獨立測試之間的落差大到不容忽視。
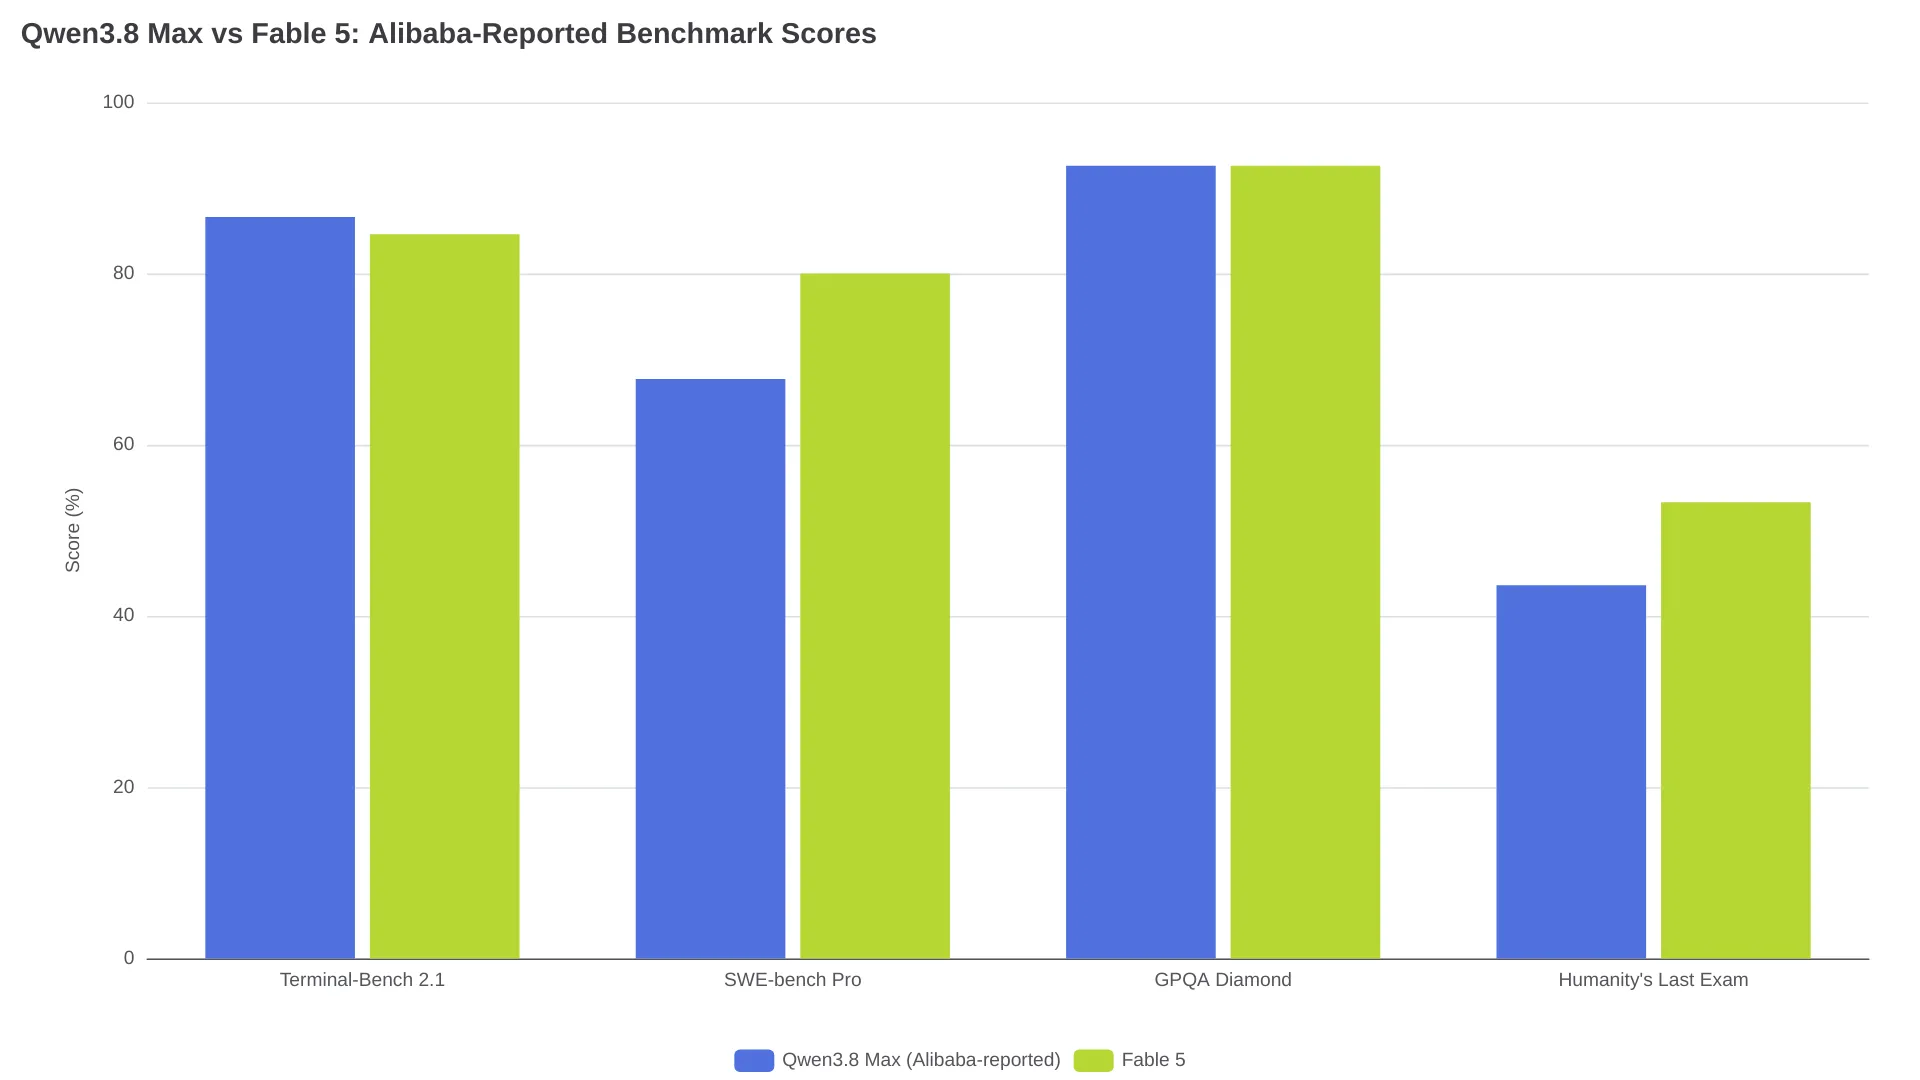
| 基準測試 | Qwen3.8 Max(Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 高於 Qwen(未公布確切分數) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | 高於 Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | 未公布 |
獨立測試呈現的是另一幅圖像。Artificial Analysis 測得 Qwen3.8 Max 在 Terminal-Bench 2.1 的成績為 81.3%,比 Alibaba 公布的 86.6% 低了 5.3 個百分點。以這項獨立成績計算,Qwen 整體排名約第十,落後 Fable 5(84.6%)與 Kimi K3(85.0%)。
Qwen3.8 Max 仍有自己的強項:SWE-bench Pro 的 67.7% 優於 GPT-5.6 Sol 的 64.6%,多模態成績也很亮眼,例如 MathVision 為 95.2、Fable 5 為 92.7;LogicVista 則是 91.9 對 85.7。模型在 DeepSWE 1.1 上也比 Qwen3.7 Max 大幅進步,從 21.6 提升至 56.6,顯示其軟體工程 agent 任務確有實質增益。
社群評價也正好反映這種兩極感。同一串抱怨它過度思考的 Reddit 討論中,也有人這樣說:
「輸出品質簡直是神級。」- u/TangerineLogical9779,r/Qwen_AI
速度方面則據報不太穩定,會隨負載與時段在 8 tokens/sec 到 60 tokens/sec 之間波動。若想查看與 Kimi K3 的正面比較,可參考我們的 Qwen3.8 Max vs Kimi K3 comparison。
常見問題
Qwen3.8-Max 的權重可以下載嗎?
可以。Alibaba 已於 2026 年 8 月 12 日在 ModelScope 發布 Qwen3.8-2.4T-A95B checkpoint。這是首款開放權重的 Qwen-Max 級模型。雲端版 Qwen3.8-Max 則在基礎模型之上加入額外的生產環境能力。
開放權重採用什麼授權?
截至本文撰寫時,確切授權尚未確認。依過往案例推測,可能是 Apache 2.0——Qwen3.6 就是採用該授權——但 Qwen3.7 Max 仍維持封閉。若要用於商業用途,請先閱讀 ModelScope 儲存庫中的實際授權檔案。
Qwen3.8-2.4T-A95B 與 Qwen3.8-Max 有何差異?
Qwen3.8-2.4T-A95B 是開放權重的基礎模型:具備 2.4T 參數、95B 啟用參數、MoE 架構與原生 256K 上下文。Qwen3.8-Max 則是 Alibaba 基於此模型打造的雲端版本,加入用於生產環境的後訓練,包括統一獎勵系統與線上資料平衡。開放權重提供基礎版,API 則提供強化版。
我能在本機執行 Qwen3.8-Max 嗎?
實際上不可行。模型在 4-bit 量化下約需 1.2 TB VRAM,僅權重就要 9 張以上 H200 GPU,還沒有空間留給上下文 cache。即使採用 1.5-bit 量化,需求仍是數百 GB。較現實的本機替代方案是 Qwen3.8-27B variant,可裝進單張消費級 GPU。
Qwen3.8 Max API 要多少錢?
Model Studio API 的費率為每百萬輸入 token $2、每百萬輸出 token $6。訂閱方案從 $6/月的 Lite 起,最高為 $68/月的 Pro。Qoder 在離峰時段提供最高 98% 折扣的促銷 credits,但這是上市定價,未來可能調整。