 AIREITER
17GB 的模型下載檔,不代表它就是一個用起來順暢的本地 Agent。Qwen3.8-27B 是具備 Apache-2.0 授權、能力完整的開放權重模型,但預設的超高推理強度,若沒有搭配合適的量化、上下文預算與推論服務堆疊,原本幾秒能完成的任務也可能變成漫長等待。
Qwen3.8-27B 值得在本地跑嗎?
如果你有大約 24GB 的 GPU 記憶體或統一記憶體、重視資料留在本機處理,也能接受互動回應比快速託管 API 慢,Qwen3.8-27B 值得考慮本地部署。它最吸引人的地方不在單一基準成績,而是它以可部署的規模,提供 Apache-2.0 授權的 Dense 模型、影像與影片輸入、262,144 Token 原生上下文,以及可調整的推理機制。Qwen 官方模型卡標示的發布日期為 2026 年 8 月 14 日。
不過,別把它當成所有 API 模型的自動替代品。官方成績屬於廠商自行公布,激進量化會同時影響品質與速度,而預設的 xhigh 推理強度,對許多本地互動任務來說並不是理想起點。
先看記憶體預算,再看跑分圖表
Qwen3.8-27B 是 Dense 模型,每次生成 Token 都會啟用完整模型。因此,記憶體頻寬、KV Cache、量化方式與指定上下文長度,比單看權重檔大小更能決定實際體驗。Qwen 的模型卡記載原生上下文為 262K,但在本地實際使用時,通常應設得低得多,才能保留可用記憶體與合理速度。Qwen 的服務範例展示了 262,144 Token 的上限;那是能力極限,不是每台消費級電腦都該採用的預設值。
| 可用記憶體 | 實務起步配置 | 預期體驗 | 建議 |
|---|---|---|---|
| 12GB | 激進的 Q3 級量化,加上 CPU/系統記憶體卸載 | 上下文短,延遲取捨明顯 | 除非目的是本地實驗,否則建議改選更小的模型 |
| 16GB | 激進 Q3,或審慎挑選的 Q4 類量化 | 可處理短小且有人監督的任務;上下文與速度都受限 | 投入 Agent 工作流程前先實測 |
| 24GB | Q4 級量化 | 適合程式開發、工具呼叫與中等上下文,是實務上的入門點 | 最符合多數 Qwen3.8-27B 本地使用者需求 |
| 32GB+ | 品質更高的量化,或保留更多上下文空間 | 在 KV Cache 與長時間工作階段上可少做些妥協 | 持續執行 Agent 工作時優先考慮此級距 |
以上是操作建議,不是官方最低硬體需求。獨立使用者回報,12GB RTX 3060 可以跑起本地版本並處理工具呼叫;但也有人警告,Dense Agent 在這個 VRAM 級距下表現不佳。這種分歧正說明了「能載入」與「好用」不能混為一談。可參考 r/LLM 的真實使用者討論。
24GB 顯示卡是舒適使用 4-bit 工作流程的門檻,不保證你能舒服地跑長上下文。一份以部署為重點的評估估計,4-bit 的總記憶體需求約為 17–19GB,但也提醒,長時間 Agent 工作階段的 KV Cache 會快速膨脹。Neoteric 的本地部署分析適合用來規劃,不應視為官方硬體規格。
預設設定為何會讓 Qwen3.8-27B 看起來難以使用
Qwen3.8-27B 預設會啟用思考模式。官方模型卡提供的 reasoning_effort 包含 xhigh、medium 與 low,也可透過 enable_thinking=False 提出不思考請求;此外,preserve_thinking 也預設開啟。Qwen 的最佳實務章節提醒,降低推理強度不一定能縮短完整任務時間,但把高強度當成處理瑣碎工作時的預設,成本依然很高。
Simon Willison 的本地測試很能說明差異。他在 LM Studio 執行 Q4_K_M 版本時,第一個 SVG 任務採用預設設定,使用了 22,276 個推理 Token,花了 21 分鐘;關閉推理後,則在 137 秒內得到不同的結果。他的測試環境不能當成通用基準,但確實讓設定風險變得具體。閱讀完整測試與對話紀錄。
「我原本以為它大概會和 3.6 35b 同級,只是因為重度量化而比較慢;結果它在各方面都直接輾壓。」u/AltruisticList6000, r/LocalLLaMA,分享其 16GB RTX 4060 Ti 的 Q3 實驗結果。
這個正面案例並沒有消除取捨。另一份真實使用者回報提到,32K 上下文有限,Agent 工作階段也變得不穩定;另有人建議,本地程式工作應使用清楚、原子化的指令。工作流程討論在此。
Qwen3.8-27B 官方提供了哪些能力
Qwen3.8-27B 是 Dense 的原生視覺語言模型,不是 MoE 模型。官方模型卡列出它支援文字、影像與影片輸入,具備 64 層、5,120 隱藏維度、262,144 個原生上下文 Token,以及 Apache-2.0 授權。文件也記載可透過 YaRN 擴展至 1M Token,但明確警告靜態 YaRN 可能傷害短文字效能。官方規格與上下文說明應優先於第三方發布摘要。
官方儲存庫列出 Transformers、vLLM、SGLang、TokenSpeed,以及 llama.cpp、Ollama、LM Studio 等量化本地路徑。推論器支援相當重要,因為這個模型採用混合式 Gated DeltaNet 與 Gated Attention 架構;在判斷模型是否故障前,先更新推論器。Qwen 的快速入門儲存庫提供了 OpenAI 相容服務的範例。
官方基準成績能證明什麼,不能證明什麼
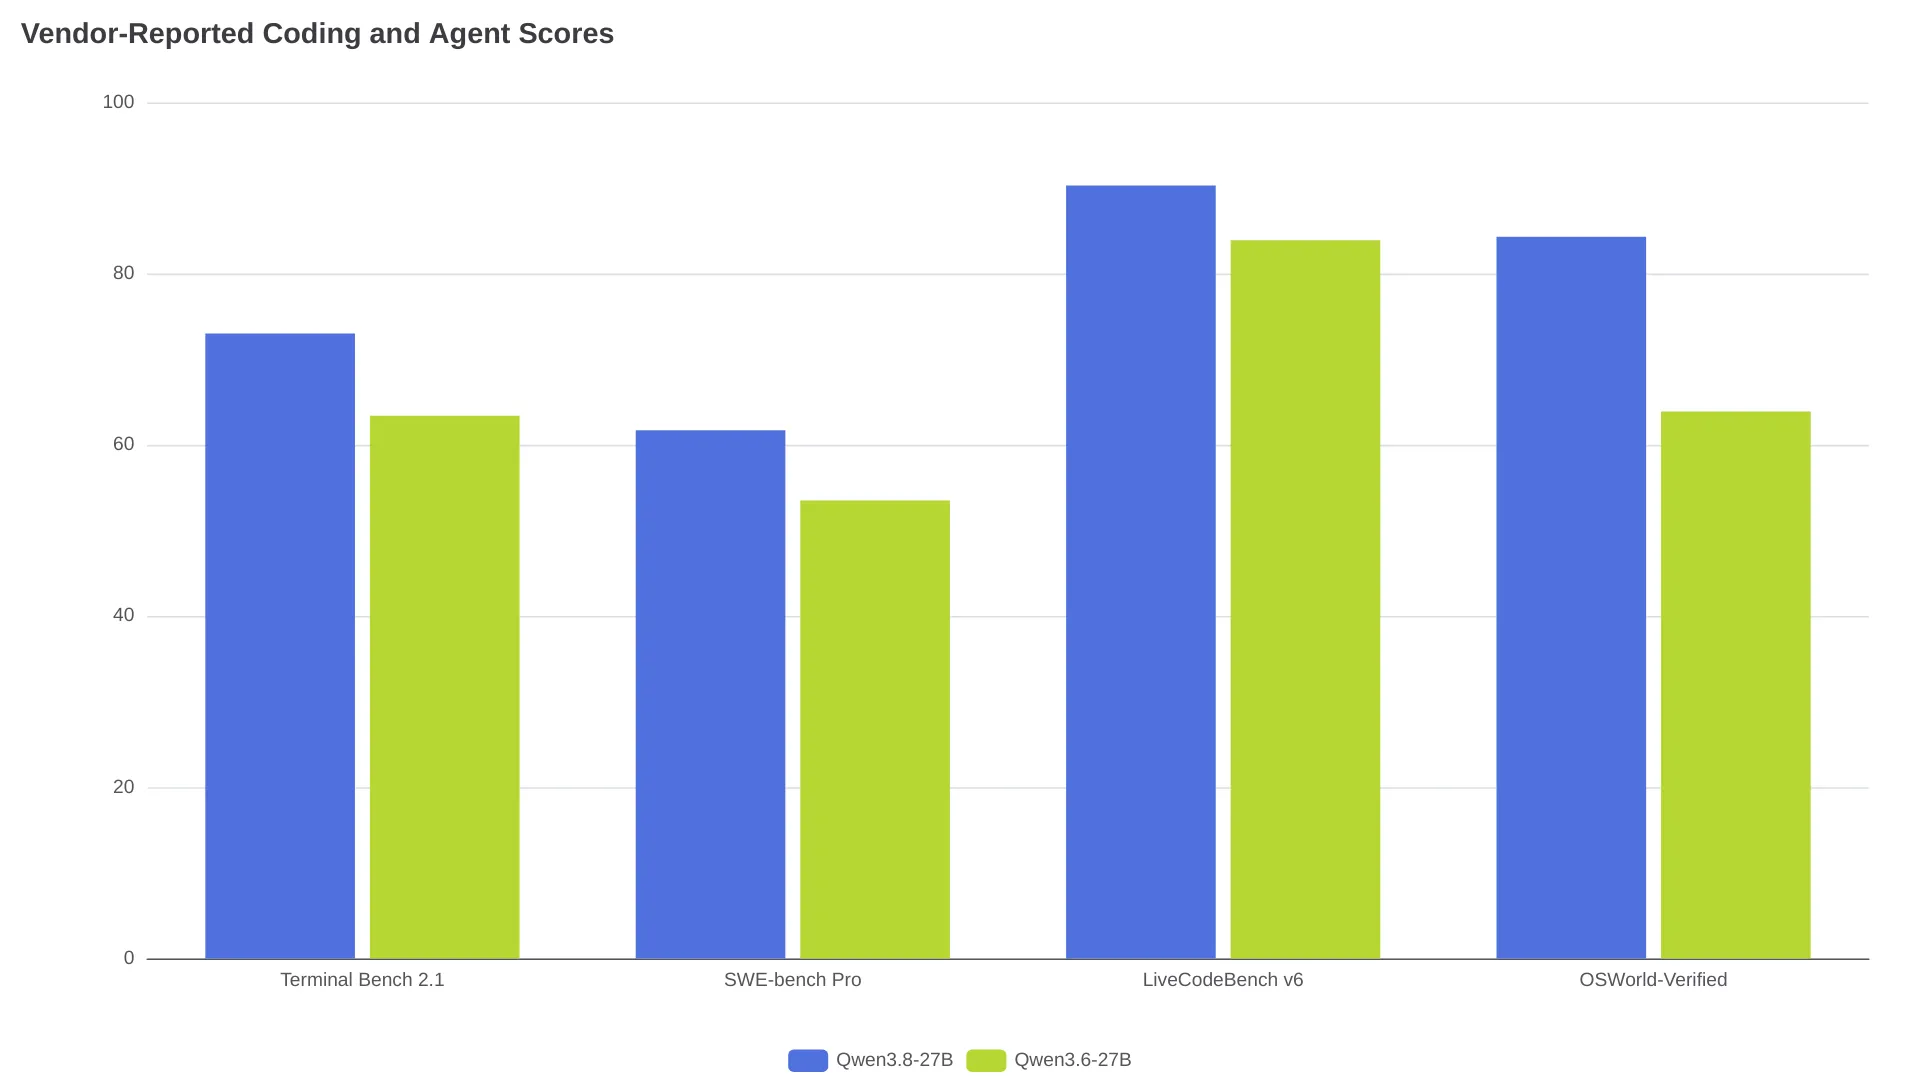
Qwen 表示,Qwen3.8-27B 在程式開發與電腦操作評測上,相較 Qwen3.6-27B 有明顯進步。圖表中的四項分數來自官方模型卡,是廠商自行公布的結果,並非獨立重現的成績。
| 官方基準測試 | Qwen3.8-27B | Qwen3.6-27B | 可參考的意義 |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Agent 終端機程式能力訊號 |
| SWE-bench Pro | 61.7 | 53.5 | 程式庫 Issue 解決能力訊號 |
| LiveCodeBench v6 | 90.3 | 83.9 | 程式能力評測訊號 |
| OSWorld-Verified | 84.3 | 63.9 | 電腦操作能力訊號 |
模型卡公開了完整比較與測試方法。針對 SWE-bench Pro 與 DeepSWE 1.1,Qwen 表示使用 Claude Code harness,設定為 temperature=1.0、top_p=0.95 與 256K 上下文,另也納入 QwenSWEBench 等內部基準。比較模型前,先檢視測試方法。這些數字支持「Qwen3.8-27B 是相對 Qwen3.6-27B 的顯著官方升級」,但不等於「它已證實可全面取代前沿 API」。
一套合理的本地初始配置
第一次本地部署,應優先追求可預期的行為,而不是把推理強度拉到最高。使用最新版推論器,在 24GB 級硬體上從 Q4 級量化開始,刻意設定保守的上下文上限,並先以短 Agent 任務測試,再開放長時間自主迴圈。
- 以 vLLM 或 SGLang 等支援的引擎啟動 OpenAI 相容伺服器。Qwen 提供的範例使用
Qwen/Qwen3.8-27B、--reasoning-parser qwen3與--tool-call-parser qwen3_coder。官方指令位於儲存庫中。 - 對日常分類、資料擷取或快速程式修改,設定
enable_thinking=False。Qwen 建議不思考模式使用temperature=0.7、top_p=0.80與presence_penalty=1.5。請見官方 API 範例。 - 若是需要大量推理的除錯任務,先嘗試
low或medium,再考慮xhigh,並以真實任務比較總完成時間與工具呼叫品質。 - 當每項任務彼此獨立時,關閉保留思考內容。只有多輪推理上下文的價值足以抵銷額外 KV Cache 壓力時,才保留它。
- 在無人看管的情況下使用前,先測試工具呼叫、輸出格式遵循度與上下文輪替。單次提示能寫出好程式碼的模型,仍可能在長時間 Agent 迴圈中失敗。
哪些情況不該選 Qwen3.8-27B 作為本地模型
當 12GB 或更低是硬性上限、回應延遲比本地控制更重要,或 Agent 必須在嚴格格式要求下無人看管地執行時,Qwen3.8-27B 都不是首選。它可以在受限環境中跑起來,但這不代表能提供可靠的互動吞吐量,或容納程式庫工作的足夠上下文。
獨立測試也發現,它傾向產生較長輸出、尾端延遲偏高,且未必能完美遵循嚴格指令。一項結構化評估在其工作站設定中記錄到 49 項測試有 4 次逾時,P95 回應時間為 143.32 秒。這些數字不是可移植的效能保證,但足以提醒我們:本地 27B 模型不該被當成無需審查的自動化元件。CrucibleMark 的測試報告提供了設定與限制說明。
Qwen3.8-27B 常見問題
Qwen3.8-27B 已經正式發布了嗎?
是。Qwen 官方儲存庫列出 Qwen3.8-27B 於 2026 年 8 月 14 日在 Hugging Face Hub 與 ModelScope 發布。Qwen 的發布時間線是主要來源。
Qwen3.8-27B 能在 16GB GPU 上運行嗎?
使用高度量化且上下文較短的配置可以運行,但這屬於受限部署。真實使用者回報從 16GB RTX 4060 Ti 上令人期待的 Q3 結果,到低 VRAM 執行 Dense Agent 時速度與品質大幅取捨的警告都有。LocalLLaMA 討論串。
Qwen3.8-27B 有 1M Token 的上下文視窗嗎?
它的原生上下文為 262,144 Token。模型卡描述可透過 YaRN/RoPE 縮放達到 1M 上下文,並提醒靜態 YaRN 可能降低短文字效能。官方上下文文件。
如何關閉 Qwen3.8-27B 的思考模式?
依照 Qwen 模型卡的示範,在 API 請求中設定 enable_thinking=False。若任務確實需要推理,應先從 low 或 medium 開始,而不是直接假定 xhigh 適合。官方不思考模式範例。
Qwen3.6-27B 使用者該升級嗎?
如果既有硬體已能運行相同級別的部署,且工作負載能受益於程式開發、電腦操作或多模態提升,值得升級。若目前堆疊穩定,而新的推論器、量化方式或推理行為尚未在實際工作流程驗證,則可繼續使用 Qwen3.6-27B。
依照你無法改變的限制來選
| 限制條件 | 下一步建議 |
|---|---|
| 重視本地資料處理,且有 24GB 可用 | 以 Q4 運行 Qwen3.8-27B,從低推理強度或不思考模式開始 |
| 只有 12GB 到 16GB | 針對有人監督的短任務測試 Q3 類版本,或直接選更小模型 |
| 長時間程式庫 Agent 工作階段 | 預留 32GB+ 空間,採用前先驗證 KV Cache 行為 |
| 需要快速互動回應 | 使用託管 API 或更小的本地模型 |
| 無人看管且格式或發布要求嚴格 | 保留驗證層與人工審核;不要只依賴模型自行遵循規則 |
Qwen3.8-27B 擴大了可在本地部署的 27B 模型能嘗試的範圍,但它沒有消除系統層面的工作:依硬體選量化、主動控制推理模式,並以具代表性的工作流程評估模型,而不是只看下載檔大小。