 AIREITER
MuseTalk 可以在 4 GB 筆電 GPU 上執行,但「跑得動」和「快到能用」是兩回事。官方 README 記錄了 RTX 3050 Ti Laptop 以 FP16 處理 8 秒影片約需 5 分鐘。這個差距,正是評估 MuseTalk 唇形同步時最該先問的問題;而且它不只影響速度,也會一路延伸到輸出解析度、安裝流程,以及下方的成本比較。
MuseTalk 會改動影片哪些地方?哪些內容完全不碰?
MuseTalk 會重繪現有影片中的嘴巴與下半臉,讓嘴唇配合指定的音訊。頭部位置、眼睛動作、臉部表情、背景和鏡頭運動都不會重新生成,而是沿用原始影片內容。換句話說,它是局部修補工具,不是完整的 talking-head 生成器;你必須先準備一段臉部清楚可見的影片。
它之所以能跑得快,關鍵在於架構。這套由 Tencent Music 旗下 Lyra Lab 發布的專案,先用凍結的 sd-vae-ft-mse VAE 編碼遮罩臉部,再用凍結的 Whisper-tiny 模型擷取音訊特徵,最後透過 cross-attention 將兩者融合到取自 Stable Diffusion v1.4 的 UNet。它採用單步潛在空間修補,而不是反覆去噪,因此作者宣稱能在 NVIDIA Tesla V100 上達到 30 fps 以上。
1080p 原始影片遇上 256x256 臉部區域,代表什麼?
256x256 指的是可編輯的臉部區域,不是最終輸出解析度。你的 1080p 影片仍會以原本的解析度和幀率輸出,只是嘴巴附近會先生成一個 256x256 的區塊,再融合回畫面。因此,臉在畫面中越小,結果通常越自然;如果是非常近的特寫,周圍清晰的臉部細節就更容易把修補區域的柔化感凸顯出來。
有兩種補救方式,但都要付出代價。移除 --use_float16 可以提升畫質,代價是需要更多 VRAM,也會延長處理時間。完成輸出後再使用 GFPGAN 或 CodeFormer 臉部修復,則能讓嘴部區域更銳利,但會多一道處理流程,還可能輕微改變人物外觀。
用數字看畫質:MuseTalk 贏在哪裡,Wav2Lip 又強在哪裡?
MuseTalk 的主要優勢是影像品質,而不是純粹的同步準確度。在 HDTF 資料集上,MuseTalk 技術報告給出的 FID 為 6.43,優於 DI-Net 的 7.27、VideoRetalking 的 10.93,以及 Wav2Lip 的 11.21。
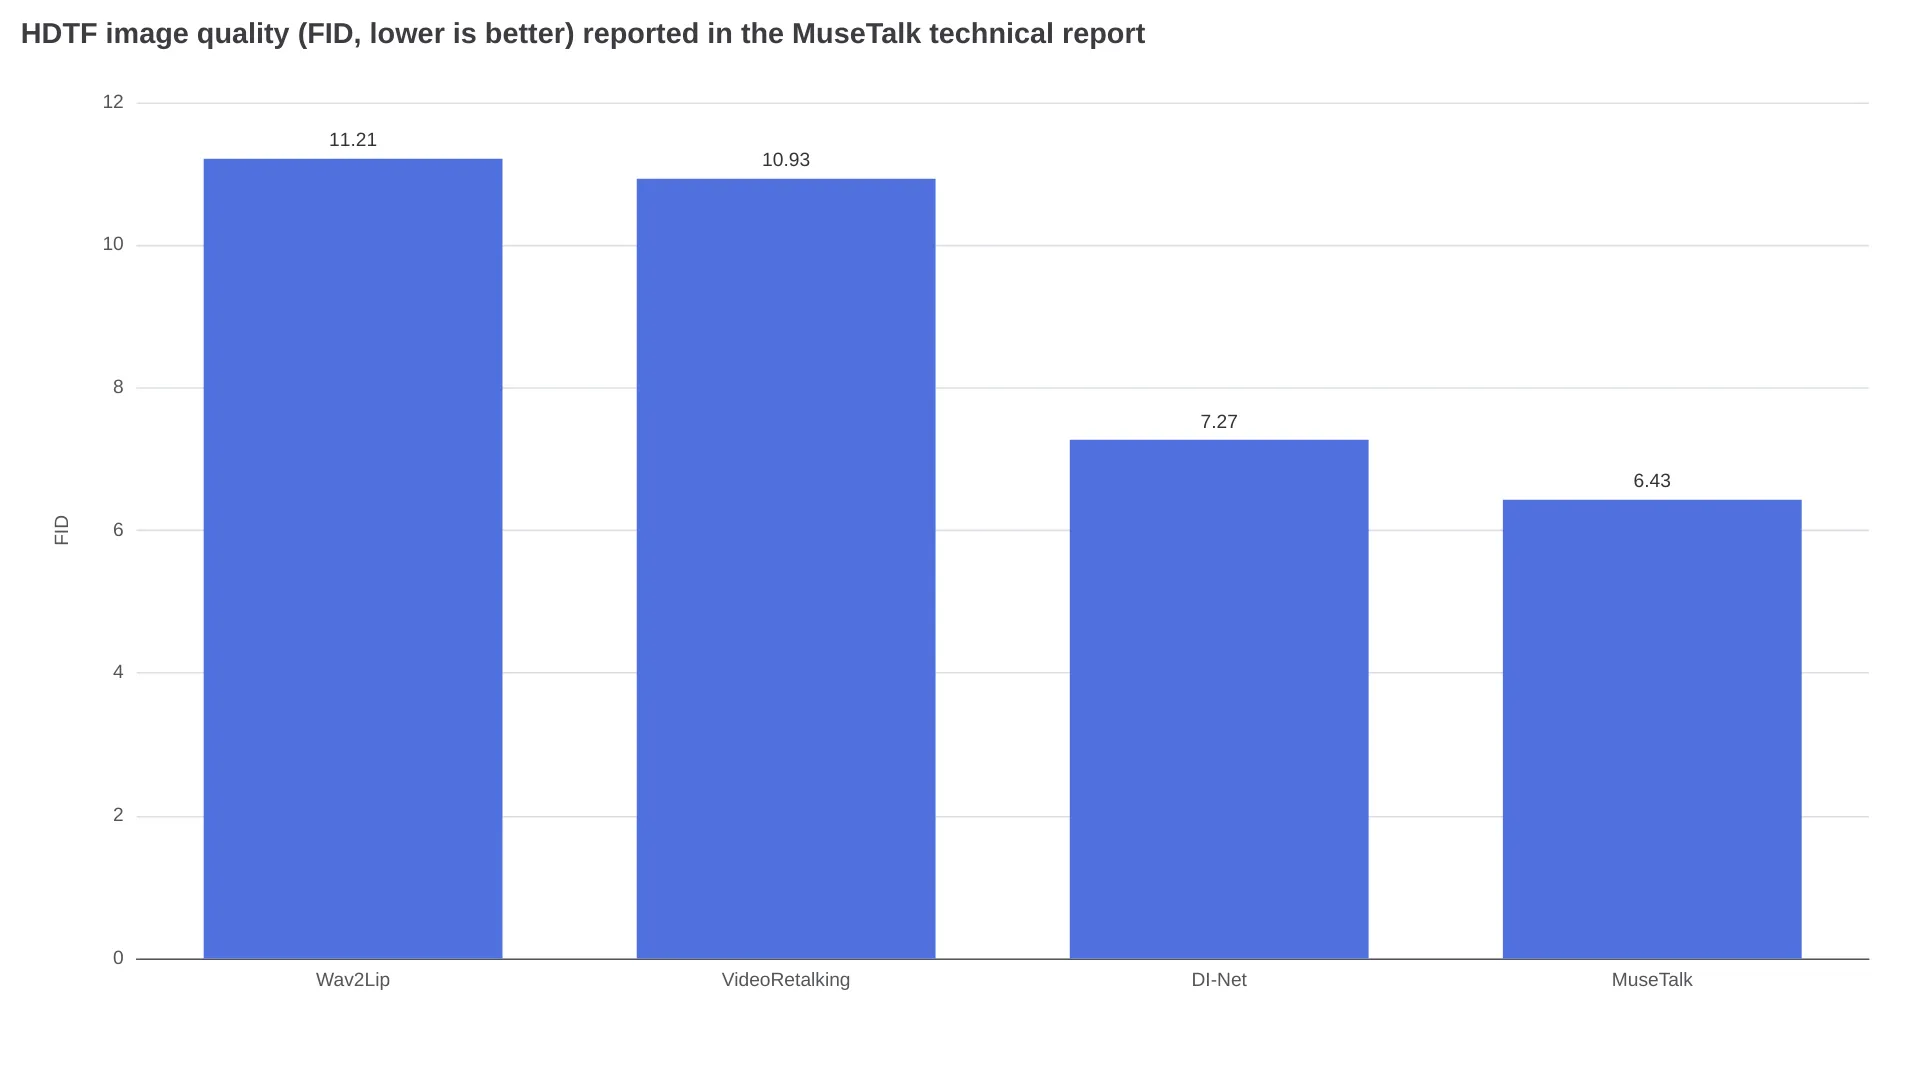
但換成同步指標,排名就不一樣了。同一份報告中,Wav2Lip 的 LSE-C 為 7.46,MuseTalk 則是 6.53;另一方面,MuseTalk 的身份相似度略高,CSIM 為 0.8225,Wav2Lip 為 0.8184。簡單說,較舊的 GAN 模型在嘴唇追蹤上更好,MuseTalk 則有更好的影像保真度。報告自己的使用者研究結果則相當中規中矩:視覺品質 5 分中得 3.62 分、身份一致性 3.55 分、唇形同步 3.41 分。
把這些數據放回 256x256 的限制來看,MuseTalk 更適合做出有說服力的中景畫面,而不是經得起 4K 大特寫檢視的成果。
唇形同步每分鐘要花多少錢?
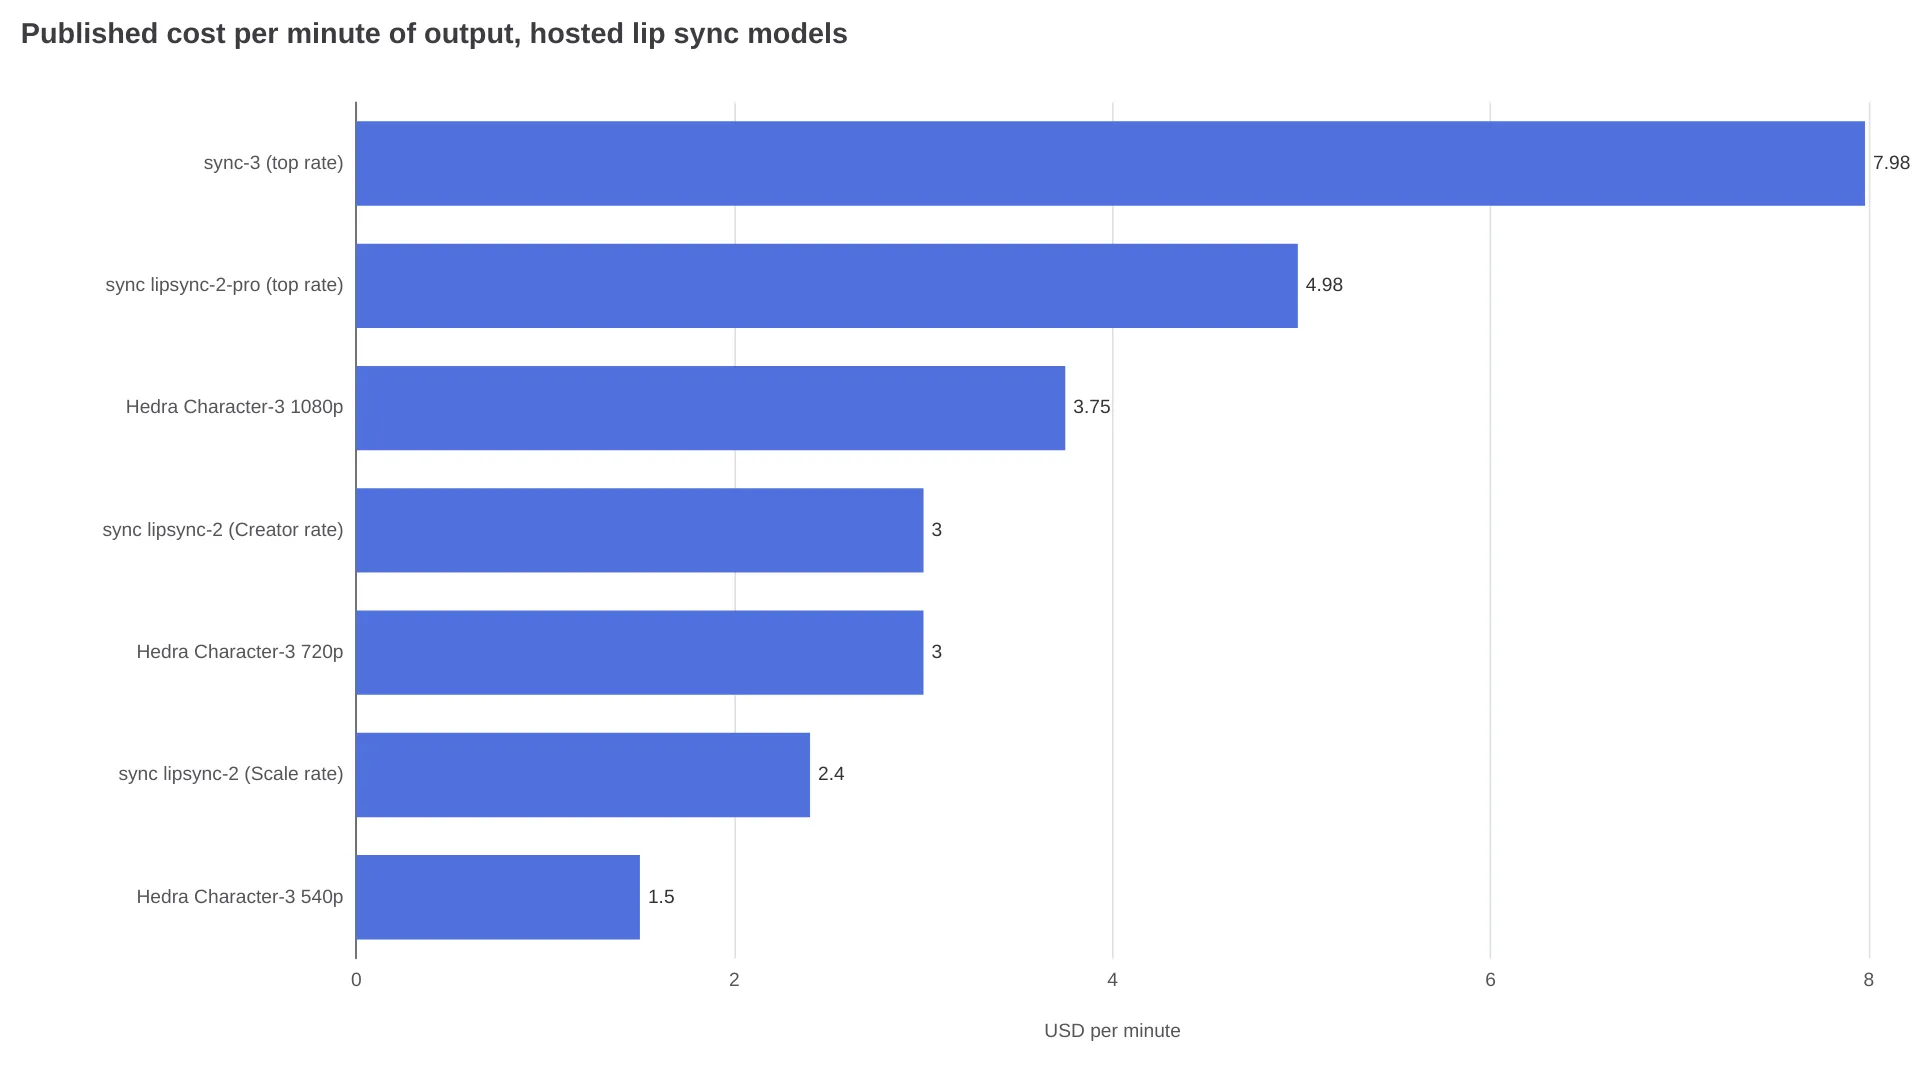
開源方案真正有吸引力的地方,就在這裡。公開的託管唇形同步模型價格,從每分鐘 $1.50 一直到接近 $8.00 不等。
| 方案 | 公開價格(計費單位不同) | 每分鐘輸出成本 | 臉部解析度 |
|---|---|---|---|
| MuseTalk 自行架設,租用 Tesla V100 | $0.188 / GPU 小時 | 以每分鐘影片需 2 GPU 分鐘計算,約 $0.006 | 256x256 |
| Replicate 上的 MuseTalk | 約 $0.052 / 次執行;模型頁面標示典型執行時間為 54 秒 | 按次執行計費,不是按分鐘 | 256x256 |
| fal.ai 上的 MuseTalk | 按計算秒數計費 | 模型頁面未公布 | 256x256 |
| Hedra Character-3 540p / 720p / 1080p——影像生成影片,不是可直接套用在現有影片上的方案 | 每秒 2.5¢ / 5¢ / 6.25¢ | $1.50 / $3.00 / $3.75 | 不適用 |
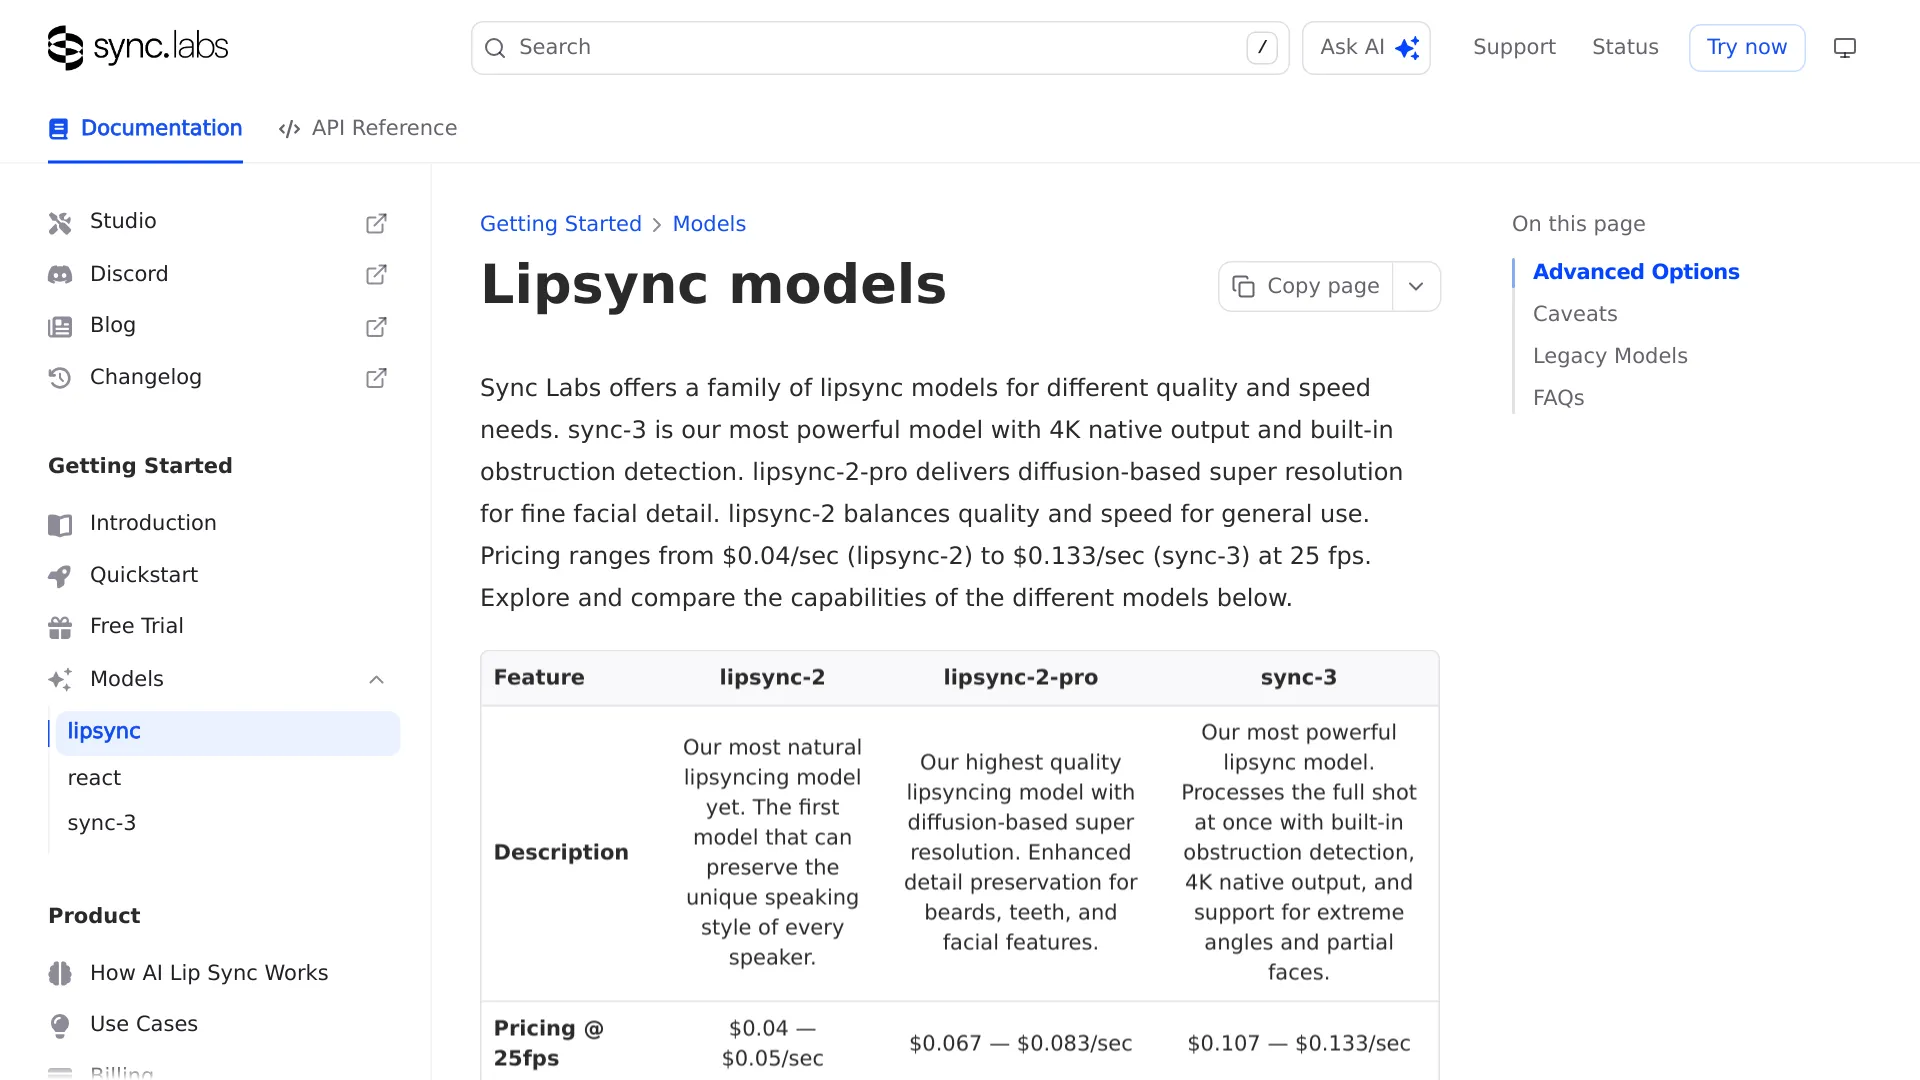
| sync lipsync-2 | 25 fps 下每秒 $0.04–0.05 | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | 每秒 $0.067–0.083 | $4.02–$4.98 | 512x512 + 細節處理 |
| sync-3 | 每秒 $0.107–0.133 | $6.42–$7.98 | 原生 4K |
自行架設的數字來自 NexGPU 的成本分析。它以每 1 分鐘影片需要 2 分鐘完整 GPU 時間估算,包含推論、DWPose 偵測、VAE 編碼/解碼和 FFmpeg 封裝。以每小時 $0.188 的 V100 計算,處理 100 段 1 分鐘影片,GPU 成本約為 $0.63,另外約需 $0.09 的設定時間成本。這些只計算 GPU 租用費,不包含工程時間、儲存空間和營運負擔。
把規模放大到在地化製作,差距會很快拉開。若要處理 500 分鐘配音影片,透過自行架設的 MuseTalk 租用 GPU,成本約為 $3;以 Creator 價格使用 sync lipsync-2,則約為 $1,200。
免費方案從哪裡開始不再免費?
你付出的每分鐘溢價,主要買到的是以下幾件事:
- 臉部生成解析度。根據 sync 的模型文件,lipsync-2 和 lipsync-2-pro 會以 512x512 生成臉部,區域是 MuseTalk 的兩倍;sync-3 則原生輸出 4K,並內建超解析度。
- 更難處理的鏡頭。同一份文件指出,sync-3 原生支援側臉、越肩構圖和部分臉部畫面,還會自動偵測遮擋物。MuseTalk 則是逐幀進行臉部偵測,因此人物轉頭或手遮住嘴巴,都是已知的失敗情境。
- 多人影片。sync 目前三個模型都列有主講者偵測選項;MuseTalk 沒有對應的參數。
- 設定時間。自行架設只需付出一次,但這個代價並不小。
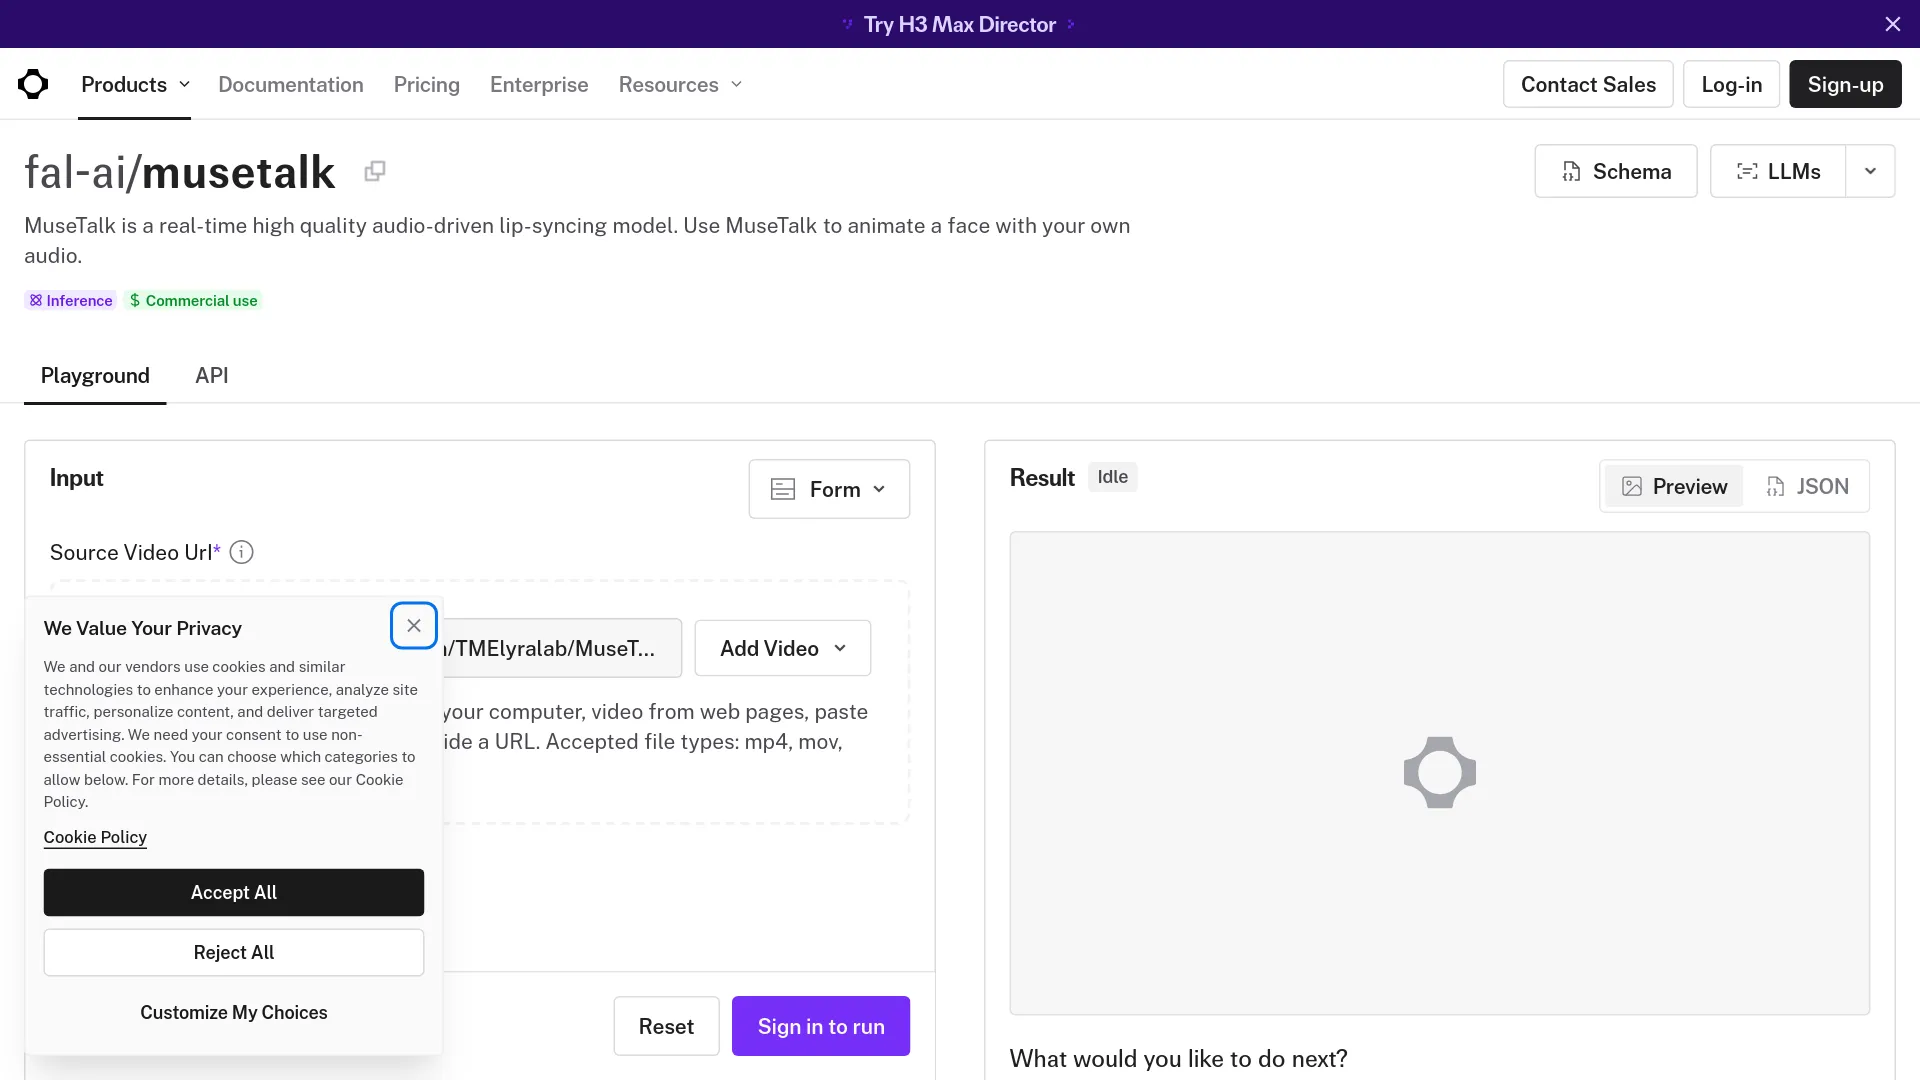
fal.ai 的 MuseTalk 頁面正好說明了你為最後一項付費後能得到什麼:只要提供來源影片 URL 和音訊 URL,沒有其他要求。不用建立 conda 環境、不用處理 CUDA 版本,也不用準備權重目錄。
如何在不被依賴套件折磨的情況下跑起 MuseTalk?
實際跑過這套模型的人,反覆抱怨的往往不是輸出品質,而是 OpenMMLab 套件堆疊。在 r/StableDiffusion 上,一名同時測試 MuseTalk 和 LatentSync、比較兩者唇形同步效果的使用者直白地說:
「LatentSync 和 MuseTalk 都能運作,效能也差不多……MuseTalk 很難設定,因為它依賴 OpenMMLab 函式庫。」—— u/Traditional_Tap1708,r/StableDiffusion
README 指定的版本要透過 mim 安裝,不要直接用 pip:
- 在全新的 conda 環境使用 Python 3.10,並安裝 PyTorch 2.0.1、torchvision 0.15.2 和 torchaudio 2.0.2。
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0"。mmcv 太新,是 mmdet 匯入失敗最常見的原因。- 把 FFmpeg 加到
PATH,再用ffmpeg -version確認;Windows 也可以透過--ffmpeg_path明確指定路徑。 - 執行
sh download_weights.sh下載完整權重樹。只有 UNet 並不夠;這個腳本還會下載 sd-vae-ft-mse、Whisper、DWPose 的dw-ll_ucoco_384.pth和 BiSeNet 臉部分割權重。缺少檔案時,往往會以臉部偵測或融合失敗的形式出現,而不是清楚的錯誤訊息。 - 用
ffmpeg -i input.mp4 -r 25 output.mp4將來源影片轉成 25 fps。專案建議輸入使用 25 fps,因為模型就是以這個幀率訓練;幀率不一致通常是時間逐漸偏移的主要原因。 - 在
configs/inference/test.yaml中指定影片和音訊,接著執行python -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15。
如果要讓同一張臉反覆生成不同音訊,先在 configs/inference/realtime.yaml 將 preparation: true 設定一次,讓程式在 results/v15/avatars/ 下快取 coords.pkl、latents.pt 和遮罩集合,之後再改回 false。加上 --skip_save_images 的效果比想像中更重要:把 PNG 寫入磁碟,可能會讓儲存速度取代模型本身,成為整個流程的瓶頸。
MuseTalk 1.5 還是 1.0:該下載哪一套權重?
選 1.5。專案將它列為最新版本,發布日期是 2025 年 3 月 28 日,並表示透過感知損失、GAN 損失、同步損失,以及兩階段訓練,改善了清晰度、身份一致性和唇形與語音的對齊。
保留 1.0 的唯一理由,是 bbox_shift 只適用於這個版本。它可以垂直移動遮罩邊界:正值會讓嘴巴張得更大,負值則會讓嘴巴閉得更小。
先用預設值執行一次,腳本會列出這段影片可調整的範圍。README 的操作範例得到 [-9, 9],最後選擇 -7。之後在你實際取得的範圍內重新渲染:嘴巴看起來太誇張就往負值調,幾乎張不開則往正值調。
你會遇到哪些失敗情況?哪些可以靠調參解決?
| 現象 | 原因 | 能修正嗎? |
|---|---|---|
| 執行中止,找不到臉 | 其中一幀的人臉轉向、被遮住或消失 | 可以。裁切或刪除出問題的片段 |
| 嘴巴幾乎不動 | 音訊被音樂蓋過,或遮罩邊界設得太高 | 可以。分離人聲;v1.0 使用正值 bbox_shift |
| 影片中途嘴唇逐漸不同步 | 來源影片不是 25 fps | 可以。處理前先轉檔 |
| 嘴巴相對清晰的臉部顯得模糊 | 臉在畫面中太小,256x256 區域不足以保留細節 | 部分可以。裁切得更近、停用 fp16,並加入臉部修復 |
| 看得見接縫,鬍鬚沒有保留 | 下半臉合成會取代身份細節 | 不行。這是模型本身的限制 |
| 畫面逐幀抖動 | 每一幀都是獨立生成 | 部分可以。專案表示 v1.5 的兩階段訓練改善了一致性 |
| 卡通或風格化臉部失敗 | 訓練資料以真人臉為主 | 不行 |
| 充滿情緒的音訊搭配表情靜止的講者 | MuseTalk 不會處理頭部動作或表情 | 不行。重新拍攝或更換來源影片 |
一名進行低 VRAM 測試的使用者回報,MuseTalk「7 秒音訊要跑 171 秒」,並補充它「只適用於寫實影像」(u/Bartholomheow,r/StableDiffusion)。至於「即時」這個說法,指的是完成 avatar 準備後的持續處理吞吐量,不是從頭到尾的延遲。一名在 r/LocalLLaMA 開發 talking head 的開發者則表示,對他們的互動式使用情境來說,MuseTalk「準備時間太長」(u/lonyPorgrammer)。
哪一條唇形同步路線適合你的工作?
| 方案 | 適合在什麼情況使用 | 主要取捨 |
|---|---|---|
| 自行架設 MuseTalk | 高產量、條件理想的影片:在地化草稿、同一張臉搭配數千段音訊的互動 avatar、內部培訓影片 | 設定時間以小時計,不是以分鐘計;處理吞吐量取決於你租用的 GPU |
| 託管 MuseTalk(Replicate、fal.ai) | 只需處理少量影片,或想先用自己的素材測試品質,再決定是否部署 | 同樣受限於 256x256,兩個端點的 schema 都沒有 avatar 快取參數,並且按次執行計費 |
| 付費唇形同步模型(sync-3、lipsync-2-pro) | 面向客戶的輸出、大型特寫、側臉角度、遮擋、多位講者、4K 交付 | 每分鐘 $4–$8,而且影片會離開你的基礎架構 |
如果想重現官方的處理速度,租用 V100;如果要串流即時處理,則選 4090。至於託管端點的使用方式,我們在Replicate 評測和 fal.ai 評測中都有更深入的介紹。
MuseTalk 唇形同步 FAQ
MuseTalk 能在 6 GB 或 8 GB GPU 上執行嗎?
可以。README 記錄了在 4 GB RTX 3050 Ti 筆電 GPU 上以 FP16 測試的結果,因此基本推論可以在有限 VRAM 中完成。實際上更大的限制是處理速度。
256x256 就是輸出解析度嗎?
不是。它是可編輯的臉部區域,完成修補後會融合回保留原始解析度和幀率的影片。
MuseTalk 能處理卡通或動漫臉嗎?
不可靠。模型是以真人 talking-head 影片訓練,測試風格化輸入的使用者也回報結果不穩定。
「30 fps 即時」這個數字包含前處理嗎?
不包含。它描述的是 Tesla V100 在完成 avatar 準備後的生成吞吐量。臉部偵測、潛在表示編碼和第一次快取都會在此之前完成。
MuseTalk 還是 LatentSync?
如果專案重視延遲和產量,可以優先考慮 MuseTalk,因為單步推論和 avatar 快取能削減大部分每段影片的成本。前面提到的那位同時測試兩者的 r/StableDiffusion 使用者認為兩者效能相近,因此真正的決勝點會是吞吐量,而不是畫質。
MuseTalk 可以商用嗎?
專案程式碼採用 MIT 授權,但整條依賴鏈的授權並不一致。Whisper、VAE、DWPose、BiSeNet 臉部分割和 SyncNet 都各自採用不同條款,專案也標示了範例資料的額外限制。正式上線前,請逐一確認。
這個價位仍未解決的取捨
MuseTalk 幾乎不用花錢,就能讓你完成大部分工作。但它處理不了的是身份細節在高要求情境下的穩定性:鬍鬚、精確的唇形、填滿畫面的臉,以及說話途中轉頭的講者。
對多數團隊來說,答案不會是只選一個工具,而是讓 MuseTalk 負責大量產出,再用付費模型處理那些會以全螢幕呈現的鏡頭。
延伸閱讀
- Higgsfield AI 評測、價格與 API 存取比較
- Kokoro 82M TTS 本機設定指南,用來生成 MuseTalk 所需的音訊軌
- Wan 2.2 Animate 使用指南