 AIREITER
只寫一句「電影感畫面」描述,等於把所有空白都交給模型自行腦補。沒交代鏡頭,官方提示文件指出,成片通常會變成固定機位;聲音欄位沒有明確限制,也可能憑空冒出不想要的台詞或配樂。MiniMax H3 真正有效的寫法,更像一份精簡的拍攝腳本:官方指南定義了固定的三欄格式、鏡頭時間戳、穩定的說話者 ID,以及兩個獨立的聲音欄位。整份腳本還必須塞進約 7,000 字元的 prompt 預算內(視供應商而定),影片最長則為 15 秒。
先選對格式:H3 有兩份指南、四種基礎模式
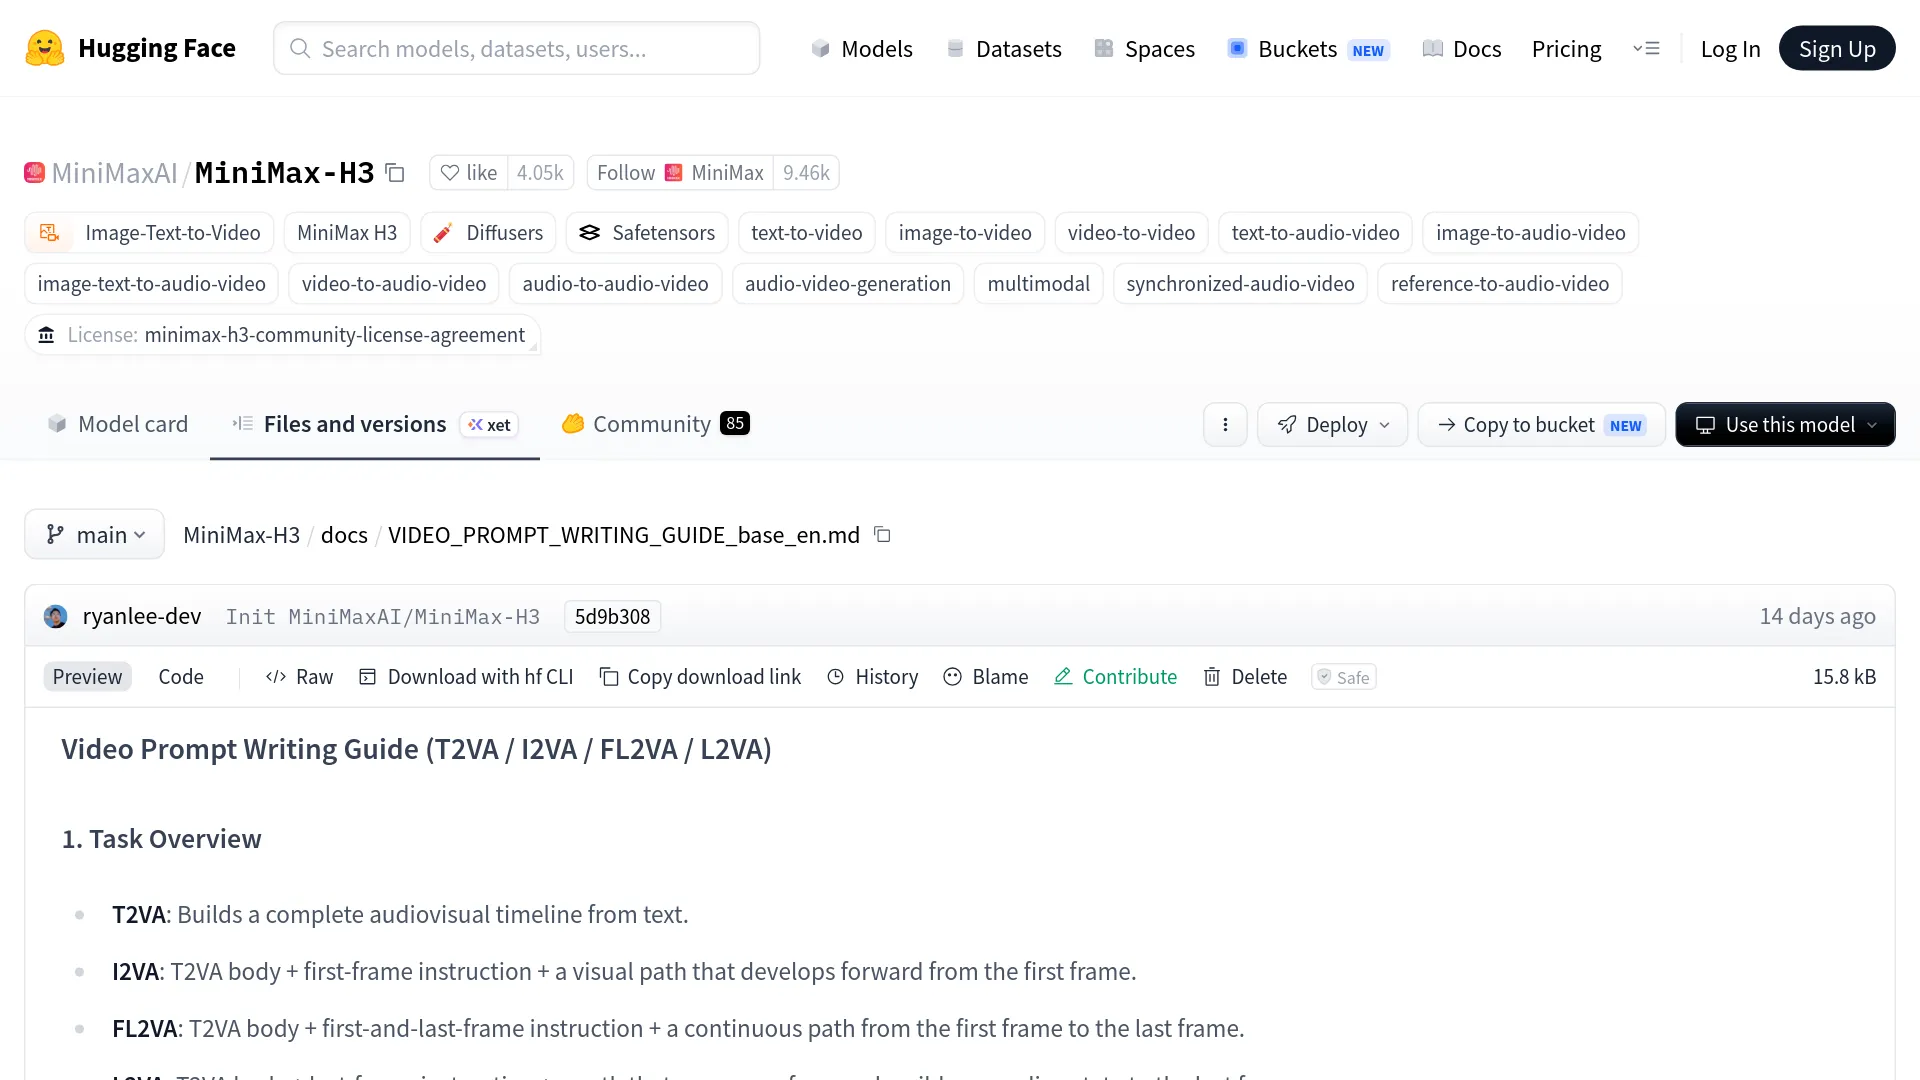
MiniMax 在 Hugging Face 的 MiniMax-H3 repository 中提供兩份獨立的 prompt 撰寫指南,對應不同工作流程。base guide 用於沒有上傳任何參考素材的四種生成任務;只要圖片、影片或音訊素材會參與生成,就應改用 reference guide。四種 base 任務與模式如下:
| 模式 | 輸入內容 | prompt 中必須加入的對齊指令 |
|---|---|---|
| T2VA | 純文字 | 不需要,直接從核心欄位開始 |
| I2VA | 一張首幀圖片 | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | 首幀加尾幀 | Picture 1 放在 0.00 秒,Picture 2 放在精確的結束時間 |
| L2VA | 一張尾幀圖片 | Picture 1 對齊影片結束時間與最後一個鏡頭 |
兩份指南最後都附有完整案例;MiniMax 發布文章對模型的定位也一致:重點不是從選單挑任務,而是描述文字、圖片、影片與音訊輸入之間的關係。託管端點通常把它簡化成三種工作流程(fal 上的 minimax/h3/text-to-video、image-to-video 與 reference-to-video),但底層 prompt 結構並沒有改變。
Base Prompt 的三個必填欄位
Base 模式的 MiniMax H3 prompt,在對齊指令後必須有剛好三個欄位,欄位之間以空白行分隔。基本骨架如下:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_description是時間軸主體:視覺風格、構圖、動作、鏡頭切換、說話者、對話與畫內聲音都寫在這裡,也就是一切看得見或聽得見的內容。overall_soundscape用 1–4 句、單一段落概述環境音與物理聲響,不能放對話。non_diegetic_music描述只有觀眾聽得到的配樂,限 1–3 句;若沒有配樂,填入N/A。
以下是依照官方 T2VA 案例改寫的完整範例,場景設定為日出前的麵包店:
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
依官方規則,各段文字的控制作用如下:
| Prompt 元素 | 控制項目 | 規則 |
|---|---|---|
[Shot 1] Live-action, cinematic. | 整體風格 | 風格標籤從 Shot 1 開始;指南列出的範例包括(非完整清單):Cinematic、live-action、2D-animated、3D CG、claymation、watercolor、vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | 說話者身分 | 身分特徵要寫在 ID 前方,且 ID 必須跨鏡頭保持不變 |
The camera pushes in with small amplitude at slow speed | 鏡頭運動 | 以自然動作句描述移動類型、幅度與速度 |
<d>[English] First batch of the day.</d> | 對話 | 僅放語言標籤與逐字台詞,必須原文照錄,不能翻譯 |
At 00:05.000, the camera cuts to... | 切鏡時間 | 時間必須嚴格遞增;[Shot 1] 本身不會有時間戳 |
<scenetrans> continuing seamlessly across the cut | 聲音延續 | 標示對話跨越切鏡,必須在兩個銜接點都加入 |
鏡頭切換、時間戳與運鏡怎麼寫
MiniMax H3 的鏡頭語法以位置為準:[Shot 1] 不加時間戳,後續每個鏡頭都要以嚴格遞增的切鏡時間開頭,例如 At 00:03.500,。建議使用簡短的切鏡語句,例如「the camera cuts to」、「the shot transitions to」或「the shot switches to」。交叉淡化、淡入淡出與擦拭轉場,只有在你明確要求時才應出現。若只是構圖輕微變動,指南建議用運鏡而非切鏡,因為切鏡應帶入新的主體、空間、狀態或時間資訊。
鏡頭移動應寫成自然的英文動作,最多包含三個維度:移動類型、幅度與速度。
| 維度 | 可用表述 |
|---|---|
| 移動類型 | Zoom In/Out、Push In/Pull Out、Pan Left/Right、Truck Left/Right、Tilt Up/Down、Pedestal Up/Down、Arc Shot、Tracking Shot、Static Shot、Shake Slightly/Strongly、POV、Roll Clockwise/Counterclockwise |
| 幅度 | "with small amplitude"、"with large amplitude" |
| 速度 | "at slow speed"、"at fast speed" |
中等幅度與正常速度依慣例省略即可。也要注意兩者的意義不同:「Zoom In」是在固定位置改變焦距;「Push In」則是攝影機實際向前移動。指南刻意保留了這項區分。
對話格式與說話者標籤
MiniMax H3 prompt 中,每個有發聲的角色都需要穩定 ID,例如 (S1)、(S2);同步說話時可使用像 (S1,S2) 這樣的複合標籤,並且必須在每一個鏡頭中沿用相同 ID。從不說話的角色不需要 ID。角色第一次出現時,應盡量交代足以維持穩定生成的身分資訊:是否入鏡、年齡區間、性別、音高、音色、說話速度與口音。
單句的正確格式如下:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
官方文件列出四項規則,可避免最常見的失敗情況。身分、動作與說話方式都要放在 <d> 外面;<d> 裡只能包含語言標籤與逐字台詞,連標點也要保留。旁白必須使用固定字串「says in an off-screen voiceover」,並立刻補充畫面中角色的嘴唇保持閉合。對話跨切鏡時,要在兩個銜接點都加入 <scenetrans>,再使用「continues seamlessly across the cut」或「carries over from the previous shot」等延續語句。若台詞在影片結束前被截斷,則使用 <cutoff>。
引號只有一項保留用途:影片裡實際可見的文字,例如布條、招牌、標籤、霓虹字或字幕,必須以英文雙引號逐字寫出,且不可翻譯。把口語對白放進引號,正是官方記載會讓 H3 將其渲染成燒錄字幕、而非語音的原因。
兩個聲音欄位各自負責什麼
MiniMax 發布文章指出,H3 的所有音訊輸出都是隨影片原生生成的立體聲,因此聲音不是在描述裡隨手加幾個形容詞,而是有兩個專屬欄位。overall_soundscape 負責環境與物理聲音,例如風、雨、車流、腳步、衣料摩擦、撞擊、呼吸與笑聲,以 1–4 句描述;只有明確要求完全靜音時,才填 N/A。non_diegetic_music 則用來描述角色聽不見的配樂,可交代樂器、速度、節奏與動態變化;官方明確不建議使用「epic」、「emotional」這類抽象情緒詞。若完全不要配樂,正確值就是 N/A。
畫內音訊,例如唱歌、場景中的收音機或街頭樂手,不屬於這兩個欄位;它們應寫進掌管時間軸的 integrated_multimodal_description。這種拆分不只是形式問題:APIMODELS 的教學指出,想要穩定結果就必須明確限制聲音;若沒有指定 non_diegetic_music,模型可能加入你從未要求的配樂。
使用參考素材:標籤與保留規則
當上傳素材會引導生成時,就要改用 reference guide。它要求依固定順序寫出六個區段:subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_music。用於生成任務時,detailed_description 正文通常為 350–500 個英文單字;對話量大的 prompt,應優先容納完整口語時間線,即使因此偏離建議字數也沒關係。
核心由四種標籤分工:
| 標籤 | 用途 |
|---|---|
<Subject N> | 實際會出現在輸出中的可見內容:可從任何素材抽象出的角色、產品、場景、服裝、風格或動作 |
<Picture N> | 作為具體畫面錨點的圖片,例如首幀、關鍵幀、尾幀或構圖錨點 |
<Video N> | 整段影片層級的關係,例如剪輯來源、延續位置、運鏡或切鏡結構、節奏 |
<Audio N> | 被複製或參考的音訊訊號,例如聲音音色、歌詞、節拍或音效 |
每種標籤各自獨立編號,因此同一支上傳影片可以是 <Video 1>,而它的音軌則可標記為 <Audio 2>。會說話的主體要結合標籤與說話者 ID,例如 <Subject 3> (S1)。
summary 區段要以方括號任務前綴開頭,例如 [reference generation] 或 [video editing + audio reuse]。影片編輯任務必須以「The target video is an edited version of <Video 1>.」開頭。接著,retention_analysis 要為每個標籤指派一個保留標記:視覺素材可用 fully_preserved、partially_preserved、attribute_transfer 或 weak_reference;音訊則可用 fully_copy、partially_copy、reference 或 weak_reference。這些標記就是你告訴 H3「臉必須保留、服裝可以換掉」的方式。
以下是符合官方順序的最小 reference 模式骨架:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
H3 失常時怎麼修:症狀對照表
| 症狀 | 可能的 prompt 原因 | 修正方法 |
|---|---|---|
| 亂碼或虛構的「Sims-speak」 | 對話沒有結構、缺少說話者 ID,或未描述不說話角色 | 加入 (S1)/(S2) ID,以 <d>[Language] ...</d> 包住逐字台詞,並明確寫出安靜角色不說話 |
| 對話變成燒錄字幕 | 把口語台詞寫在引號中 | 引號僅保留給畫面可見文字;將對話移入 <d> 標籤 |
| 對話被分配給錯誤角色 | 說話者 ID 沒有連結至具體描述的人物 | 角色首次出現時交代身分特徵,例如年齡、是否入鏡與聲音;跨鏡頭維持相同 ID |
| 出現未要求的配樂或音樂 | non_diegetic_music 模糊或缺漏 | 不需要配樂時寫 non_diegetic_music: N/A;社群討論指出這是排除多餘音訊的有效做法 |
| 出現未規劃的切鏡 | 場景變化暗示了切鏡,但沒有時間戳 | 使用 [Shot N] At 00:03.500 與明確切鏡語句;單鏡到底時加上「no cuts」表述 |
| 人臉、服裝或產品外觀漂移 | 沒有宣告參考素材的角色 | 在 retention_analysis 為該標籤加入 fully_preserved,並在每次出現時重複該標籤 |
亂碼與字幕兩項直接來自官方語法規則;r/StableDiffusion 的社群討論也獨立回報相同修正方式在實作上有效,其中 non_diegetic_music: N/A 更是處理不必要音訊時最常被提及的方法之一。
限制條件與測試 prompt 的成本
生成範圍很重要,因為 prompt 長度有限,每一次迭代都會計費。以下整理官方 API 與託管供應商文件中的限制:
| 參數 | 數值 | 備註 |
|---|---|---|
| 影片長度 | 最長 15 秒,以整秒計 | fal/EvoLink 端點最短為 5 秒;部分 V2 API 文件列為 4 秒 |
| 解析度 | 768p 與 2K,24 FPS | 依 MiniMax 說法,2K 是預設輸出解析度 |
| 參考檔案 | 最多 9 張圖片、3 支影片、3 段音訊 | 合計 12 個檔案;音訊不能作為唯一參考素材 |
| Prompt 長度 | 約 7,000 字元 | fal 與 V2 API 文件如此記載;APIMODELS 列為 20,480,請以供應商為準 |
| 長寬比 | 21:9、16:9、4:3、1:1、3:4、9:16、adaptive | 圖生影片會依照輸入圖片的長寬比 |
價格會因供應商而變動,以下應視為特定時間點的快照,而不是牌價。在 fal,根據 8 月 1 日價格快照,2K 生成為每秒 $0.26(5 秒 $1.30、15 秒 $3.90);前五張參考圖片免費,額外圖片每張 $0.08。在 APIMODELS,H3 的費率是每秒 $0.088(15 秒影片為 $1.32),且只對成功請求收費。作為參考,以下為同一市集上的每秒價格:
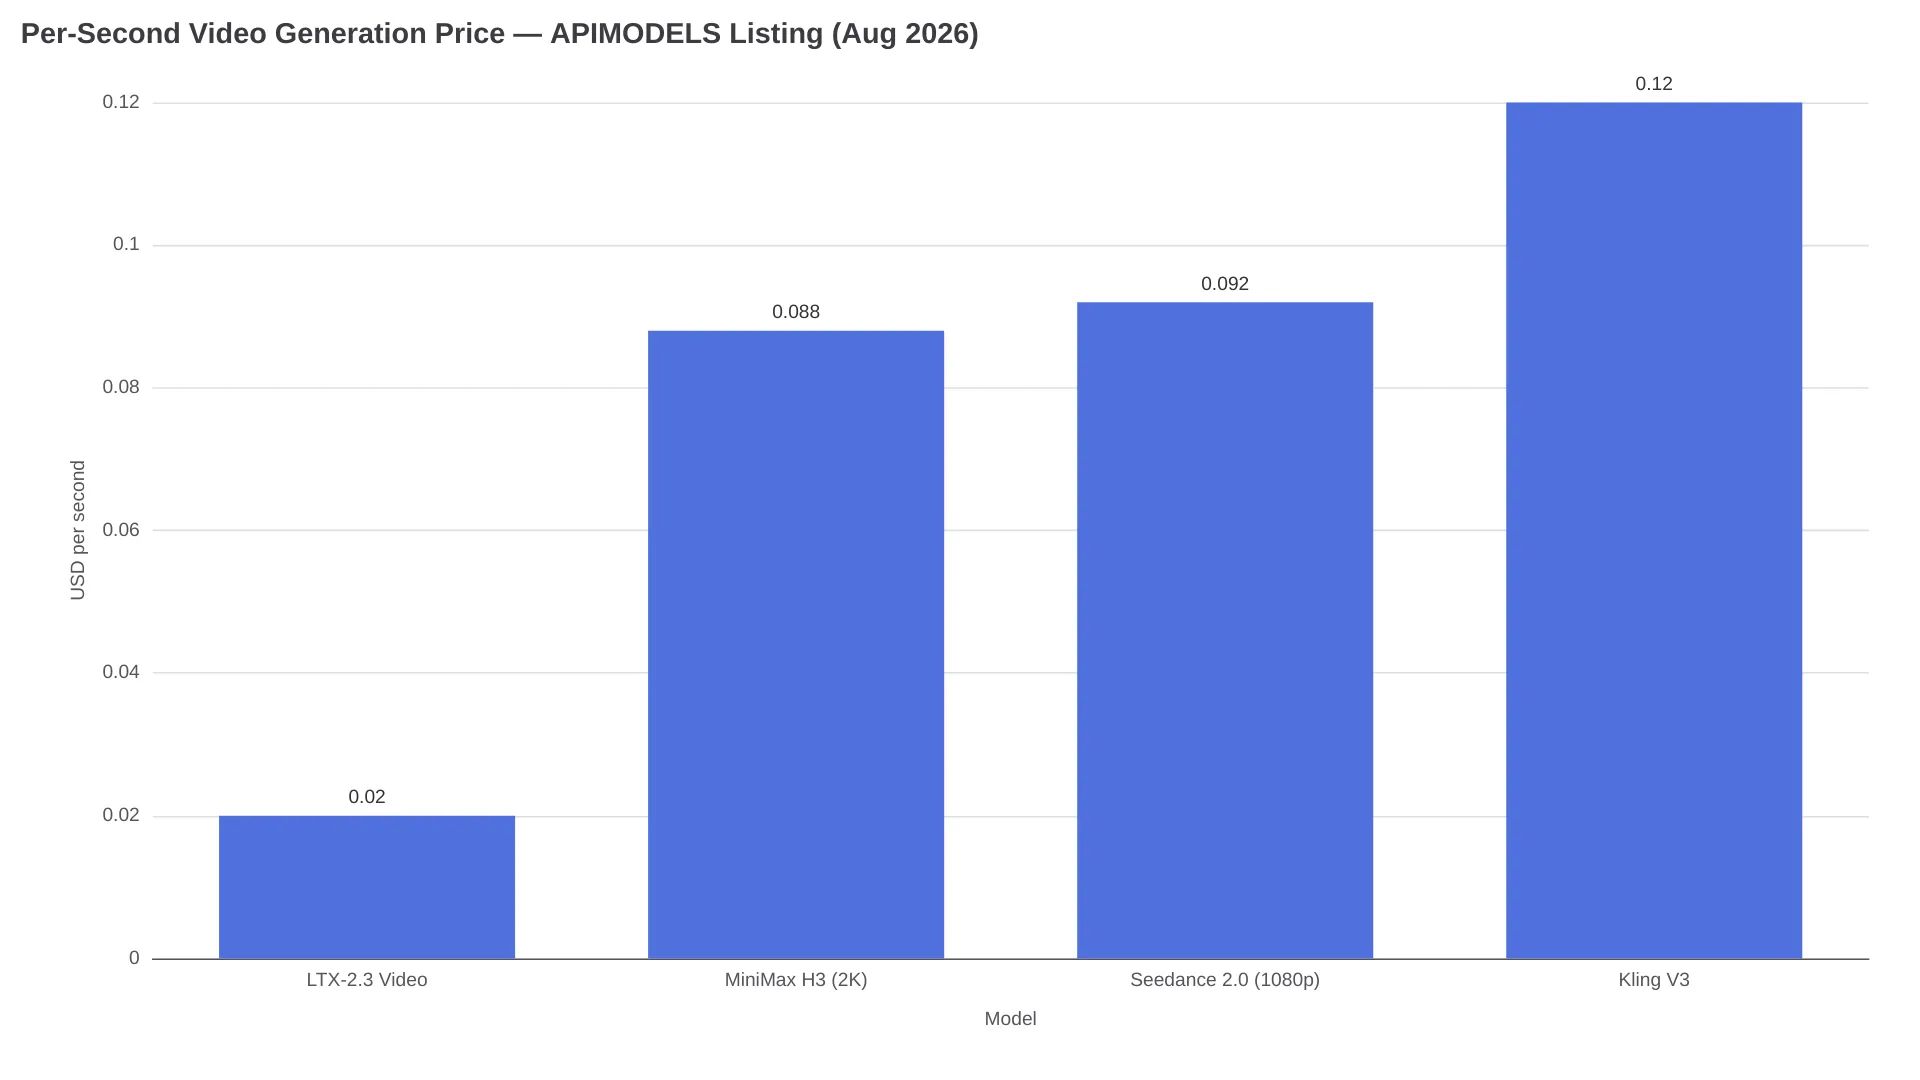
真正該算進預算的是重試成本:一份結構完整的 15 秒對話 prompt,第二次就成功,在 APIMODELS 上會花 $2.64;沒有結構的 prompt 若要嘗試五次才得到一段可用成果,成本就是 $6.60。若想透過託管 H3 端點反覆迭代 prompt,可使用 AIReiter 的 MiniMax H3 API 頁面,頁面會顯示模型與當前價格。
可直接複製的起手式
以下兩份 base 骨架足以涵蓋大多數短影片需求。填入方括號內容即可,欄位名稱與空白行請完全保留:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/A若你要找的不是空白範本,而是已驗證的 prompt,以下三個資料庫都保留來源連結。ecomimagelab/awesome-minimax-h3-prompts 收錄 58 組 prompt,其中 39 組來自官方、19 組經社群測試;每一組都附帶可下載的結果影片,規則是「No video, no entry.」。imagineVid/Awesome-minimax-h3-prompts-and-skills 收錄六種工作流程中的 28 個已驗證案例,涵蓋 omni-reference 身分一致性到原生音訊對話。APIMODELS gallery 則有 226 組可依用途瀏覽的 prompt,全部附帶影片;其一句話原則是「References carry identity, the prompt carries action.」
撰寫腳本本身也有兩條捷徑。根據 Reddit 使用者回報,將官方指南貼入 LLM,再指定目標模式,例如「rewrite this idea as T2VA using the base guide」,能得到相當穩定的結果。另一個選項是 ComfyUI 擴充功能 MiniMax H3 Prompt Writer v0.3,可在節點工作流程中建立結構化格式。
FAQ
MiniMax H3 的 base 與 reference prompt 指南差在哪裡?
Base guide 處理四種不使用參考素材的模式:T2VA、I2VA、FL2VA、L2VA,核心是三個欄位;reference guide 則會在上傳圖片、影片或音訊參與生成時,加入六個必填區段與 <Subject>/<Picture>/<Video>/<Audio> 標籤。
MiniMax H3 prompt 要怎麼標記說話者?
依照首次發聲順序指派穩定 ID,例如 (S1)、(S2),跨鏡頭維持相同 ID;同步說話使用 (S1,S2)。<d> 標籤內只能放語言標籤與逐字台詞。
如何避免 MiniMax H3 產生亂碼音訊?
用說話者 ID 與逐字 <d> 標籤建立對話結構,明確描述不說話的角色保持安靜;如果不想要配樂,設定 non_diegetic_music: N/A。這些都是官方與社群驗證過的修正方法。
MiniMax H3 的對話應該放進引號嗎?
不應該。引號保留給影片裡看得見的文字;口語對話應寫成 <d>[Language] ...</d>,否則 H3 可能把它渲染為畫面字幕。
MiniMax H3 prompt 最長可以寫多少?
fal 與官方 V2 API 文件記載約 7,000 字元,但 APIMODELS 列出 20,480 字元。寫一份 10,000 字元腳本前,請先確認你使用的端點限制。
語法無法解決的事
結構化寫法能提高命中率,但無法讓生成變成完全確定的流程。精確的人物身分、Logo 與產品外觀仍帶有機率性:社群維護的 API wrapper 明確拒絕承諾幀級一致性,而最強的 prompt 資料庫案例也是透過冗長的限制區塊維持身分,而非提供可量測的保證。非語言聲音的內嵌 <tags> 屬於社群實驗性用法,效果會隨生成而變。評估成果時,應看每一秒獲准使用影片的成本,而不是單次請求成本;寫作時也建議始終開著官方 base 與 reference 指南。
延伸閱讀:MiniMax H3 發布總覽介紹模型本身,而 MiniMax H3 vs LTX 2.3 則將它與每秒成本最低的替代方案進行比較。