 AIREITER
程式代理看起來很便宜,但上下文一跨過計費門檻,或推理預算開始擠壓輸出額度,成本模型就會完全不同。這場 Grok 4.6 與 Opus 5 的選擇很明確:提示詞通常低於 200K tokens、在意成本,就選 Grok 4.6;若 1M token 上下文、128K 輸出,或其已文件化的代理控制功能確實是需求,則選 Claude Opus 5。
先看工作負載的邊界條件
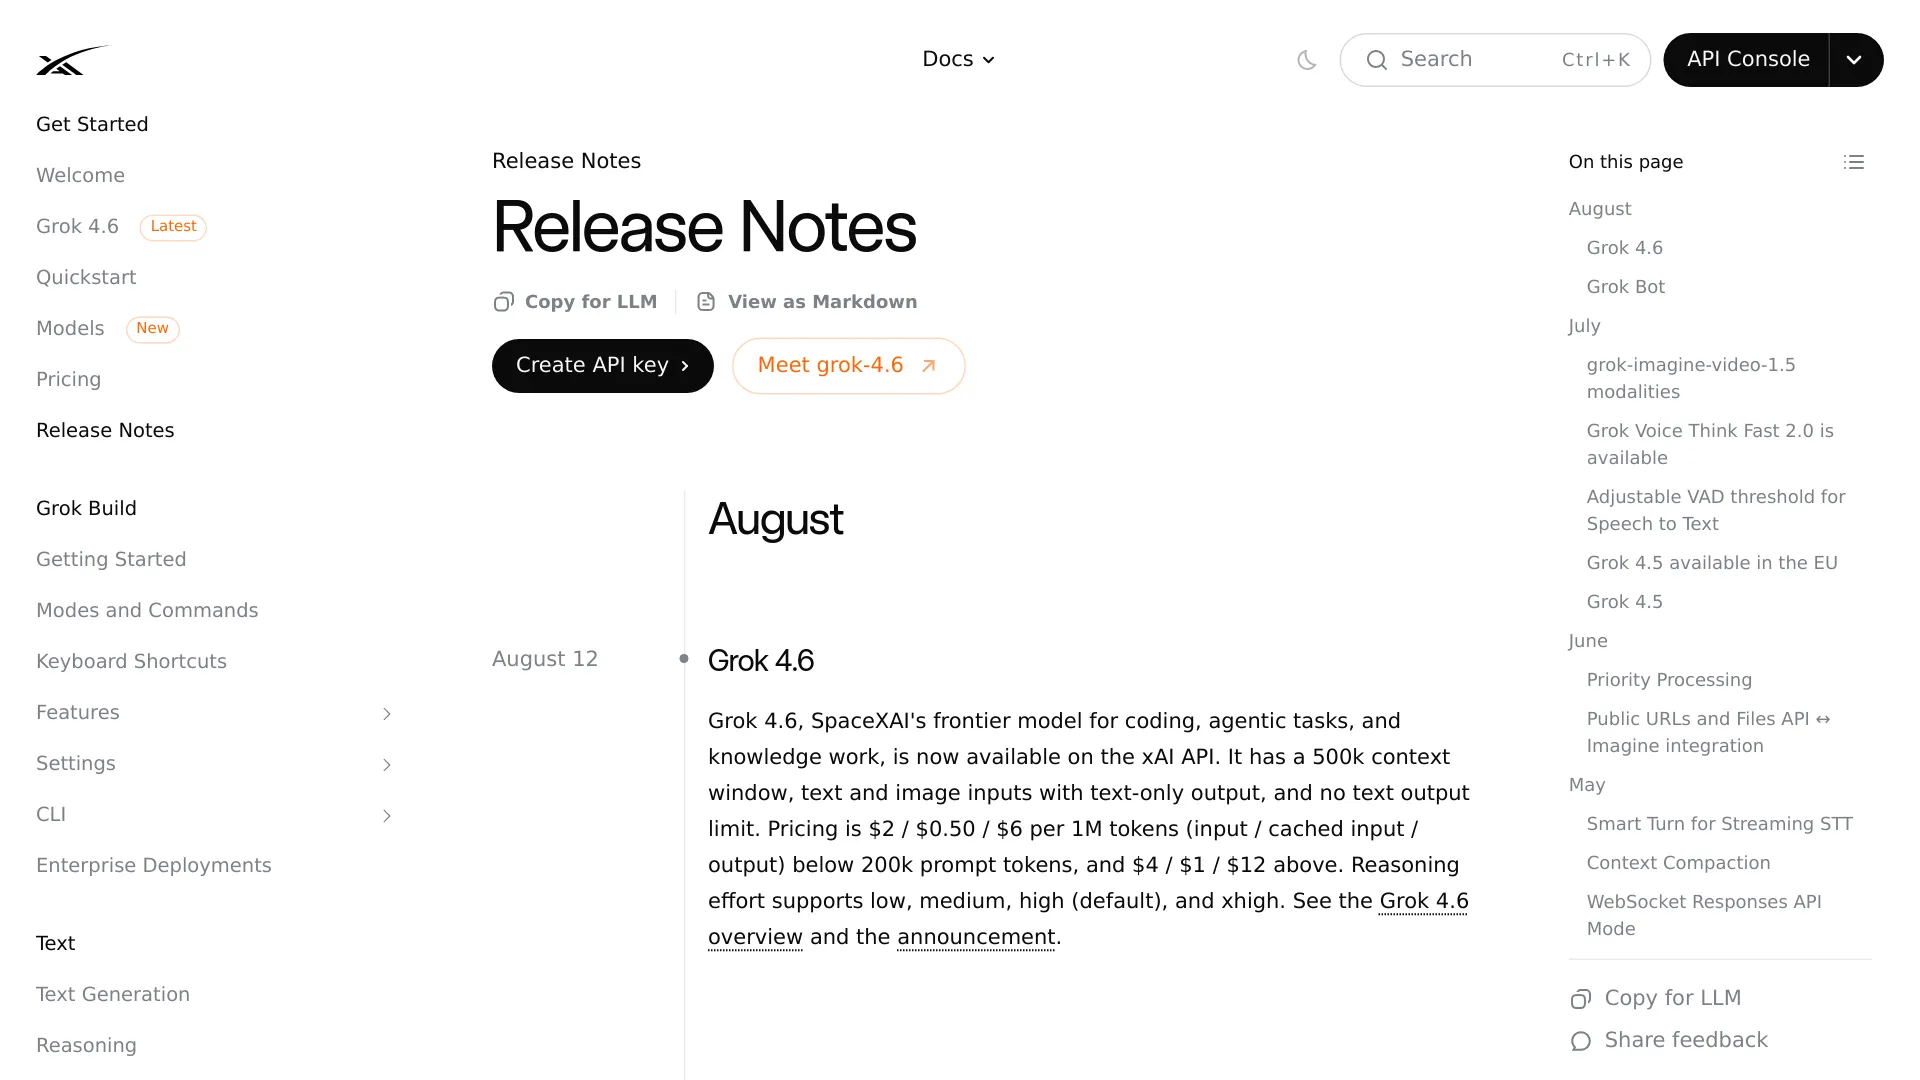
對於產出文字的程式開發或知識工作代理,只要提示詞維持在 xAI 的 200K prompt token 計價門檻以下,Grok 4.6 是實際可行的預設選項。xAI 在 2026 年 8 月 12 日的發布說明中列出:500K 上下文視窗、文字與圖片輸入、文字輸出,以及從 low 到 xhigh 的四種 effort 設定。最主要的規格來源是 xAI 開發者發布說明。
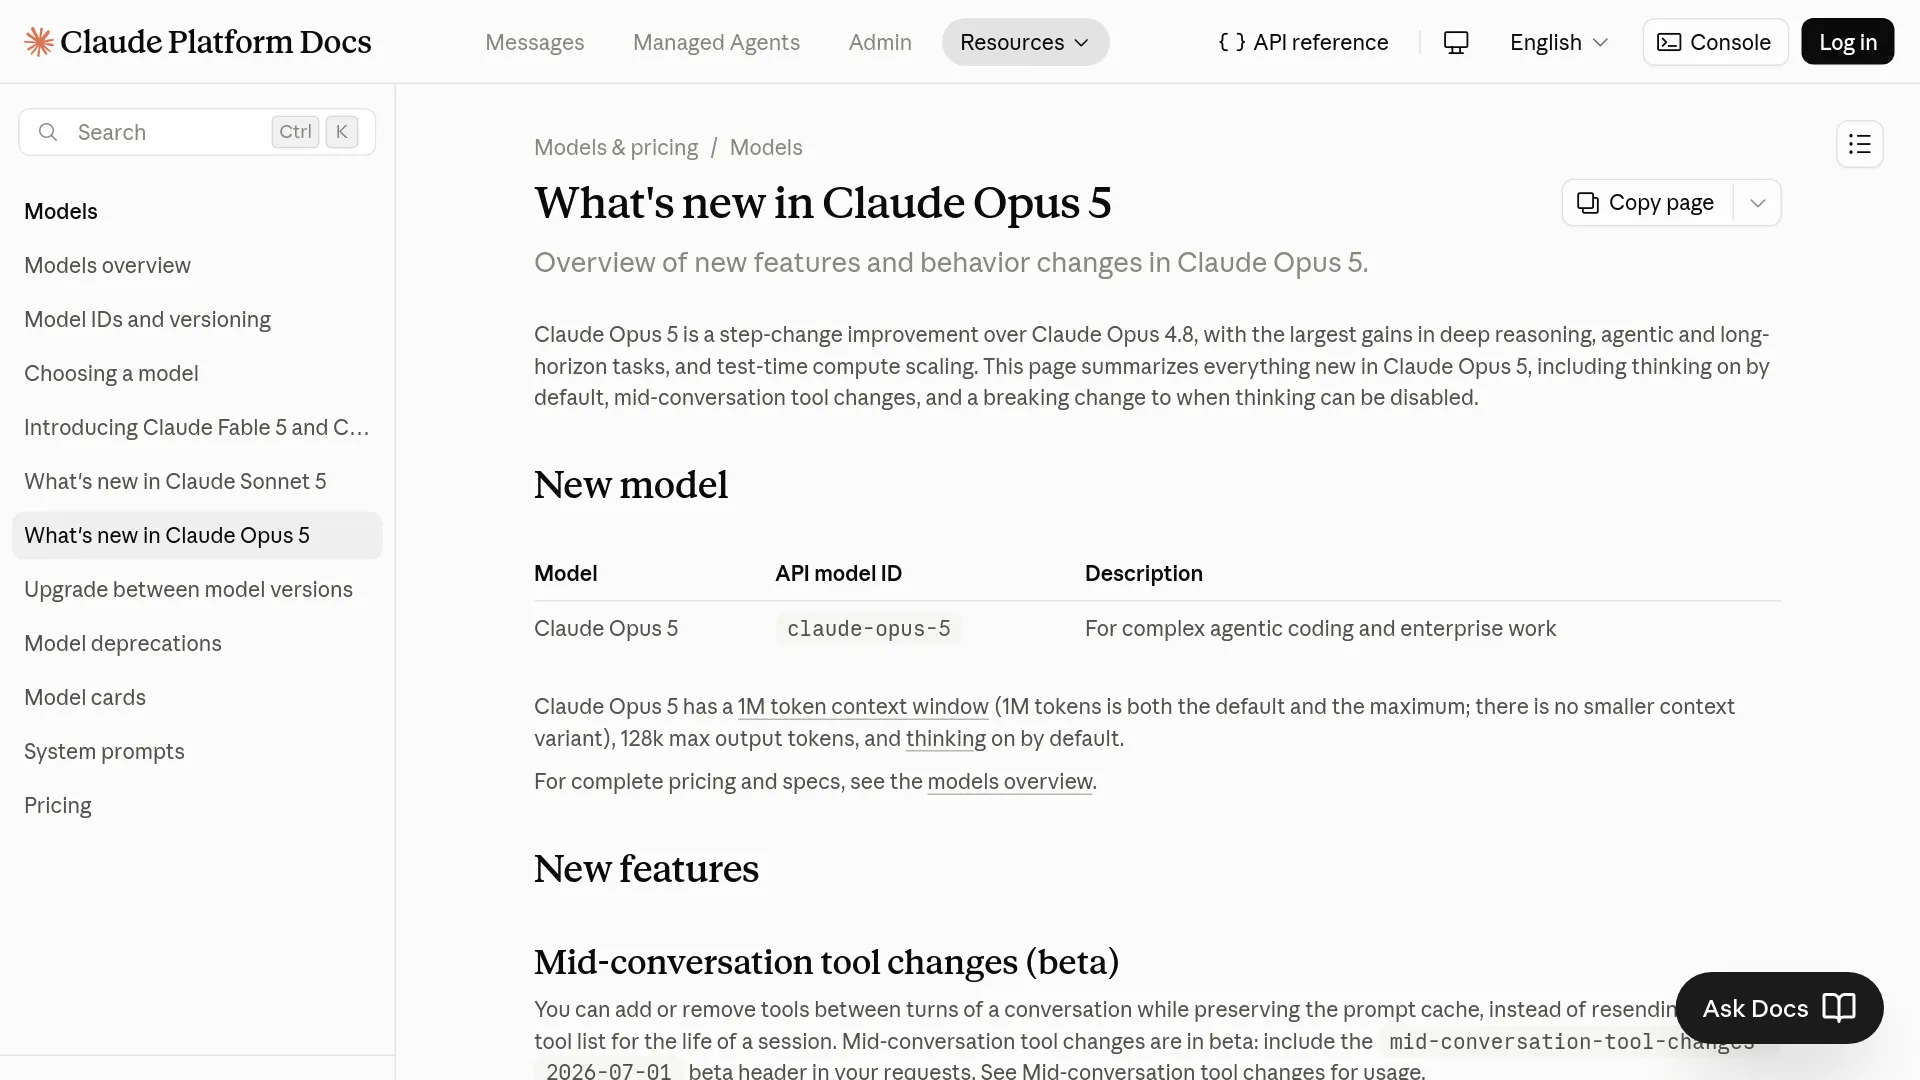
當 500K tokens 不夠用、工作流程需要最高 128K 輸出 tokens,或整合方案仰賴 Anthropic 的 fallback 與動態工具清單功能時,Claude Opus 5 更合適。Anthropic 文件指出,它提供預設也是最高上限的 1M-token 上下文視窗、預設開啟 thinking,並可透過 API 與主要雲端合作夥伴使用 claude-opus-5。在這類決策中,Claude Platform 的 Opus 5 文件比排行榜上些微的分數差距更重要。
本文引用的來源並沒有提供一份足以判定所有程式任務勝負的共同基準測試。應先用自己的測試框架確認最大提示詞長度、所需輸出篇幅、工具契約,以及單一完成任務的成本。
比較分數前,先把 API 限制攤開來看
Grok 4.6 與 Claude Opus 5 都支援文字與圖片輸入,並產生文字輸出。真正拉開差距的,是上下文容量、長上下文計費、輸出規格與整合控制能力。
| API 項目 | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| 上下文視窗 | 500K tokens | 1M tokens |
| 輸入模態 | 文字、圖片 | 文字、圖片,以及 Anthropic 所描述的 PDF/文件工作流程 |
| 輸出模態 | 文字 | 文字 |
| 文字輸出上限 | xAI 發布說明未列出數字上限 | 128K tokens |
| Effort 設定 | low、medium、high、xhigh | low、medium、high、xhigh、max |
| 預設 effort | high | high |
| 標準輸入價格 | $2/M tokens | $5/M tokens |
| 標準輸出價格 | $6/M tokens | $25/M tokens |
| 長提示詞規則 | 提示詞超過 200K tokens 時,輸入 $4/M、輸出 $12/M | Opus 5 發布文件未列出對應門檻 |
| 快取輸入 | 低於 200K 為 $0.50/M;高於 200K 為 $1/M | 可快取提示詞最低為 512 tokens,快取價格另有文件說明 |
Grok 4.6 的標示單價較低,但提示詞超過 200K 後會翻倍;Opus 5 雖然較貴,但對真正需要的工作流程來說,1M 上下文可省下分段處理或檢索的額外成本。
Grok 4.6 的成本分水嶺在 200K
提示詞低於 200K tokens 時,Grok 4.6 的定價為每百萬輸入 tokens $2、每百萬輸出 tokens $6。提示詞一旦超過 200K tokens,xAI 列出的價格便提高至輸入 $4/M、輸出 $12/M;快取輸入則分別為 $0.50/M 與 $1/M。比起只看低價方案的宣傳數字,這條門檻更值得注意。兩個級距都由 xAI 發布說明明確列出。
按標示價格計算,100K 未快取輸入 tokens 加上 20K 輸出 tokens 的成本為 $0.32;250K 輸入加 20K 輸出,套用高級距後則為 $1.24。這些只是單次請求的計算,不代表代理實際執行成本,因為重試、工具呼叫、快取前綴與累積上下文都可能主導帳單。
近期一篇 r/grok 討論指出,在特定配置下,Grok 4.6 Extra High 的 CursorBench 3.2 成績為每項任務 $2.81、46 個步驟;Opus 5 Max 則為 $8.23、78 個步驟。這些數字應視為作者回報的測試框架結果,而不是廠商中立的保證:同一篇貼文也指出,Grok 4.6 在 Terminal-Bench 3.0 的成績為 26.0%,落後於其他列出的模型。
Opus 5 影響的是代理整合設計
Claude Opus 5 預設啟用 thinking。max_tokens 是隱藏推理與可見輸出共用的硬性上限,因此若從不使用 thinking 的 Opus 4.8 請求遷移過來,可能需要提高輸出預算。Anthropic 也說明,若將 thinking: {"type":"disabled"} 與 xhigh 或 max 合用,會回傳 HTTP 400。遷移說明給出的選項有兩個:停用 thinking 時降低 effort,或移除停用 thinking 的設定。
Claude Opus 5 也將可快取提示詞的最低長度,從 Opus 4.8 的 1,024 tokens 降為 512 tokens。它的 beta 控制功能可在對話進行中修改工具,而不使提示詞快取失效,另提供受管理的 fallbacks: "default" 模式。如果代理的權限或工具集會改變,這些功能很有價值;對單純的無狀態 completion endpoint 而言,則沒有實質差別。
Fast mode 是僅限 API 的研究預覽功能,價格為輸入 $10/M、輸出 $50/M,正好是標準 Opus 5 價格的兩倍。Anthropic 表示,Amazon Bedrock、Google Cloud 與 Microsoft Foundry 都無法使用,因此不能同時假定可攜性與速度。Anthropic 的發布公告列出的標準價格為輸入 $5/M、輸出 $25/M。
程式代理測試只能提供方向,沒有通用贏家
Anthropic 表示,Opus 5 在 maximum effort 下,CursorBench 3.2 可達約 70.0%,每項任務成本約 $8.50;與 Fable 5 所回報的最佳成績相差 0.5 個百分點以內,成本約為其一半。這是 Anthropic 圖表中的結果,應視為廠商自行評估的證據,而非跨供應商稽核。Opus 5 公告說明,其 Frontier-Bench 方法是每項任務嘗試五次,使用 Anthropic 的內部執行環境。
若是程式碼審查,另一項看似獨立、但範圍較窄的測量更具實用性。CodeRabbit 測試了約 100 種來自真實開源 pull request、已驗證的錯誤模式;每種配置執行三次,並評估篩選後的審查留言。在 xhigh effort 下,其 Opus 5 配置找出 55.2% 的已知問題,生產環境基準為 61.1%;可採納精確率則為 39.3%,高於基準的 35.2%,但也產生了 92 則 nitpick,基準僅有 23 則。CodeRabbit 的 Opus 5 評估建議賦予它特定的精確率導向角色,而不是將 Opus 5 當成唯一防線。
這些證據支持一條具體原則:以不只一種 effort 等級測試 Opus 5,並在自己的 pull request 上衡量召回率、精確率、token 使用量與審查雜訊。至於 Grok 4.6,xAI 目前的發布說明提供 API 契約與價格,但沒有發布可直接比較的程式碼審查研究。不要從程式代理分數直接推論它在程式碼審查上勝出。
依部署情境選擇模型
若代理平常的提示詞維持在 200K tokens 以下,且優先考量較低的 API 標示成本,建議選 Grok 4.6。測試預算應涵蓋這條門檻:即使最初提示詞不大,儲存庫代理仍可能因工具輸出與重試而超過門檻。
若儲存庫、文件或代理工作階段需要超過 500K tokens 的有效上下文、最高 128K 輸出,或 Anthropic 已文件化的工具變更與 fallback 控制功能,建議選 Claude Opus 5。先從 high 開始,再測試較低 effort,不要預設 max 必然值得其成本。
自動化程式碼審查不應根據一般程式排行榜來選模型。應建立帶標籤的 pull request 測試集,記錄問題召回率與誤報負擔,並保留第二條審查路徑處理並行、API 使用與驗證缺陷。CodeRabbit 發現,這些類別是其受測 Opus 5 配置較弱的部分。其分類結果是在提醒你測試任務適配性,並非對所有 Claude 部署情境的定論。
| 部署情境 | 預設選擇 | 判斷依據 |
|---|---|---|
| 提示詞低於 200K tokens、重視成本的程式代理 | Grok 4.6 | 標示價格為輸入 $2/M、輸出 $6/M |
| 上下文超過 500K 的長篇儲存庫或文件工作階段 | Claude Opus 5 | 1M 上下文視窗與 128K 輸出上限 |
| 工具會動態變更的代理 | Claude Opus 5 | beta 的對話中工具變更可保留快取 |
| 經常出現超過 200K tokens 提示詞的任務 | 兩者都要評估 | Grok 4.6 在門檻後的標示 token 價格會翻倍 |
| 程式碼審查管線 | 以帶標籤 PR 評估兩者 | 召回率、精確率、重試與審查雜訊,比單一醒目分數更重要 |
常見問題
Grok 4.6 比 Opus 5 便宜嗎?
提示詞低於 200K tokens 時,xAI 列出的 Grok 4.6 價格為輸入 $2/M、輸出 $6/M;Opus 5 則是輸入 $5/M、輸出 $25/M。Grok 4.6 的標示價格在超過 200K prompt tokens 後會翻倍,因此應比較完成任務的總成本,而不只是初始請求。
程式開發該用哪個模型?
如果代理通常維持在 200K prompt tokens 以下,且你重視較低的 API 標示費率,選 Grok 4.6。若必須使用 1M 上下文、128K 輸出,或 Anthropic 的代理控制功能,則選 Opus 5;無論選哪一個,都應以實際執行的程式語言、儲存庫型態與工具迴圈驗證。
下一步:用實際任務做部署測試
針對每個候選模型,以固定工具、固定重試上限與 token 記錄,執行同一批 20 到 50 個具代表性的任務。選擇能以較低完成任務成本達到所需通過率的模型;另一個模型則保留作為路由選項,用於上下文或控制層優勢具有決定性的工作負載。
延伸閱讀:Claude Opus 5 API 定價指南、Grok 4.6 發布細節,以及 Grok 4.6 vs GPT-5.6。