 AIREITER
Grok 4.6 在 2026 年 8 月 12 日登場,比 Elon Musk 口中「兩週後」所暗示的日期晚了五天。乍看之下,API 價格完全沒變:每百萬 Token 輸入 $2.00、輸出 $6.00、上下文長度 500K,和 Grok 4.5 一模一樣。但實際帳單不是這回事。快取輸入價格比 4.5 高出 67%,獨立測量也顯示,Grok 4.6 完成同一項任務時會用掉更多 Token。
8 月 12 日推出了什麼
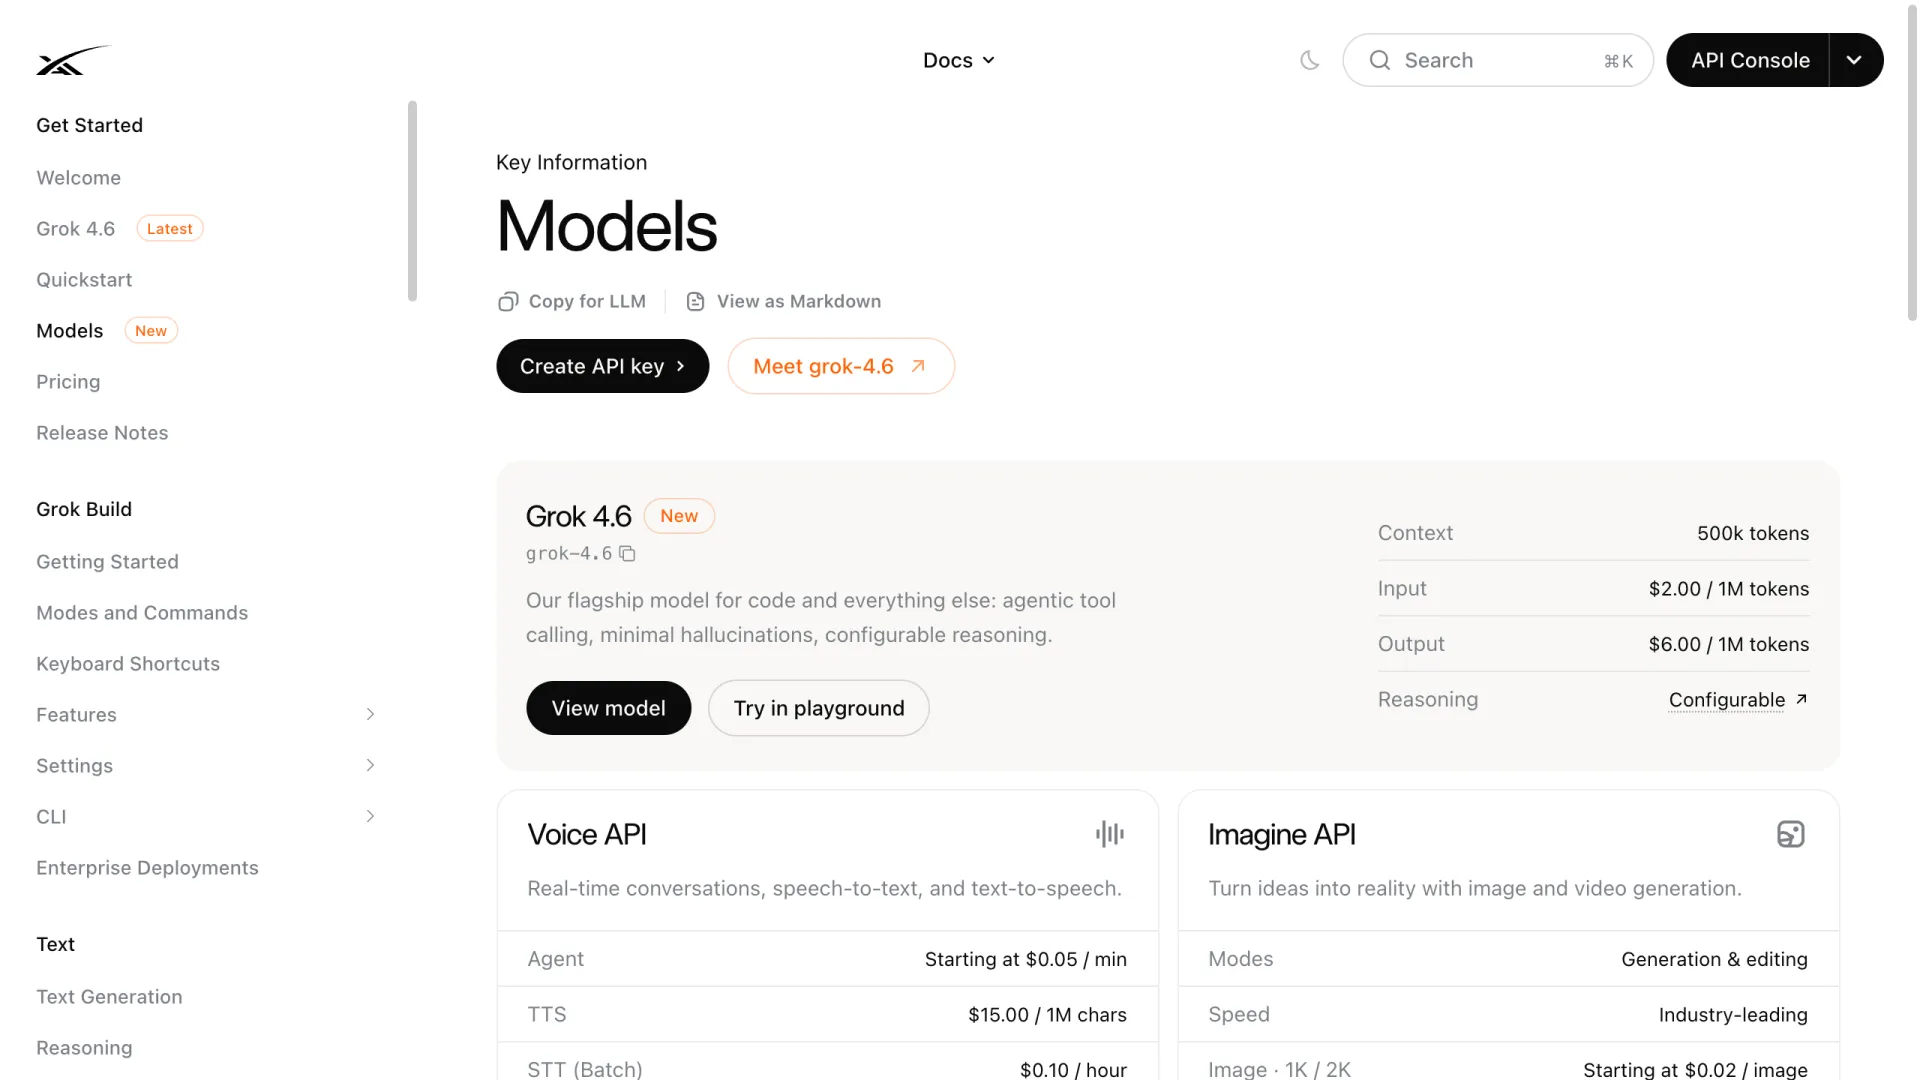
新模型的 ID 是 grok-4.6。根據 SpaceXAI 的發布說明,它在 2026 年 8 月 12 日正式透過 API 提供。文件列出的規格如下:
| 項目 | Grok 4.6 |
|---|---|
| 模型 ID | grok-4.6 |
| 上下文 | 500K tokens |
| 輸入 | 文字與圖片 |
| 輸出 | 僅文字,未標示輸出上限 |
| 推理強度 | low、medium、high(預設)、xhigh |
| 知識截止日 | 2026 年 2 月 1 日 |
其中有兩項是新內容。首先,xhigh 是第四個推理強度等級,Grok 4.5 並沒有這一檔,4.5 最高只到 high。其次,文件現在列出 2026 年 2 月 1 日的知識截止日;若你會依問題的時間點避開模型知識盲區,這項資訊就很重要。
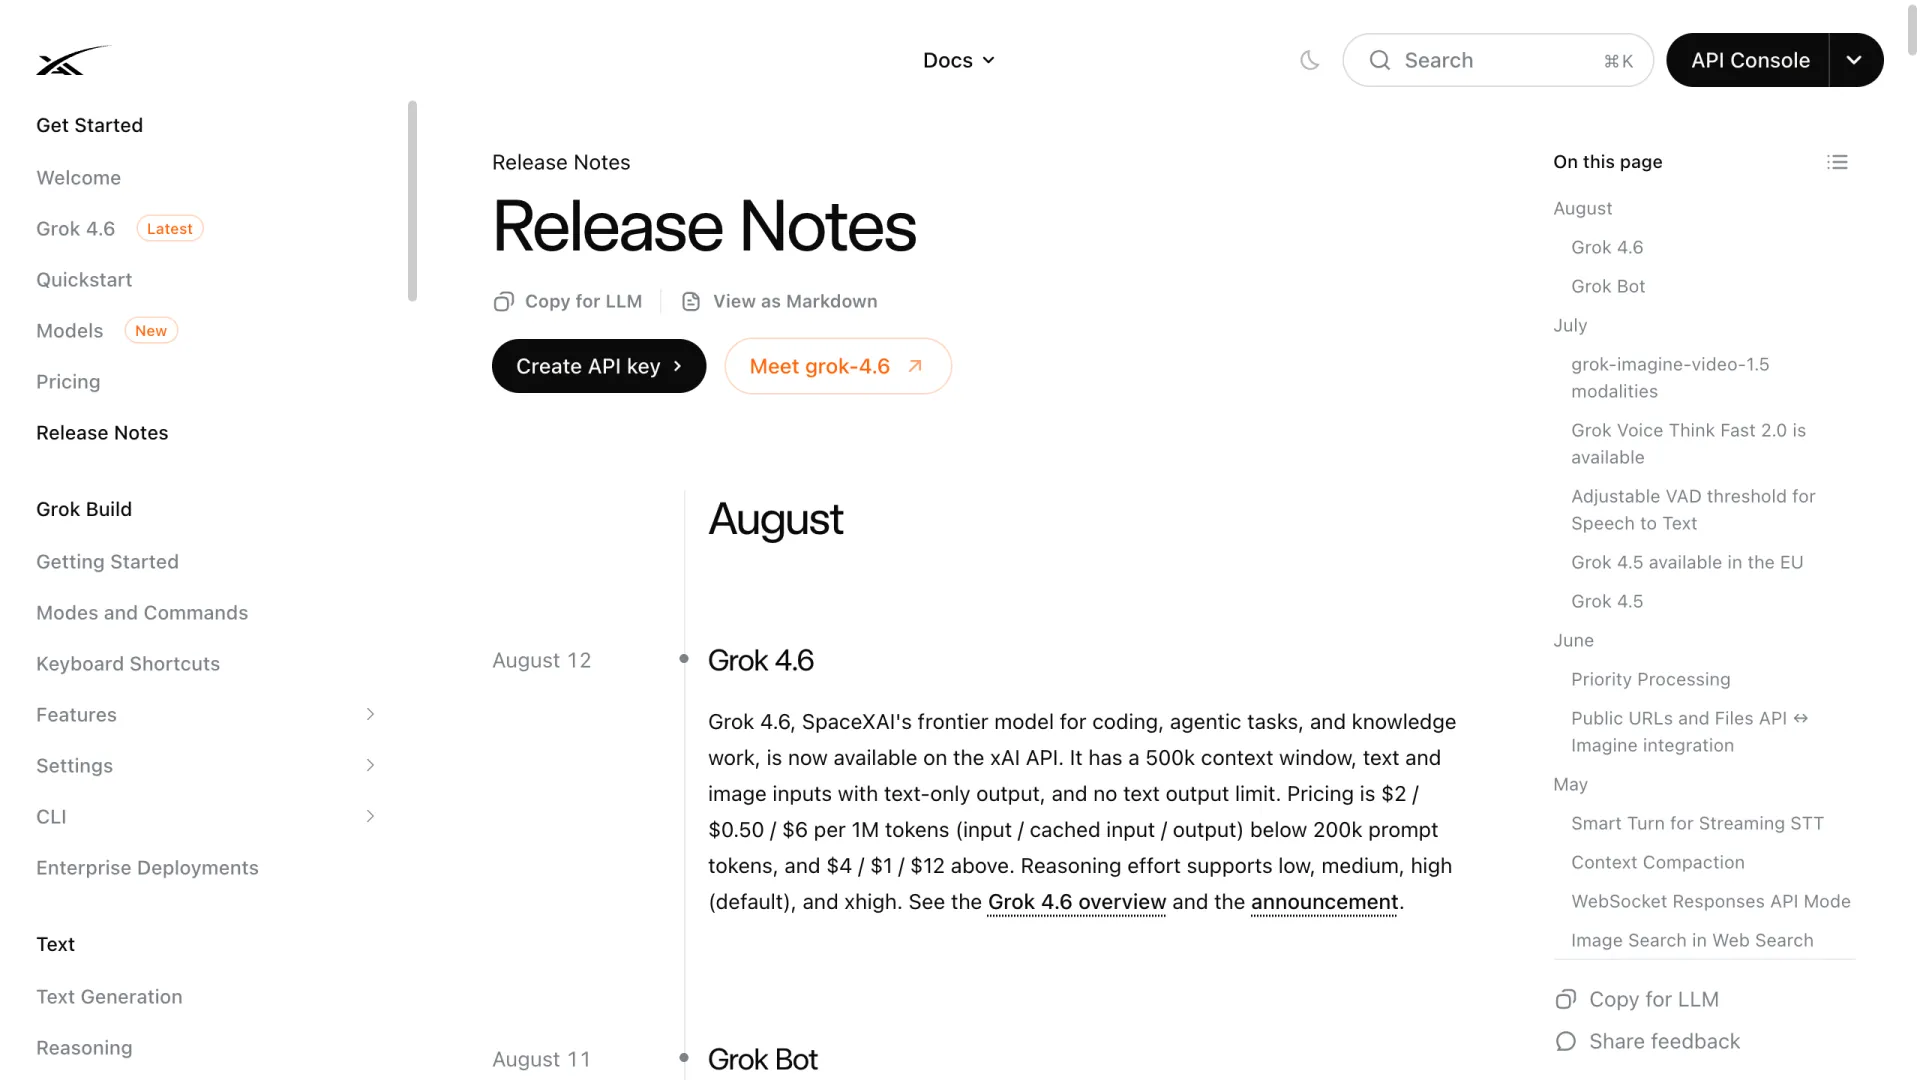
模型目錄將 Grok 4.6 定位為程式開發與對話的旗艦模型,側邊欄標示為 Latest,頁面日期為 2026 年 8 月 12 日。Grok 4.5 並未下架,定價頁上仍保留其原本的費率。
首日的發行範圍相當廣。SpaceXAI 的公告列出 Cursor 與 Grok Build,兩者在第一週都有 2 倍內含用量;另外也可經由 API 及包括 OpenRouter、Vercel、Cloudflare 在內的合作夥伴使用。公告還提到一個價格為兩倍的快速版本,但公開定價頁目前沒有對應欄位,因此 2 倍這個數字應視為公告中的說法,而非已公開的正式費率。
Grok 4.6 定價沒漲?快取讀取其實更貴
一般輸入與輸出費率原封不動沿用 Grok 4.5;變動的是快取輸入。
| 每 1M tokens 費率 | Grok 4.5 | Grok 4.6 |
|---|---|---|
| 輸入(低於 200K) | $2.00 | $2.00 |
| 快取輸入(低於 200K) | $0.30 | $0.50 |
| 輸出(低於 200K) | $6.00 | $6.00 |
| 輸入 / 快取 / 輸出(200K+) | $4.00 / $0.60 / $12.00 | $4.00 / $1.00 / $12.00 |
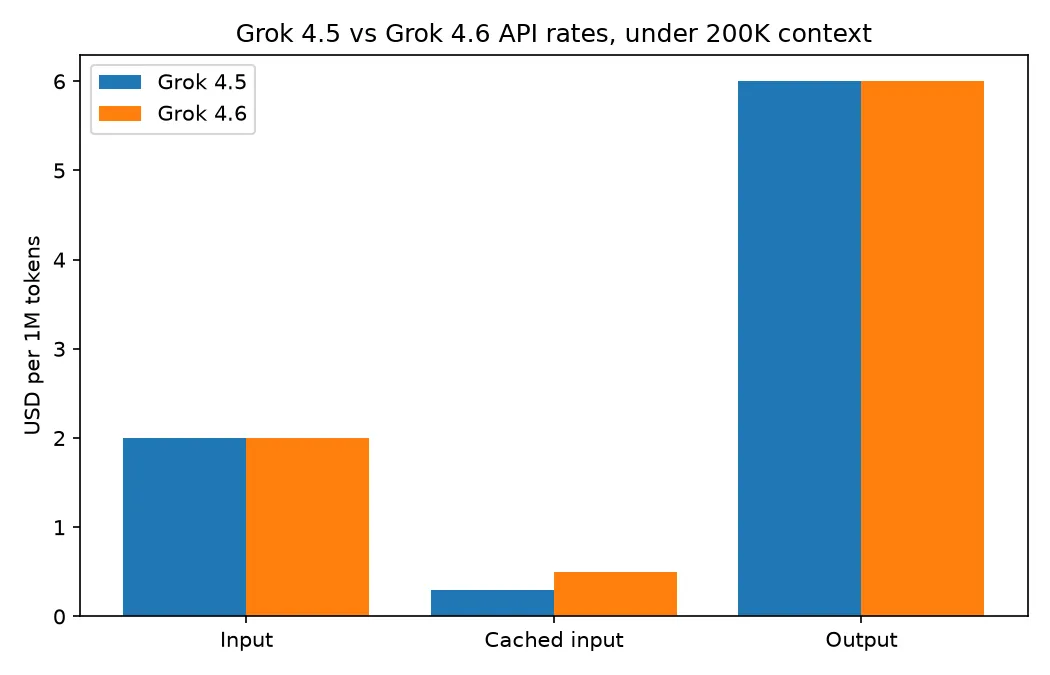
快取輸入折扣從 85% 縮減為 75%,每百萬 Token 多了 20 美分。這筆費用會隨 Agent 的執行步數增加,而非單純跟任務數量成長。若一個測試框架每天重播 50M 快取 Token,使用 4.6 的成本是 $15.00,4.5 則是 $9.00。
長上下文的計費規則沒有改,而且依然很容易被忽略:只要單次請求的 prompt 達到 200K Token,該請求中的每個 Token 都會以較高級距計費。換句話說,一次 210K Token 的呼叫,整筆輸入都按每百萬 Token $4.00 計,不是兩個級距混合計算。OpenRouter 的公開模型頁也列出相同費率與 200K 的切換規則,因此走第三方路由不會改變這筆帳。
官方評測裡,Grok 4.6 贏在哪、輸在哪
SpaceXAI 公布了一份十項評測的對照表,將 Grok 4.6 與 Grok 4.5、GPT-5.6 Sol Max、Fable 5 Max 放在一起比較。Grok 4.6 在其中三項拿下最高分:GDPVal-AA v2(1753)、AA-Briefcase(1577)與 Harvey LAB(15.8%);其餘七項則未居首。以下是對模型路由較具參考價值的八項:
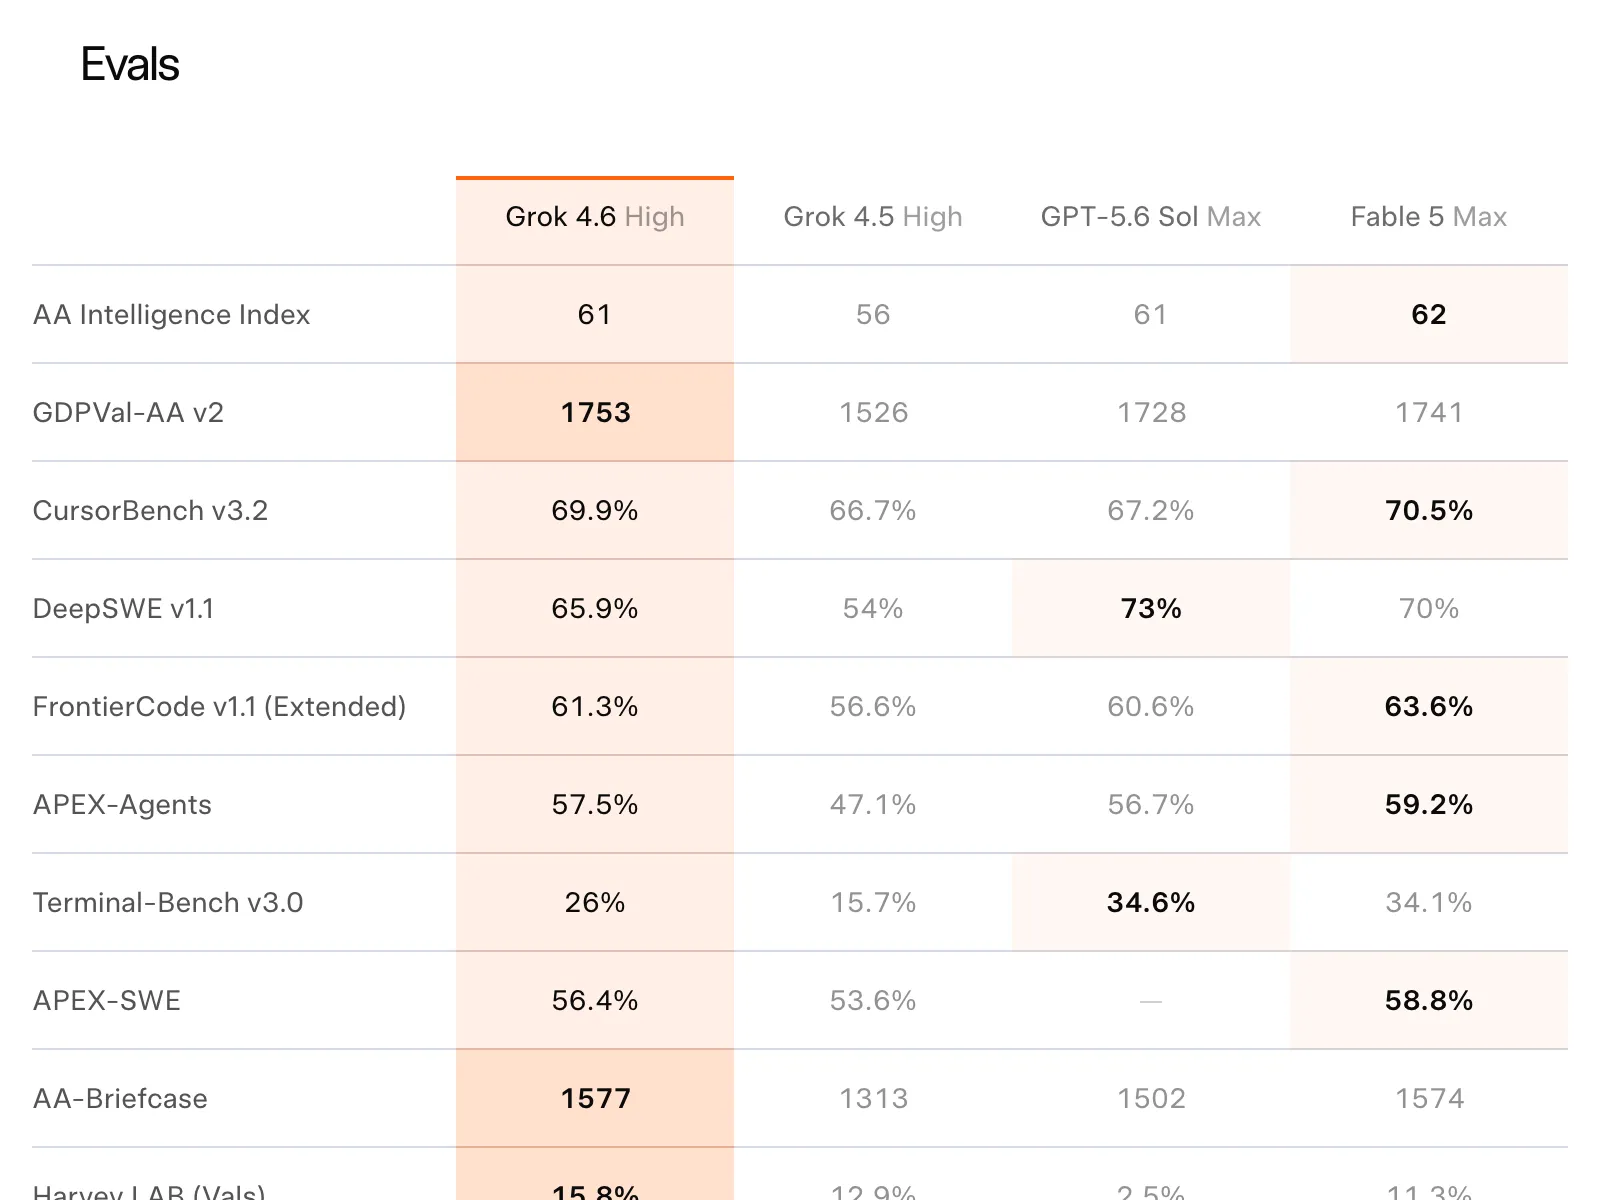
| 評測 | Grok 4.6 | Grok 4.5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
Terminal-Bench 的差距尤其值得注意。Grok 4.6 拿到 26%,GPT-5.6 Sol 是 34.6%,Fable 5 為 34.1%。在最接近 Agent 操作 shell 的這項評測中,Grok 4.6 排第三,落後約八個百分點。DeepSWE 的結論也相似,只是數字不同:Grok 4.6 為 65.9%,Sol 為 73%。如果你的工作負載主要是終端機驅動的 Agent,供應商自己的表格已經表明它不是領先選擇。
不過,相較 Grok 4.5 的進步確實存在,而且相當一致。所有評測項目都提升,APEX-Agents 從 47.1% 升至 57.5%,Terminal-Bench 從 15.7% 提升至 26%,兩者漲幅都超過十個百分點。SpaceXAI 將此歸因於更長的補充訓練、重新生成的 SFT 軌跡,以及橫跨程式開發與知識工作環境的 Agentic RL。值得留意的是,公告從未提及參數量;與這個模型連結在一起的 2 兆參數說法來自 Musk,並非發布資料。
能力提升的代價:實測成本
供應商的表格會告訴你分數,卻不會告訴你取得這個分數花了多少錢。Artificial Analysis同時公布兩者,其 8 月 13 日的測量結果也正好揭示 Grok 4.6 真正的取捨。
| 同一指數下的測量結果 | Grok 4.5(high) | Grok 4.6(high) |
|---|---|---|
| Intelligence Index | 56(184 個模型中第 16) | 61(184 個模型中第 6) |
| 輸出速度 | 56.9 tokens/s(第 102) | 67.6 tokens/s(第 74) |
| 產生的輸出 Token | 60M | 72M |
| 完整評測成本 | $579.21 | $1,068.47 |
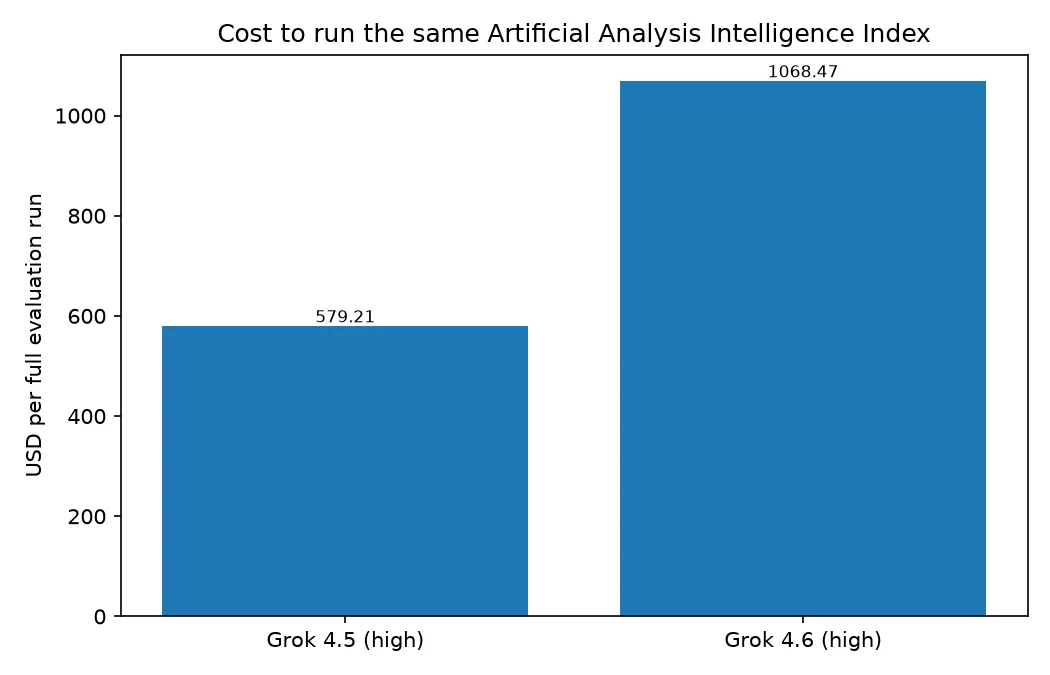
智慧指數多了五分,成本卻來到 1.8 倍。表面費率相同,但跑完同一套基準測試多花了 $489:部分原因是輸出更冗長,Grok 4.6 產生 72M Token,對比 4.5 的 60M;另一部分則是前述的快取調價。Artificial Analysis 沒有提供這次執行的逐項成本明細,因此 1.8 倍是觀察到的總成本,不是能自行推導的計算公式。
速度則朝有利方向發展:Grok 4.6 的輸出速度為每秒 67.6 Token,4.5 為 56.9 Token。這讓它從同類模型的後半段,上升到 184 個模型中大致中位數的位置。
Musk 當初的說法,與實際推出的版本
這個名稱最早是透過一句三字回覆被確認。Musk 在7 月 18 日回覆 @minchoi 時寫道:「Our 2T model, which is better than our 1.5T in every way, will finish initial training next week. It might be able to exceed Kimi, but with speed and token efficiency close to our 1.5T (aka Grok 4.5).」Andrew Curran 問這是否就是 Grok 4.6 時,他的回答是:「Yeah, Grok 4.6.」
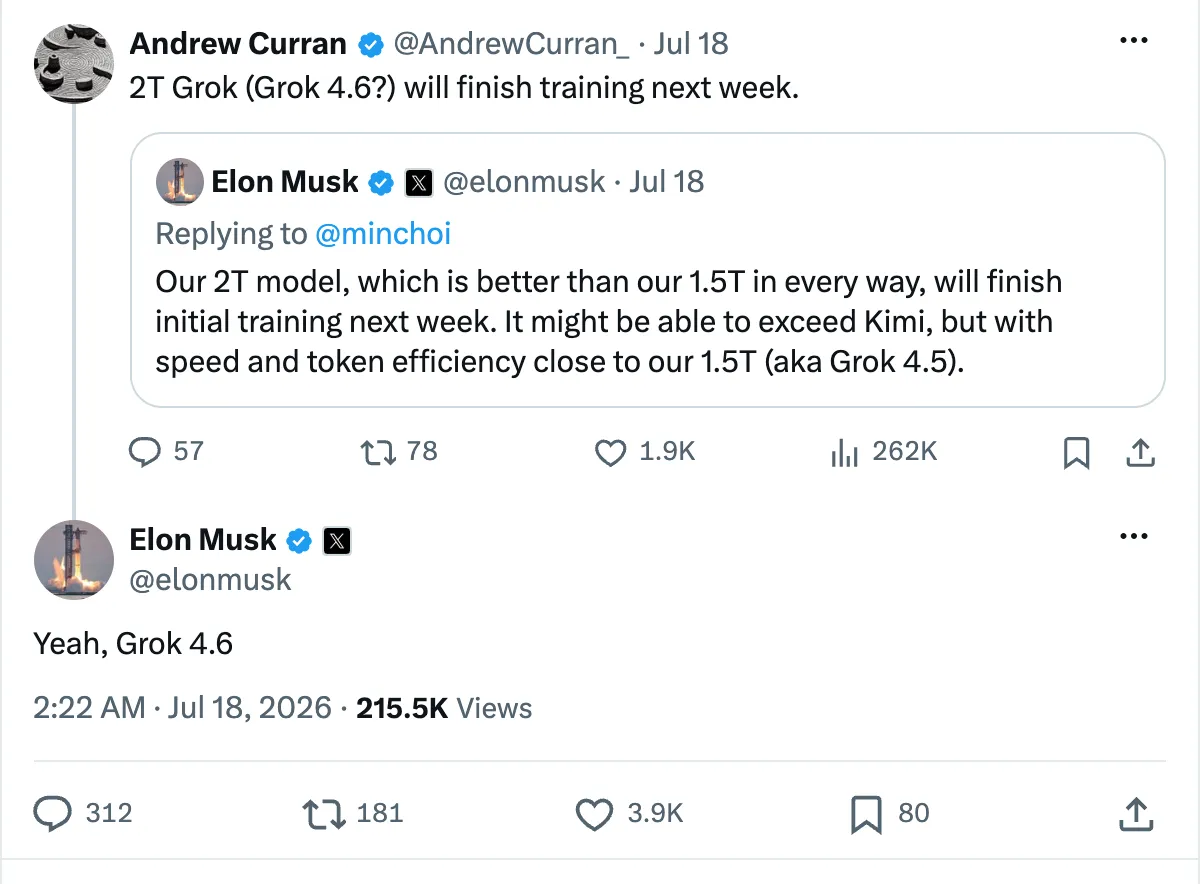
7 月 24 日,他再給出時程:「Grok 4.6 in 2 weeks and Grok 4.7 in 4 weeks。」從該日期起算兩週大約是 8 月 7 日,而模型實際上在 8 月 12 日推出,晚了五天。
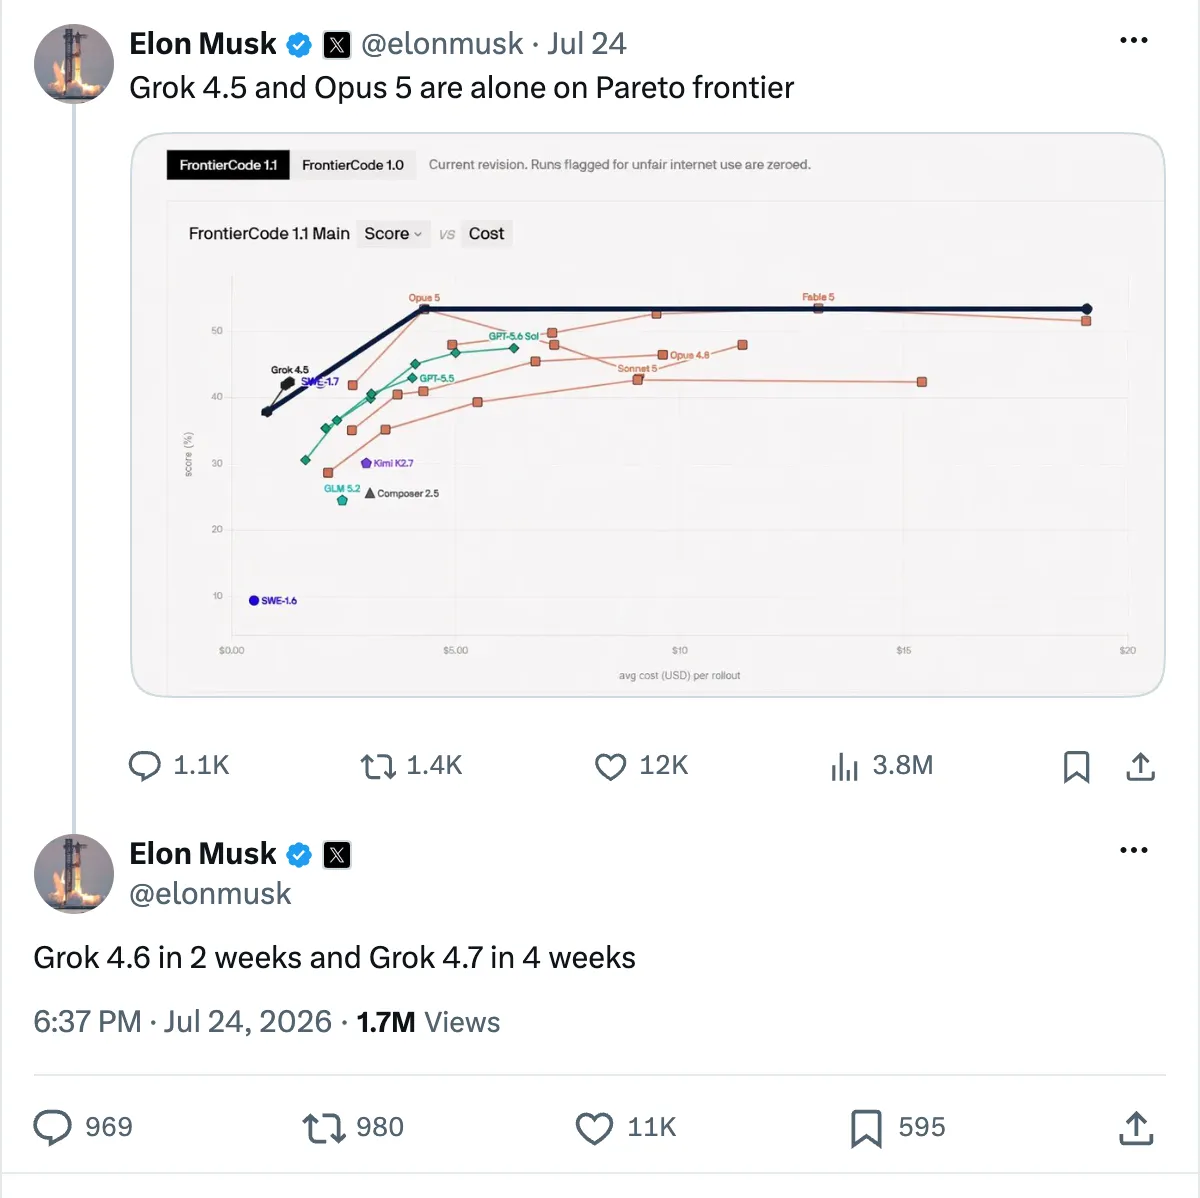
上述貼文中的三項說法,沒有完整地反映在正式發布內容裡:
- 2 兆參數仍未獲確認。SpaceXAI 的公告、模型文件與發布說明均未列出 Grok 4.6 的參數量。
- 「Token 效率接近 Grok 4.5」與 Artificial Analysis 的測量相矛盾:在同一套評測中,Grok 4.6 產生 72M 輸出 Token,Grok 4.5 則為 60M。
- 「可能超越 Kimi」目前仍無從驗證。SpaceXAI 的表格沒有納入 Moonshot 的 K3,只比較了 GPT-5.6 Sol 與 Fable 5。
該從 Grok 4.5 升級到 Grok 4.6 嗎?
如果你目前使用 Grok 4.5,且工作偏向 Agentic 或知識型任務,答案是可以升級;不過應該在遷移一週後檢查 Token 帳單,而不是在切換當下就下結論。Grok 4.5 仍以原有費率提供,因此切換可逆,值得實測,而非預設新版本一定更划算。
若你的工作是長時程 Agent 或知識任務,可以現在就遷移:APEX-Agents 提升 10.4 個百分點,GDPVal-AA 增加 227 分,加上更快的生成速度,在多步驟執行中會累積效益。若流量高度依賴快取、價格敏感,則可留在 4.5——快取讀取漲價 67% 是實質倒退,而且 4.6 推出後,4.5 的分數並沒有下降。至於終端機 Agent,建議直接考慮其他選項;依 SpaceXAI 自己的表格,Grok 4.6 落後GPT-5.6 Sol與 Fable 5 約八個百分點。
將正式流量切換前,先確認三件事:
- 兩個 ID 都是別名。SpaceXAI 的別名規則指出,
grok-4.6指向最新的穩定版本,grok-4.6-latest則指向最新版本;只有帶日期的<modelname>-<date>ID 才是固定版本。目前模型目錄與 OpenRouter 都沒有列出帶日期的 4.6 版本,因此需要可重現工作流程時,現在還沒有可鎖定的版本。 - 重新測試推理強度設定。新的
xhigh不是免費升級。這個模型已被測出比前代更容易產生冗長輸出,xhigh 還會再花更多 Token。預設的high才是和 4.5 進行同級比較的設定。 - 確認你的供應商真的已支援。SpaceXAI 首日可用,不代表所有平台首日都有。8 月 13 日查詢
/v1/models時,官方 API 與 OpenRouter 都回傳grok-4.6;但我測試的一個 OpenAI 相容轉售端點最高仍只到grok-4.5,新 ID 會回傳model_not_found。在導流前,請先用自己的 key 確認目標 ID 能正常回應。
FAQ
Grok 4.6 API 要多少錢?
在 200K 上下文以下,每百萬輸入 Token 為 $2.00、每百萬輸出 Token 為 $6.00,快取輸入為 $0.50。若 prompt 超過 200K Token,整筆請求的費率將改為輸入 $4.00、快取 $1.00、輸出 $12.00。公告提到一個兩倍價格的快速版本,但公開定價頁尚未列出。
Grok 4.6 比 Grok 4.5 好嗎?
就 SpaceXAI 公布的每一項基準測試而言,是的。AA Intelligence Index 為 61 分,對比 4.5 的 56 分,且最大進步集中在 Agentic 評測。但獨立測量也補上了重要前提:同一套評測中,它產生 72M 輸出 Token,Grok 4.5 是 60M,因此完成相同任務的成本更高。
Grok 4.6 有多少參數?
未公開。Musk 在 2026 年 7 月 18 日描述一個 2 兆參數模型,並確認該模型名為 Grok 4.6;但 SpaceXAI 的發布資料沒有提供參數量、架構細節,也沒有說明每個 Token 會啟用多少參數。
Grok 4.6 的上下文視窗與知識截止日是什麼?
上下文長度為 500K Token,支援文字與圖片輸入,輸出僅限文字。文件列出的知識截止日是 2026 年 2 月 1 日;除非啟用伺服器端的 Web Search 或 X Search,模型無法得知此後發生的事件。
Grok 是由 xAI 還是 SpaceXAI 製作?
兩個名稱指的是同一家公司。開發者文件標題為「SpaceXAI Docs」,而在 2026 年納入 SpaceX 後,公告頁尾仍寫著 X.AI LLC。x.ai 網域與 grok-* 模型 ID 都沒有改名。
Grok 4.7 何時推出?
目前尚未公布日期。Musk 在 7 月 24 日的貼文中表示 Grok 4.7 約四週後推出,指向 2026 年 8 月 21 日前後;而 Grok 4.6 本身就比其暗示的日期晚了五天才發布。
延伸閱讀
定價、模型 ID 與基準測試數據,均於 2026 年 8 月 13 日依 SpaceXAI 文件、Grok 4.6 公告及 Artificial Analysis 資料核對。