 AIREITER
如果只看 Artificial Analysis Intelligence Index,Grok 4.6 以約 61 分幾乎追平 GPT-5.6 Sol 的 58.9 分;但 API 計價上,Sol 每個輸出 token 的成本卻是 Grok 的 5 倍。不過,Sol 擁有大約兩倍大的上下文視窗,代理任務效率指標也更高,實際價值不能只用單價直接下結論。
智慧分數接近,但綜合指標看不到的差異
Artificial Analysis Intelligence Index v4.1 將推理、程式設計與知識型任務整合為單一分數。根據 OpenAI 公布資料,GPT-5.6 Sol 得分為 58.9;而多個引用 Artificial Analysis arena 資料的社群消息指出,Grok 4.6 約為 61 分。這項社群流傳的數字尚未獲得獨立驗證,但與 Artificial Analysis 將 Grok 4.6 視為 Sol 同級模型的趨勢一致。
綜合分數會掩蓋不少關鍵差異,包括上下文視窗大小、代理效率與各項基準測試的波動。根據 OpenAI 公開結果,Sol 在 Terminal-Bench 2.1(88.8%)和 DeepSWE v1.1(72.7%)等高度依賴代理能力的測試中表現突出;Grok 4.6 對應的具體分數目前尚未獨立公開。Intelligence Index 顯示兩者整體智慧接近,但代理型基準測試可能呈現不同結論。
| 項目 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| 開發商 | xAI | OpenAI |
| 上下文視窗 | 500K tokens(x.ai/api) | 約 1,050,000 tokens(openai.com) |
| API 輸入價格(每 1M) | $2.00(x.ai/api) | $5.00(openai.com) |
| API 輸出價格(每 1M) | $6.00(x.ai/api) | $30.00(openai.com) |
| Intelligence Index v4.1 | 約 61(社群回報) | 58.9(官方資料) |
| 雲端供應情況 | Azure AI Foundry、Oracle OCI、Google Vertex(x.ai/api) | Azure、AWS Bedrock(openai.com) |
API 價格:輸入便宜 2.5 倍,輸出便宜 5 倍
xAI 的 API 頁面列出 Grok 4.6 的價格為每百萬輸入 tokens $2.00、每百萬輸出 tokens $6.00。OpenAI 的 GPT-5.6 頁面則列出 Sol 的輸入與輸出價格分別為每百萬 tokens $5.00 與 $30.00。
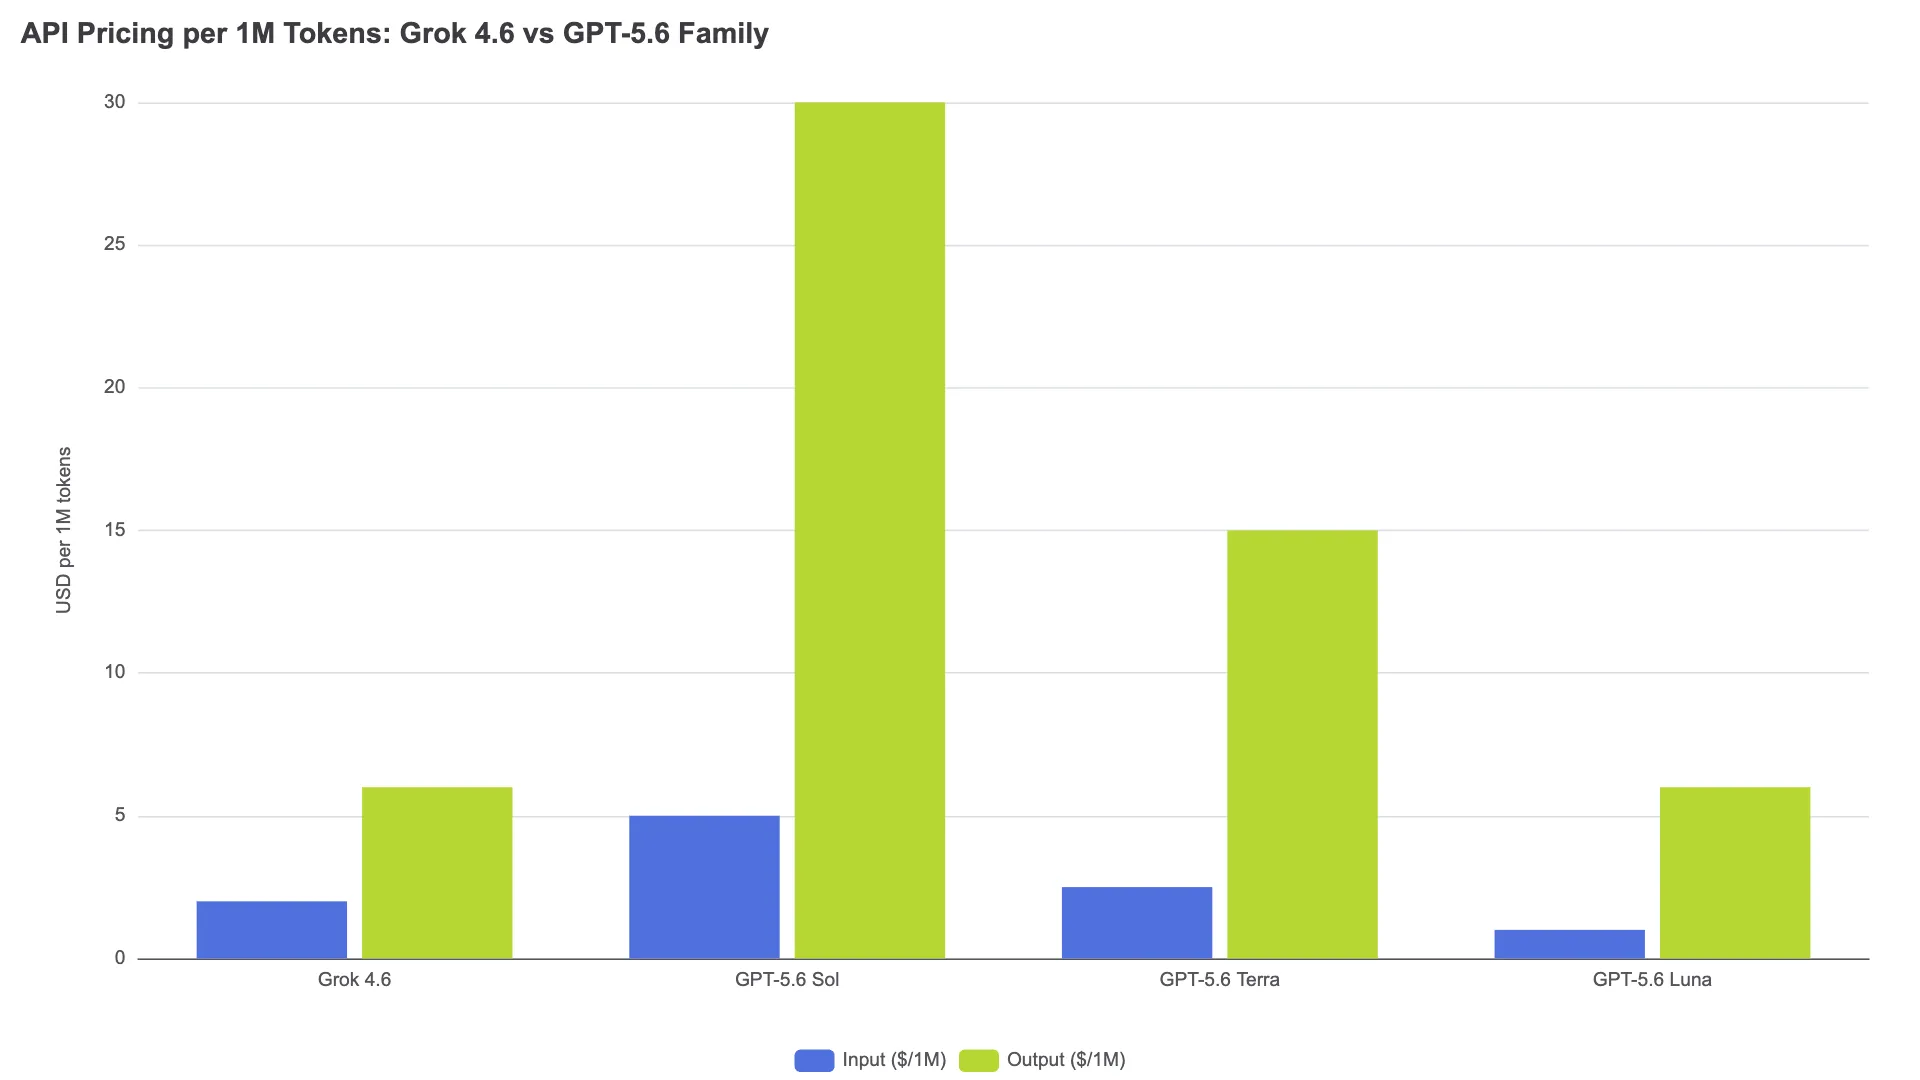
以每月使用 50M 輸入 tokens 與 10M 輸出 tokens 的工作負載計算,Grok 4.6 的費用為 $160,Sol 則為 $550。即使還沒將 Sol 推理模式每項任務會消耗更多 tokens 的因素算進去,兩者成本已相差 3.4 倍。
OpenAI 也提供更低價的層級:GPT-5.6 Terra 的價格是 $2.50/$15.00,GPT-5.6 Luna 為 $1.00/$6.00(Luna 的價格在 2026 年 7 月 30 日調降 80%)。Luna 的輸出價格與 Grok 4.6 相同,輸入價格更低,但它是規模較小的模型,各項基準分數也全面較低。若要比較智慧能力相近的模型,誠實的對照組仍是 Grok 4.6 與 Sol;在這個前提下,Grok 的成本優勢相當顯著。
上下文視窗:500K 對上 1M tokens
依據 xAI 的 API 頁面,Grok 4.6 的上下文視窗為 500K tokens;OpenAI 文件則指出 Sol 提供約 105 萬 tokens。500K tokens 已足以處理一般元件、模組,以及多數服務層級的程式開發工作。當任務必須一次載入整個 monorepo、多份大型文件,或極長的對話紀錄時,Sol 的 1M 視窗便很有意義。若你的代理工作流程需要單次分析 800K tokens 的程式庫上下文,Sol 做得到,Grok 4.6 則無法。
另一項考量是長上下文中的資訊檢索可靠度。OpenAI 表示,Sol 在 1M tokens 條件下的 GraphWalks BFS 得分為 77.1%。Grok 尚未公布對等的長上下文檢索成績。若使用情境是「在這個 600K-token 程式庫中找出 bug」,Sol 的大視窗不只代表能塞進更多內容,也關係到模型能否真的從那個深度取回所需資訊。
程式設計與代理測試:真正拉開差距的地方
Intelligence Index 的接近分數,並不代表兩者在所有程式設計基準上都同樣接近。下表列出 GPT-5.6 Sol 的 OpenAI 官方分數,並以 Fritz.ai 報導的 Grok 4.5 結果作為參考代理值。Grok 4.6 專屬的程式設計基準尚未獲獨立公布,因此 Grok 欄位應視為前代參考,不能當成與 Grok 4.6 的直接對決。
| 基準測試 | GPT-5.6 Sol(官方) | Grok 4.5(參考代理值) | 差距 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58.9 | - | Grok 4.6:約 61(幾乎打平) |
| Coding Agent Index v1.1 | 80.0 | - | 沒有 Grok 4.6 資料 |
| Terminal-Bench 2.1 | 88.8% | 83.3% | Sol +5.5 分 |
| DeepSWE v1.1 | 72.7% | 53.0% | Sol +19.7 分 |
| SWE-Bench Pro | 64.6% | 64.7% | 實質打平 |
| GPQA Diamond | 94.6% | 93.1% | Sol +1.5 分 |
Sol 在 Terminal-Bench 與 DeepSWE 的領先尤其值得注意。Terminal-Bench 衡量代理完成真實終端機任務的能力,例如安裝套件、執行測試與除錯失敗項目;DeepSWE 則以真實 GitHub issue 評估端到端軟體工程能力。Sol 相對 Grok 4.5 在 DeepSWE 領先 19.7 分,代表它在複雜、多步驟的程式任務上可能明顯更強,尤其是需要規劃、執行與從錯誤中恢復的工作。Grok 4.6 的後訓練改進能否縮小這段差距,仍有待觀察。
基準測試適合用來判斷方向,不能視為最終定論。代理框架、工具、提示詞與執行環境都會影響結果,因此一個模型在某套框架中分數較低,換到另一套框架可能反而更高。
別只看 token 單價,要看每個完成任務的成本
從價目表來看,Grok 4.6 較低的每 token 價格很有吸引力,但代理系統實際購買的是「完成的任務」,不是 tokens。假設 Sol 能以 3,000 個輸出 tokens 完成程式任務,而 Grok 4.6 完成相同任務需要 6,000 個 tokens,可能是因為重試更多次、推理鏈更長或工具使用效率較差,兩者的成本差距就會縮小。
以現行價格做敏感度分析,可以看出可能的範圍。假設 Sol 完成一個程式任務需使用 10K 輸入與 4K 輸出 tokens,而 Grok 4.6 需使用 12K 輸入與 8K 輸出 tokens,也就是 Sol 擁有 2 倍 token 效率優勢:
| 成本項目 | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| 輸入成本 | $0.05 | $0.024 |
| 輸出成本 | $0.12 | $0.048 |
| 每項任務總成本 | $0.17 | $0.072 |
即使在 Grok 4.6 的 token 效率落後 2 倍的情境下,它每項任務仍便宜 2.4 倍。引用 Artificial Analysis 的 Reddit 使用者估計,Grok 4.6 每個 Intelligence Index 任務的成本約為 $0.86。若在你的實際工作負載中,Grok 能否在 Sol 等級的 token 效率下仍保有成本優勢,取決於任務複雜度及代理框架。
真正的風險不在 token 經濟性,而在任務是否能完成。Sol 在 Terminal-Bench 與 DeepSWE 的較高分數,意味著它可能成功處理某些 Grok 無法完成的複雜代理任務,否則就得重試或交由人工介入。無論單價多低,失敗的任務都比成功完成的任務更昂貴。
存取管道與生態系
兩款模型都已不再侷限於單一供應商 API。以下資訊主要整理自 xAI 的 API 頁面與 OpenAI 文件:
| 存取管道 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry(x.ai) | Azure OpenAI(openai.com) |
| AWS | 未列出 | Bedrock(openai.com) |
| Google Cloud | Vertex Model Garden(x.ai) | 未列出 |
| Oracle | OCI Generative AI(x.ai) | 未列出 |
| IDE 整合 | Cursor、Devin | Cursor、Codex |
| SDK 相容性 | OpenAI + Anthropic SDKs(x.ai) | OpenAI SDK |
| 消費者聊天服務 | SuperGrok($30/mo)、X Premium+ | ChatGPT Plus($20/mo)(fritz.ai) |
| 是否使用消費者資料訓練 | 預設加入;需手動退出 | API/Business 資料預設不納入訓練 |
根據 xAI 文件,Grok 同時支援 OpenAI 與 Anthropic SDK,因此遷移時只需更換 API key 與 endpoint。若處理敏感或專有程式碼,OpenAI 對 API 與 Business 資料預設不訓練的政策,在採購上是一項優勢;依據 Fritz.ai 的隱私分析,Grok 消費者則必須自行選擇退出訓練。
該選哪一款模型?
| 工作負載 | 建議選擇 | 原因 |
|---|---|---|
| 高量程式設計代理 | Grok 4.6 | 大規模使用時 token 成本低 2.5 至 5 倍 |
| 複雜多步驟代理任務 | GPT-5.6 Sol(暫定) | 代理基準的領先是相對 Grok 4.5,而非 4.6 |
| 大型程式庫分析(>500K tokens) | GPT-5.6 Sol | 上下文視窗大 2 倍 |
| 成本敏感的批次處理 | Grok 4.6 | 智慧能力接近,但每 token 成本較低 |
| 即時社群/網路研究 | Grok 4.6 | 原生支援 X 與網路搜尋(x.ai) |
| 敏感/專有程式碼 | GPT-5.6 Sol | API 資料預設不用於訓練 |
| 企業 Azure 部署 | 兩者皆可 | 兩者都提供於 Azure AI Foundry |
最可靠的決策方式,是將具代表性的真實任務同時送進兩個 API。比較成功完成率、每個成功任務的中位成本、重試次數與延遲表現,再依結果選擇。
常見問題
Grok 4.6 是否應該改與 GPT-5.6 Terra 比較,而不是 Sol?
Terra($2.50/$15.00)的價格與 Grok 4.6 較接近,但它在所有已公布基準上都低於 Sol:Intelligence Index 為 55.0、Coding Agent Index 為 77.4、Terminal-Bench 為 87.4%(依 OpenAI 資料)。如果以智慧能力對齊,Grok 4.6 與 Sol 才是合理比較;如果以價格對齊,Grok 4.6 對 Terra 則在成本與基準分數上都更有優勢。Luna($1.00/$6.00)比兩者都便宜,但品質取捨也明顯更大。
想進一步了解 Grok 4.6 的規格與能力,可參考我們的 Grok 4.6 指南。如果你想比較 GPT-5.6 與較早期的 Grok 版本,我們的 GPT-5.6 Sol vs. Grok 4.5 分析涵蓋了前代模型的對照。