Google 在三天內推出兩款 Gemini 4 模型:Carbon 於 2026 年 11 月 10 日上市,Hydrogen 則在 11 月 12 日登場。把兩者簡化成「Carbon 聰明、Hydrogen 快」很方便,卻可能讓成本失控。一項 grounded-video 基準測試中,單價便宜 25% 的 Hydrogen 因為輸出了 2.6 倍 Token,最終帳單達 $35.35,反而高於 Carbon 的 $27.94。
兩款模型都可透過 Gemini API 與 AI Studio 使用,模型 ID 分別為 gemini-4-carbon、gemini-4-hydrogen;同樣具備 1,048,576 Token 的統一 Context Window,能接收文字、圖片、音訊、影片與 PDF,並輸出文字(OpenRouter 即時比較)。Carbon 是面向長程推理的前沿模型;Hydrogen 則是由其蒸餾而來、針對速度最佳化的版本,適合日常執行型工作。Google 在 Carbon 發表文章與 Hydrogen 發表文章中也提出一種定位:先讓 Carbon 規劃,再交由 Hydrogen 實際執行。
Token 單價較低,不代表任務帳單較少
本文引用的公開端對端測試,來自 Agnify 的 grounded-video QA benchmark:模型必須找出問題指定的物件、在關鍵影格框選,再持續追蹤其在影片中的位置。測試共有 300 題、1.9 小時影片,兩個模型各自處理相同的 7.6M 輸入 Token。這項影片工作負載的結果,正好讓只看每 Token 價格的算法顯得尷尬。
| 模型 | HOTA | 物件辨識正確率 | 單次執行成本 | 每影片小時成本 |
|---|---|---|---|---|
| GPT-6.1 Terra | 0.6169 | 94.3% | — | $8.19 |
| Gemini 4 Carbon | 0.6016 | 94.3% | $27.94 | $14.60,12 月 1 日起為 $29.20 |
| Gemini 4 Hydrogen | 0.6006 | 95.1% | $35.35 | 約 $18.50,固定 |
| Claude Opus 5.5 | 0.5944 | 92.7% | — | $43 |
Carbon 與 Hydrogen 的 HOTA 僅差 0.001,且信賴區間重疊;統計上可視為平手,也和同一樣本中的 Terra、Sol、Opus 5.5 打成平手。但 Hydrogen 輸出 3.19M Token,Carbon 則是 1.23M;在單物件框選的第 3 階段,中位數更是 387 Token 對 47 Token。有一個泡棉字母案例裡,Hydrogen 消耗 62,138 Token,還框錯字母,得分 0.36;Carbon 僅用 80 Token,得分 0.70。Agnify 完整報告估計,若能把 Hydrogen 第 3 階段的冗長程度壓到 Carbon 的水準,該次執行成本可降至約 $24。
Vercel 的工作負載指南有一條原則可以直接套用:Token 單價相同,不等於每個任務的成本相同。該衡量的是每個被接受任務的成本,還要把重試算進去,而不是每百萬 Token 的價格。
Google 這次實際上推出了什麼
Vercel 的指南將 Argon 定位為整合、知識工作等一般任務的預設起點(Vercel)。以它為基準,Carbon 是難題除錯與開放式科學問題的升級路徑,Hydrogen 則適合大量、流程明確的例行工作。Argon 的詳細內容可參考我們的 Carbon vs Argon 與 Hydrogen vs Argon 指南。
真正有意思的是兩者搭配的架構。根據 Vercel 對 eve 路由的說明與 DataCamp 的 Hydrogen 概覽,Antigravity 的 Orchestrator 模式會先讓 Carbon 以唯讀方式完成規劃,再把檔案修改和測試執行交給 Hydrogen;遇到卡關時,控制權再回到 Carbon。這種組合據報可減少 24% 配額用量,並在接近 Carbon Terminal-Bench 成功率的前提下加快 19% 完成時間:前沿模型只為規劃付一次錢,量大的執行工作則交給快速模型。
兩款模型都是 closed-weights(OnlySOTA),皆支援多模態輸入、文字輸出及推理功能(OpenRouter)。Carbon 提供 low、medium、high 三種 thinking level,預設為 medium;Hydrogen 多了 xhigh,預設則是 high。兩個模型中同名的等級並不代表相同算力,因此每次測試都應記錄模型與等級。
12 月 1 日後,價格公式完全不同
Carbon 的牌價屬於促銷價格,Hydrogen 則採固定費率。這個差異對採購決策的影響,往往比任何基準排行都大。
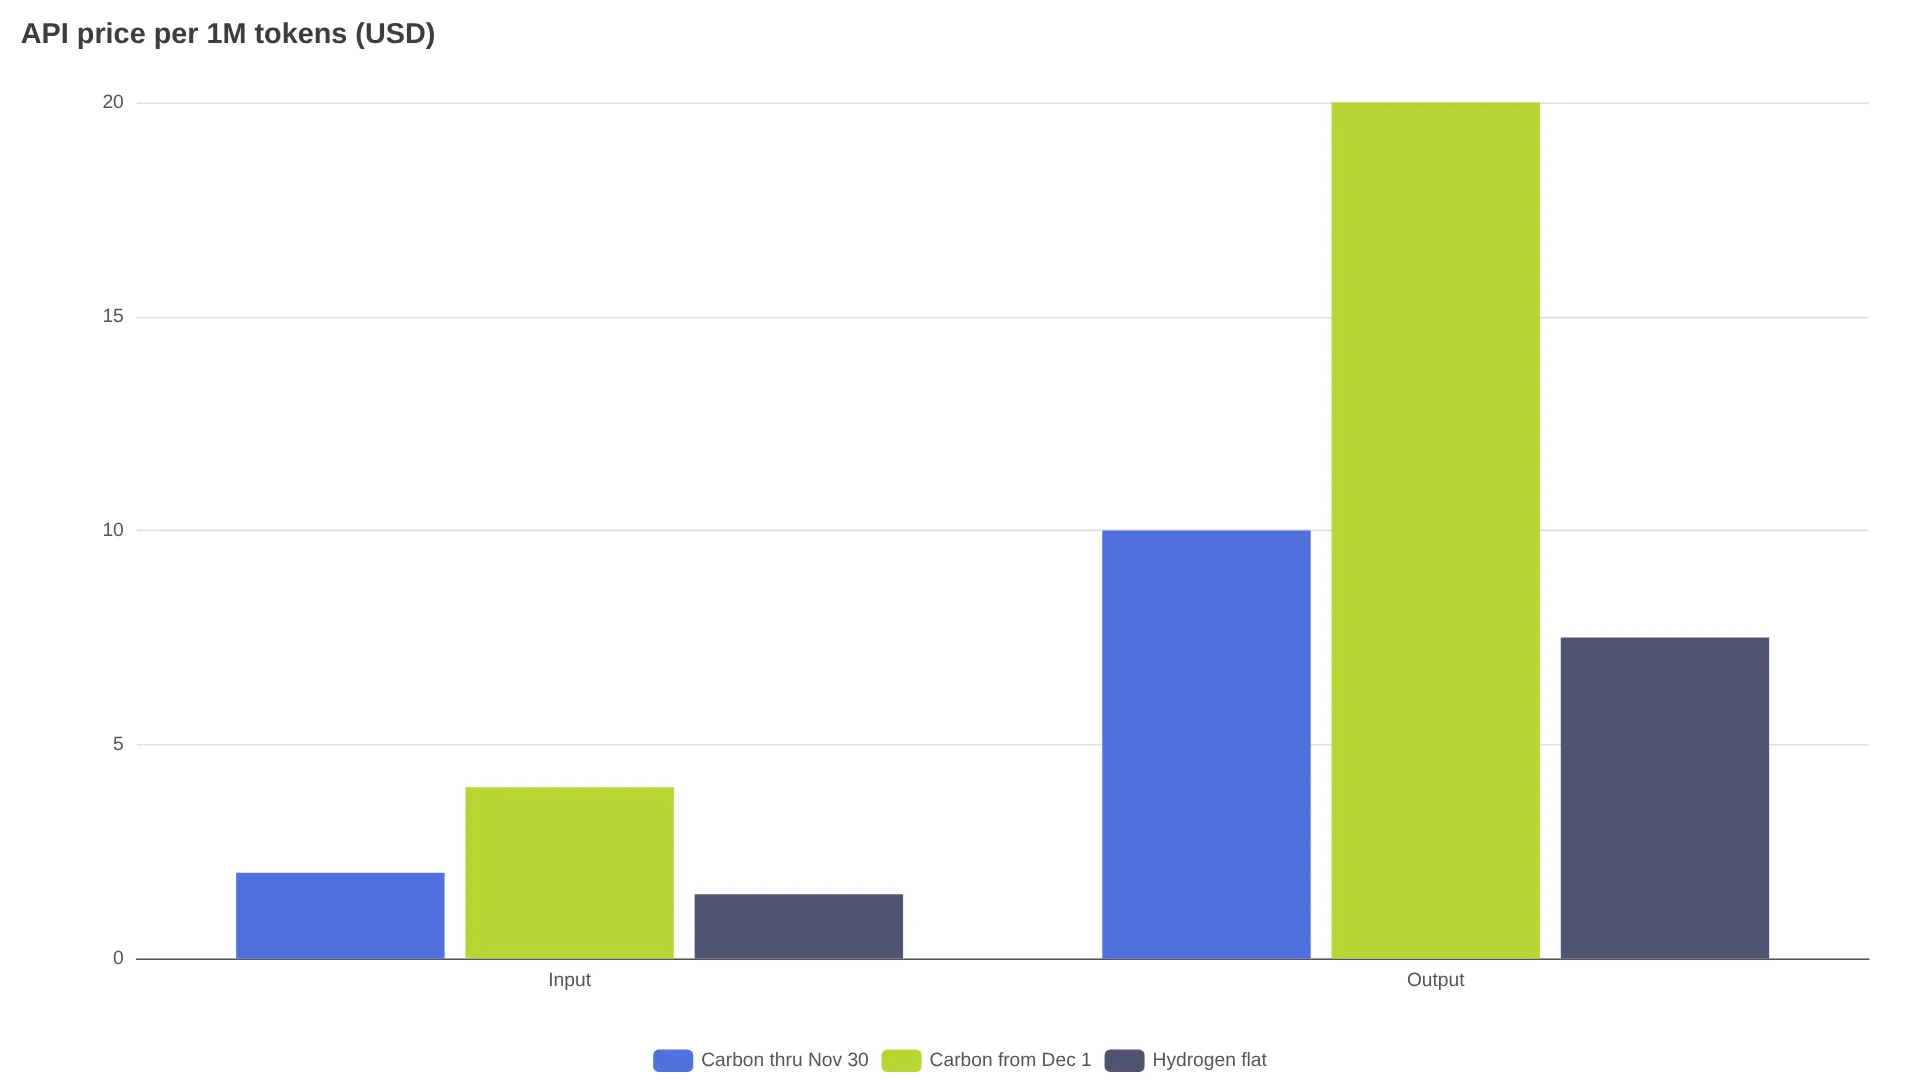
| 級距 | Carbon 截至 11 月 30 日 | Carbon 自 12 月 1 日起 | Hydrogen |
|---|---|---|---|
| 輸入 / 1M | $2.00 | $4.00 | $1.50 |
| 輸出 / 1M | $10.00 | $20.00 | $7.50 |
| 快取輸入 / 1M | $0.10 | $0.20 | $0.075 |
| 輸入+輸出批次處理 | $1.00 / $5.00 | $2.00 / $10.00 | 依供應商而定 |
| 輸入+輸出優先處理 | $3.60 / $18.00 | $7.20 / $36.00 | 依供應商而定 |
定價資料來源包括 LiteLLM 上市首日筆記與 Cloud 價格表所列的 Google 發表費率,以及 DataCamp和 AI Studio 文件提供的 Hydrogen 固定費率。輸出費用包含 thinking tokens,所以 Carbon 的深度推理會讓帳單承受兩層壓力:一層是實際多用的 Token,另一層是 12 月起價格翻倍。
截至 11 月,Carbon 的影片測試雖與 Argon 採相同每 Token 費率,卻因使用 Token 較少而便宜 9%。12 月以後,只要兩者輸出冗長程度相近,Hydrogen 就會更便宜。以 3:1 的輸入對輸出混合比例計算(OnlySOTA),Hydrogen 為 $3.00/M;Carbon 在 11 月為 $4.00/M,12 月起為 $8.00/M。若想透過同一個 Key 呼叫兩者,Gemini 4 Carbon API 頁面可路由至任一模型。
互動體感,取決於速度與 thinking level
OpenRouter 比較資料的即時中位數顯示:Carbon 的 p50 延遲是 11.32 秒、輸出速度 57 tokens/s;Hydrogen 則是 1.68 秒與 144 tokens/s。Hydrogen 的首次回應約快 6.7 倍,吞吐量約為 2.5 倍,對互動式 Agent 的使用感影響極大。
| Hydrogen 等級 | 單次任務成本 | Intelligence Index | 適用情境 |
|---|---|---|---|
low | 約 $0.29 | 27 | 簡單、高量任務 |
medium | 約 $0.80 | 41 | 重視速度的例行工作 |
high(預設) | 約 $1.87 | 51 | 大多數程式設計與 Agent 工作 |
xhigh | 約 $3.16 | 54 | 僅用於較難的多步驟問題 |
估算資料來自 Artificial Analysis,並由 DataCamp 報導。從 high 升至 xhigh,每項任務成本增加 69%,卻只多 3 點指數,而且可能讓模型對簡單提示過度思考。
程式串接時要處理的 API 特性(DataCamp):
thinking_budget與MINIMAL會回傳 HTTP 400,應改用thinking_leveltemperature參數會被忽略- 同步輸出上限為 65,536 Token;根據Agnify 的測試,Carbon 上限更低,為 32,768
- Hydrogen 屬於 short-term GA,至少會提前 45 天通知退役
基準成績應按工作類型看,不是只看獎盃
| 來源 | Carbon | Hydrogen | 比較對象 |
|---|---|---|---|
| Intelligence Index (OnlySOTA) | 60.0,第 2/57 名 | 53.9,第 7/57 名 | — |
| Arena Agent | 0.164,第 3/65 名 | 0.149,第 5/65 名 | — |
| Terminal-Bench 4.0 (OnlySOTA) | 64.5%,第 3/59 名 | 56.4%,第 12/59 名 | Sonnet 5.5 64%(AA 獨立資料) |
| Arena Code | 1768,第 4/157 名 | 1704,第 11/157 名 | — |
| Arena Text | 1526,第 1/421 名 | 1490,第 15/421 名 | — |
| Agents' Last Exam (DataCamp) | 77.4% | 71.6% | Argon 69.0% |
| AA-Omniscience 幻覺率 | — | 8% | 比 Flash 3.8 少 5 倍捏造內容(Google 經 DataCamp) |
OnlySOTA 彙整第三方排行榜,本身並不執行測試(OnlySOTA)。Google 經由 DataCamp 公布的調整版 Terminal-Bench 4.1 成績為:Hydrogen 57.0%,Flash 18.2%,Sonnet 63.9%。結論是,Hydrogen 在 Agentic coding 上頗具競爭力,但若工作高度依賴終端機操作,它不是最佳選擇。
眼前真正的阻礙,是能不能取得模型
模型 ID 已穩定下來(gemini-4-carbon、gemini-4-hydrogen)。Hydrogen 文件標示可用於所有 API 方案,包括受速率限制的免費層(DataCamp、AI Studio 文件)。Carbon 則限付費 API 與 Ultra 方案使用(Carbon 發表文章)。不過實務上的推送狀況並不整齊:Hydrogen 會因 App 與帳號不同而出現、消失,甚至自動取代 Flash(r/GeminiAI 發表討論串)。詳情可見我們的 Hydrogen 定價與上線狀態追蹤頁。
任何遷移評估都該把配額回報納入成本考量:
「昨天的限制比較寬鬆。我是付費 pro 用戶。今天的提示詞,例如寫一章約 6–7k 字,會吃掉約 4–5%。昨天 Hydrogen 出現時,3 章大約只用了 5 小時配額的 2%。5 小時限制根本是笑話。」— u/Neat_Reaction9164,r/GeminiAI
「我今天拿它和 Sonnet 寫程式;Hydrogen 確實很強,效率也出乎意料,而 Sonnet 表現則好壞參半,還碰到用量限制……現在下定論仍太早。」— u/mmmtv,r/GeminiAI
請用實際要上線的路由測試,無論是 AI Studio、Antigravity、Cursor 或 API;方案等級、整合方式及 thinking level 都可能大幅改變有效配額。如果使用自動路由,也別漏算決策呼叫的延遲與成本:Vercel 的 eve 模式每回合會使用 google/gemini-decision-1,並以 Argon 作為 fallback。
依工作負載做決定
多數 API 工作負載可歸入以下三種情境:
- 日常大量工作直接用 Hydrogen。適合可檢查 diff 的例行程式修改、格式已固定的資料擷取、單一來源問答及大量分流。固定使用
high,在medium做回歸測試;只有明確證實多步驟情境需要時,才保留xhigh。 - 把困難的 10% 升級給 Carbon。例如彼此競爭的解釋、修補可能掩蓋症狀的根因分析、需要設計鑑別測試的衝突實驗,或修正案會覆蓋原提案的文件集合。接受它的延遲,以及 12 月後的價格。
- 兩者搭配使用。Carbon 進行唯讀規劃,Hydrogen 執行修改與測試,若卡關再由 Carbon 接手。這種配置據報可減少 24% 配額用量,並縮短 19% 完成時間。
尚未完全解決的取捨,在於輸出冗長的風險。Agnify 的探測中,Hydrogen 預設 high 輸出 89 至 201 個 thought token,Carbon 預設則為 51 至 64。應設定輸出上限,並以自己的提示詞量測實際輸出 Token。目前規劃 Hydrogen 預算時,應依實際產生的 Token,而不是標價 Token 來算。
常見問題
Carbon 的推理能力比 Hydrogen 好嗎?
是。Intelligence Index 為 60.0 對 53.9,Terminal-Bench 4.0 為 64.5% 對 56.4%,Arena Text 是第 1 名對第 15 名;不過影片 QA 的 HOTA 為 0.6016 對 0.6006,可視為平手。
哪一款更便宜?
Hydrogen 固定為每 1M $1.50/$7.50。Carbon 在 11 月 30 日前為 $2/$10,12 月 1 日起為 $4/$20。
哪一款更快?
Hydrogen:中位延遲 1.68 秒,Carbon 為 11.32 秒;吞吐量為 144 對 57 tokens/s。
兩者的 Context Window 一樣嗎?
是,兩者都是統一的 1,048,576 Token。
Carbon 可以規劃、Hydrogen 負責執行嗎?
可以,可透過 Antigravity Orchestrator,或以 gemini-decision-1 進行每回合路由。
該選哪個 thinking level?
Carbon 選 medium,Hydrogen 選 high;只有接受率可量化地提升時,才使用 xhigh。