 AIREITER
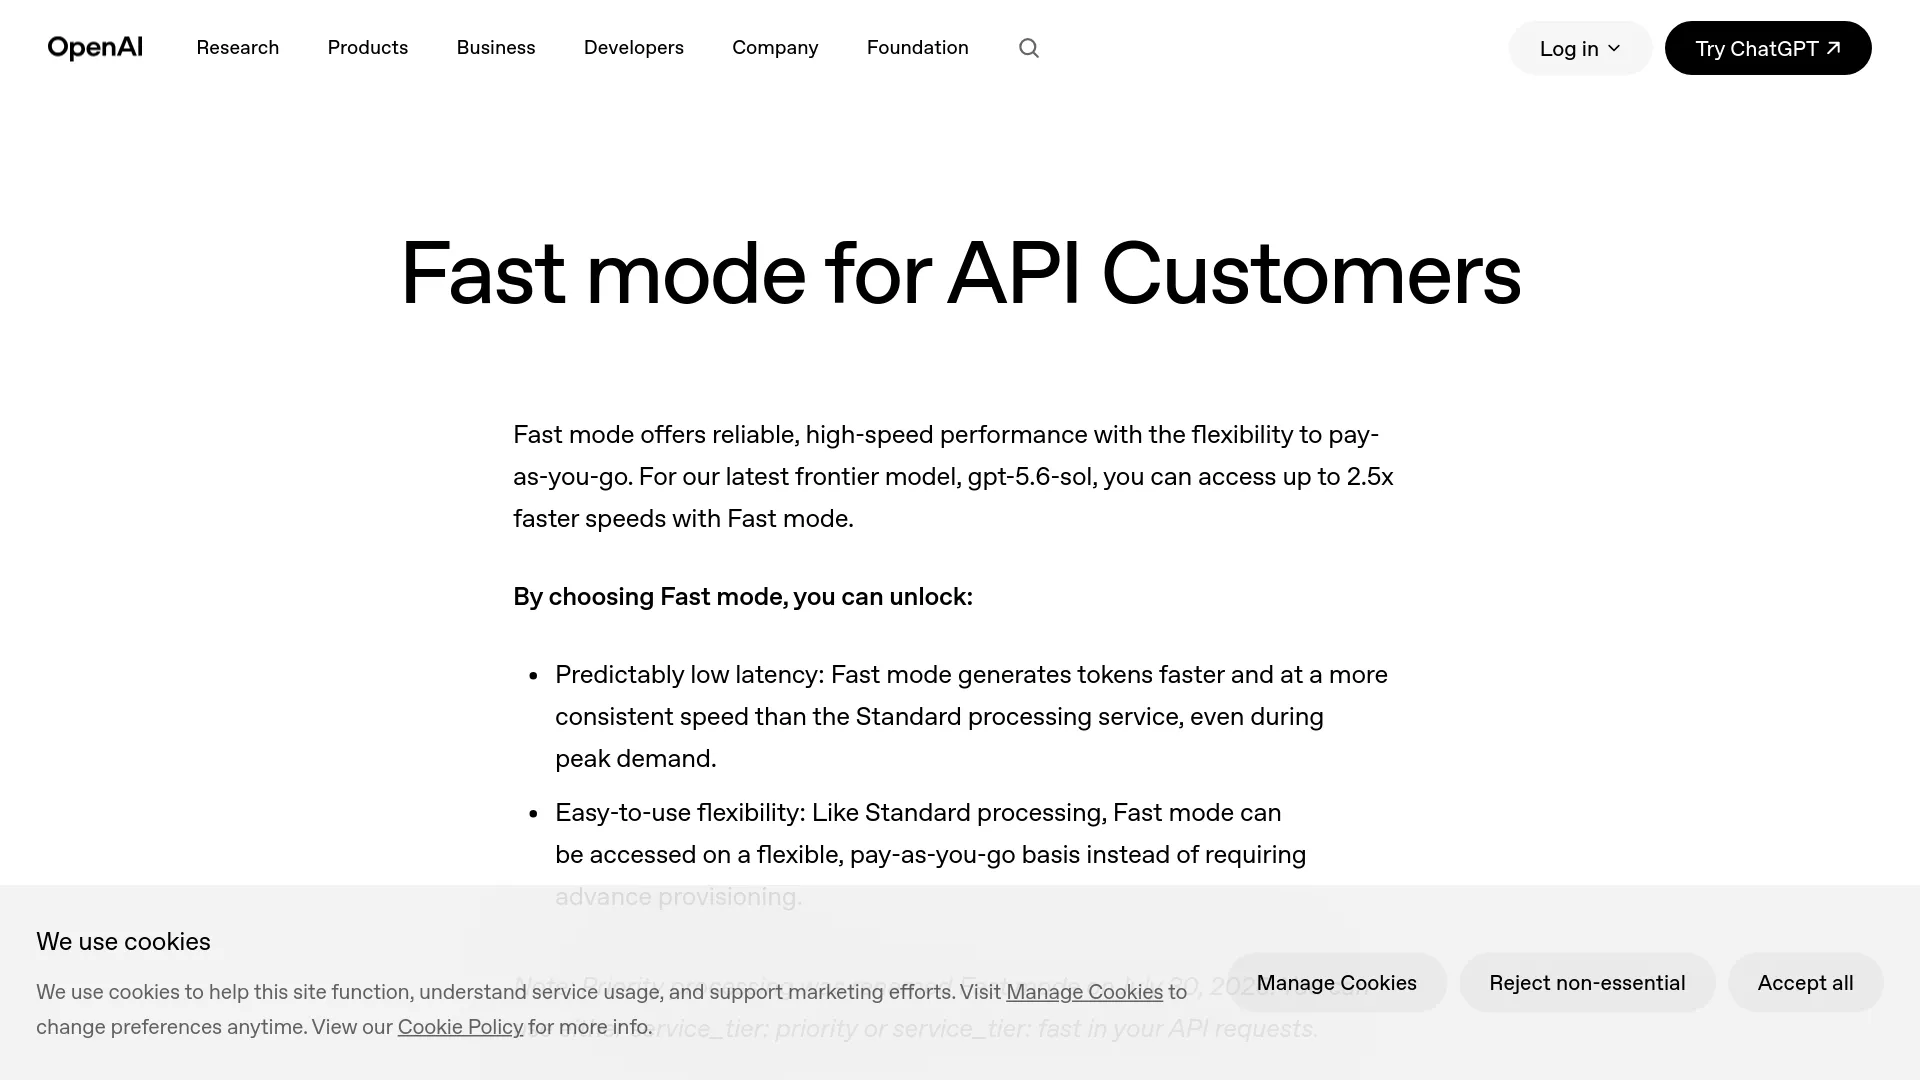
OpenAIには現在、「fast」や「ultra」を冠する選択肢が3つある。しかし、750トークン/秒に到達するのはそのうち1つだけだ。2026年8月13日に発表されたOpenAI Ultrafast modeは、Cerebrasのウェハースケールチップ上でGPT-5.6 Solを動かし、Standardの最大14倍の速度をうたう新しいAPIサービス階層である。ただし、利用できるのは招待された一部顧客のみで、価格も未公表。今すぐ購入できる最速の階層は、入出力100万トークンあたり$10/$60のFast modeとなる。
ultra、Fast mode、Ultrafast modeの違い
GPT-5.6 Solを使う際、「速度」に関係しそうな名称は3つあるが、それぞれ指すものはまったく異なる。まずは一覧で整理しよう。
| 名称 | 内容 | 利用方法 | Solの価格(100万トークンあたり) | 公称速度 |
|---|---|---|---|---|
ultra reasoning設定 | 1つのタスクにサブエージェントと追加計算リソースを投入する推論・作業モード | Codexの設定。個別に購入するAPI階層ではない | 単独料金はなし。利用上限を速く消費する | 設計上、低速 |
| Fast mode | APIの処理階層。2026年7月30日にPriorityから名称変更 | APIリクエストでservice_tier="fast"を指定 | 入力$10/出力$60(短いコンテキスト) | Standardの最大2.5倍 |
| Ultrafast mode | GPT-5.6 Sol向けのCerebrasベースAPI階層。2026年8月13日にプレビュー公開 | 一部顧客限定のプレビュー | 未公表 | Standardの最大14倍 |
方向性も対照的だ。ultraは、速度よりも精度・深さを優先するサブエージェント作業モードである。一方のUltrafast modeは、同一モデルのデコード速度を純粋に引き上げるものだ。その中間に位置するのが、レイテンシ短縮を料金で購入できるFast modeであり、詳細はOpenAIのFast modeページで公開されている。
8月13日のプレビューで明らかになったこと
公式発表で確認できる具体的なポイントは5つある。UltrafastはまずOpenAI APIで提供され、対象モデルはGPT-5.6 Solのみ。Standard処理の最大14倍、出力は最大毎秒750トークンで、Cerebrasが基盤を担う。提供形態は限定プレビューで、Jane Street、Podium、Basis、Rogoを含む選ばれた顧客が対象となっている。
反対に、購入判断に必要な情報で発表に含まれていないものも4つある。トークン単価、モデルID、レート制限、レイテンシSLAだ。名称付きのベンチマークも提示されていない。
OpenAIが示したのは、1つのプロンプトから3D倉庫シミュレーターを構築するUltrafast版SolとStandard版Solの並列デモである。RogoのAlex Wangによる「Ultrafastによって、複雑な金融リサーチがリアルタイムの対話のように感じられる」というコメントは、このサービスが狙う体験を端的に表している。
最大2.5倍と14倍の差は実務でどう効くか
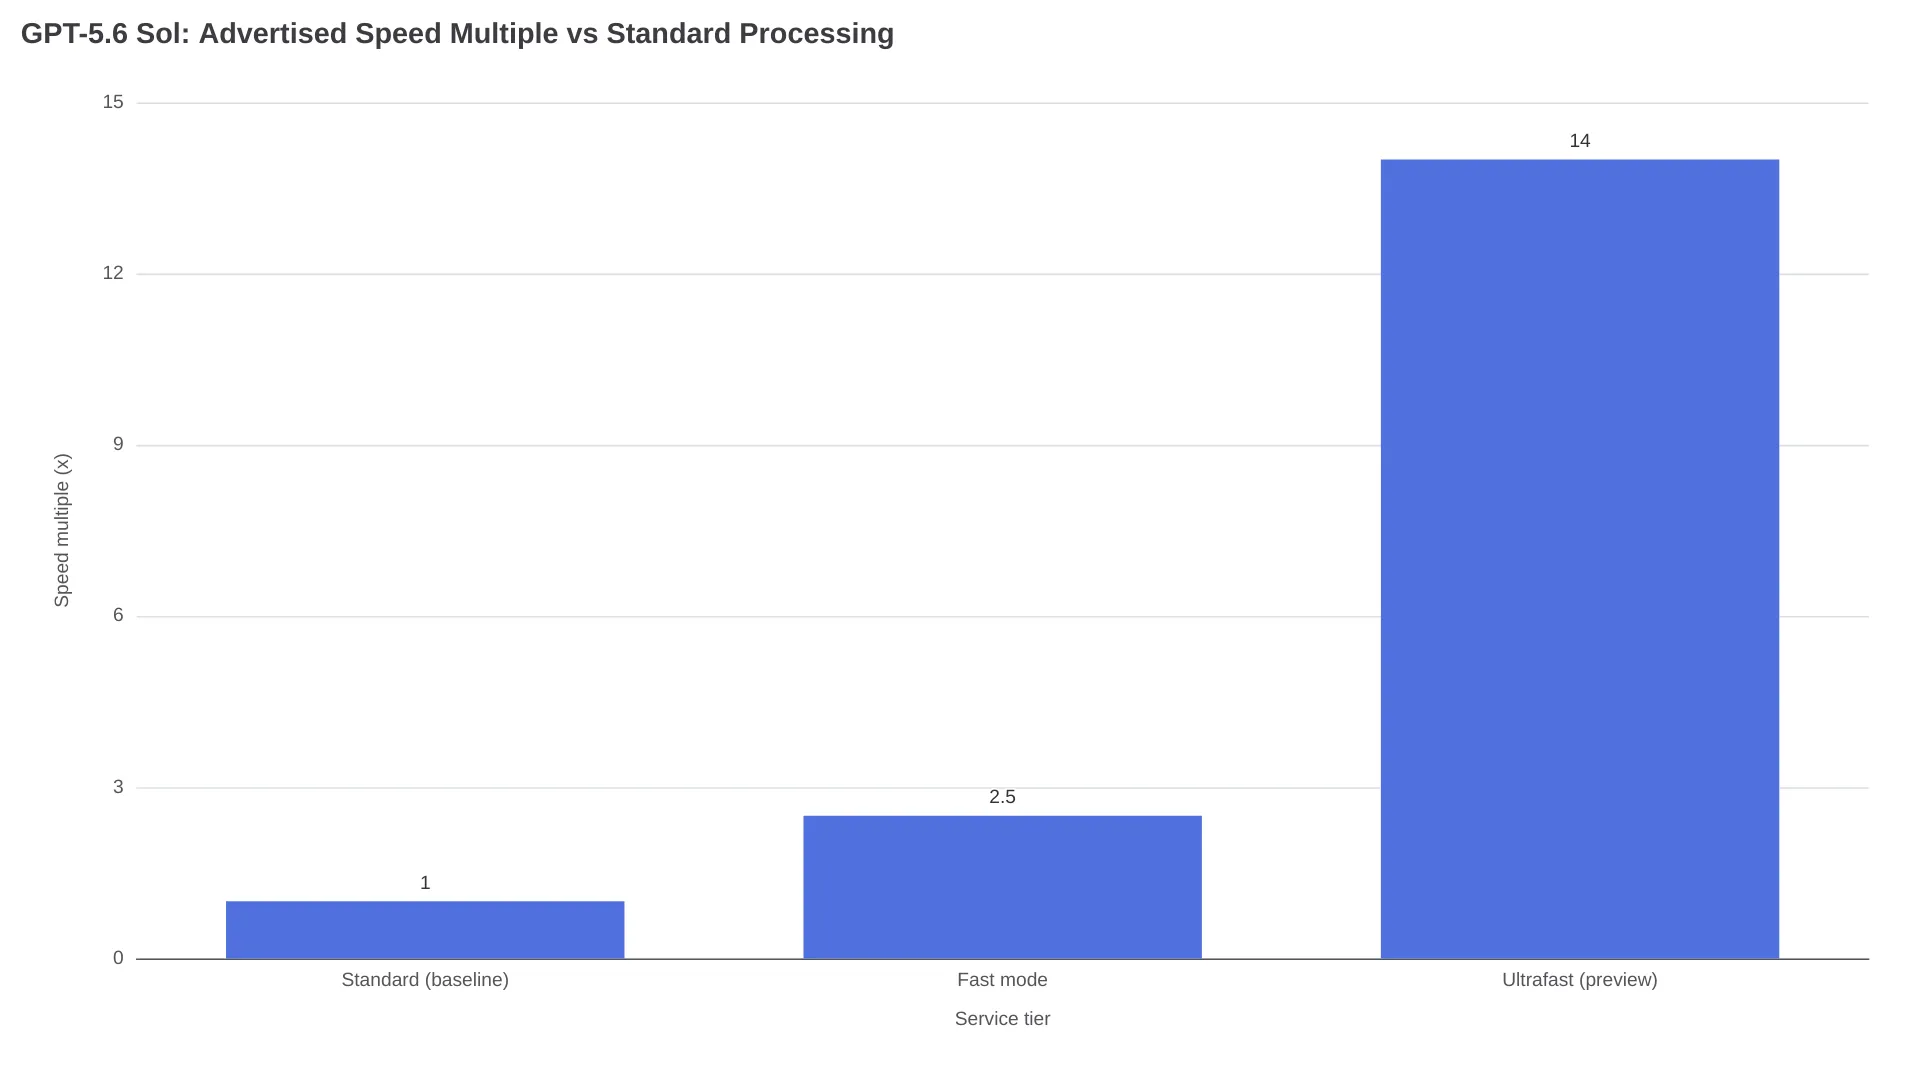
数値を比較するうえで注意したい点がある。750トークン/秒は公称の出力スループットであるのに対し、Fast modeの数値はSLAの下限値だ。関連はしているものの、同一の指標ではない。750を14で割ると、Standard Solのデコード速度はおよそ毎秒54トークンと推定できる。この前提では、10,000トークンの生成はStandardで約186秒、Fast modeのEnterprise向けSLA下限である毎秒80トークンでは最大125秒、Ultrafastでは約13秒となる。
| ワークロード | Standard(約54 tok/s、推定値) | Fast mode(SLA ≥80 tok/s) | Ultrafast(公称750 tok/s) |
|---|---|---|---|
| 10,000トークン生成 | 約186秒 | ≤125秒 | 約13秒 |
| 1ターン1,000トークンの5ターン・エージェントループ | 約93秒 | ≤63秒 | 約7秒 |
r/AIToolsPerformanceで出回っている数値では、これらの比較はArtificial AnalysisとCerebrasに由来するとされる。UltrafastはClaude Fable 5の11倍、Fast mode上のOpus 4.8の5倍の速度であり、Humanity's Last Examの全2,500問を11時間11分で完了したという。Fable 5では78時間27分だったとされる。ただし、いずれもベンダー報告の数値であり、独立した再現検証はまだ行われていない。
プレビュー外では分からないUltrafastの価格
Ultrafastの価格は公表されていない。発表には料金が一切なく、コミュニティもすぐにこの点を指摘した。r/AIToolsPerformanceの投稿者の言葉を借りれば、「ブログが語っていないのは価格だ。プレビュー参加者以外は、誰もコストを知らない」。
現時点で参照できるGPT-5.6 Solの料金体系は、すべて100万トークンあたりで以下のとおりだ。
| 階層 | 入力(短いコンテキスト) | 出力(短いコンテキスト) | 入力(長いコンテキスト >272k) | 出力(長いコンテキスト) | キャッシュ済み入力 |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | 未公表 | 未公表 | 未公表 | 未公表 | 未公表 |
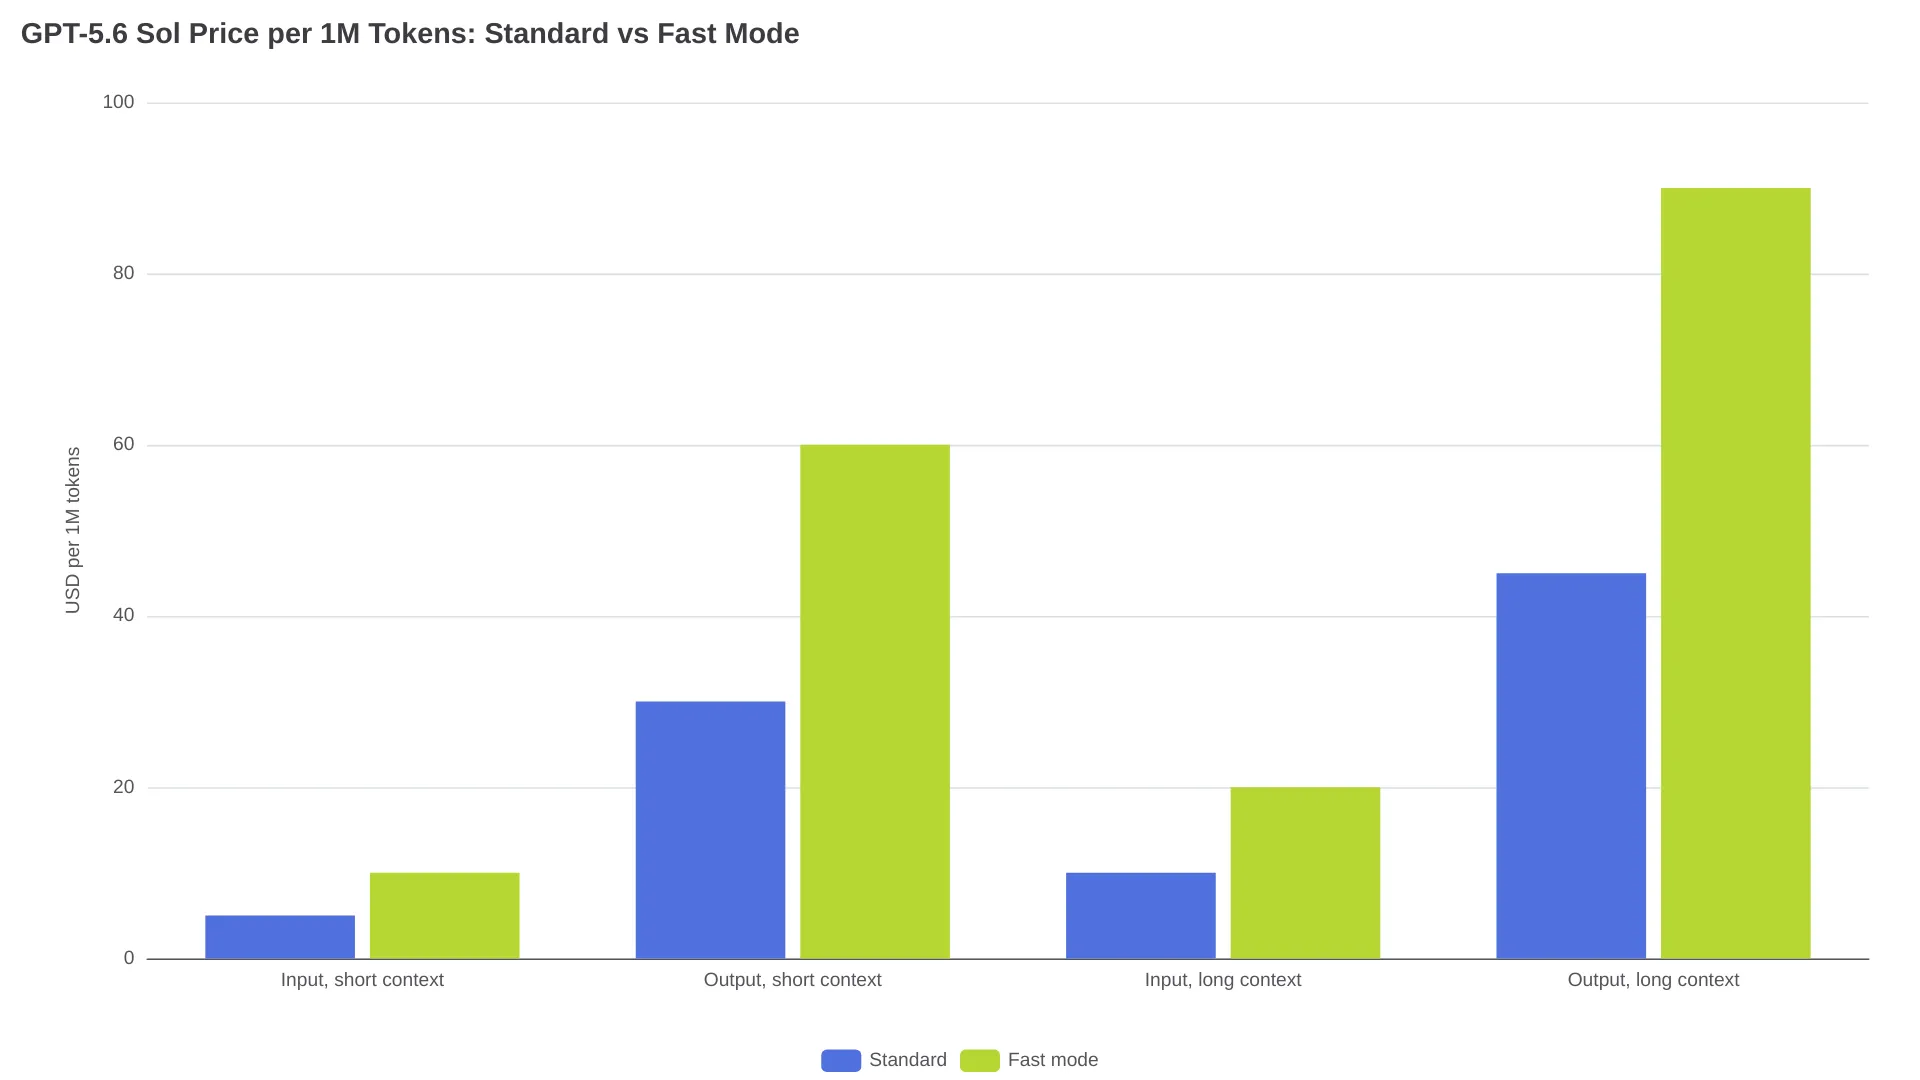
SolのFast modeはStandardのちょうど2倍だが、この倍率からUltrafastの価格を推定する根拠はない。料金はどちらの方向にも変動しうる。実際、OpenAIは7月30日にTerra/Lunaの価格を引き下げている。また、レイテンシ予算を考えるならFast modeの細則も重要だ。毎分100万トークンを超え、15分未満でトラフィックが50%超増加した場合、超過リクエストは自動的にStandardへダウングレードされる。この場合はservice_tier="Default"が返され、Standard料金で請求される。
利用条件:現時点では招待制
Ultrafastへのアクセスは公開待機リストではなく招待制だ。OpenAIは、容量の拡大に応じてプレビューを拡張するとしており、発表ページではアクセス情報の通知登録を受け付けている。7月の報道では、初期段階のSolアクセスに入っていた組織は約20社とされていた。
このインフラには前例がある。OpenAIとCerebrasの提携は2026年1月14日に始まり、750 MWのウェハースケール容量を確保している。また、同じハードウェア上ではGPT-5.3-Codex-Sparkがすでに毎秒1,000トークンを超えている。
招待を待たずに出力速度を上げる方法
Fast modeはすでにすべてのAPI顧客が利用でき、有効化はパラメーターを1つ追加するだけで済む。
/v1/responsesまたは/v1/chat/completionsへのリクエストにservice_tier="fast"を追加する。- 従来の
service_tier="priority"も引き続き利用可能だ。既存モデルは使用状況ダッシュボードでpriorityと表示される一方、GPT-5.6以降のモデルではfastと表示される。 - プロジェクト全体の既定値にするには、Project settings -> Default Service Tier -> Fastを設定する。
| Fast mode対応モデル | 100万トークンあたりの価格(入力/出力) | レイテンシSLA |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
3モデルのうち、SLA下限が最も高いのはLunaだ。キャッシュ読み取りでは入力コストを90%削減できる。Standard Solなら$0.50/Mで、TTLはおよそ30分である。どの階層でも、長く維持するセッションのほうが毎回新規リクエストを送るより有利になる。実トラフィックで各階層を試すなら、GPT-5.6 API endpointでは3モデルを単一インターフェースから利用できる。
FAQ
Ultrafast modeはChatGPTやCodexでも使える?
いいえ。UltrafastはまずOpenAI APIで提供されており、発表ではChatGPTおよびCodexへの提供時期は示されていない。
Cerebras上でGPT-5.6 Solを動かすと出力品質は変わる?
OpenAIはUltrafastを別モデルではなく、同じGPT-5.6 Solを高速に提供するものとして位置付けている。現時点での品質に関する主張は、Cerebras報告の、品質低下なしでGDP-Valを5.6倍高速化したという内容のみであり、独立ベンチマークによる再現はまだない。
Ultrafast modeにレイテンシSLAはある?
公開されていない。Fast modeはEnterprise顧客向けに、p50で>80トークン/秒、稼働率99.9%のSLAを掲げている。一方、Ultrafastはプレビュー期間中のSLAを明示していない。
Ultrafast modeに対応するモデルは?
GPT-5.6 Solのみ。TerraとLunaはFast modeに対応するが、Ultrafastプレビューの対象ではない。
Ultrafast modeはいくらになる?
公式料金は存在しない。現時点での唯一の参考材料は、Fast modeがStandard Solに対して設定している2倍のプレミアムである。