 AIREITER
スクリーンショットや動画を扱うならGLM-5.3-Flash、長い共通プロンプトをキャッシュしてテキストやコードを大量処理するならDeepSeek V4 Flashが有力です。単一ベンチマークの勝敗より、実際のワークロードと課金経路で選ぶべき2モデルです。
まず確認したいモデルIDと比較対象
ここで比較するのは、GLM-5.3-Flash(glm-5.3-flash)と、DeepSeekの本番APIモデルであるdeepseek-v4-flashです。DeepSeekの公式料金ページでは後者をDeepSeek-V4-Flash-0731として案内しています。DeepSeek V4 Proや、別エンドポイントのdeepseek-v4-flash-vision-expは、このFlashモデルの代替としては扱いません。Ox Alphaとしての位置付け、ハードウェア制約、プレビュー版に関する注意点は、AIReiter GLM-5.3-Flash reviewを参照してください。
用途別:最初に選ぶべきモデル
| 優先したいこと | 選ぶモデル | 理由 |
|---|---|---|
| スクリーンショットからの実装、UI確認、動画・ファイル入力 | GLM-5.3-Flash | 1モデルで画像、動画、ファイルをネイティブに入力できる |
| キャッシュヒット率が高い、テキストのみの大量処理 | DeepSeek V4 Flash | 公式のキャッシュ済み入力料金が低く、特にオフピーク時に有利 |
| GLMのキャンペーン期間中に、未キャッシュ入力と出力が多い処理 | GLM-5.3-Flash | キャンペーン中の入力・出力単価は、DeepSeek公式のキャッシュミス・出力単価を下回る |
| ターミナル中心のコーディングと、堅実な本番導入の判断 | DeepSeek V4 Flash | バージョン付きのパブリックベータ経路と、Flash向けの公式評価結果がある |
| 視覚情報を使うブラウザ/コンピュータ操作エージェント | GLM-5.3-Flash | コーディングやツール実行のループ内で視覚的フィードバックを扱える |
| 100万トークンのテキストコンテキスト | どちらも安易には選ばない | 両者とも100万トークン級を掲げるが、実際のプロンプト長で検索・参照性能を検証すべき |
| テキスト、コード、画像を1モデルで処理したい | GLM-5.3-Flash | 主要なマルチモーダル経路で別途ビジョン用エンドポイントを使わずに済む |
公式仕様から見える違い
GLMのモデル仕様と課金情報は、Z.AI model documentationおよびZ.AI pricing pageに掲載されています。DeepSeek側のFlashのバージョンと機能は、Models & Pricing documentationとchange logで確認できます。
| 仕様 | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| APIモデルID | glm-5.3-flash | deepseek-v4-flash |
| 公開バージョン | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| コンテキストウィンドウ | 100万トークン | 100万トークン |
| 公式ドキュメント記載の最大出力 | 128Kトークン | 384Kトークン |
| 主な入力形式 | テキスト、画像、動画、ファイル | テキストとコード。ビジョンは実験的な別モデル |
| 出力 | テキスト | テキスト |
| 推論制御 | Thinking有効、reasoning_effortに対応 | Thinking/非Thinkingモード、low・high・maxの推論強度 |
| ツールと構造化出力 | Function calling、ストリーミング、コンテキストキャッシュ、JSON出力 | ツール呼び出し、JSON出力、Responses API、Anthropic API互換 |
| 重み | プロバイダーがオープンウェイトを公開 | プロバイダーがオープンウェイトを公開 |
GLMの総パラメータ数320B、アクティブパラメータ数18Bは、疎な専門家モデルのアーキテクチャを示す数字です。18Bのローカルチェックポイントを意味するわけではありません。DeepSeekの公式Flash料金ページには、比較可能なパラメータ数は掲載されていません。
GLMはメインモデルの経路で視覚入力を受け付けます。一方、DeepSeekではdeepseek-v4-flash-vision-expが別途提供されており、ルーティングとテストの前提が変わります。
コーディングとエージェントは、別々に評価する
ターミナル型エージェントで問われるのは、リポジトリを理解し、ツールを実行する力です。ビジュアル型エージェントではさらに、レンダリング後のUIやGUI状態を読み取る能力も必要になります。
ターミナル操作とリポジトリ作業
Z.aiのlaunch tableと、DeepSeekのofficial July 31 updateでは、以下の結果が報告されています。
| ベンチマーク | GLM-5.3-Flash | DeepSeek V4 Flash | 根拠の位置付け |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | 各プロバイダーが個別に報告した評価 |
| DeepSWE | 63.4 | 54.4 | 各プロバイダーが個別に報告した評価 |
| Toolathlon Verified | 78.4 | 70.3 | 各プロバイダーが個別に報告した評価 |
| AutomationBench | 48.8 | 25.1 | 各プロバイダーが個別に報告した評価 |
| Agents’ Last Exam | 26.3 | 25.2 | 各プロバイダーが個別に報告した評価 |
これらのプロバイダー報告ベンチマークではGLMが上回っています。ただし、評価ハーネスが異なるため、導入モデルを即決する材料ではなく、候補を絞るための参考値として扱うべきです。
独立系の検証を見ると、優劣はそこまで単純ではありません。Composioは8月27日、30件のマルチステップエージェントタスクをテストし、GLM-5.3-Flashは21/30、DeepSeek V4 Flashは20/30を完了したと報告しました。DeepSeekは30タスク中19タスクで最速でした。また、成功タスクあたりの報告コストは、DeepSeekが約$0.028、GLMが約$0.06でした。これらは両プロバイダーではなく、Composioのテストによる数値です。
ターミナル中心のエージェントでは、速度、再現性、説明しやすい初期選定を重視するなら、まずDeepSeek V4 Flashから始めるのがよいでしょう。ただし、初回での修復品質や、より幅広いツール挙動に価値があるなら、低コストなDeepSeekとの比較対象としてGLMも含める価値があります。
ツール実行、ブラウザ状態、視覚的フィードバック
エージェントが自分のコードによる出力を確認する必要がある場合、プロダクトとの適合性ではGLMが強みを持ちます。Z.aiは、モデルがスクリーンショットやレンダリング済みインターフェースを読み、実装を修正し、再び結果を確認するループを説明しています。これはスクリーンショットからの実装、フロントエンドデバッグ、ブラウザ利用、ドキュメント処理、一部の3Dワークフローに当てはまります。
DeepSeekはdeepseek-v4-flashを通じてテキスト・コード中心のエージェント処理に対応しますが、視覚入力には別経路のdeepseek-v4-flash-vision-expが必要です。既存パイプラインにビジョン用のルーティングがあるなら、この分離は問題にならないかもしれません。ソースコード、ブラウザのスクリーンショット、動画をエンドポイントの切り替えなしに行き来するエージェントなら、GLMのほうが素直に使えます。この代替経路については、DeepSeek V4 Flash Vision Exp API guideで解説しています。
ベンチマーク後に見えてくる実利用の声
コミュニティでの評価は、万能な勝者ではなくトレードオフを示しています。あるユーザーは2日間の集中的なGLM-5.3-Flash利用後、小さめのコンテキストでは有能だと評価する一方、プロンプトが大きくなると安定感を欠くと述べ、画像対応は評価しています。
「大きくなると、不安定で雑な挙動をし始める。」— @XBToshi、2日間にわたってGLM-5.3-Flashを集中的に使った結果を公開比較で報告
これは失敗率を示すデータではなく、あくまで逸話的な証拠です。それでも、ベンチマーク表だけでは見えない失敗モードを示しています。大きなコンテキスト上限があっても、マルチターンのエージェント挙動が安定するとは限りません。
小規模なOllama experimentでも、プロバイダー固有のクォータ単位ではDeepSeekが有利という結果でした。ただし、投稿者はその単位をAPIのドル建てコストと同一視していません。
レイテンシと配信性能の根拠で結論は変わる
この2モデルそのものを同一ハーネスで比較したp50レイテンシやスループットの公開データはありません。Pro、Vision-Exp、別経路の結果を流用してはいけません。ComposioではDeepSeekが30件中19件のエージェントタスクで最速でしたが、これはスループットを直接示すものではないものの、有用なシグナルです。対話型アシスタントでは最初の有用なツール呼び出しまでの時間を、バッチ処理では受け入れ可能な結果に至るまでの実時間を測定してください。
トークン単価と完了タスク単価は別物
公式料金表を見ると、「DeepSeekのほうが安い」と一括りにはできません。Z.AIは、GLM-5.3-Flashを2026年9月9日24:00 UTC+8まで50%割引で提供しています。DeepSeekはキャッシュヒットとキャッシュミスを分け、さらにピーク・オフピークで料金を設定しています。
以下の金額はすべて、100万トークンあたりの米ドルです。
| 課金項目 | GLM-5.3-Flash キャンペーン価格 | GLM-5.3-Flash 通常価格 | DeepSeek V4 Flash オフピーク | DeepSeek V4 Flash ピーク |
|---|---|---|---|---|
| 新規入力/キャッシュミス入力 | $0.075 | $0.15 | $0.22 | $0.44 |
| キャッシュ済み入力 | $0.015 | $0.03 | $0.007 | $0.014 |
| 出力 | $0.25 | $0.50 | $0.66 | $1.32 |
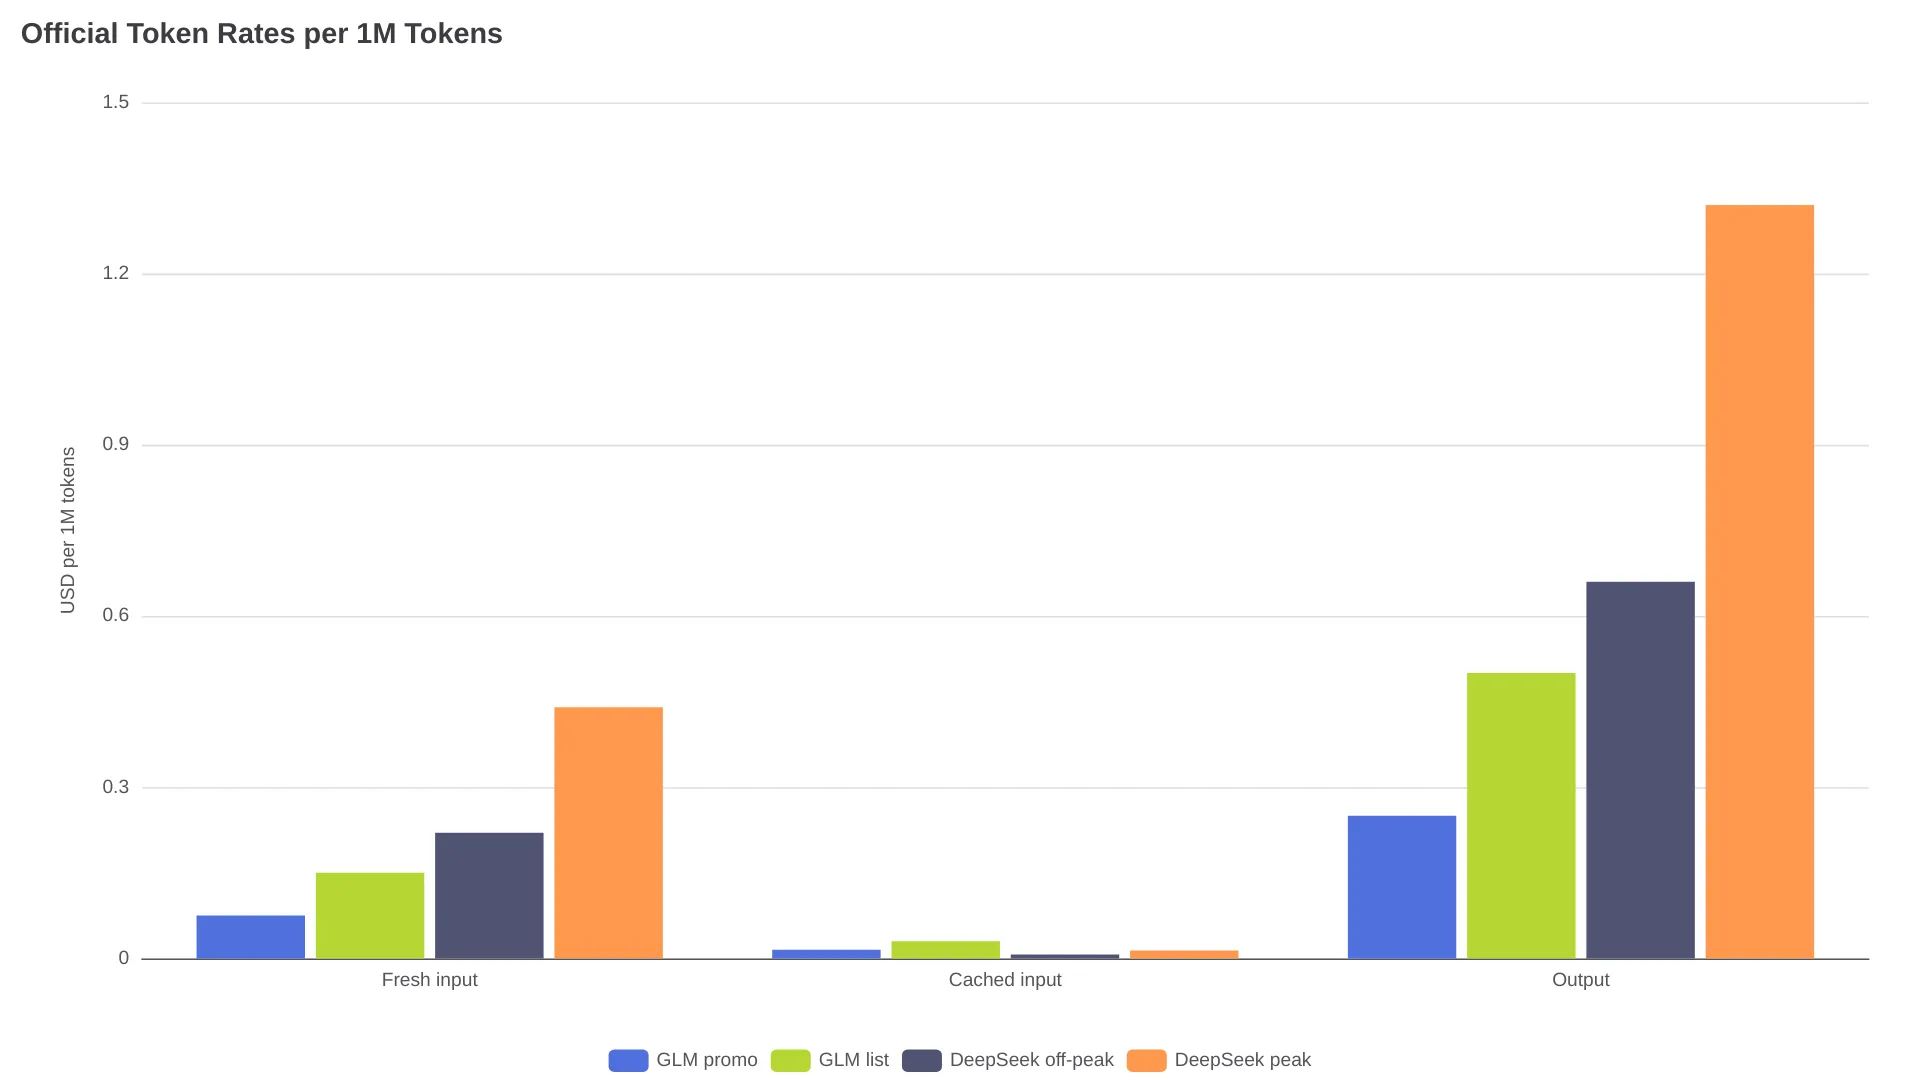
DeepSeekのピーク時間帯は、月曜日から金曜日の01:00~04:00 UTCおよび06:00~10:00 UTCです。それ以外はオフピークとなります。公式表にはV4 Flashの同時実行数として2,500も記載されています。GLMの料金ページでは期間限定でキャッシュ済み入力の保存を無料としていますが、共通して適用される同時実行数は掲載していません。
- キャッシュ済み入力の単価はDeepSeekが有利です。対応する各時間帯でGLMを下回ります。
- 未キャッシュ入力と出力では、キャンペーン中のGLMが有利です。DeepSeek公式のキャッシュミス・出力料金を下回ります。
- キャンペーン終了後も、GLMの通常の新規入力・出力料金は、DeepSeekのオフピーク料金を下回ります。
- DeepSeekの料金面で最も有利なケースは、キャッシュ比率が高く、入力主体で出力が短いトラフィックを、特にオフピークに実行する場合です。
入力1,000万/出力200万トークンでの試算
ツール料金やリトライを含めず、新規入力トークン1,000万、出力トークン200万と仮定します。
| モデルと課金経路 | 計算式 | 合計 |
|---|---|---|
| GLM キャンペーン価格 | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM 通常価格 | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek オフピーク、キャッシュミス | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek ピーク、キャッシュミス | 10 × $0.44 + 2 × $1.32 | $7.04 |
1,000万入力トークンがすべてキャッシュヒットなら、DeepSeekのオフピーク合計は$1.39(10 × $0.007 + 2 × $0.66)です。一方、GLMのキャンペーン価格では$0.65(10 × $0.015 + 2 × $0.25)になります。入力と出力の比率がさらに大きく、出力が短いほど、DeepSeekのキャッシュ優位性は重要になります。
DeepSeekの低コストが決定打になるケース
多くのリクエストで長く安定したシステムプロンプトやリポジトリのプレフィックスを再利用し、回答が短く、ピーク時間外に実行できるなら、DeepSeek V4 Flashを選ぶ価値があります。分類、抽出、要約、定型的なテキストのみの自動化は、スクリーンショット主導のエージェントよりもこの条件に当てはまります。
GLMの追加機能がトータルで安くなるケース
画像、ドキュメント、動画のために別のビジョンリクエストが必要になるパイプラインでは、GLMが全体のコストを下げられる可能性があります。長いコードパッチを生成するエージェントでは、キャンペーン中の低い出力単価も効きます。ただし、常にタスク単価で勝てると決めつけず、実際に課金されたトークン、修復ループ、受け入れられたタスクの割合で検証してください。
長大なコンテキストは容量であり、品質保証ではない
両社の公式ドキュメントは100万トークンのコンテキストウィンドウを掲げているため、コンテキスト長だけで見れば引き分けです。DeepSeekの最大出力は384Kトークン、Z.AIのGLM-5.3-Flashの最大出力は128Kトークンと記載されています。この差が意味を持つのは、極端に長い生成を許容するアプリケーションに限られます。
Z.aiはGLM-5.3比で、注意計算が3.01倍低く、KVキャッシュサイズが4.44倍小さいと報告しています。同時に、GLMのKVキャッシュはDeepSeek V4 Flashよりなおわずかに大きいとも説明しています。これらはベンダー側の主張であり、DeepSeekに対するレイテンシや検索・参照品質の優位性を裏付けるものではありません。
50K、200K、そして実運用での最大プロンプト長において、以下の判定基準で検索・参照、ツール完了率、受け入れタスク率をテストしてください。
1モデルに決めるか、両方をルーティングするか
| ワークロード | 最初に試すモデル | フォールバック/エスカレーション先 |
|---|---|---|
| テキストのみの分類・抽出 | DeepSeek V4 Flash | フォーマットまたは品質が不十分ならGLM |
| キャッシュ率の高いリポジトリチャット | DeepSeek V4 Flash | 難しい修復ターンではGLM |
| ターミナル型コーディングエージェント | DeepSeek V4 Flash | 初回完了が重要な場面ではGLM |
| スクリーンショットからの実装 | GLM-5.3-Flash | テキストのみの後続作業ではDeepSeek |
| ブラウザ/コンピュータ操作エージェント | GLM-5.3-Flash | 視覚を使わない計画ステップではDeepSeek |
| 動画・画像・ファイルに基づく分析 | GLM-5.3-Flash | 別経路を許容できるならDeepSeek Vision Exp |
| 長いテキストと短い出力 | DeepSeek V4 Flash | 検索・参照性能が落ちるならGLM |
| キャンペーン中の長いコード生成 | GLM-5.3-Flash | キャッシュヒットの経済性が支配的ならDeepSeek |
本番ワークロードを切り替える前に、小規模でも同一ハーネスで次のゲートを実施してください。
- 対象IDを
glm-5.3-flashとdeepseek-v4-flashに固定します。ルーターがProやVision-Expへ暗黙に切り替えないようにしてください。 - 成功した処理と直近の失敗例を含む、実タスク20~50件を使います。エージェント型の製品なら、少なくとも5件はツール利用タスクを含めます。
- 合格率、修復ループ、ツール呼び出しの欠落、最初の有用なアクションまでの時間、入力・出力トークン総数、キャッシュヒット率を記録します。
- 受け入れられたタスクあたりのコストを比較し、タイムアウト率と失敗率が安定するまで、もう一方のモデルはフォールバックとして維持します。
Z.AI’s quick startとDeepSeek’s first API call guideは、いずれもOpenAI互換のアクセス方法を案内しています。ただし、推論制御、ビジョン経路、課金の意味合いは同一ではありません。
導入前によくある質問
GLM-5.3-FlashとOx Alphaは同じモデル?
Z.aiは、GLM-5.3-FlashがOx Alphaとして匿名テストしていたモデルだと公式に明らかにしています。プレビュー時のルーティング、クォータ、エンドポイントの挙動を、公開モデルの恒久的な仕様と見なすべきではありません。
まずはルーティング表を使い、固定したID、実際の失敗ケース、同一の評価ハーネスでデフォルトモデルを検証してください。モデルの同一性とデプロイに関する根拠はGLM-5.3-Flash review、独立した視覚経路についてはDeepSeek V4 Flash Vision Exp API guideで扱っています。