 AIREITER
正式発表前、Ox Alphaという匿名モデルが一部で使われていました。Z.aiは今回、その実験的モデルにGLM-5.3-Flashという正式名称を与えました。ただし、「Flash」という名前から小型・低負荷のモデルを想像するのは早計です。1トークンあたりに稼働するパラメーターは18Bですが、公開チェックポイント全体では約320B。ローカルで動かすには、依然として本格的なハードウェアが必要です。
結論:Ox AlphaはGLM-5.3-Flashのプレビュー版だった
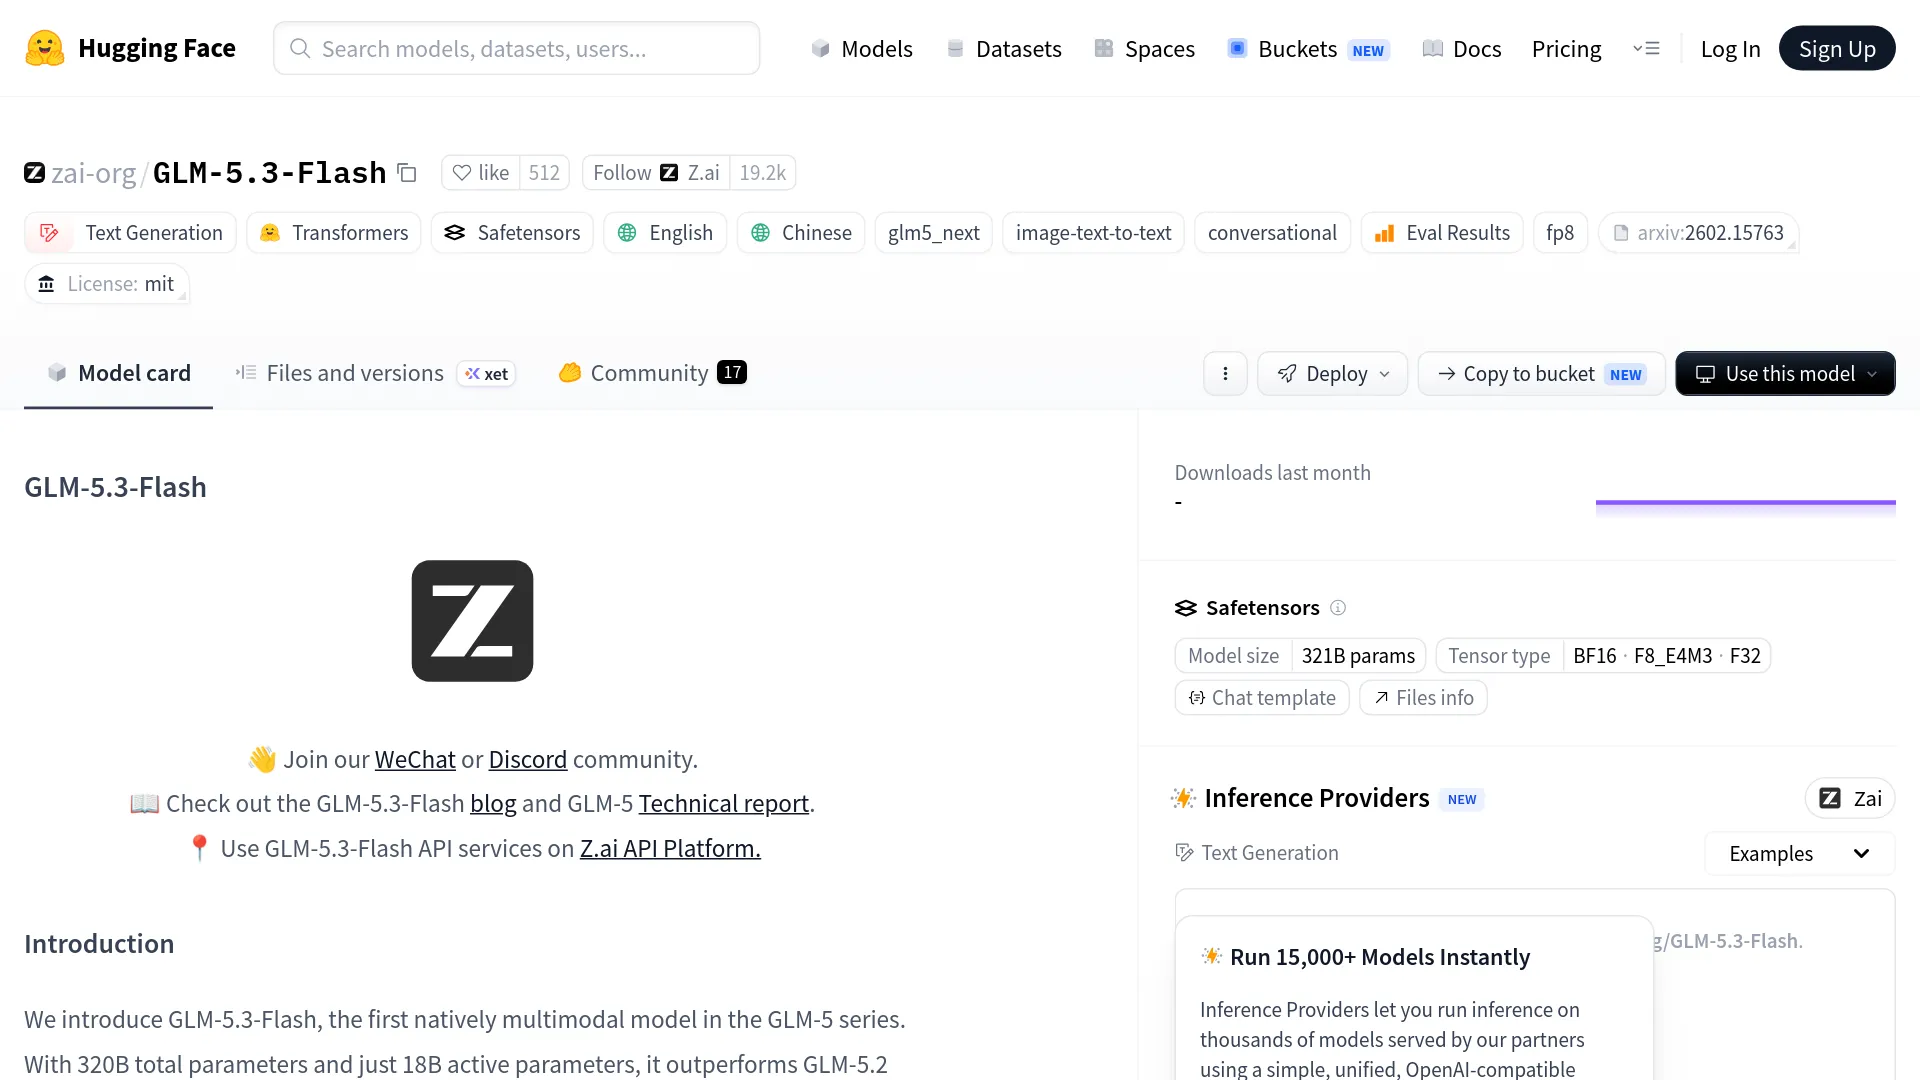
Z.aiが2026年8月26日に発表した内容によると、GLM-5.3-Flashは、OpenCodeやOpenRouterで匿名公開されていたOx Alphaの正式版です。公式のHugging Faceモデルカードには、公開チェックポイント、MITライセンス、マルチモーダル入力、ローカル実行に関する情報が掲載されています。
ただし、Ox Alphaに関する報告は、正式リリース版の仕様ではなく、あくまでプレビュー時点の参考情報として扱うべきです。Ox Alphaには独自のルーティング、トラフィック状況、運用条件がありました。初期に報告された速度、利用上限、ポリシーが、GLM-5.3-Flashのすべてのエンドポイントに当てはまるとは限りません。
「自分にとっては何も変わっていません。どちらのモデルも、32 GB RAMのシステムには大きすぎます」— r/LocalLLaMAのu/dampflokfreund
GLM-5.3-Flashの仕様を一覧で確認
| 仕様 | GLM-5.3-Flash |
|---|---|
| 正式リリース | 2026年8月26日 |
| プレビュー時の名称 | Ox Alpha / ox-alpha |
| モデル構成 | 総パラメーター数320B、1トークンあたりのアクティブパラメーター18B |
| コンテキスト長 | 1,048,576トークン(1M) |
| 入力 | テキスト、画像、動画 |
| 出力 | テキスト |
| ライセンス | MIT |
| 公式チェックポイント | zai-org/GLM-5.3-Flash |
| API入力料金 | 100万トークンあたり$0.15 |
| キャッシュ済み入力料金 | 100万トークンあたり$0.03 |
| API出力料金 | 100万トークンあたり$0.50 |
Hugging Faceのページでは、保存されたモデルサイズを約321Bパラメーターと表示しています。一方、モデル説明では320B-A18Bという簡略表記が使われています。前者は保存された総容量、後者の18Bはトークンごとに計算へ参加する規模を示す数字です。18Bがアクティブだからといって、ローカルで18Bモデルと同じ感覚で扱えるわけではありません。
Ox Alphaから正式版で何が変わったのか
Z.aiは正式リリースに先立ち、OpenCodeとOpenRouterでGLM-5.3-FlashをOx Alphaとして匿名運用し、実際の利用からフィードバックを集めていました。OpenRouterの掲載情報では、プレビュー版はマルチモーダル対応かつ長大なコンテキストを扱えるモデルとして紹介され、一時的に料金は$0でした。正式版では、提供元、チェックポイント、ライセンスが明確になっています。
もっとも、プレビュー版と正式版は別の運用環境です。トークナイザーが一致していたり、GLM系らしいAPIエラーが出たりしても、匿名リクエストのすべてが最終版の重みや同じルーティング層を使っていたことの証明にはなりません。デプロイと再現性を検証する際の基準は、現在公開されているチェックポイントです。
「Flash」を支えるアーキテクチャ
GLM-5.3-Flashは、スパースなMixture-of-Experts構成に加え、非常に長いコンテキストでのコスト削減を狙ったアテンション機構を採用しています。Z.aiによれば、総パラメーター数は320B、アクティブパラメーターは18B、45層構成で、ハイブリッドなスパース/線形アテンション、IndexPool検索、Manifold-Constrained Hyper-Connections(mHC)を備えます。モデルカードでは、30Tトークンのマルチモーダル事前学習コーパスで訓練されたことも説明されています。
Z.aiは、GLM-5.3と比べて1Mコンテキスト時のアテンション計算量を3分の1に、KVキャッシュを4.4分の1に削減したとしています。ただし、これはベンダーが示すアーキテクチャ上の比較であり、ハードウェアを問わず同じレイテンシーが得られるという保証ではありません。実際の速度は、コンテキスト長、同時実行数、画像の前処理、サービング基盤によって変わります。
このモデルのマルチモーダル機能は、単なる「画像を見られるチャットボット」というより、エージェント用途で真価を発揮します。Z.aiが想定するのは、エージェントがレンダリングされた画面、ブラウザーの状態、ドキュメントなどの視覚情報を確認し、その結果をもとにコードや出力を修正するループです。公式モデルカードでは画像入力が実演されており、公開モデルとデプロイ資料では動画入力にも対応すると説明されています。
ベンチマーク結果から分かること、分からないこと
公式発表とモデルカードでは、特にコーディングやエージェントタスクで強い結果が報告されています。モデルカードに掲載されている主な数値は、TerminalBench 2.1が84.3、DeepSWEが63.4、HLEが55.3です。さらにZ.aiの発表資料では、Artificial Analysis Intelligence Indexが57、AutomationBenchが48.8、Z.ai Code Benchの最大努力設定が29.0とされています。
| ベンチマーク | GLM-5.3-Flash | 比較対象またはベースライン | 出典と注意点 |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2:81.0、Claude Opus 4.8:85.0 | Z.ai/モデルカードの結果。ハーネスや推論予算の影響を受ける |
| DeepSWE v1.1 | 63.4 | GLM-5.2:46.2 | 報告された評価結果。すべてのリポジトリに一般化はできない |
| AutomationBench | 48.8 | GLM-5.2:26.2 | 指定されたベンチマークバージョンによる評価結果 |
| Z.ai Code Bench、最大努力設定 | 29.0 | Claude Opus 4.8:29.5 | Z.aiの環境におけるほぼ同等という主張 |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.aiはClaude Opus 4.8と同等と説明 | 外部インデックス。コーディングだけを評価するスコアではない |
各結果は、異なるハーネス、コンテキスト上限、タイムアウト設定、判定方法で測定されています。したがって、ひとつの万能ランキングとしてではなく、方向性を示す数字として比較するのが妥当です。公平な結論は、GLM-5.3-Flashがコーディングエージェント評価でGLM-5.2から大きく改善したことを示す有力な材料はあるものの、あらゆる最先端モデルを圧倒するとまでは言えない、というものです。
初期コミュニティテストにも同じ注意が必要です。@prz_chojeckiの報告では、Ox Alphaが226問すべてのErdosBench問題でGLM-5.2を上回ったとされています。自分でテストケースを作る際の参考にはなりますが、利用するツールやリポジトリを対象にした管理下の評価の代わりにはなりません。
初期ユーザーが指摘した実運用上の限界
「Flash」という名称が比較的よく表しているのは、インタラクティブな応答速度よりも、アクティブ計算量とコスト面での位置付けです。r/opencodeCLIの実ユーザーからは、匿名プレビュー期間中を中心に、コーディング結果を評価する声と、待ち時間への不満の両方が出ていました。これらはプロバイダーやワークロードに依存する観測であり、公式のレイテンシーベンチマークではありません。
「メインモデルよりずっと遅いのに、どうして『Flash』と呼べるのでしょうか?」— r/opencodeCLIのu/ahriad
運用面で最も重要なのは、高負荷時に長時間動くエージェントが安定するかどうかです。@solomonneasの報告では、7日間のテストで49回の試行中30回のビルドに成功し、14回の失敗はタイムアウトとして発生しました。これは公式APIの固定的な失敗率を証明するものではありませんが、数時間かかるタスクにはフォールバック経路を用意すべきだと判断するには十分な材料です。
ベンチマークの見出しだけでは分かりにくい、ローカル運用上の制約もあります。公式FP8チェックポイントは、ランタイムとKVキャッシュのオーバーヘッドを除いて約306 GiBあります。1トークンあたり18Bパラメーターしかアクティブにならないとしても、総パラメーター数320Bのモデルを動かすには、大容量メモリーを備えたインフラが必要です。
API、ホスティング、ローカル実行の選び方
ホスティングサービスを使う場合、Z.aiの料金ページでは、GLM-5.3-Flashの料金を入力100万トークンあたり$0.15、キャッシュ済み入力100万トークンあたり$0.03、出力100万トークンあたり$0.50としています。期間限定の50%プロモーションでは、入力$0.075、キャッシュ済み入力$0.015、出力$0.25。終了時刻は2026年9月9日24:00(UTC+8)です。予算を組む前に、Z.AI公式の料金表を確認してください。プロモーションには終了日時があります。
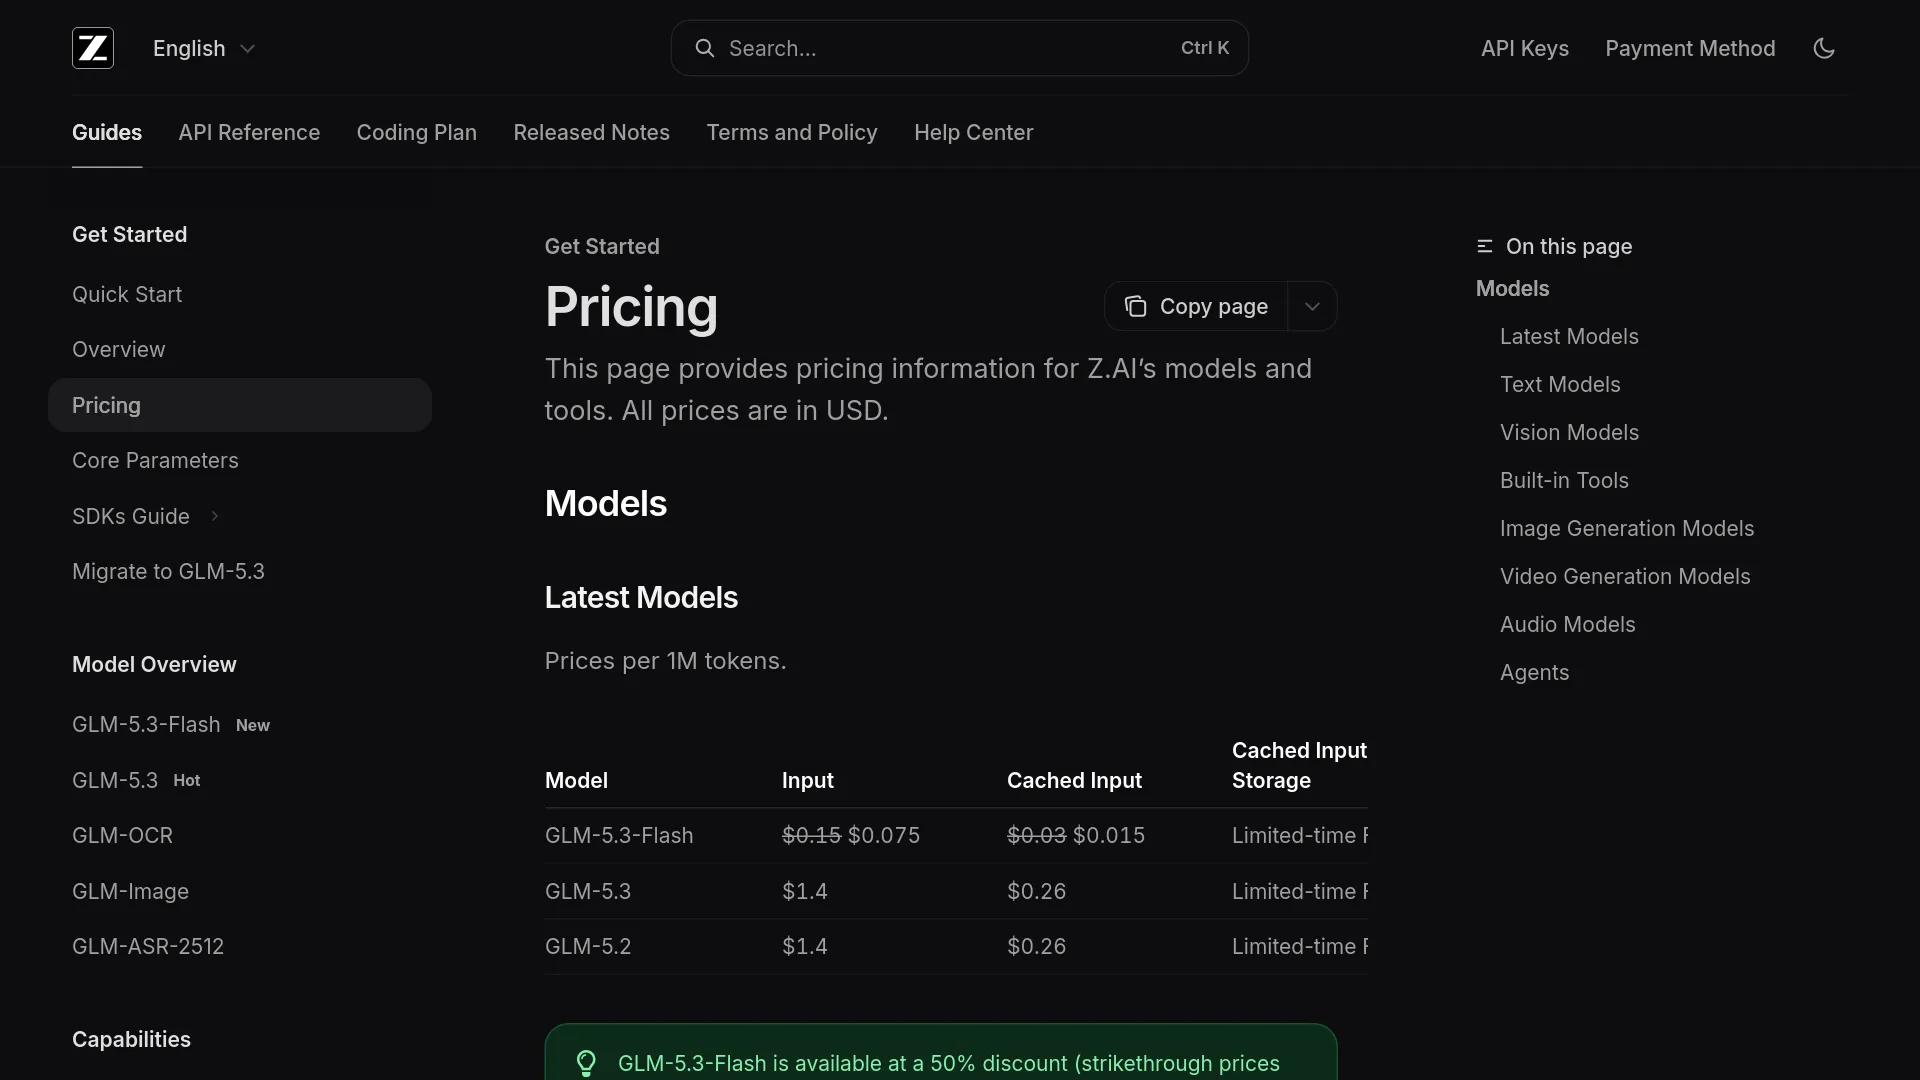
公開された通常料金と、Ox Alphaプレビュー時の料金は別物です。単純な例として、入力10Mトークンと出力2Mトークンを通常料金で処理した場合、他のプロバイダー手数料を除けば$2.50です。計算式は10 × $0.15 + 2 × $0.50。プロバイダーが一部の入力をキャッシュ済みとして請求する場合は、入力分のコストを下げられます。
ローカル実行も可能ですが、ノートPCにダウンロードして使うタイプの導入ではありません。公式のvLLMレシピでは、FP8重みに約306 GiB、標準FP8構成に386GBのVRAM、BF16構成に772GBが必要とされています。現在サポートされている手順ではNVIDIA Hopper以降のGPU、比較的新しいFlashInfer、そして統合が進むまでの専用vLLMイメージが求められます。
KTransformersのチュートリアルでは、CPUとGPUを組み合わせた推論、公式FP8重みの直接利用、少なくとも350GBの空きシステムメモリーについて説明しています。単一GPUの例はオフロード構成であり、一般的なコンシューマー向けGPU 1枚にモデル全体を収められることを示すものではありません。また、このチュートリアルでは検証済みの501,025トークン設定を使い、マルチモーダルリクエストを1回あたり画像8枚または動画1本に制限しています。
| 実行方法 | ドキュメントで確認できること | 主な制約 |
|---|---|---|
| Z.ai API | 従量課金のホスティングアクセス。通常料金とプロモーション料金を公開 | レート制限、地域別条件、現在のプロモーションを確認する必要がある |
| vLLM | FP8/BF16サービング、OpenAI互換エンドポイント、テンソル並列、マルチモーダル経路 | 大容量メモリーを持つNVIDIA基盤が必要。現在のレシピはHopper以降を対象 |
| KTransformers | CPU-GPU異種構成での推論とFP8ロード | 重みだけで約306 GiB。システムメモリーは少なくとも350GBが推奨 |
| Ollama/LM Studio/llama.cppエコシステム | モデルカードが量子化版の配布物と対応ツールを案内 | 量子化対応状況と速度は個別のビルドによって異なる |
いまGLM-5.3-Flashを使うべき人
コストを抑えたいコーディングエージェントや、長文脈を使う開発検証に向いています。低い通常料金、1Mコンテキスト、GLM-5.2からの改善報告を考えると、リポジトリ解析、複数ファイルにまたがる変更、テスト生成、エージェントの反復呼び出しに有力な候補です。自分の環境で成功率が安定するまでは、受け入れテストとフォールバックモデルを組み合わせて運用しましょう。
テキストだけのGLMモデルでは足りないマルチモーダルな技術作業にも適しています。画像や動画を入力できるため、エージェントがブラウザーの出力、UIレイアウト、図表、ドキュメント、レンダリング結果を確認する用途に使えます。動画を生成するモデルではなく、視覚情報を読み取り、テキストやコードを返すモデルです。
「18Bアクティブ」という数字だけを見て、デスクトップ向けモデルだと判断してはいけません。チェックポイント全体は約320Bパラメーターで、ローカル実行にはコンテキストとランタイムのオーバーヘッドを除いても数百GB規模のストレージまたはメモリーが必要です。すでに大容量メモリーの推論基盤を運用しているのでなければ、ホスティングAPIのほうが経済的にも導入しやすいでしょう。
検証していないプレビューエンドポイントに機密コードを送ってはいけません。公開されたGLM-5.3-FlashはZ.aiのモデルとして明確になっていますが、プロバイダーの利用条件、データ保持、ルーティングについては引き続き確認が必要です。本番トラフィックに使うなら、利用するエンドポイントの現在のデータポリシーを記録し、公式APIか、運用条件を監査できるプロバイダーを選びましょう。
FAQ
Ox AlphaとGLM-5.3-Flashは完全に同じモデルですか?
Z.aiは、GLM-5.3-Flashが以前Ox Alphaとしてプレビューされていたモデルだと公式に説明しています。ただし、初期のOx Alphaの挙動は参考情報としては有用でも、プレビュー時のルーティングや利用制限を公開モデルの仕様と見なすべきではありません。
GLM-5.3-Flashはオープンソースですか?
公式Hugging FaceチェックポイントはMITライセンスで公開され、Z.aiはローカルサービングの手順も提供しています。運用上は「オープンウェイト」と表現するのが正確です。重みは利用できますが、モデル全体を実行するには依然として大規模なインフラが必要です。
GLM-5.3-Flashをローカルで動かすには、どのくらいのメモリーが必要ですか?
公式FP8重みだけで、ランタイムとKVキャッシュのオーバーヘッドを除いて約306 GiBあります。vLLMのレシピでは、標準FP8構成に386GBのVRAMが必要とされ、KTransformersでは異種構成の推論に少なくとも350GBのシステムメモリーを推奨しています。
API料金は本当に入力100万トークンあたり$0.15ですか?
はい。Z.AI公式料金ページでは、入力が$0.15、キャッシュ済み入力が$0.03、出力が$0.50です。50%のプロモーション料金は、2026年9月9日(UTC+8)までと記載されています。
GLM-5.3-Flashは、ほかのFlashモデルより速いのですか?
現時点の情報から、普遍的なレイテンシーランキングを導くことはできません。初期ユーザーからは、エージェントの処理が遅い、あるいはタイムアウトするという報告も出ています。実際に使うプロバイダーの経路で、最初のトークンまでの時間、完了時間、リトライ回数、タスク受け入れ率を測定してください。
GLM-5.3-Flashは画像と動画に対応していますか?
対応しています。Z.aiと公式モデルカードでは、テキスト、画像、動画を入力し、テキストを出力できると説明されています。ローカル実行については、KTransformersの手順で画像8枚または動画1本までといったリクエスト単位の制限も示されています。
数百GB規模の推論ボックスを用意せずにGLM-5.3-Flashの低価格とマルチモーダル機能を使いたいなら、ホスティングAPIを選ぶのが現実的です。ローカル実行は、すでに必要なインフラがある場合に限って検証するとよいでしょう。長時間動くエージェント処理では、実証済みのフォールバックも用意してください。現時点の公開情報は、能力と価格については説得力がある一方、長時間のインタラクティブな安定性についてはまだ十分ではありません。