 AIREITER
GLM-5-3-Flashの代替モデルを探しているなら、Ox Alphaの正体をもう一度説明してほしいわけではないはずです。必要なのは、ときどき遅くなる安価なエージェント経路の置き換え、320B級のローカルチェックポイントの回避、あるいはAPIクライアントを作り直さずにマルチモーダル処理を維持すること。どのモデルが適切かは、解決したい問題によって変わります。
結論:直したい問題から代替モデルを選ぶ
DeepSeek V4 Flashは、キャッシュヒット時の料金、思考しないモード、高い同時実行数を重視する場合に有力なテキスト処理向けの選択肢です。コンテキスト長は1Mトークン、同時実行数の上限は2,500リクエスト。公式のオフピーク料金は、キャッシュされていない入力が100万トークンあたり$0.22、出力が$0.66です。
Qwen3.8-Flashは、画像や動画の入力、API互換性、組み込みツールを重視する場合に試したいホステッドモデルです。料金表では、入力が100万トークンあたり$0.15、出力が$0.47となっています。
GLM-5.3は、Z.aiを使い続けながら、同社のフラッグシップ級テキストモデルへ移行したい場合の選択肢です。GPT-5.6 TerraとClaude Opus 4.8は、成功するタスクが増えるなら数倍の料金を払う価値があるケース向けのプレミアムモデル。Kimi K3は1Mコンテキストに対応する選択肢ですが、安価な置き換えではありません。
重要なのは「どのモデルが勝つか」ではありません。最適化したいのがトークン料金、画像入力、長時間のコーディング、ローカル運用、タスクの成功率のどれなのかを見極めることです。
Ox Alphaのエンドポイントは終了済み。まず移行状況を確認する
Z.aiの公式発表では、匿名で提供されていたOx Alphaのプレビューが、2026年8月26日にGLM-5.3-Flashであると明らかにされました。正式版では、名前付きチェックポイント、公開料金、MITライセンスのHugging Faceモデル、そしてドキュメント化されたAPIアクセスが提供されています。旧プレビュー環境を恒久的なモデル契約と考えるべきではありません。プレビュー時のルーティング、クォータ、レイテンシ、ポリシー上の挙動は、正式版APIと異なる可能性があります。
設定にまだstealth/ox-alphaが残っている場合、公開OpenRouterの識別子はz-ai/glm-5.3-flashです。Z.aiへ直接リクエストする場合のベースURLはhttps://api.z.ai/api/paas/v4。Z.aiはCoding Plan向けに別のエンドポイント、https://api.z.ai/api/coding/paas/v4も用意しています。サブスクリプション経由のルートと通常APIで、料金や制限が同じだと決めつけないようにしてください。
AIReiterのGLM-5.3-Flashレビューでは、18Bのアクティブパラメータと、総計でおよそ320Bとなるチェックポイントの違いを含め、ベースラインを詳しく扱っています。ここではその次の疑問、つまり料金、速度、ハードウェア要件、信頼性のいずれかが合わなくなったとき、何に置き換えるべきかを考えます。
「私にとっては何も変わっていません。どちらのモデルも、32GB RAMのシステムには大きすぎます」— u/dampflokfreund、r/LocalLLaMA
料金、コンテキスト長、運用形態で代替モデルを比較
以下の料金は、2026年8月28日時点で各プロバイダーが掲載していた情報です。全モデルが同じキャンペーン条件というわけではありません。DeepSeekはピーク時とオフピーク時で料金が変わり、Z.aiのFlash料金には2026年9月9日24:00 UTC+8までの期間限定割引が含まれます。
| モデル | 入力/100万トークン | 出力/100万トークン | コンテキスト | 入力モダリティ | 置き換える理由 |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | $0.22(オフピーク)、$0.44(ピーク) | $0.66(オフピーク)、$1.32(ピーク) | 1M | テキスト | キャッシュを考慮したテキスト処理と思考なしモード |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | テキスト、画像、動画 | ホステッド環境でのマルチモーダル対応とAPI互換性 |
| GLM-5.3 | $1.40 | $4.40 | 1M | テキスト | 同じプロバイダーの高性能ファミリーモデル |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | テキスト | 難しいエージェント処理で高い成功確度を狙える |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | テキスト | 難度の高いコーディングと長文コンテキストのレビュー |
| Kimi K3 | $3.00 | $15.00 | 1M | テキスト | 長大なコンテキストを使う高性能処理 |
Z.aiが現在掲載しているGLM-5.3-Flashの料金は、50%割引期間中で入力が100万トークンあたり$0.075、キャッシュ入力が$0.015、出力が$0.25です。通常料金はそれぞれ$0.15、$0.03、$0.50。比較図では一時的な割引料金ではなく、通常料金を使っています。(Z.aiの料金表)
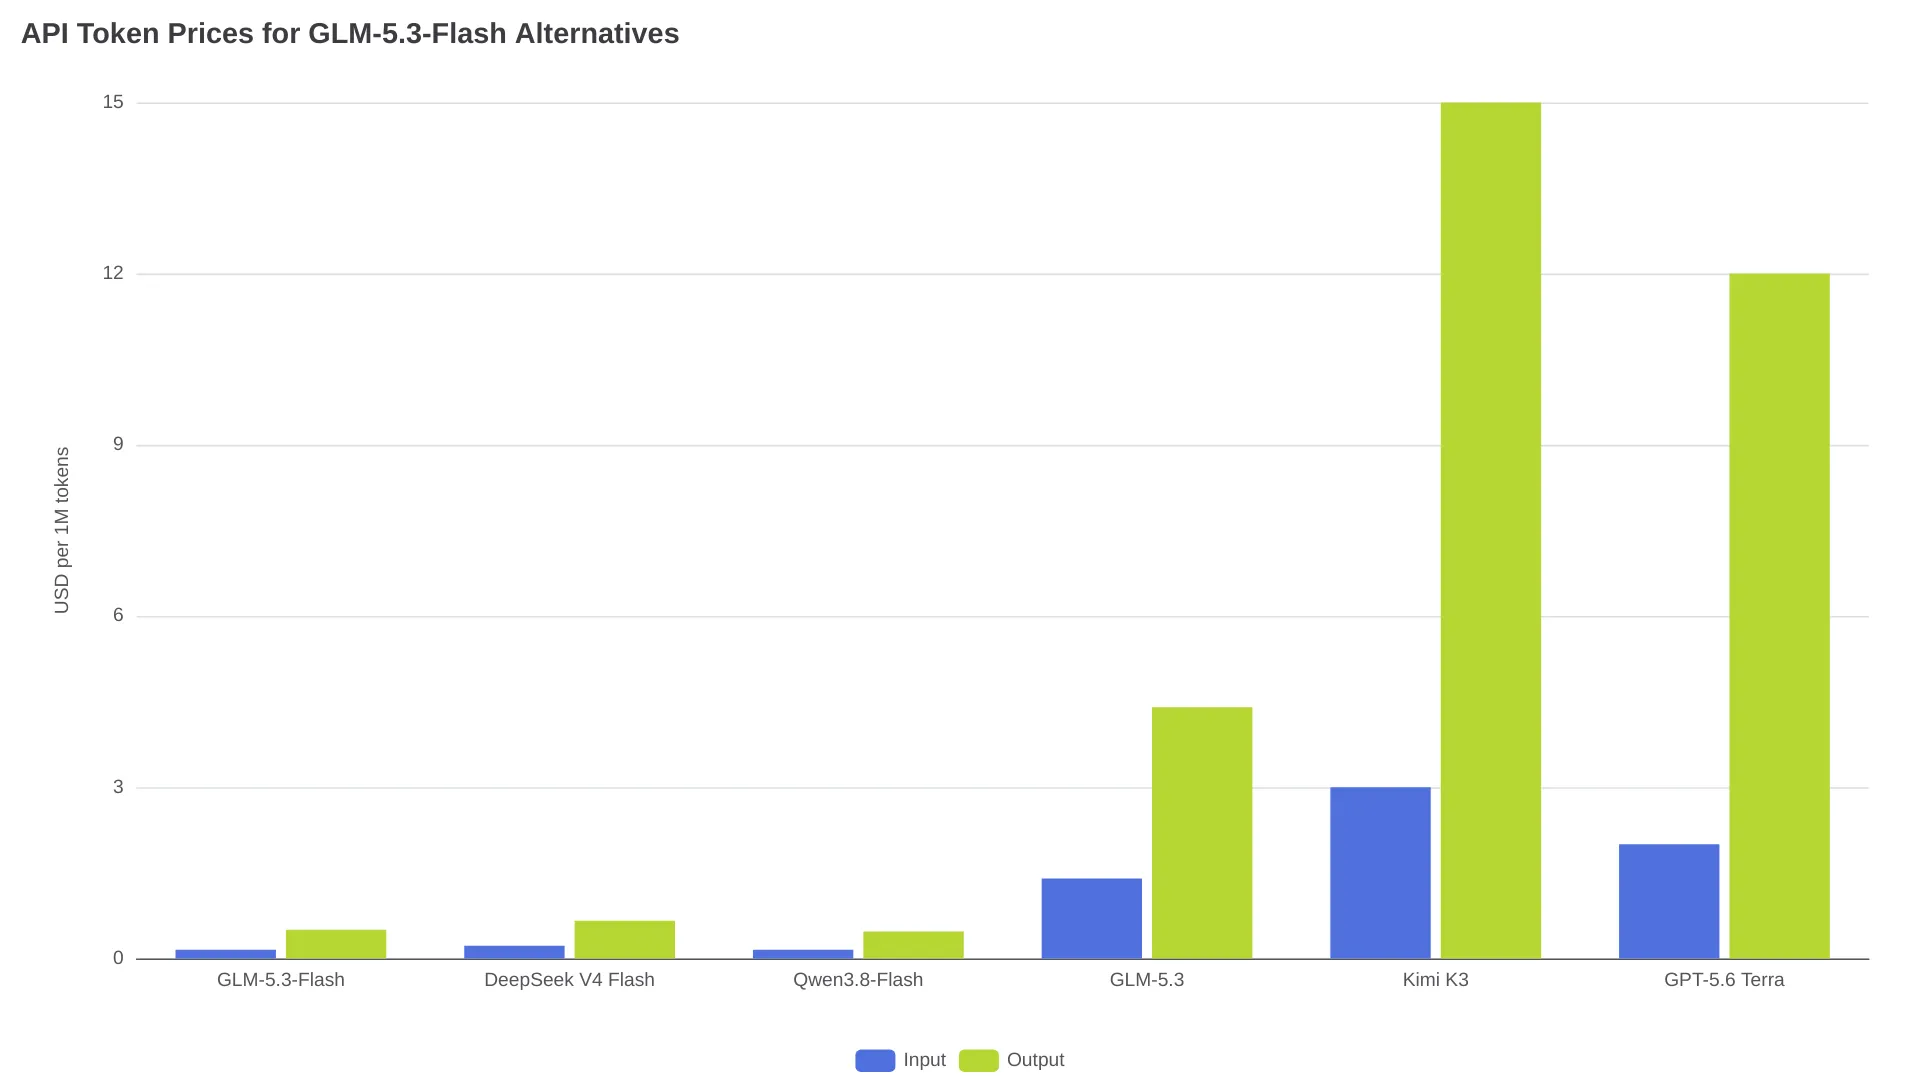
料金の基準:GLM-5.3-Flashは通常料金、DeepSeek V4 Flashは公式のオフピーク料金、それ以外は各プロバイダーが現在掲載している料金。DeepSeekのピーク料金はオフピーク料金の2倍です。
現実的な代替候補6モデル
DeepSeek V4 Flash:キャッシュを活かせるテキスト・コーディング向け
DeepSeek V4 Flashは、GLM-5.3-Flashを日常的なテキスト処理に使うには高いと感じたとき、最初に試したいモデルです。DeepSeekは、1Mトークンのコンテキスト、最大384Kの出力、JSON出力、ツール呼び出し、Responses API、Anthropic互換アクセスを案内しています。公式の同時実行数上限は2,500リクエストです。
料金体系の違いも見逃せません。DeepSeekはキャッシュヒットとキャッシュミスを分けて課金し、平日のピーク時間帯である01:00~04:00および06:00~10:00 UTCには料金が2倍になります。また、思考モードと思考なしモードを切り替えられます。一方、GLM-5.3-Flashのモデルカードでは、単純な思考なしモードではなく、low、high、maxの推論強度が説明されています。
繰り返し同じコンテキストを送る処理、検索結果を多用するチャット、キャッシュヒットや推論の制御が重要なテキスト中心のコーディングには、DeepSeek V4 Flashが向いています。ただし、新規トークンの料金だけを比べるとQwen3.8-Flashのほうが安いため、すべてのテキスト処理で最安とは限りません。画像入力の完全な置き換えにもなりません。画像入力はDeepSeekの別ルート、deepseek-v4-flash-vision-expに分かれており、画像から生成されたトークンも入力として課金されます。
Qwen3.8-Flash:ホステッド型で最も近いマルチモーダル代替
Qwen3.8-Flashは、エージェントがスクリーンショット、グラフ、動画を扱い、APIの形を大きく変えずに移行したい場合に、まず試す価値のある候補です。QwenCloudは画像、テキスト、動画入力、1Mトークンのコンテキスト、最大991Kの入力、最大131Kの出力を掲載しています。OpenAI互換およびAnthropic互換API、ツール、構造化出力、キャッシュ、バッチ、ウェブ検索、ファインチューニングにも対応します。
運用面でのポイントはキャッシュの料金体系です。QwenCloudの料金表では、暗黙的なキャッシュ読み出しが100万トークンあたり$0.016、明示的なキャッシュ作成が$0.20、出力が$0.47。公開されている上限は毎分2Mトークン、毎分15,000リクエストですが、アカウント単位、キー単位、組織単位、デプロイ単位のどれに適用されるかはページ上で明記されていません。
画像や動画の入力が不可欠な場合、または新規トークンの料金を重視する場合は、Qwen3.8-Flashを選ぶとよいでしょう。ただし、公式モデルページには名前付きのベンチマーク表、レイテンシの結果、長時間セッションの信頼性調査はありません。機能が同じだから挙動も同じだと考えず、実際のエージェントのトレースで検証してください。
GLM-5.3:Flashでは足りないときの同系統モデル
GLM-5.3は、低価格を求めるための代替ではありません。テキスト処理の深さが足りないことが問題で、料金やマルチモーダル対応が課題ではない場合に、自然なステップアップ先となります。Z.aiの料金表では、入力が100万トークンあたり$1.40、キャッシュ入力が$0.26、出力が$4.40。Flashの通常料金と比べると、およそ1桁高い水準です。
Z.aiはGLM-5.3をフラッグシップのコーディングモデル、GLM-5.3-Flashを低コストでネイティブなマルチモーダル対応を備えたモデルとして位置づけています。難度の高いテキスト中心のタスクに限定してGLM-5.3を使うのがよいでしょう。移行によって、Flashを選んだ理由でもある画像処理のワークフローを失う可能性があります。
GPT-5.6 Terra:エージェントの実行成功率を優先する場合
GPT-5.6 Terraは、トークン単価の安さよりも、難しいタスクを完了できる確度を重視するチーム向けのプレミアムな選択肢です。OpenAIの料金は、入力が100万トークンあたり$2、キャッシュ入力が$0.20、出力が$12。コンテキスト長はおよそ1.05Mトークンです。Z.aiが公開したベンチマーク表では、引用された条件のもとでGPT-5.6 TerraがTerminal-Bench 2.1で87.4、DeepSWE v1.1で69.6を記録。GLM-5.3-Flashの84.3、63.4を上回っています。
この数字は、コーディングタスクの失敗コストがAPI料金の増加を上回る場合に、Terraを検証する理由にはなります。ただし、あらゆる本番環境で普遍的に優れていることを証明するものではありません。価値の高いリポジトリ変更や、複雑な自律処理のための上位ルートとして使うのが現実的です。
Claude Opus 4.8:難しいコーディングと長文レビュー向け
Claude Opus 4.8のAnthropic標準グローバル料金は、入力が100万トークンあたり$5、出力が$25です。キャッシュ読み出しは100万トークンあたり$0.50、バッチ処理は通常の入力・出力料金の半額と案内されています。
Z.aiの比較表では、Opus 4.8がTerminal-Bench 2.1、Agents’ Last Exam、HLE with Tools、NL2RepoでGLM-5.3-Flashを上回っています。一方、複数のツール中心・自動化系の項目ではFlashが優勢です。この結果から、Opusは常時使うデフォルトというより、計測結果に基づいて投入する上位モデルと考えるのが適切です。
Kimi K3:安価な推論ではなく、1Mコンテキストを活かす処理向け
Kimi K3を候補に含める理由は、別の移行ニーズに応えられるからです。ソフトウェアエンジニアリングや調査の長時間ワークフローで、1Mコンテキストのモデルが必要になるケースです。Kimiの料金は、キャッシュ入力が100万トークンあたり$0.30、入力が$3、出力が$15です。
この料金水準では、コンテキスト長と性能特性がプレミアム料金に見合う場合に限ってKimi K3を選ぶべきです。「トークン料金を下げたい」という目的の答えにはなりません。
ランキングではなく、ワークロードで代替モデルを選ぶ
| ワークロード/制約 | 最初に試すモデル | 理由 |
|---|---|---|
| 大量のテキスト分類や抽出 | Qwen3.8-Flash | DeepSeek V4 Flashのオフピーク料金より、新規入力・出力の掲載料金が安い |
| 同じプレフィックスを繰り返し使う長文処理 | DeepSeek V4 Flash | キャッシュヒット料金と思考なしモード |
| ほぼすべてが新規入力となる長文処理 | Qwen3.8-Flash | 新規トークンの掲載料金が安い |
| APIワークフローでスクリーンショット、グラフ、動画を扱う | Qwen3.8-Flash | 画像・動画のネイティブ入力と使い慣れたAPIプロトコル |
| 同じZ.aiエコシステムで、より難しいテキスト推論を行う | GLM-5.3 | プロバイダーを変えずに、ファミリー内の上位モデルへ移行できる |
| 失敗コストの高いコーディング | GPT-5.6 Terra | 引用されたコーディングスコアがより強いプレミアムな上位モデル |
| 慎重なコードレビューやリポジトリの計画 | Claude Opus 4.8 | キャッシュやバッチ処理にも対応するプレミアム推論モデル |
| 料金よりコンテキスト長が重要な長時間処理 | Kimi K3 | 1Mコンテキストを活かすモデルとして位置づけられている |
| 一般的なノートPCや32GBワークステーション | まずはホステッドAPI | GLM-5.3-Flashは総計およそ320Bパラメータのチェックポイントであり、18Bのローカルモデルではない |
ローカル運用には大きな制約があります。公式のGLM-5.3-Flashチェックポイントは総計およそ320Bパラメータと説明されており、AIReiterのデプロイレビューでは、FP8時の容量は約306GiB、vLLMのデフォルト構成ではVRAM約386GBが必要とされています。量子化でハードルは下がりますが、一般的なノートPCにダウンロードして使えるモデルになるわけではありません。
エージェント移行を安全に進める方法
プロバイダーのアダプターとタスクのルーティングを分離し、実際に重要な処理で移行先を評価しましょう。
- リクエストのインターフェースを統一する。プロバイダーが対応している範囲では、OpenAI互換のメッセージ、ツール、構造化出力のレイヤーを維持します。推論制御、画像ペイロード、ツール呼び出し、構造化出力、コンテキスト上限は、どのモデルでも使える共通フィールドではなく、機能フラグとして扱ってください。
- 生成テキストではなく、タスクの成功を測る。コードがビルドできたか、ツール呼び出しが正しかったか、画像による確認を通過したか、リトライなしでタスクを完了したかを記録します。最初の応答が安くても、リポジトリ規模のリトライが2回必要なら、結果的に安いとは限りません。
- 失敗の種類でルーティングする。同じコンテキストを繰り返し使うテキスト処理はDeepSeek V4 Flash、マルチモーダル処理はQwen3.8-Flash、高リスクのコーディングは、受け入れテストの結果に応じてGPT-5.6 Terra、Claude Opus 4.8、GLM-5.3へ振り分けます。
- フォールバックを用意する。AIReiterのレビューでは、7日間のコミュニティテストで49回の試行中30回のビルドに成功し、14回のタイムアウト失敗が記録されています。これをプロバイダー全体の普遍的な失敗率とみなすことはできませんが、本番エージェントを単一ルートだけで運用しない理由には十分です。
- 通常料金を前提に予算を組む。Z.aiのFlashキャンペーンは2026年9月9日に終了します。DeepSeekの料金はピーク時間帯で変わり、Qwenではキャッシュ作成とキャッシュ読み出しに異なる料金が設定されています。一時的な割引がある間だけ成立する移行は、安定したコストモデルとはいえません。
最初の検証では、日常的な処理またはテキスト中心のリクエストを10件、コーディング、ツール利用、画像処理のタスクを10件用意するとよいでしょう。タスクの成功率、完了までの総時間、リトライ回数、トークンの総使用量を比較します。多くのチームにとっては、繰り返しコンテキストを使うテキスト処理にDeepSeek V4 Flash、マルチモーダル処理にQwen3.8-Flashを試しつつ、新しい経路の信頼性が確認できるまでGLM-5.3-Flashをフォールバックとして残す構成になります。
FAQ
Ox Alphaの代わりに使える無料モデルは?
今回確認した公式情報からは、恒久的かつプロバイダーに依存しない無料の代替モデルは確認できませんでした。プロバイダーが提供する無料クォータやキャンペーンは変わる可能性があります。本番環境の判断では公開されている有料料金を基準にし、無料枠は追加メリットとして扱うべきです。
画像と動画に対応する代替モデルは?
Qwen3.8-Flashは、公式に画像、テキスト、動画入力への対応を掲載しています。DeepSeekの通常のV4 Flashルートはdeepseek-v4-flash-vision-expルートとは別物なので、画像を扱うエージェントを移行する前に、実際に使うエンドポイントを検証してください。
ローカルで実行できる代替モデルは?
オープンウェイトの候補には、GLM-5.3-FlashチェックポイントとQwen3.8-Flash-Nextがあります。GLM-5.3-Flashは総計およそ320Bパラメータ。一方、Qwenのオープンウェイト版Flash-Nextのドキュメントでは、ネイティブのコンテキスト長は262Kで、YaRNにより1Mまで拡張できると説明されています。どちらも32GBのマシンで動くと考えてはいけません。
プロバイダー変更後の想定外の問題を避けるには?
代表的なタスクを20件選び、2つのルートで実行して、タスクの成功率、完了までの総時間、リトライ回数、トークンの総使用量を比較します。移行先が自分のツールやリポジトリで安定して動くことを確認するまで、既存のGLM-5.3-Flashルートをフォールバックとして残してください。