 AIREITER
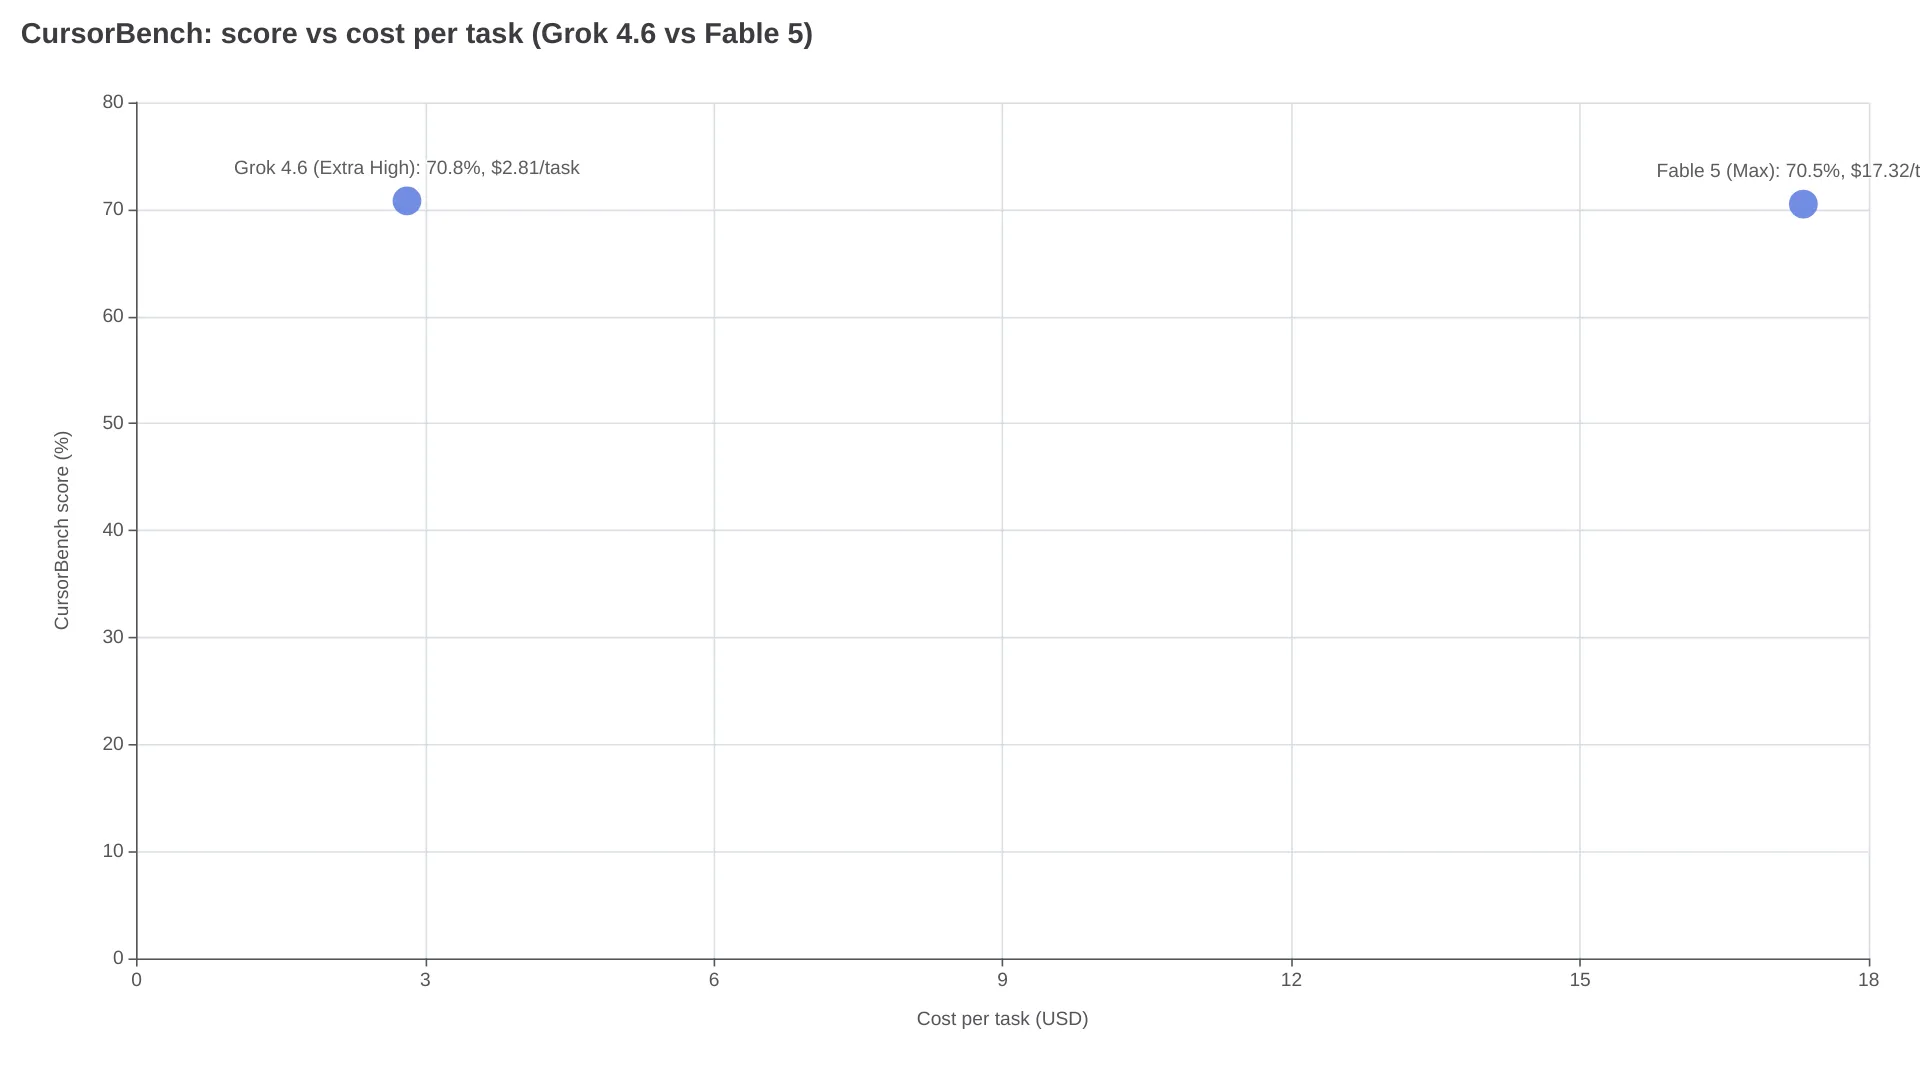
Su CursorBench, Grok 4.6 Extra High arriva al 70,8% spendendo $2,81 per task completato. Fable 5 Max, nello stesso harness agentico, si ferma al 70,5% ma costa $17,32 per task. Per gli agenti di coding messi a confronto è, di fatto, un pareggio nei benchmark; sul conto finale, però, la distanza è di 6 volte. Fable 5 conserva due vantaggi rilevanti: resta in testa al più ampio Artificial Analysis Intelligence Index e offre una finestra di contesto doppia.
Come Grok 4.6 ha ridotto il divario con Fable 5
Due mesi fa il verdetto sarebbe stato molto più netto. A luglio 2026, Artificial Analysis assegnava a Grok 4.5 un punteggio di 56 nell'Intelligence Index, contro 62 per Fable 5: sei punti di distacco. Grok 4.6, rilasciato nell'agosto 2026, ha guadagnato circa cinque punti, arrivando a ~59 e affiancando grossomodo GPT-5.6 Sol, secondo i delta di benchmark riportati. Il vantaggio di Fable 5 si è così ridotto a circa tre punti.
Sugli agenti per il coding, la distanza si è accorciata ancora. Quando Fable 5 è arrivato in Cursor, a giugno 2026, ha stabilito un nuovo record di 72,9% su CursorBench (r/accelerate), otto punti sopra il precedente migliore risultato. Nel confronto diretto pubblicato su r/cursor ad agosto, dopo il rilascio di Grok 4.6, Grok 4.6 Extra High ha ottenuto il 70,8% contro il 70,5% di Fable 5 Max. A parità di harness, il risultato è sostanzialmente un pareggio. Resta però una riserva importante, sollevata da un utente Cursor che ha eseguito il confronto:
"Grok 4.6 mi ha fatto chiedere: quanto di CursorBench dipende dal modello e quanto dall'harness?" - thread su r/cursor, agosto 2026
I punteggi dei benchmark misurano l'intero stack dell'agente — scaffold dei prompt, strumenti e tentativi — non soltanto il modello di base. Inoltre, il 72,9% ottenuto da Fable 5 al lancio e il 70,5% di agosto derivano da configurazioni diverse: entrambi i dati vanno quindi letti come indicativi.
Il costo per task è il terreno su cui Grok 4.6 stravince
I dati per task del confronto di agosto raccontano la parte più concreta della storia:
| Metrica (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Punteggio | 70,8% | 70,5% |
| Costo per task | $2,81 | $17,32 |
| Passaggi per task | 46 | 72 |
Per arrivare allo stesso punteggio, Fable 5 ha richiesto il 57% di passaggi agentici in più. Quei passaggi aggiuntivi, insieme ai token di ragionamento che comportano, spiegano la differenza di costo. Non sorprende che chi ha alternato i due modelli abbia iniziato a mettere in discussione il confronto basato soltanto sul prezzo a listino:
"$/token sta diventando il modo sbagliato di confrontare gli agenti AI." - titolo di un thread su r/grok, agosto 2026
I listini per token spiegano una parte del divario. Sulla API Anthropic, Fable 5 costa $10 per milione di token in input e $50 in output. Per prompt inferiori a 200K token, la tariffa API xAI pubblicata per Grok 4.5 era di $2 / $6 per milione; xAI non ha pubblicato un listino separato per 4.6, mentre la community di r/grok riferisce per 4.6 "prestazioni da Sol a una frazione del prezzo API". Per il listino completo di Fable 5 nelle varie fasce, consulta l'analisi dei prezzi API di Fable 5.
Nell'uso reale, due fattori riducono questo vantaggio. Oltre i prompt da 200K token, i prezzi di Grok raddoppiano approssimativamente ($4 / $12 per milione in quella fascia, secondo le tariffe pubblicate da xAI). Inoltre, se il flusso di lavoro dipende già molto da Fable 5, esistono interventi strutturali per ridurre i costi token di Fable 5 prima di cambiare modello.
Dove Fable 5 mantiene il vantaggio
| Area | Evidenze | Cosa cambia per te |
|---|---|---|
| Indice di intelligenza | Fable 5 resta al primo posto nell'AA Intelligence Index: 62 contro circa 59 per Grok 4.6 | Del precedente vantaggio di sei punti, tre sono rimasti dopo il salto di 4.6 |
| Finestra di contesto | Fable 5 espone 1.000.000 di token di contesto; Grok arriva a 500.000 | Un repository ampio con la cronologia del task entra in un solo passaggio, mentre il vantaggio di prezzo di Grok si riduce oltre la fascia dei 200K |
| Affidabilità sui task più difficili | Nel test di sviluppo di TryAI, Fable 5 ha renderizzato il Cubo di Rubik 3D al primo tentativo e prodotto il miglior SVG; Grok 4.5 ha richiesto una nuova esecuzione. Goldie Bench ha dato Fable 5 avanti 20-17 su 47 task one-shot, con vittorie nelle build shader e GPU physics per 0,8-1,6 punti | Quando il task è ambiguo e va risolto in un solo tentativo, emerge il limite superiore del ragionamento di Fable 5 |
Velocità, latenza e throughput
I numeri misurati da TryAI, con lo stesso routing del provider, limite di 400 token e tre esecuzioni per tipo di prompt:
| Metrica | Grok 4.5 | Fable 5 |
|---|---|---|
| Tempo al primo token | 0,44 s | 3,47 s |
| Throughput | 110 tok/s | 28 tok/s |
| Costo per risposta | $0,00002 | $0,00009 |
| Tasso di successo | 100% | 100% |
Grok genera 110 tok/s: circa il doppio di GPT-5.5 e Opus 4.8, e approssimativamente quattro volte i 28 tok/s di Fable 5. Artificial Analysis riporta per Fable 5 un dato ancora più severo con ragionamento al massimo sforzo: 113,68 secondi prima del primo token di risposta, contro 8,68 per Grok. Una volta avviato lo streaming, tuttavia, Fable 5 decodifica leggermente più rapidamente, a 63,1 contro 58,9 tok/s. In pratica, Grok appare reattivo nei cicli interattivi; Fable 5 concentra prima una lunga fase di ragionamento e la paga in tempo complessivo.
Accesso, abbonamenti e strumenti per agenti
Fable 5 è disponibile tramite API Anthropic, Claude Code e Cursor; gli abbonamenti Claude Pro a tariffa fissa coprono la maggior parte degli utilizzi non via API. L'ecosistema Claude Code — CLAUDE.md, plugin, skill e server MCP — ha alle spalle anni di maturazione.
Grok 4.6 è disponibile tramite API xAI e Grok Build CLI (curl -fsSL https://x.ai/cli/install.sh | bash), mentre X Premium include l'accesso alla chat. Secondo ClockedCode, Grok Build legge senza configurazione i file CLAUDE.md esistenti, i plugin di Claude Code, le skill, i server MCP, gli agenti e gli hook; può operare in modalità headless con il flag -p per CI ed espone un Agent Client Protocol per l'integrazione. L'ecosistema è più giovane, ma la compatibilità con Claude Code porta il costo di migrazione quasi a zero nelle configurazioni compatibili.
Per entrambi c'è un aspetto di fatturazione da ricordare: gli abbonati Claude Pro e X Premium pagano tariffe fisse, quindi contano più i limiti d'uso rispetto al proprio carico di lavoro che il listino.
Quale scegliere in base allo scenario
| La tua situazione | Scegli | Perché |
|---|---|---|
| Task di coding ben definiti e ad alto volume | Grok 4.6 | $2,81/task contro $17,32 a parità di punteggio CursorBench |
| Lavoro dove la correttezza è critica in un repository grande | Fable 5 | Finestra di contesto da 1M, primo nell'indice di intelligenza, migliore affidabilità al primo tentativo |
| Sessioni interattive con agenti e iterazioni rapide | Grok 4.6 | 0,44 s al primo token, 110 tok/s |
| Build one-shot ambigue e ragionamento più difficile | Fable 5 | Ha vinto il task più difficile di TryAI e gli scontri diretti di Goldie Bench |
| Spesa API con budget limitato | Grok 4.6 | Token in output a circa un ottavo del prezzo di Fable 5 |
La mia lettura: Grok 4.6 dovrebbe essere la scelta predefinita per il lavoro delimitato e ripetitivo; Fable 5 va riservato ai task in cui una risposta errata costa più dei token. I team con volumi reali dovrebbero usare entrambi e instradare le richieste in base alla dimensione rappresentativa dei task, al tasso di retry e al costo per task completato: costa meno che impegnarsi in esclusiva con uno dei due.
FAQ
Grok 4.6 è migliore di Fable 5 per il coding?
Su CursorBench sono alla pari: nel confronto di agosto, Grok 4.6 Extra High ha totalizzato 70,8% contro il 70,5% di Fable 5 Max. Fable 5 guida ancora il più ampio Artificial Analysis Intelligence Index (62 contro ~59) e vince sui task one-shot più difficili. Stabilire quale sia "migliore" dipende quindi dal collo di bottiglia: costo per task o limite di correttezza.
Grok 4.6 costa meno di Fable 5?
Sì: circa 6 volte meno per task CursorBench completato ($2,81 contro $17,32). Il confronto per token si basa sulla tariffa pubblicata di Grok 4.5 ($6 in output contro i $50 di Fable 5 per milione), poiché xAI non ha rilasciato un listino separato per 4.6; oltre i 200K token, dove i prezzi di Grok raddoppiano approssimativamente, il divario si riduce.
Quale modello ha la finestra di contesto più ampia?
Fable 5: 1.000.000 di token contro i 500.000 di Grok. Per i carichi di lavoro che mantengono in contesto un'intera codebase, questa differenza può pesare più del vantaggio di prezzo di Grok.
Grok Build può usare la mia configurazione Claude Code?
Sì. Grok Build legge automaticamente CLAUDE.md, i plugin Claude Code, le skill, i server MCP, gli agenti e gli hook senza porting, e aggiunge la propria directory .grok/ per la configurazione specifica di Grok.
I benchmark di Grok 4.5 sono una buona approssimazione per Grok 4.6?
Non per le capacità. Rispetto a 4.5, Grok 4.6 ha guadagnato circa cinque punti nell'Intelligence Index, riducendo il deficit di sei punti rispetto a Fable 5 a circa tre, e ha pareggiato con Fable 5 Max su CursorBench, dove 4.5 era chiaramente indietro. Le cifre su velocità e prezzi per token riportate in questo articolo sono misurazioni di Grok 4.5, perché non esistono ancora dati equivalenti pubblicati per Grok 4.6.
Il compromesso che resta irrisolto
Nessun benchmark di questo confronto stabilisce se il vantaggio di costo regga quando il repository ha 50.000 righe, il ticket è ambiguo e un tentativo fallito costa un'ora di debug. Il contesto da 1M e il maggiore limite di intelligenza di Fable 5 esistono proprio per questo scenario: certezza costosa contro i passaggi economici di Grok 4.6. Un divario abbastanza ampio da spingere la maggior parte dei team a tenere entrambi attivi.
Approfondimenti correlati: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5