 AIREITER
Grok 4.6 e GPT-5.6 Sol sono vicinissimi nell’Artificial Analysis Intelligence Index: circa 61 punti contro 58,9. Eppure Sol costa 5 volte di più per ogni token generato. Il confronto non si riduce però al listino: Sol offre una finestra di contesto doppia e ottiene risultati migliori nelle valutazioni sull’efficienza degli agenti, due aspetti che rendono meno immediata la scelta in base al valore.
Intelligenza generale simile, ma il punteggio non racconta tutto
L’Artificial Analysis Intelligence Index v4.1 riunisce in un solo punteggio test di ragionamento, programmazione e conoscenza. OpenAI indica 58,9 per GPT-5.6 Sol. Grok 4.6 avrebbe ottenuto circa 61, secondo segnalazioni della community che citano i dati dell’arena Artificial Analysis. Il dato diffuso dalla community non ha ancora ricevuto una conferma indipendente, ma è coerente con il posizionamento di Grok 4.6 come equivalente di Sol da parte di Artificial Analysis.
Un indice composito nasconde differenze importanti: ampiezza del contesto, efficienza degli agenti e variazioni tra benchmark. Sol registra risultati di spicco nelle valutazioni più orientate agli agenti, come Terminal-Bench 2.1 (88,8%) e DeepSWE v1.1 (72,7%), secondo i risultati pubblicati da OpenAI. I punteggi specifici di Grok 4.6 per questi test non sono ancora stati pubblicati in modo indipendente. L’Intelligence Index li considera pari sul piano dell’intelligenza generale; i benchmark per agenti potrebbero invece delineare un quadro diverso.
| Specifiche | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Sviluppatore | xAI | OpenAI |
| Finestra di contesto | 500K token (x.ai/api) | ~1.050.000 token (openai.com) |
| Input API (per 1M) | $2.00 (x.ai/api) | $5.00 (openai.com) |
| Output API (per 1M) | $6.00 (x.ai/api) | $30.00 (openai.com) |
| Intelligence Index v4.1 | ~61 (segnalato dalla community) | 58,9 (ufficiale) |
| Disponibilità cloud | Azure AI Foundry, Oracle OCI, Google Vertex (x.ai/api) | Azure, AWS Bedrock (openai.com) |
Prezzi API: input a 2,5 volte meno, output a un quinto
La pagina API di xAI quota Grok 4.6 $2.00 per milione di token in input e $6.00 per milione in output. Nella pagina dedicata a GPT-5.6, OpenAI indica invece $5.00 per l’input e $30.00 per l’output di Sol, sempre per milione di token.
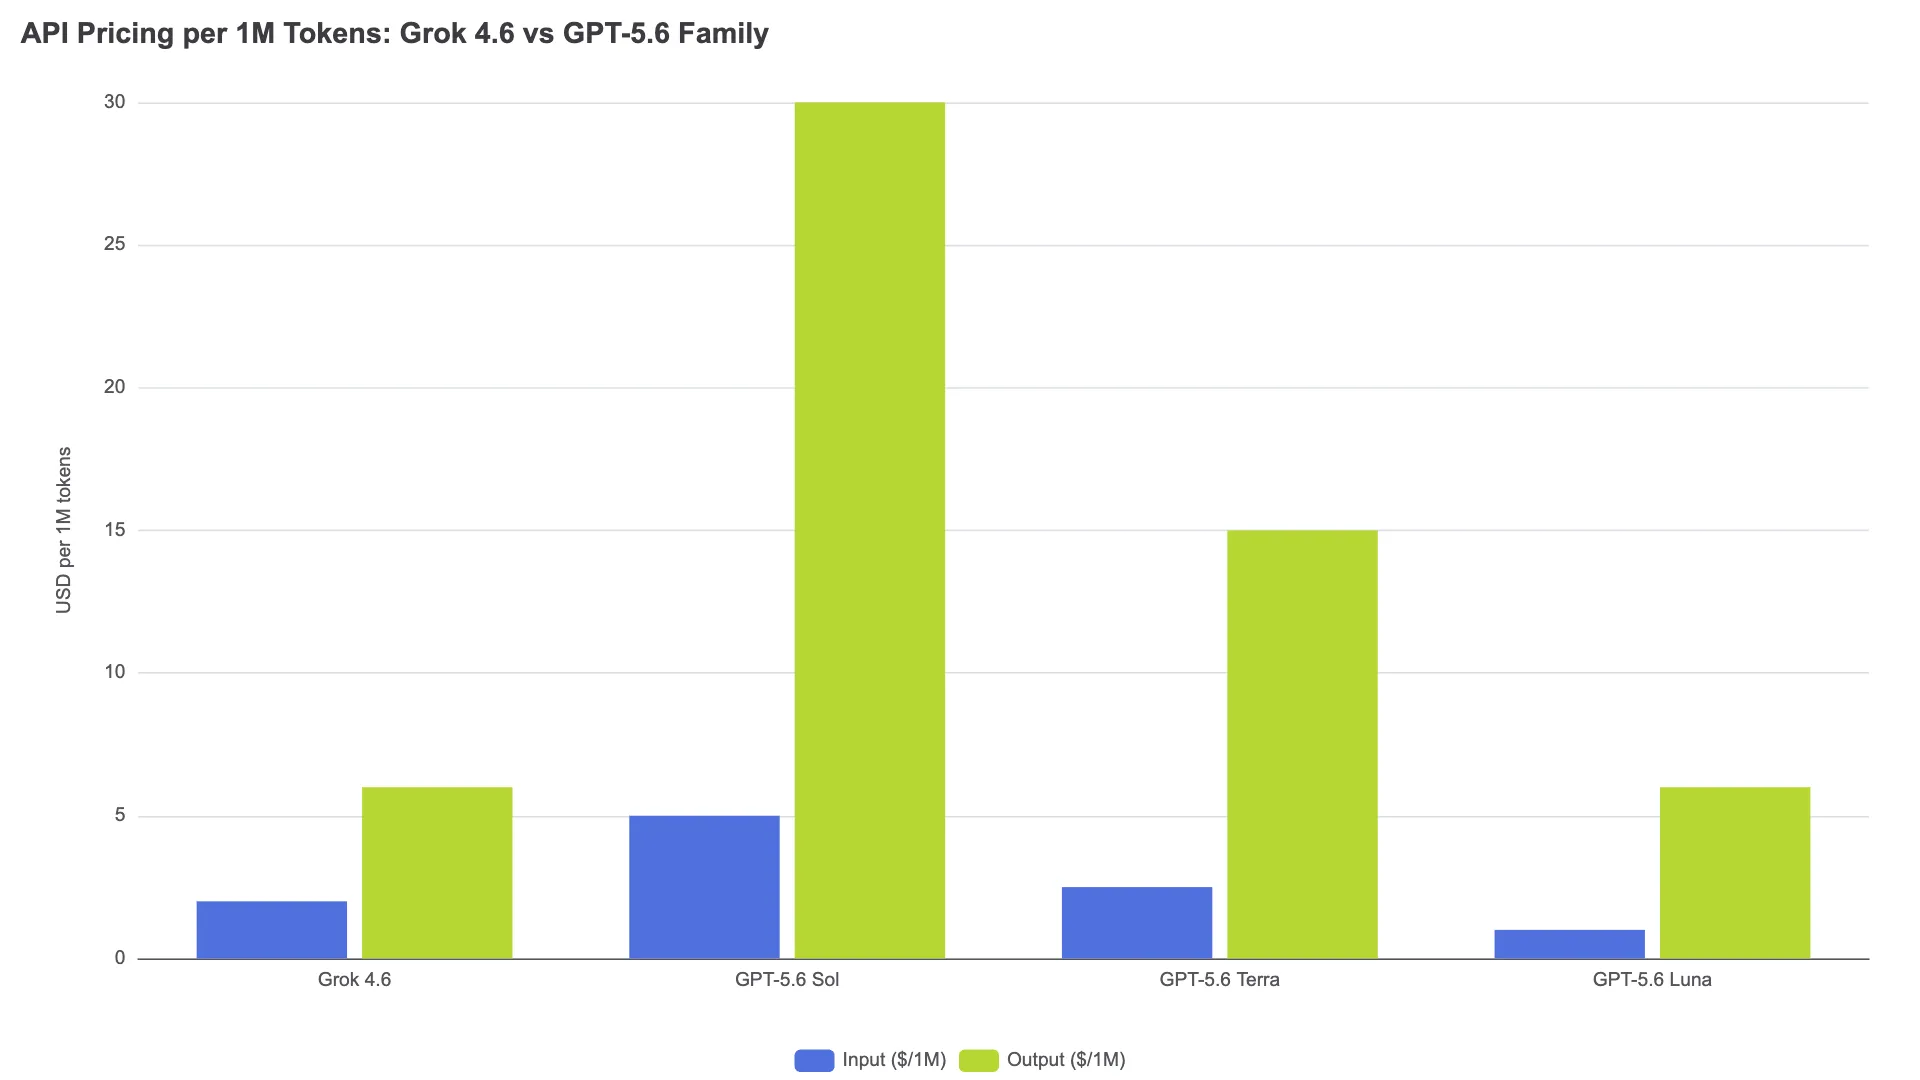
Con un carico mensile di 50M token in input e 10M in output, Grok 4.6 costa $160. Sol arriva a $550: una differenza di 3,4 volte, prima ancora di considerare che le modalità di ragionamento di Sol consumano più token per attività.
OpenAI propone anche fasce meno costose: GPT-5.6 Terra a $2.50/$15.00 e GPT-5.6 Luna a $1.00/$6.00 (il prezzo di Luna è stato ridotto dell’80% il 30 luglio 2026). Luna eguaglia Grok 4.6 sul prezzo dell’output e costa meno in input, ma è un modello più piccolo con punteggi inferiori in tutti i benchmark. Se il metro è la parità di intelligenza, il confronto corretto è Grok 4.6 contro Sol: su questa base, il vantaggio di costo di Grok è notevole.
Finestra di contesto: 500K contro 1M token
Secondo la pagina API di xAI, Grok 4.6 dispone di una finestra di contesto da 500K token. Sol arriva a circa 1,05 milioni di token, come riportato nella documentazione OpenAI. Cinquecentomila token sono sufficienti per il lavoro ordinario su componenti, moduli e per la maggior parte del codice a livello di servizio. Il milione di token di Sol fa la differenza quando occorre caricare in un unico prompt un intero monorepo, più documenti molto grandi oppure una lunga cronologia conversazionale. Se il flusso agentico deve analizzare in un passaggio 800K token di contesto del codebase, Sol può farlo; Grok 4.6 no.
C’è anche il tema dell’affidabilità nel recupero delle informazioni. OpenAI riporta un punteggio del 77,1% per Sol in GraphWalks BFS su 1M token. Grok non ha pubblicato risultati equivalenti sul recupero da contesti molto lunghi. In uno scenario come «trova il bug in questo codebase da 600K token», la finestra più ampia di Sol non riguarda quindi solo la capacità massima, ma anche l’effettiva possibilità che il modello recuperi informazioni a quella profondità.
Benchmark di coding e agenti: dove emergono le differenze
Il quasi pareggio nell’Intelligence Index non si riflette in modo uniforme nei benchmark specifici per il coding. La tabella mette i punteggi ufficiali di GPT-5.6 Sol pubblicati da OpenAI accanto ai risultati di Grok 4.5 riportati da Fritz.ai, usati come riferimento indicativo. I benchmark di coding specifici per Grok 4.6 non sono ancora stati pubblicati in modo indipendente: la colonna Grok va quindi letta come confronto con il predecessore, non come sfida diretta con Grok 4.6.
| Benchmark | GPT-5.6 Sol (ufficiale) | Grok 4.5 (riferimento indicativo) | Divario |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58,9 | - | Grok 4.6: ~61 (quasi pari) |
| Coding Agent Index v1.1 | 80,0 | - | Nessun dato per Grok 4.6 |
| Terminal-Bench 2.1 | 88,8% | 83,3% | Sol +5,5 punti |
| DeepSWE v1.1 | 72,7% | 53,0% | Sol +19,7 punti |
| SWE-Bench Pro | 64,6% | 64,7% | Sostanzialmente pari |
| GPQA Diamond | 94,6% | 93,1% | Sol +1,5 punti |
I vantaggi di Sol in Terminal-Bench e DeepSWE sono i più indicativi. Terminal-Bench misura la capacità di un agente di completare attività reali nel terminale: installare pacchetti, eseguire test e correggere errori. DeepSWE valuta il software engineering end-to-end su issue reali di GitHub. Il vantaggio di 19,7 punti di Sol su DeepSWE rispetto a Grok 4.5 suggerisce prestazioni sensibilmente migliori nei compiti di coding complessi e articolati, dove il modello deve pianificare, eseguire e riprendersi dagli errori. Resta da vedere se i miglioramenti post-training di Grok 4.6 ridurranno questo divario.
I benchmark indicano una direzione, non una sentenza definitiva: harness degli agenti, strumenti, prompt e ambienti di esecuzione influenzano i risultati. Un modello che ottiene un punteggio inferiore con un harness può superare l’altro con un setup diverso.
Non conta solo il token: conta il costo dell’attività completata
Il prezzo inferiore per token di Grok 4.6 domina sulla carta, ma gli agenti acquistano attività completate, non token. Se Sol porta a termine un compito di coding con 3.000 token in output e Grok 4.6 ne richiede 6.000 per lo stesso risultato, per via di più tentativi, catene di ragionamento più lunghe o un uso meno efficiente degli strumenti, il divario di costo si riduce.
Un’analisi di sensibilità con i prezzi attuali mostra l’intervallo possibile. Per un’attività di coding che richiede 10K token in input e 4K in output con Sol, contro 12K in input e 8K in output con Grok 4.6, ossia un vantaggio di efficienza token di 2 volte per Sol:
| Fattore di costo | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| Costo input | $0.05 | $0.024 |
| Costo output | $0.12 | $0.048 |
| Totale per attività | $0.17 | $0.072 |
Anche in questo scenario, sfavorevole a Grok per un fattore di efficienza 2x, Grok 4.6 resta 2,4 volte meno costoso per attività. Alcuni utenti Reddit che citano Artificial Analysis hanno stimato il costo di Grok 4.6 per attività dell’Intelligence Index in circa $0.86. La capacità di Grok di mantenere il vantaggio di costo a un’efficienza token paragonabile a Sol dipende, nel carico di lavoro specifico, dalla complessità del task e dall’harness dell’agente.
Il rischio concreto non è l’economia dei token, ma il completamento dell’attività. I punteggi superiori di Sol in Terminal-Bench e DeepSWE indicano che riesce in compiti agentici complessi nei quali Grok potrebbe fallire del tutto, imponendo un nuovo tentativo o l’intervento umano. Un’attività non completata costa più di una conclusa con successo, a qualunque prezzo.
Accesso e integrazioni nell’ecosistema
Entrambi i modelli non sono più limitati all’API di un solo fornitore. La pagina API di xAI e la documentazione OpenAI sono le fonti principali per questo confronto:
| Canale di accesso | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry (x.ai) | Azure OpenAI (openai.com) |
| AWS | Non indicato | Bedrock (openai.com) |
| Google Cloud | Vertex Model Garden (x.ai) | Non indicato |
| Oracle | OCI Generative AI (x.ai) | Non indicato |
| Integrazioni IDE | Cursor, Devin | Cursor, Codex |
| Compatibilità SDK | SDK OpenAI + Anthropic (x.ai) | SDK OpenAI |
| Chat per utenti finali | SuperGrok ($30/mo), X Premium+ | ChatGPT Plus ($20/mo) (fritz.ai) |
| Addestramento sui dati consumer | Adesione predefinita; opt-out necessario | Dati API/Business esclusi per impostazione predefinita |
Stando alla documentazione di xAI, Grok supporta sia gli SDK OpenAI sia Anthropic: per migrare bastano quindi la modifica della chiave API e dell’endpoint. Per codice sensibile o proprietario, la policy di OpenAI che esclude per default dall’addestramento i dati API e Business rappresenta un vantaggio negli acquisti aziendali; gli utenti consumer di Grok devono invece disattivare manualmente l’uso per il training, secondo l’analisi sulla privacy di Fritz.ai.
Quale modello scegliere?
| Carico di lavoro | Scelta | Motivo |
|---|---|---|
| Agenti di coding ad alto volume | Grok 4.6 | Costo per token inferiore di 2,5-5x su larga scala |
| Attività agentiche complesse e multi-step | GPT-5.6 Sol (provvisorio) | I vantaggi nei benchmark per agenti sono rispetto a Grok 4.5, non 4.6 |
| Analisi di codebase molto grandi (>500K token) | GPT-5.6 Sol | Finestra di contesto doppia |
| Elaborazione batch sensibile ai costi | Grok 4.6 | Intelligenza quasi equivalente a un costo per token più basso |
| Ricerca social/web in tempo reale | Grok 4.6 | Ricerca nativa su X e sul web (x.ai) |
| Codice sensibile / proprietario | GPT-5.6 Sol | I dati API non vengono usati per l’addestramento per impostazione predefinita |
| Deploy enterprise su Azure | Entrambi | Entrambi disponibili su Azure AI Foundry |
Il modo più affidabile per decidere è eseguire un campione rappresentativo delle attività reali su entrambe le API. Confrontate tasso di completamento con successo, costo mediano per attività completata, numero di tentativi e latenza.
FAQ
Conviene confrontare Grok 4.6 con GPT-5.6 Terra anziché con Sol?
Terra ($2.50/$15.00) è più vicina a Grok 4.6 sul prezzo, ma ottiene punteggi inferiori a Sol in tutti i benchmark pubblicati: Intelligence Index 55,0, Coding Agent Index 77,4, Terminal-Bench 87,4% (secondo OpenAI). Se il criterio è l’intelligenza, Grok 4.6 contro Sol è il confronto equo. Se invece conta il prezzo, Grok 4.6 contro Terra favorisce Grok sia nei costi sia nei benchmark. Luna ($1.00/$6.00) è meno costoso di entrambi, ma richiede un compromesso significativo sulla qualità.
Per approfondire specifiche e capacità di Grok 4.6, consultate la nostra guida a Grok 4.6. Per un confronto tra GPT-5.6 e una versione precedente di Grok, la nostra analisi GPT-5.6 Sol vs. Grok 4.5 copre il confronto con il predecessore.