 AIREITER
Grok 4.6 è arrivato il 12 agosto 2026, cinque giorni oltre quanto lasciavano intendere le «due settimane» di Elon Musk. Sulla carta non cambia nulla: $2.00 per milione di token in input, $6.00 in output e una finestra di contesto da 500K, esattamente le condizioni di Grok 4.5. Nella pratica, però, il conto sale: l'input in cache costa il 67% in più rispetto alla versione precedente e le misurazioni indipendenti mostrano che il modello consuma più token per portare a termine gli stessi compiti.
Cosa è arrivato il 12 agosto
L'ID del modello è grok-4.6 e le note di rilascio di SpaceXAI ne datano la disponibilità via API al 12 agosto 2026. Questa è la scheda tecnica documentata:
| Caratteristica | Grok 4.6 |
|---|---|
| ID modello | grok-4.6 |
| Contesto | 500K token |
| Input | Testo e immagini |
| Output | Solo testo, senza un limite di output dichiarato |
| Livello di ragionamento | low, medium, high (predefinito), xhigh |
| Cutoff della conoscenza | 1 febbraio 2026 |
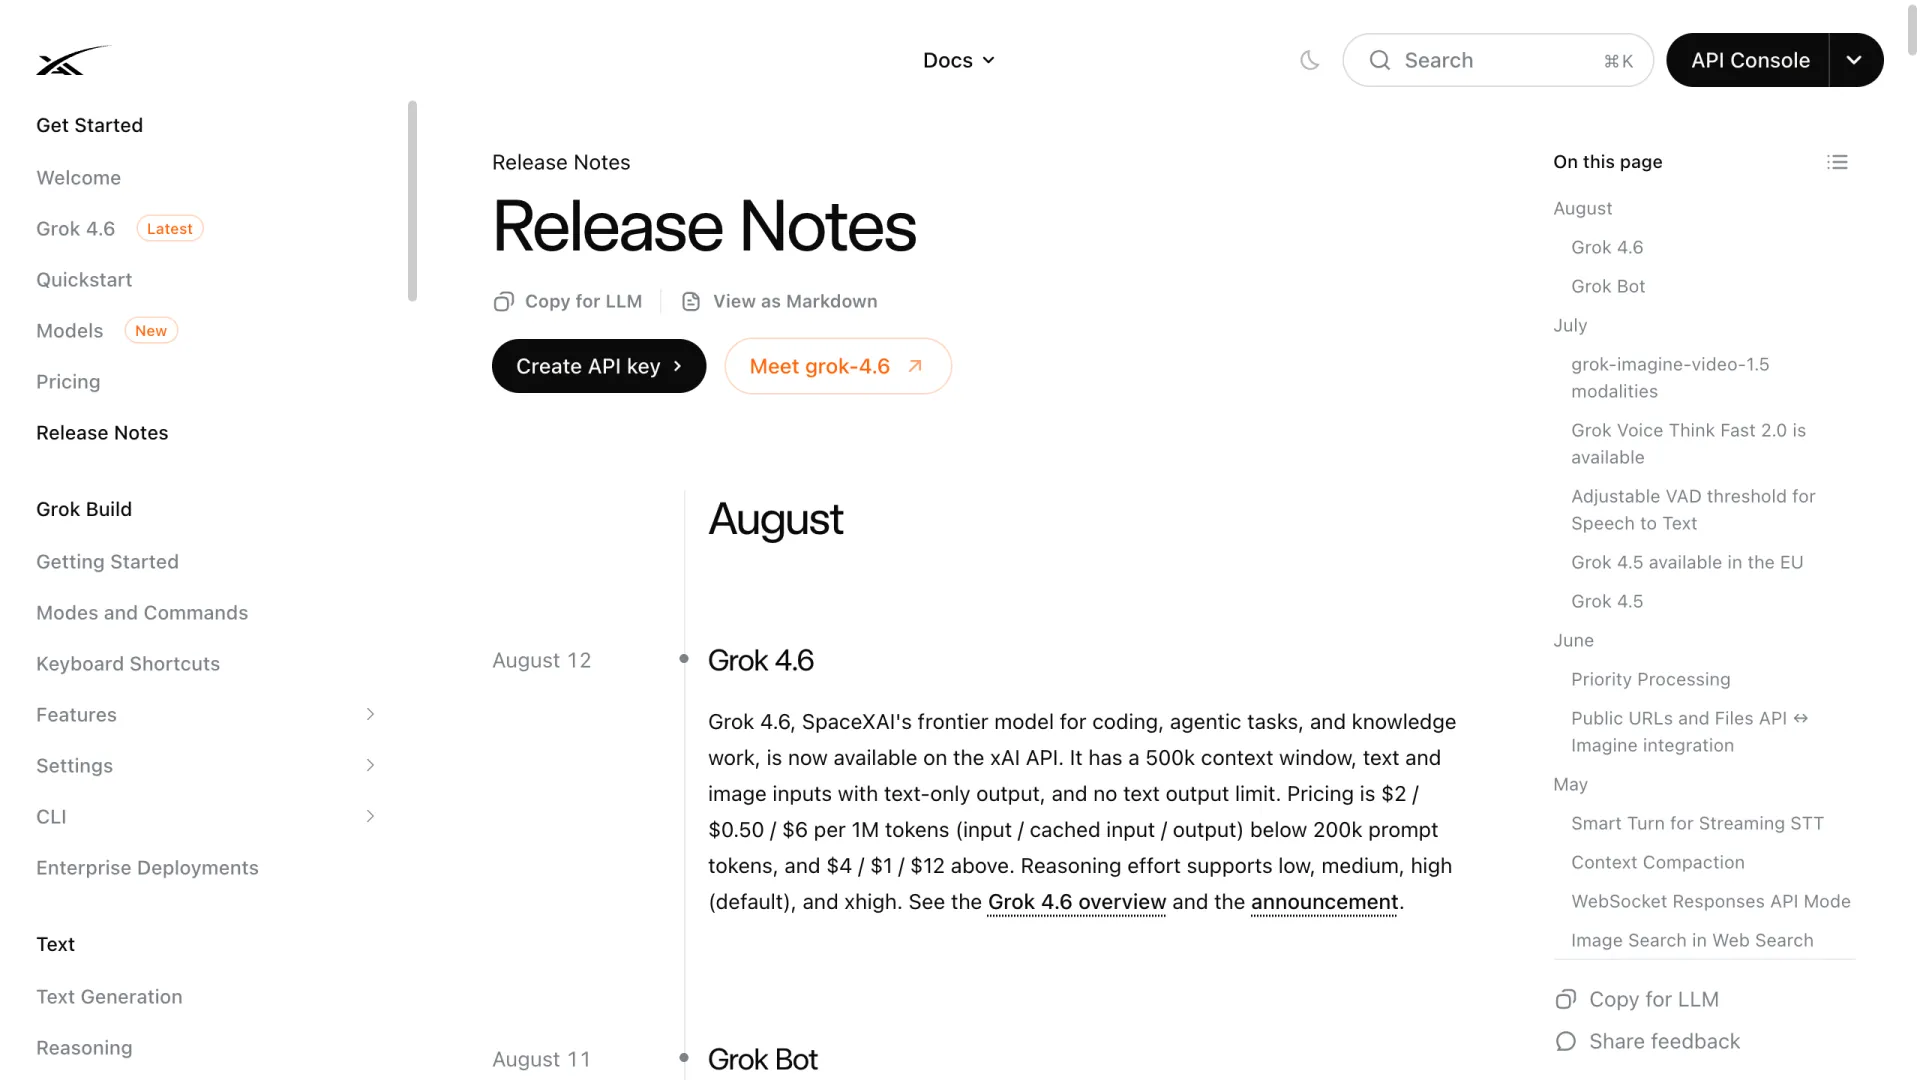
Due righe della tabella sono novità. xhigh è il quarto livello di ragionamento, assente in Grok 4.5, che si ferma a high. La documentazione introduce inoltre un cutoff della conoscenza al 1 febbraio 2026: un dato importante per chi instrada le domande datate aggirando il punto cieco del modello.
Nel catalogo dei modelli, Grok 4.6 è indicato come flagship per codice e chat, con il tag Latest nella barra laterale e pagina datata 12 agosto 2026. Grok 4.5 non è stato ritirato: continua a comparire nella pagina dei prezzi con le sue tariffe.
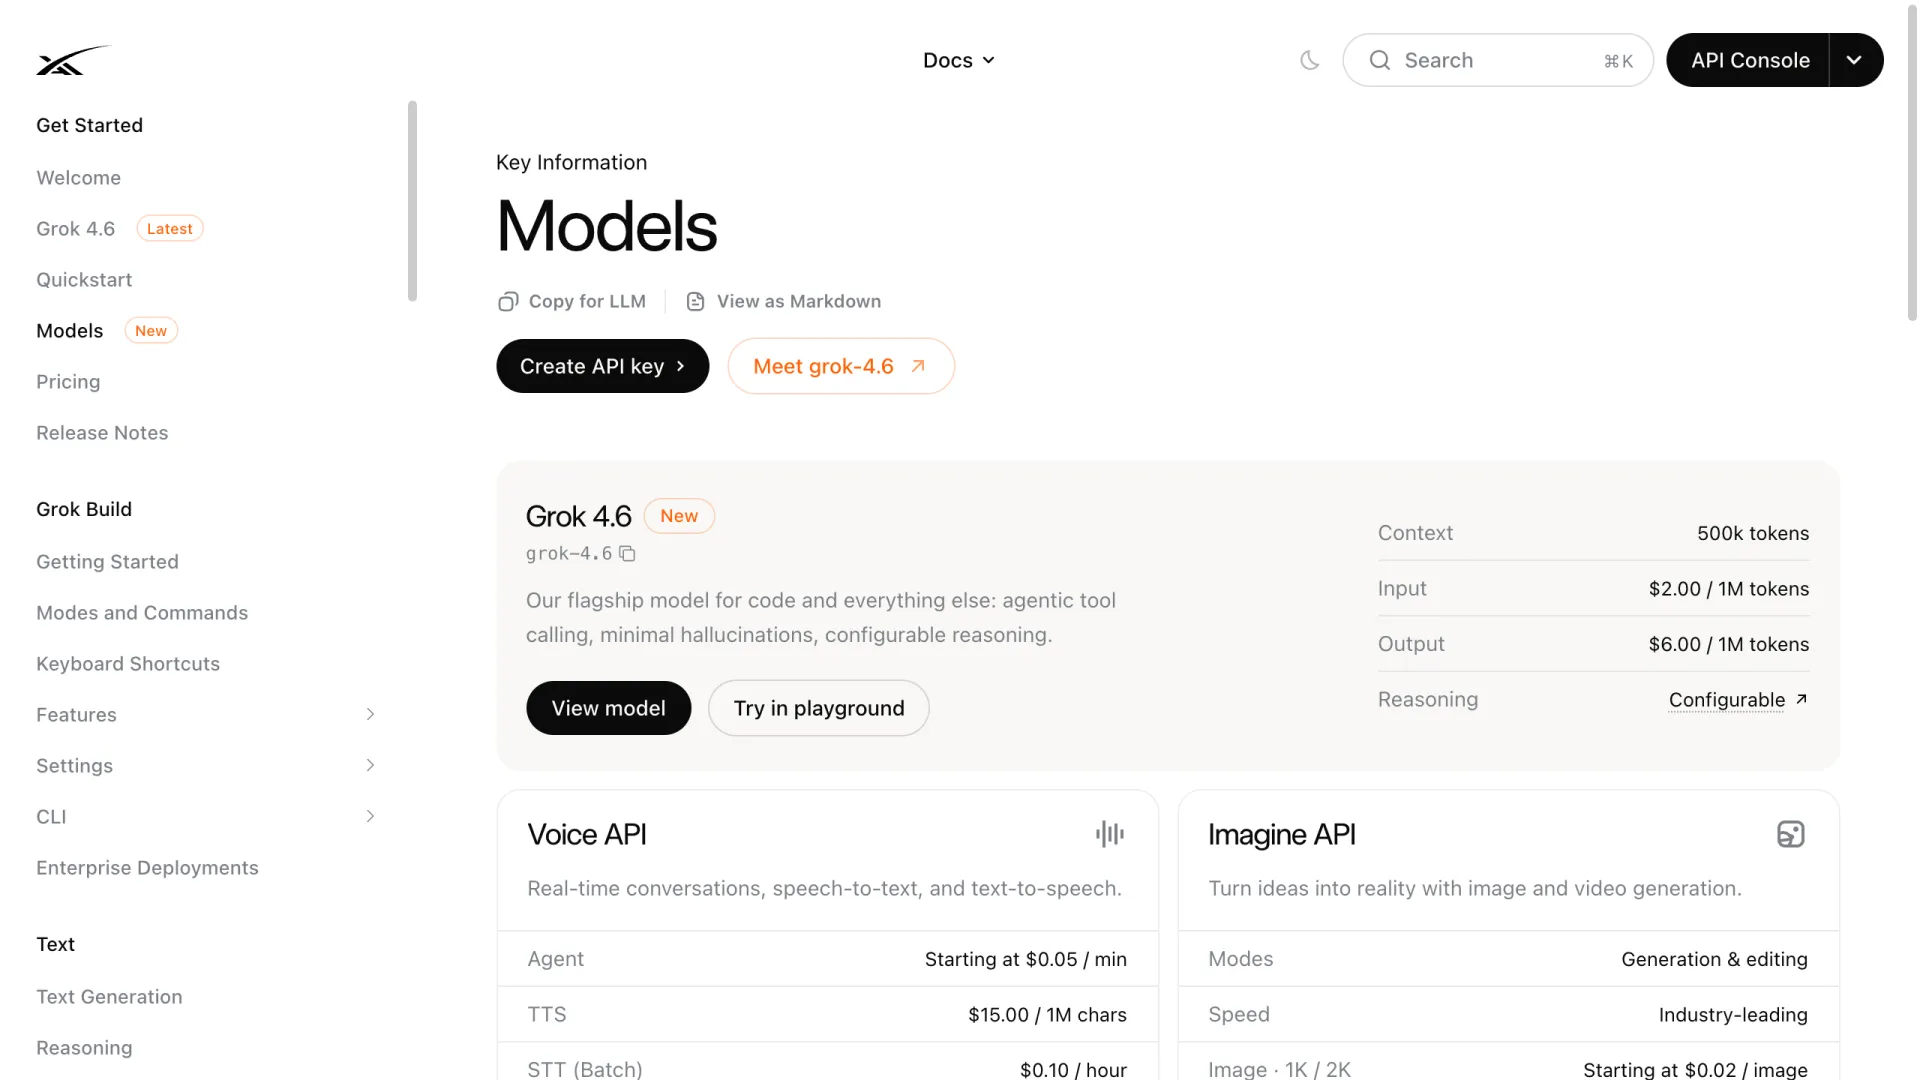
La distribuzione è stata ampia fin dal primo giorno. Nell'annuncio, SpaceXAI cita Cursor e Grok Build, entrambi con 2x di utilizzo incluso per la prima settimana, oltre all'API e a partner quali OpenRouter, Vercel e Cloudflare. Viene citata anche una variante veloce al doppio del prezzo; non compare però ancora nella pagina dei prezzi pubblica, quindi il dato 2x va considerato come quanto dichiarato nell'annuncio e non come una tariffa pubblicata.
Prezzi di Grok 4.6: listino invariato, cache più cara
Le tariffe per input e output restano identiche a quelle di Grok 4.5. A cambiare è il costo dell'input in cache.
| Tariffa per 1M token | Grok 4.5 | Grok 4.6 |
|---|---|---|
| Input (sotto 200K) | $2.00 | $2.00 |
| Input in cache (sotto 200K) | $0.30 | $0.50 |
| Output (sotto 200K) | $6.00 | $6.00 |
| Input / cache / output (200K+) | $4.00 / $0.60 / $12.00 | $4.00 / $1.00 / $12.00 |
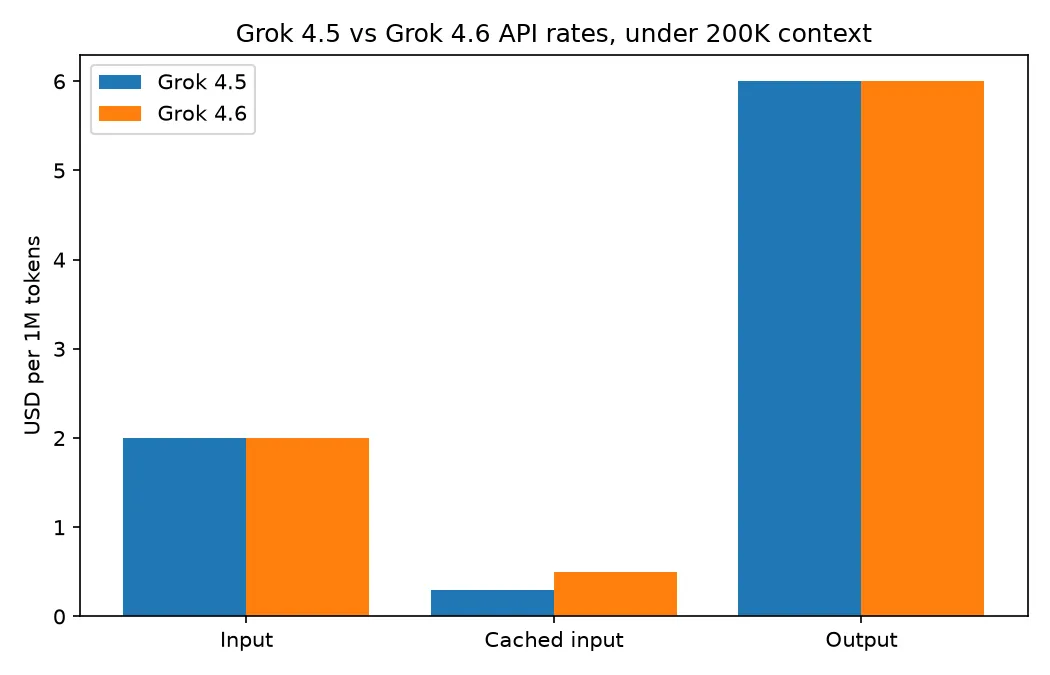
Lo sconto sull'input in cache passa dall'85% al 75%: 20 centesimi in più per milione di token proprio sulla voce che cresce con i passaggi di un agente, non con il numero di attività. Un harness che riproduce 50M di token in cache al giorno paga $15.00 con 4.6, contro $9.00 con 4.5.
La regola del contesto lungo non cambia, e continua a cogliere molti di sorpresa. Quando il prompt di una richiesta raggiunge 200K token, tutti i token della richiesta vengono fatturati alla fascia superiore: una chiamata da 210K token costa $4.00 per milione di token input sull'intera richiesta, non una combinazione delle due fasce. Anche la scheda pubblica del modello su OpenRouter riporta le stesse tariffe e la stessa soglia a 200K, quindi passare da una route di terze parti non modifica i calcoli.
Dove Grok 4.6 primeggia, e dove no, nei test ufficiali
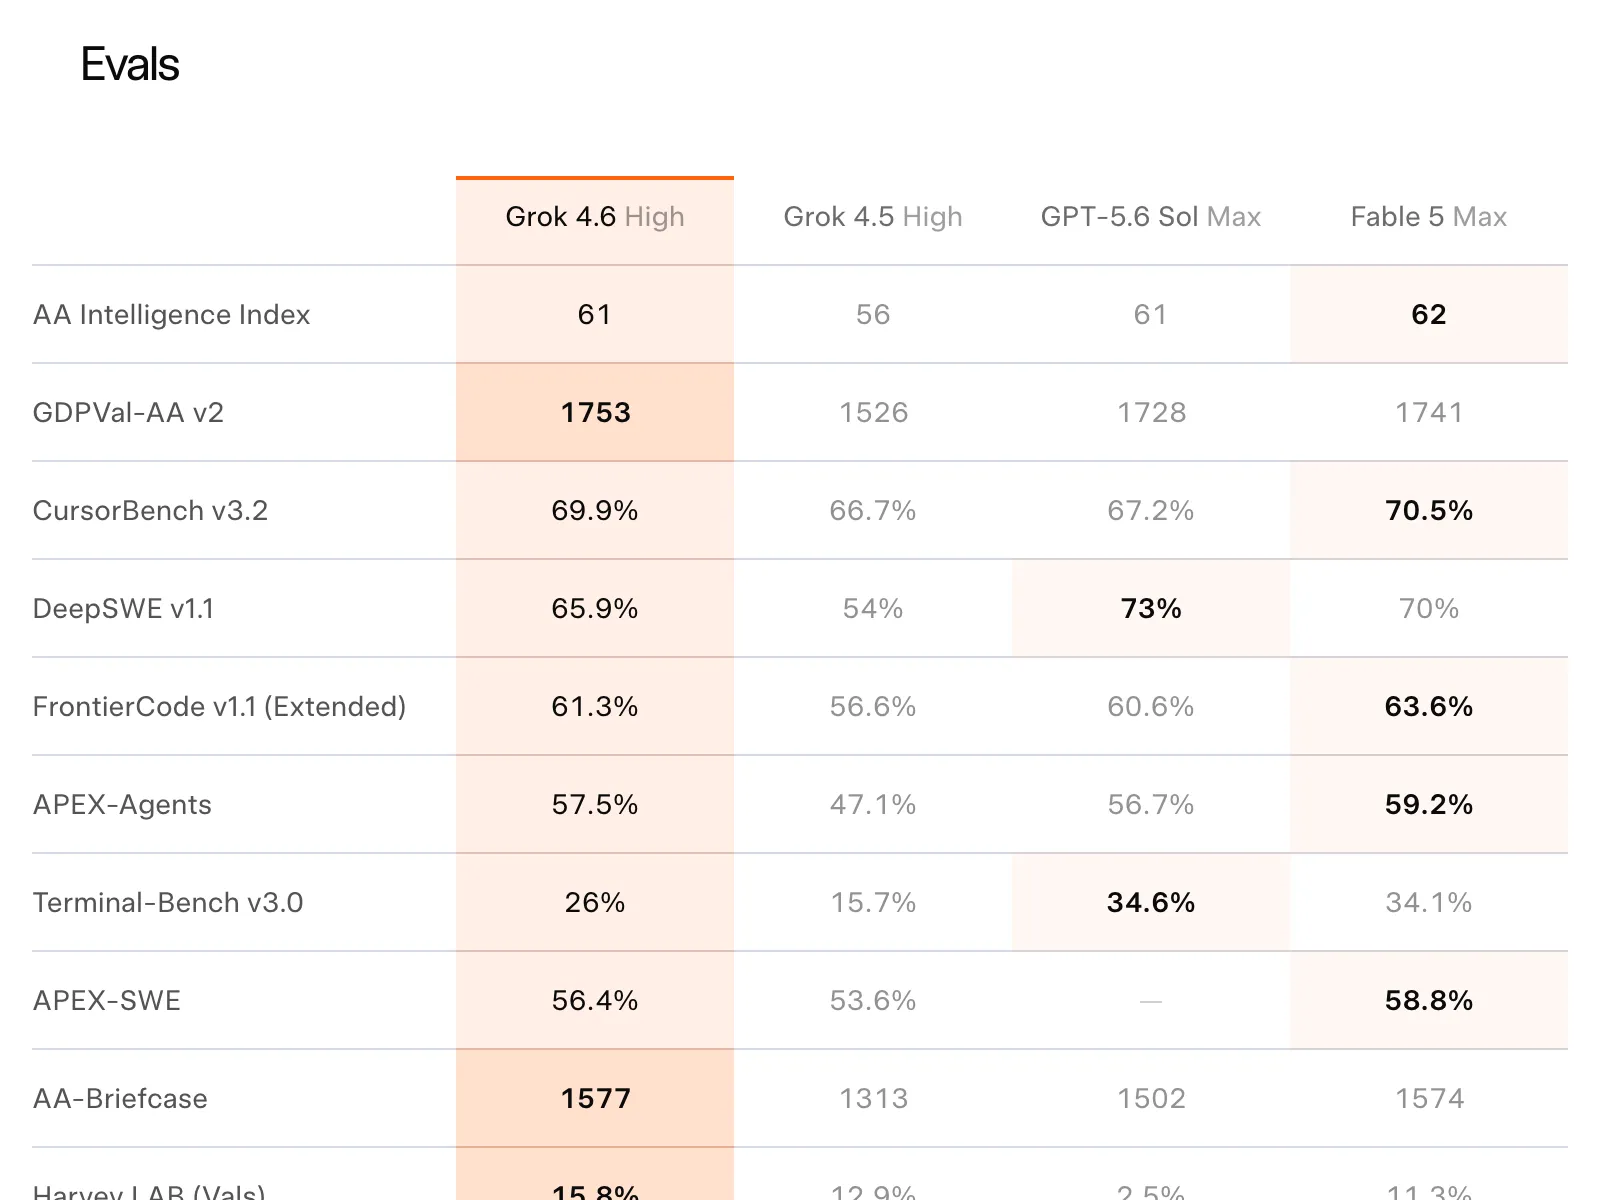
SpaceXAI ha pubblicato un confronto su dieci righe con Grok 4.5, GPT-5.6 Sol Max e Fable 5 Max. Grok 4.6 ottiene il punteggio più alto in tre test: GDPVal-AA v2 (1753), AA-Briefcase (1577) e Harvey LAB (15.8%). Negli altri sette non è in testa. Le otto righe più utili per decidere il routing sono queste:
| Valutazione | Grok 4.6 | Grok 4.5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
Terminal-Bench è il divario da leggere due volte. Grok 4.6 ottiene il 26%, contro il 34.6% di GPT-5.6 Sol e il 34.1% di Fable 5: terzo posto, con otto punti di distacco, nel test che più ricorda un agente al controllo di una shell. DeepSWE racconta la stessa storia con numeri diversi: 65.9% contro il 73% di Sol. Se il carico di lavoro riguarda agenti guidati dal terminale, la tabella del vendor dice chiaramente che questo non è il modello di riferimento.
Il salto rispetto a Grok 4.5 è comunque reale e uniforme. Tutte le righe migliorano, mentre APEX-Agents (dal 47.1% al 57.5%) e Terminal-Bench (dal 15.7% al 26%) guadagnano oltre dieci punti. SpaceXAI attribuisce il risultato a un ciclo supplementare di addestramento più lungo, traiettorie SFT rigenerate e RL agentico in ambienti di coding e knowledge work. C'è però un dato che nell'annuncio non viene mai fornito: il numero di parametri. La cifra di 2 trilioni associata al modello arriva da Musk, non dal rilascio.
Il costo misurato delle prestazioni in più
Le tabelle dei vendor riportano i punteggi, non quanto è costato ottenerli. Artificial Analysis pubblica entrambi i dati, e la sua rilevazione del 13 agosto mette in luce il compromesso reale di Grok 4.6.
| Misurato sullo stesso indice | Grok 4.5 (high) | Grok 4.6 (high) |
|---|---|---|
| Intelligence Index | 56 (#16 di 184) | 61 (#6 di 184) |
| Velocità di output | 56.9 token/s (#102) | 67.6 token/s (#74) |
| Token di output generati | 60M | 72M |
| Costo dell'intera valutazione | $579.21 | $1,068.47 |
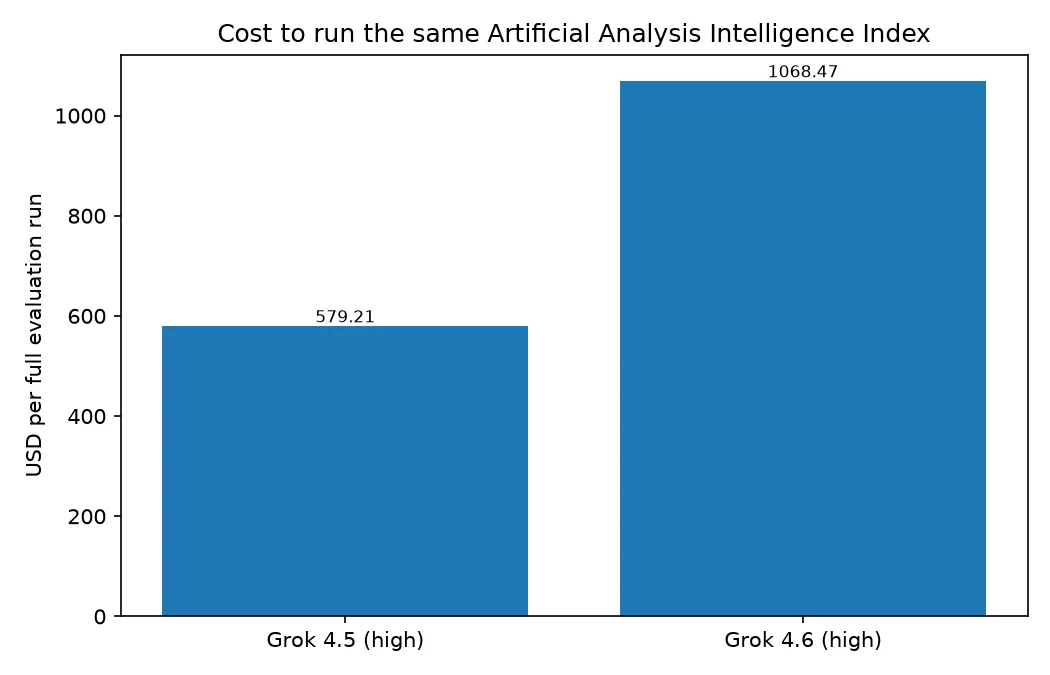
Cinque punti di intelligence costano 1.8x. Le tariffe di listino sono identiche, ma la stessa suite di benchmark è costata $489 in più: in parte per la maggiore verbosità, 72M di token output contro 60M, e in parte per il rincaro della cache visto sopra. Artificial Analysis non pubblica il dettaglio delle singole voci della prova, quindi 1.8x è un totale osservato, non una formula che si possa ricostruire.
La velocità va invece nella direzione giusta: 67.6 token di output al secondo contro i 56.9 di 4.5. Il modello passa così dalla metà bassa a circa la mediana dei 184 modelli della sua classe.
Le promesse di Musk e il prodotto effettivamente rilasciato
Il nome è comparso pubblicamente in una risposta di tre parole. Il 18 luglio, rispondendo a @minchoi, Musk ha scritto: «Our 2T model, which is better than our 1.5T in every way, will finish initial training next week. It might be able to exceed Kimi, but with speed and token efficiency close to our 1.5T (aka Grok 4.5).» Alla domanda di Andrew Curran se si trattasse di Grok 4.6, ha risposto: «Yeah, Grok 4.6.»
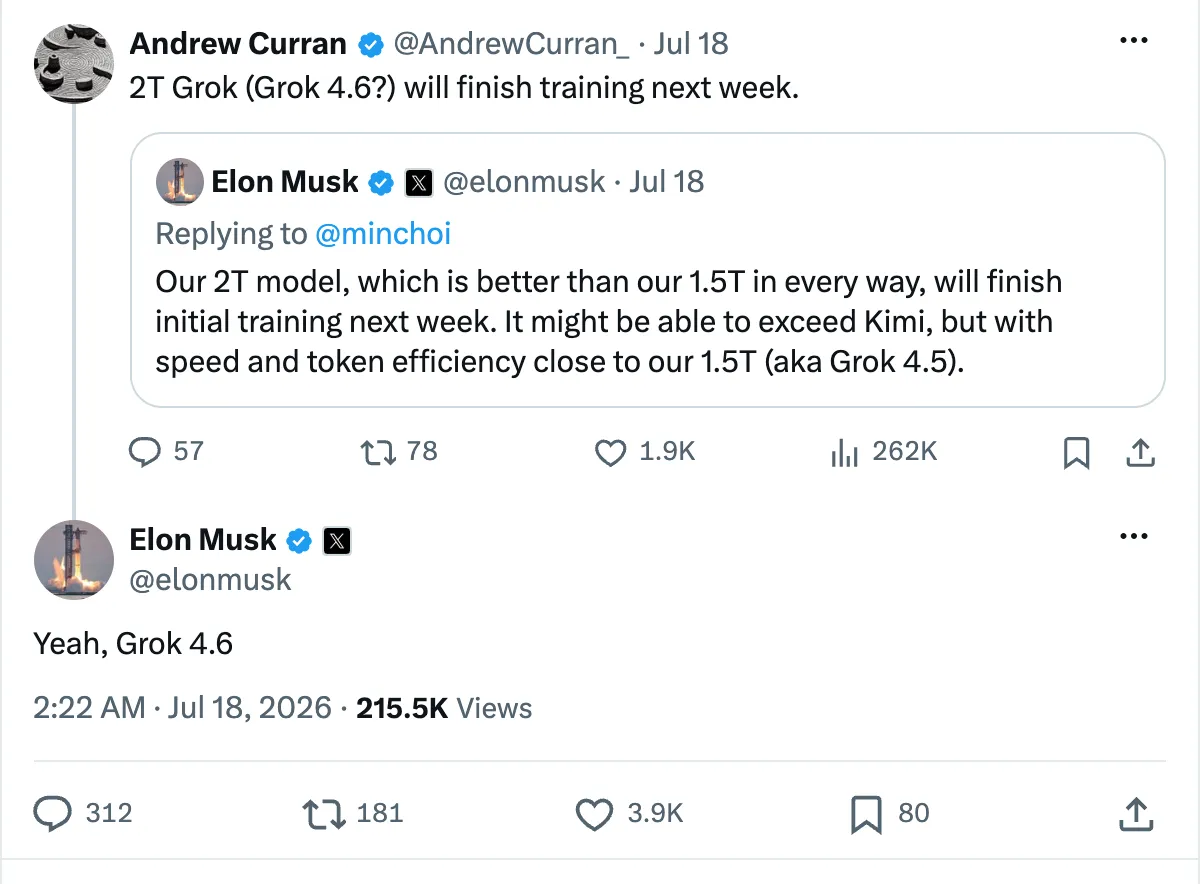
Il 24 luglio è arrivata la tabella di marcia: «Grok 4.6 in 2 weeks and Grok 4.7 in 4 weeks.» Due settimane da quella data portano intorno al 7 agosto; il modello è stato rilasciato il 12 agosto, cinque giorni dopo.
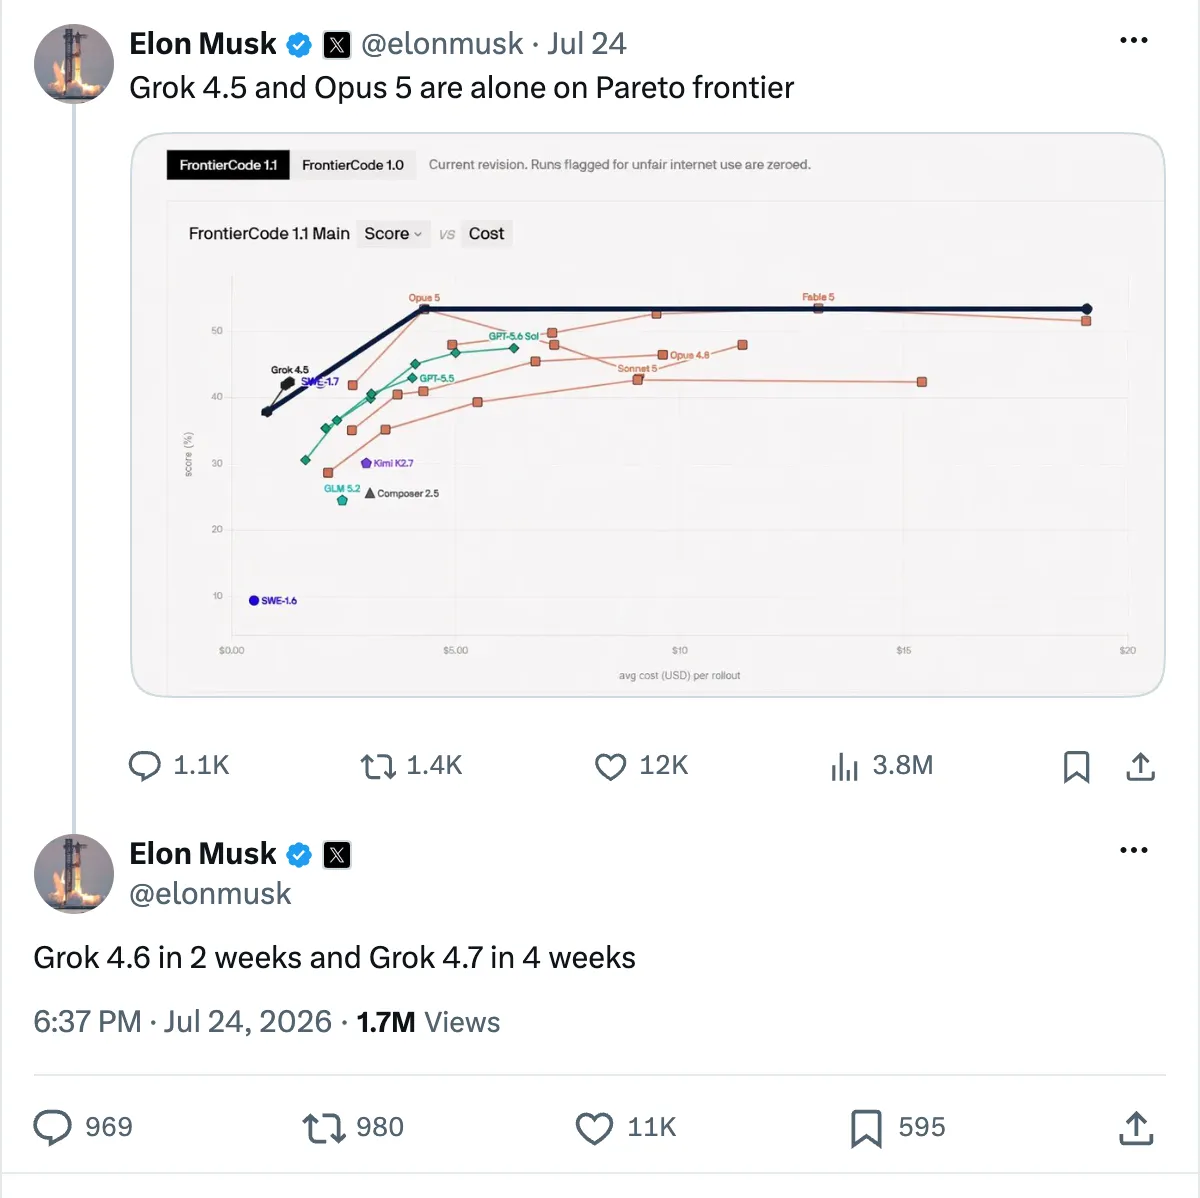
Tre affermazioni di quei post non hanno trovato piena conferma nel rilascio:
- 2 trilioni di parametri restano non confermati. L'annuncio, la documentazione del modello e le note di rilascio di SpaceXAI non forniscono alcun conteggio dei parametri per Grok 4.6.
- «Efficienza dei token vicina a Grok 4.5» è smentita dalla misurazione di Artificial Analysis: 72M token di output contro 60M nella stessa valutazione.
- «Potrebbe superare Kimi» rimane un'ipotesi non verificata rispetto a K3 di Moonshot, che non compare nella tabella di SpaceXAI, limitata al confronto con GPT-5.6 Sol e Fable 5.
Conviene passare da Grok 4.5 a Grok 4.6?
Sì, per il lavoro agentico e basato sulla conoscenza, se si parte da Grok 4.5. Il conto dei token va però controllato dopo una settimana, non dato per scontato al momento della migrazione. Grok 4.5 è ancora disponibile alle tariffe precedenti: il passaggio è reversibile e va misurato.
Ha senso migrare subito per agenti a lungo orizzonte o attività di knowledge work: APEX-Agents cresce di 10.4 punti, GDPVal-AA di 227, e la maggiore velocità di generazione si accumula nelle esecuzioni multi-step. Meglio restare su 4.5 se il traffico sfrutta molto la cache ed è sensibile al prezzo: l'aumento del 67% sulle letture in cache è un effettivo passo indietro, mentre i punteggi di 4.5 non sono diminuiti con l'arrivo di 4.6. Per gli agenti da terminale in particolare, conviene guardare altrove: la stessa tabella di SpaceXAI colloca Grok 4.6 otto punti dietro GPT-5.6 Sol e Fable 5.
Prima di spostare una route di produzione, ci sono tre verifiche da fare:
- Considerate entrambi gli ID come alias. Le regole sugli alias di SpaceXAI puntano
grok-4.6alla build stabile più recente egrok-4.6-latesta quella più nuova; solo un ID datato<modelname>-<date>è immutabile, ma né il catalogo dei modelli né OpenRouter elencano una variante 4.6 con data. Oggi non è quindi possibile fissare una versione per flussi riproducibili. - Ritestare il livello di ragionamento. Il nuovo livello
xhighnon è un upgrade gratuito: consuma più token su un modello già misurato come più verboso del suo predecessore. Il valore predefinitohighè il confronto omogeneo con 4.5. - Verificare la disponibilità presso il proprio provider. La disponibilità dal primo giorno su SpaceXAI non significa disponibilità immediata ovunque. Interrogando
/v1/modelsil 13 agosto, sia l'API ufficiale sia OpenRouter restituivanogrok-4.6; un endpoint rivenditore compatibile con OpenAI che ho testato si fermava invece agrok-4.5e rifiutava il nuovo ID conmodel_not_found. Prima di instradare il traffico, verificate che l'ID esatto risponda con la vostra chiave.
FAQ
Quanto costa la API di Grok 4.6?
$2.00 per milione di token input e $6.00 per milione di token output sotto i 200K di contesto, con input in cache a $0.50. Oltre i 200K token nel prompt, l'intera richiesta viene fatturata a $4.00 per l'input, $1.00 per la cache e $12.00 per l'output. Nell'annuncio viene citata una variante veloce al doppio del prezzo, ma non figura nella pagina dei prezzi pubblica.
Grok 4.6 è migliore di Grok 4.5?
Sì, in tutti i benchmark pubblicati da SpaceXAI: 61 contro 56 nell'AA Intelligence Index, con i maggiori progressi nelle valutazioni agentiche. Le misurazioni indipendenti aggiungono però una precisazione: ha generato 72M di token output contro i 60M di Grok 4.5 nella stessa valutazione, quindi la stessa attività costa di più.
Quanti parametri ha Grok 4.6?
Non è stato divulgato. Musk ha descritto il 18 luglio 2026 un modello da 2 trilioni di parametri e ne ha confermato il nome, ma i materiali di rilascio di SpaceXAI non indicano un conteggio dei parametri, dettagli sull'architettura né quanti parametri vengano attivati per token.
Quali sono la finestra di contesto e il cutoff della conoscenza di Grok 4.6?
La finestra di contesto è di 500K token, con input testuale e visivo e output esclusivamente testuale. La documentazione indica un cutoff della conoscenza al 1 febbraio 2026 e il modello non può accedere agli eventi successivi senza Web Search o X Search lato server abilitati.
Grok è prodotto da xAI o da SpaceXAI?
I due nomi indicano la stessa azienda. La documentazione per sviluppatori si chiama «SpaceXAI Docs» e il footer dell'annuncio riporta ancora X.AI LLC, dopo il passaggio sotto SpaceX nel 2026. I domini x.ai e gli ID modello grok-* non sono stati rinominati.
Quando uscirà Grok 4.7?
Non è stata annunciata alcuna data. Nel post del 24 luglio Musk collocava Grok 4.7 a circa quattro settimane di distanza, quindi attorno al 21 agosto 2026, mentre Grok 4.6 è arrivato cinque giorni dopo la propria data implicita.
Approfondimenti correlati
- Grok 4.5: tutto quello che sappiamo finora
- GPT-5.6 Sol e Terra vs Grok 4.5
- Claude Opus 5: cosa è confermato
Prezzi, ID dei modelli e risultati dei benchmark verificati il 13 agosto 2026 rispetto alla documentazione SpaceXAI, all'annuncio di Grok 4.6 e ad Artificial Analysis.