 AIREITER
Sulla carta, i prezzi dell'API GPT Image 2.6 non sono cambiati. Nella pratica, però, le bozze economiche sono diventate sensibilmente più costose. OpenAI applica gli stessi prezzi a token per gpt-image-2.6-flare e gpt-image-2.6-sunburst, ma nei test l'output in qualità low ha consumato 4,2 volte più token rispetto a GPT Image 2.5. Per evitare sorprese in fattura, conviene impostare sempre la qualità in modo esplicito.
Un'immagine 1:1 costa da $0.025 a $0.211: la qualità low non è più economica
Con un prompt identico, il costo di una singola immagine GPT Image 2.6 in formato 1:1 va indicativamente da $0.025 in qualità low a $0.211 in qualità max. Il 5 novembre 2026, TrezaLabs ha generato lo stesso prompt 1:1 ai cinque livelli di qualità, con un addebito di $0.00003 per token di output dell'immagine.
| Qualità | Token di output misurati | Costo indicativo per immagine 1:1 |
|---|---|---|
| Low | 824 | $0.025 |
| Medium | 1,449 | $0.043 |
| High | 1,756 | $0.053 |
| Extra high | 3,122 | $0.094 |
| Max | 7,024 | $0.211 |
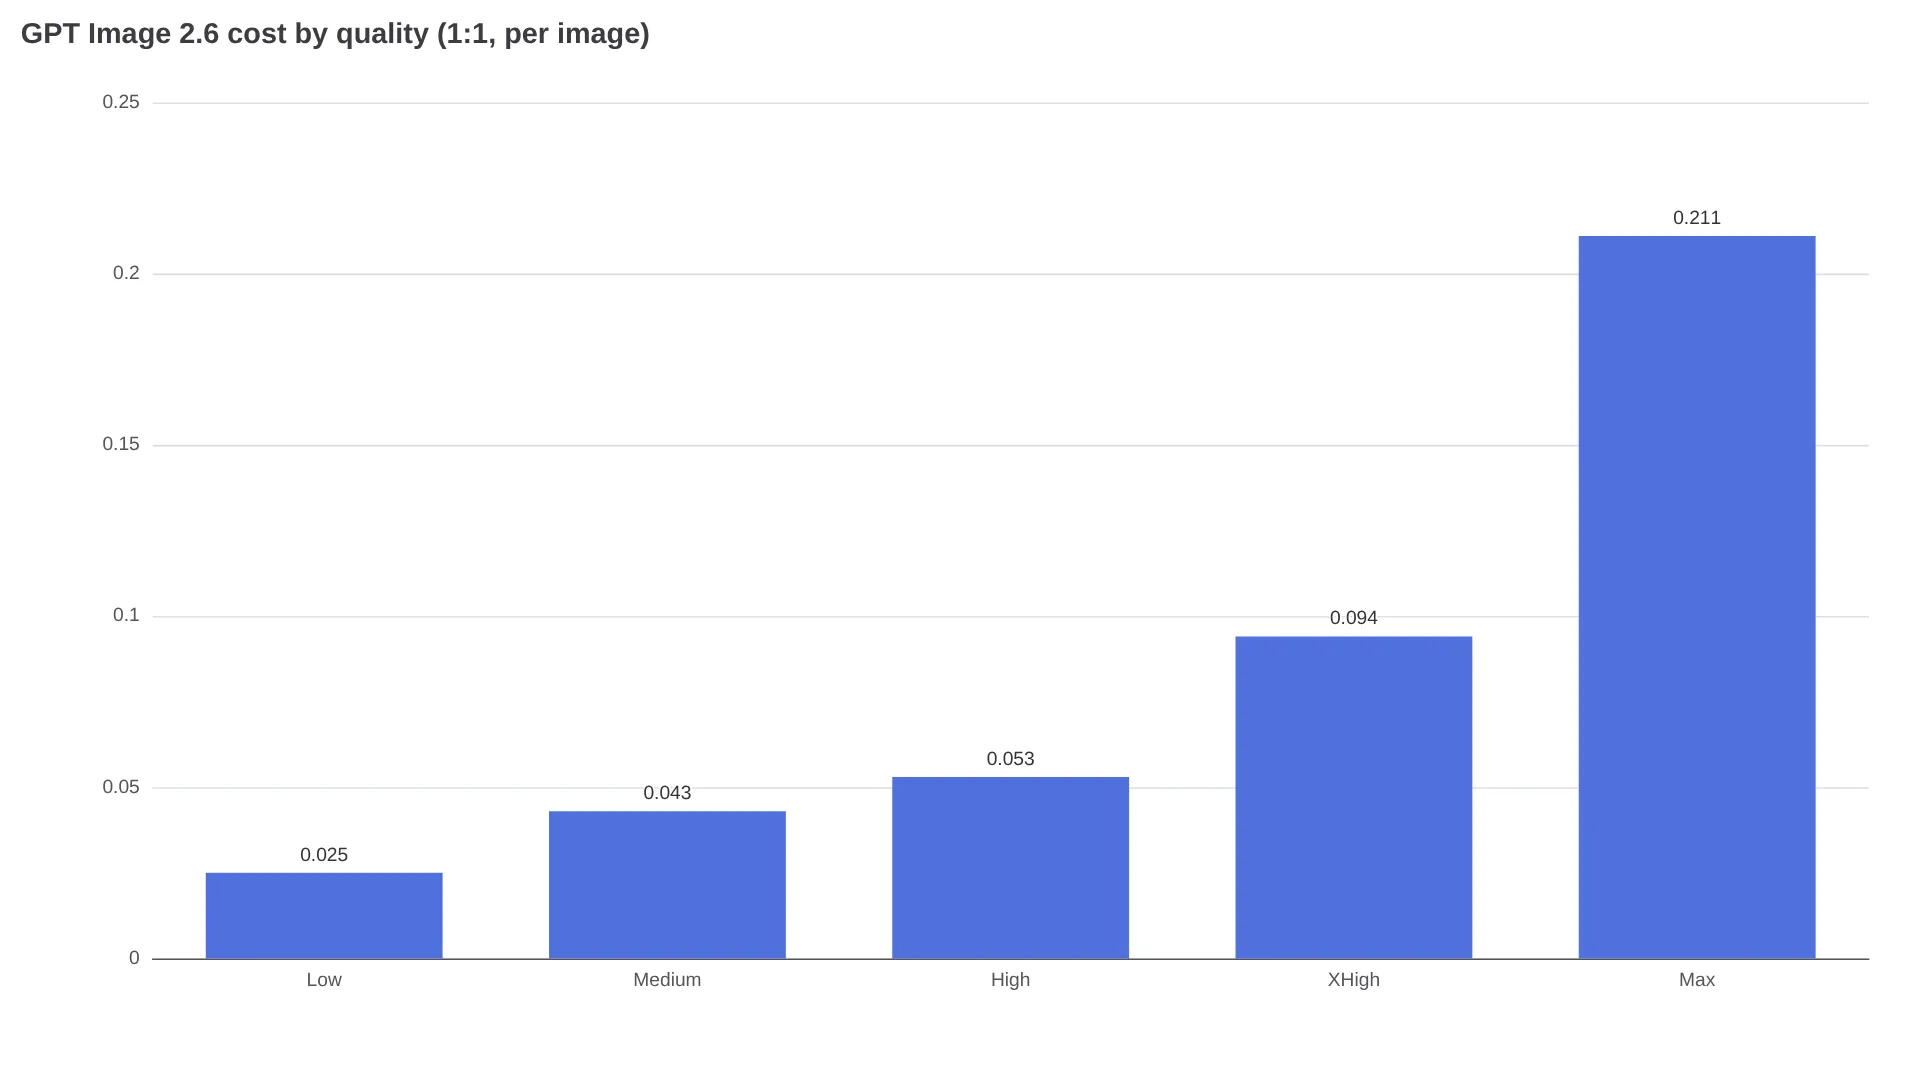
Il punto critico è passare alla nuova versione senza rivedere il parametro quality. La qualità low di GPT Image 2.6 non corrisponde più alla fascia di bozze sotto il centesimo offerta da GPT Image 2.5. Per 100 bozze low, considerate $2.47 di soli output, più gli input; per 100 immagini finali max, circa $21. Non sono la stessa voce di spesa.
Tariffe ufficiali a token e perché le tabelle di prezzo non coincidono
Nel listino API di OpenAI, GPT Image 2.6 Flare e Sunburst hanno le stesse tariffe standard: $5 per 1M di token testuali in input, $1.25 per 1M di token testuali in input in cache, $8 per 1M di token immagine in input, $2 per 1M di token immagine in input in cache e $30 per 1M di token immagine in output. La pagina ufficiale dei prezzi resta il riferimento quando le tariffe vengono aggiornate. Anche le pagine modello OpenAI di Flare e Sunburst confermano gli stessi prezzi a token.
Le tre prospettive di prezzo più citate misurano aspetti diversi:
- Tariffe ufficiali a token indicano il prezzo unitario, non il totale per immagine. I token di output cambiano in base a qualità e dimensione, mentre le immagini di riferimento aggiungono separatamente token immagine in input.
- Fatturazione su token misurati traduce in dollari un prompt fisso. TrezaLabs ha misurato da 824 a 7,024 token di output dal livello low al max in 1:1, oltre a un piccolo costo per i token testuali. Mockingbird ha rilevato circa 1,600 token di output per un annuncio 1088x1360 in qualità high, pari a circa $0.048 di solo output prima degli input.
- Griglie fisse per immagine di terze parti semplificano la pianificazione. HiAPI pubblica una griglia di 15 celle, da $0.023 per low 1K a $0.636 per max 4K. Yir stima invece circa $0.0367-$0.2227 per 1K, da low a max, attraverso il percorso ufficiale.
Usate le tariffe ufficiali per contratti e budget, i token misurati per il vostro prompt e la vostra dimensione, e le griglie fisse solo per una stima approssimativa della capacità. Una quotazione fissa di $0.04 per immagine presuppone qualità, risoluzione e numero di riferimenti specifici, che potrebbero non coincidere con la vostra pipeline.
I livelli di qualità sono low, medium, high, xhigh, max e auto. Le risoluzioni disponibili sono 1K, 2K e 4K. Una qualità più alta compra più dettaglio interno, non più pixel: TrezaLabs ha ottenuto immagini da 1024x1024 a ogni livello di qualità 1:1. complexity (low/medium/high, con high come valore predefinito) regola lo sforzo di pianificazione, non il dettaglio visivo, e non prevede un costo separato.
Perché il budget di GPT Image 2.5 non regge il passaggio a 2.6
GPT Image 2.6 usa lo stesso prezzo per token di GPT Image 2.5. Tuttavia, nelle misurazioni 1:1 citate da TrezaLabs, la versione 2.6 ha impiegato più token di output alle qualità low e medium, a parità di formato 1:1.
| Qualità | Token GPT Image 2.5 | Token GPT Image 2.6 | Effetto sul costo |
|---|---|---|---|
| Low | 196 | 824 | ~4.2x in più |
| Medium | 439 | 1,449 | ~3.3x in più |
| High | 1,756 | 1,756 | invariato |
| Extra high | 3,122 | 3,122 | invariato |
| Max | 7,024 | 7,024 | invariato |
Il costo della qualità low è passato da meno di $0.01 su 2.5 a circa $0.025 su 2.6; quello della medium da circa $0.013 a circa $0.043. Anche il thread di fatturazione su r/codex conferma l'aumento di 4,2 volte per la qualità low (thread). Per grandi volumi di bozze economiche, quindi, conviene mantenere GPT Image 2.5 e impostare quality in modo esplicito, evitando la variabilità di auto (TrezaLabs).
Flare o Sunburst: stesso costo, tempi molto diversi
Flare e Sunburst condividono le tariffe ufficiali a token e nei test limitati si sono mantenuti entro il 3% l'uno dall'altro. La scelta del tier va quindi fatta soprattutto in base alla latenza, dopo aver testato il proprio carico di lavoro. TrezaLabs ha rilevato conteggi di token identici, salvo due token di differenza alla qualità high. Mockingbird ha misurato circa il 3% di token di output in più per Flare negli annunci, con una differenza di costo per immagine entro $0.001.
La velocità è il vero elemento di separazione. Il 5 novembre 2026 TrezaLabs ha cronometrato lo stesso prompt a ogni livello di qualità, con una sola generazione per livello: un'indicazione utile, non un benchmark formale.
| Qualità | Tempo totale Flare | Tempo totale Sunburst |
|---|---|---|
| Low | 6 sec | 17 sec |
| Medium | 10 sec | 27 sec |
| High | 10 sec | 50 sec |
| Extra high | 23 sec | 82 sec |
| Max | 41 sec | 166 sec |
Gli annunci 1088x1360 in qualità high testati da Mockingbird hanno richiesto 16-26 secondi con Flare e 51-55 secondi con Sunburst 2.6, a fronte di $0.089-$0.108 contro $0.088-$0.107. OpenAI dichiara una generazione più veloce del 50% e tempi fino a sei secondi per Flare in qualità low (annuncio); Mockingbird ha confermato il vantaggio di velocità di Flare, ma nei suoi due test pubblicitari ha trovato Sunburst 2.6 più lento di Sunburst 2.5. OpenAI posiziona Flare per l'iterazione rapida e Sunburst per la coerenza dei dettagli (annuncio).
Le prime discussioni degli utenti sono tendenzialmente scettiche sul compromesso tra qualità e velocità, come mostrano la discussione su r/singularity e i thread di r/OpenAI:
Vorrei davvero che sistemassero il modello perché smettesse di aggiungere questa brutta texture maculata.
— u/lyeeedar, thread di test GIF su r/OpenAI
GIF, SVG e immagini di riferimento hanno costi aggiuntivi
Gli output extra vengono fatturati al di fuori della griglia base per livello di qualità. Ogni formato segue una regola di fatturazione e presenta un vincolo principale.
| Funzione | Costo aggiuntivo | Regola di fatturazione | Vincolo principale |
|---|---|---|---|
| GIF | Da $0.070 in low a $0.598 in max (HiAPI) | Conta solo la qualità, non la risoluzione; 2-16 fotogrammi, 9 predefiniti, 20-2,000 ms per fotogramma | Limiti del foglio: lato massimo 3840 px, area massima 8,294,400 px, rapporto massimo 3:1 |
| SVG | +$0.030 sul prezzo del tier (HiAPI) | Sovrapprezzo fisso; low 1K $0.053, max 4K $0.666 | Solo text-to-image; image-to-image resta su PNG, JPEG e WebP |
| Immagini di riferimento | Esempio: +$0.012 ciascuna; varia in base ai token | Prezzo base del tier + $0.012 x quantità nell'esempio citato, 1-16 riferimenti (HiAPI) | Una foto prodotto ha usato 1,523 token di input (TrezaLabs); nell'esempio, 16 riferimenti aggiungono $0.192 |
I livelli mask e markup non comportano costi extra (HiAPI).
Le assenze di Batch e Responses che incidono sulla spesa
Al lancio, GPT Image 2.6 funziona soltanto sugli endpoint generations ed edits della Images API: non supporta né Responses API né Batch API (confronto). GPT Image 2.5 conserva l'accesso a Responses e Batch, incluso un prezzo Batch di $15 per 1M di token di output.
- Per GPT Image 2.6 non esiste lo sconto Batch del 50%, quindi i team ad alto volume non possono programmare batch 2.6 notturni a metà prezzo.
- Gli agenti basati su Responses devono restare su 2.5 oppure separare lo stack tra il ragionamento via Responses e le chiamate alla Images API, con una gestione distinta dei retry.
- Gli abbonamenti ChatGPT non coprono l'uso dell'API. ChatGPT e Codex includono Images 2.6 in tutti i piani, incluso quello gratuito (annuncio), ma le chiamate API sono fatturate a token. ChatGPT non offre inoltre un selettore Flare/Sunburst documentato: per test riproducibili, impostate esplicitamente l'ID del modello.
Un workflow controllato nei costi, senza rallentare la produzione
Un workflow GPT Image 2.6 attento alla spesa usa Flare in qualità low per le bozze e riserva Sunburst in high o max agli asset finali.
- Generate 100 varianti con Flare low 1:1, per circa $2.47 di soli output, più gli input. Valutate la composizione, non le texture.
- Portate 10 candidate su Flare high, a circa $0.053 ciascuna di solo output, ossia circa $0.53 per il passaggio. Controllate testo, mani ed etichette dei prodotti.
- Completate 2-3 asset con Sunburst high o max. Due finali max 1:1 costano circa $0.42 di soli output.
- Limitate i riferimenti. Nell'esempio citato, sei moodboard inutilizzate aggiungono circa $0.072 a ogni generazione: più del costo di una stessa immagine 1:1 low.
- Impostate esplicitamente
qualityecomplexity; OpenAI raccomanda complexity low per modifiche mirate (Mockingbird).
| Carico di lavoro | Impostazione | Costo di output indicativo per 100 immagini |
|---|---|---|
| Bozze in volume | Flare low 1:1, misurato | $2.47 |
| Revisione quasi finale | Flare high 1K, proxy 1:1 misurato | ~$5.30 |
| Finali a pagamento | Sunburst max 1:1, misurato | $21.10 |
Riservate GPT Image 2.6 a menu leggibili, etichette, poster e modifiche che preservano il prodotto, casi in cui il rendering del testo giustifica una spesa di $0.05-$0.21 per immagine.
FAQ
Flare e Sunburst costano uguale?
Sì. OpenAI indica le stesse tariffe a token per gpt-image-2.6-flare e gpt-image-2.6-sunburst. I token di output misurati dai tester coincidono entro il 3%, quindi il costo per immagine differisce di circa $0.001. Scegliete in base a velocità e coerenza nelle modifiche, non al prezzo.
Perché non esiste un prezzo fisso per immagine?
OpenAI fattura $30 per 1M di token immagine in output, più i token in input, ma i token di output per immagine vanno da circa 824 a 7,024 in 1:1 a seconda della qualità. Qualsiasi cifra fissa in dollari presuppone qualità, risoluzione e numero di riferimenti.
GPT Image 2.6 costa più di GPT Image 2.5?
Alle qualità low e medium, sì: circa 824 contro 196 token in low e 1,449 contro 439 in medium. Da high in poi, i token misurati sono identici. Le pipeline incentrate sulle bozze dovrebbero mantenere 2.5 per le varianti economiche.
Come vengono fatturate GIF e SVG?
Le GIF sono fatturate esclusivamente in base alla qualità: da circa $0.070 in low a $0.598 in max per 2-16 fotogrammi. Le SVG aggiungono circa $0.030 al prezzo del tier e funzionano solo per text-to-image.
Quali token incidono davvero sulla fattura?
I token immagine in output, a $30 per 1M, sono la componente dominante; un prompt testuale da 1,000 token costa $0.005 a $5 per 1M. Il testo in cache ($1.25) e gli input immagine ($2) aiutano nelle modifiche ripetute con riferimenti condivisi, ma i token di output non vengono messi in cache.