 AIREITER
Oggi la maggior parte degli sviluppatori può davvero chiamare GPT-6 Cyber? No. Stando alla documentazione OpenAI, ai benchmark dei provider e alle testimonianze degli utenti, GPT-6 Cyber è uno specialista degli exploit molto potente, ma resta vincolato all’approvazione Daybreak Red. Per la maggior parte del lavoro difensivo, invece, GPT-6 Astra offre una copertura adeguata a metà prezzo.
Rilasciato il 5 novembre 2026 con il nome gpt-6-cyber, è una versione post-train di GPT-6 Astra dedicata alla ricerca autorizzata di vulnerabilità, alla validazione degli exploit e allo sviluppo di patch. L’accesso è subordinato a Daybreak Red, secondo Kingy e la documentazione sulla lineage di BenchLM.
Red o Blue? La scelta in 30 secondi
Il percorso di accesso a GPT-6 Cyber dipende dal lavoro da svolgere, non soltanto dall’account. Daybreak Blue è pensato per la difesa sui modelli principali, mentre Daybreak Red copre le attività offensive autorizzate e il modello gpt-6-cyber.
| Il tuo lavoro | Tier da richiedere | Modello da usare | Cosa cambia |
|---|---|---|---|
| Code review di sicurezza, analisi malware, risposta agli incidenti, validazione delle patch | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Meno rifiuti rispetto allo standard, ma nessuna autorizzazione allo sviluppo di exploit |
| Pentest autorizzati, red team, validazione di exploit su larga scala | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Approvazione separata, valore daybreak_red nella richiesta, IP allowlist, SSO/MFA |
| Sviluppo generale con revisioni di sicurezza occasionali | Standard o Blue | gpt-6-sol, gpt-6.1-sol | Non vale la pena pagare il sovrapprezzo di Cyber |
| Ricerca su target hardenizzati o zero-day con necessità di riproducibilità | Daybreak Red (se qualificati) | gpt-6-cyber | Prevedere revisione umana e sandboxing |
La guida Daybreak API di OpenAI è chiara: il parametro nella richiesta non concede alcun accesso. Organizzazione, progetto, programma e modello devono essere già approvati, e la chiave deve provenire da quel progetto.
In pratica: chiedi Blue se ti occupi di difendere il software. Punta a Red soltanto se puoi documentare incarichi offensivi autorizzati, gestire un’infrastruttura isolata e mantenere una persona nel ciclo di approvazione.
Che cos’è davvero GPT-6 Cyber e cosa significa la valutazione Critical
GPT-6 Cyber è uno specialista a pesi chiusi, disponibile soltanto via API e Codex, derivato da GPT-6 Astra con un reinforcement learning aggiuntivo focalizzato sulla cybersecurity. L’addestramento privilegia la capacità di sviluppare exploit, il rispetto dell’ambito autorizzato e la descrizione trasparente del lavoro incompleto, secondo l’analisi della system card di Kingy.
La finestra di contesto è ampia ma non illimitata, come evidenzia l’analisi della documentazione di Kingy: 1.050.000 token di contesto, 922.000 token massimi in input, 128.000 token massimi in output, input testuale e immagini con output testuale. È disponibile tramite Responses e Chat Completions, con streaming, function calling e structured output. Fine-tuning e Batch API non sono supportati.
Critical è la fascia di capacità del Preparedness Framework interno di OpenAI, non una certificazione di sicurezza indipendente. OpenAI classifica GPT-6 Cyber e GPT-6 Astra come Critical per la cybersecurity, rispetto a High per GPT-5.6 Cyber, secondo ArtificialWatch. Questa fascia indica che il modello può identificare e sviluppare exploit zero-day funzionanti su sistemi reali hardenizzati oppure pianificare attacchi end-to-end contro target hardenizzati, secondo la panoramica sulla sicurezza di GPT-6 Astra di OpenAI.
Per chi sviluppa, la valutazione Critical ha tre conseguenze concrete:
- Accesso vincolato a Daybreak Red, oltre a un’approvazione aggiuntiva per il modello
gpt-6-cyber - Controlli obbligatori in produzione: isolamento, limiti sui target, revisione delle azioni e monitoraggio in grado di mettere in pausa Codex, terminare le richieste o revocare l’accesso
- Gestione ZDR più impegnativa: Private Safety Processing con registri di sicurezza cifrati conservati per 30 giorni in uno storage controllato dal cliente, secondo Magica
Per approfondire: recensione dell’API GPT-6 Astra, tutto quello che sappiamo su GPT-6, recap di OpenAI DevDay 2026.
Red e Blue nella Responses API
La confusione tra Daybreak Red e Blue porta spesso a errori di integrazione. La Responses API separa il modello dal programma di accesso, e il valore inviato nella richiesta deve corrispondere al modello, non al tier più alto posseduto dall’organizzazione.
| Modello | Approvazione organizzativa richiesta | Valore da inviare in access_programs.cyber | Cosa succede se è errato |
|---|---|---|---|
gpt-6-sol | Blue o Red | daybreak_blue | daybreak_red restituisce invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (per ridurre i rifiuti) | daybreak_blue | daybreak_red viene rifiutato; con Astra, Blue da solo mantiene le protezioni standard |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | Se omesso, viene selezionato automaticamente Red e la richiesta fallisce senza accesso |
gpt-6-cyber | Red più approvazione aggiuntiva del modello | daybreak_red | La richiesta fallisce senza abilitazione del progetto, IP allowlist e chiave corretta |
Una chiamata minima a GPT-6 Cyber è questa:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
La configurazione di GPT-6 Cyber aggiunge diversi passaggi che i progetti Blue possono saltare (vedi la checklist sotto): un progetto Red abilitato dal proprietario, IP allowlist, SSO/MFA e storage ZDR verificato dove necessario. La risposta riporta il programma applicato in access_programs.cyber; chi usa -latest dovrebbe controllare il campo model risolto, come indica la guida Daybreak API.
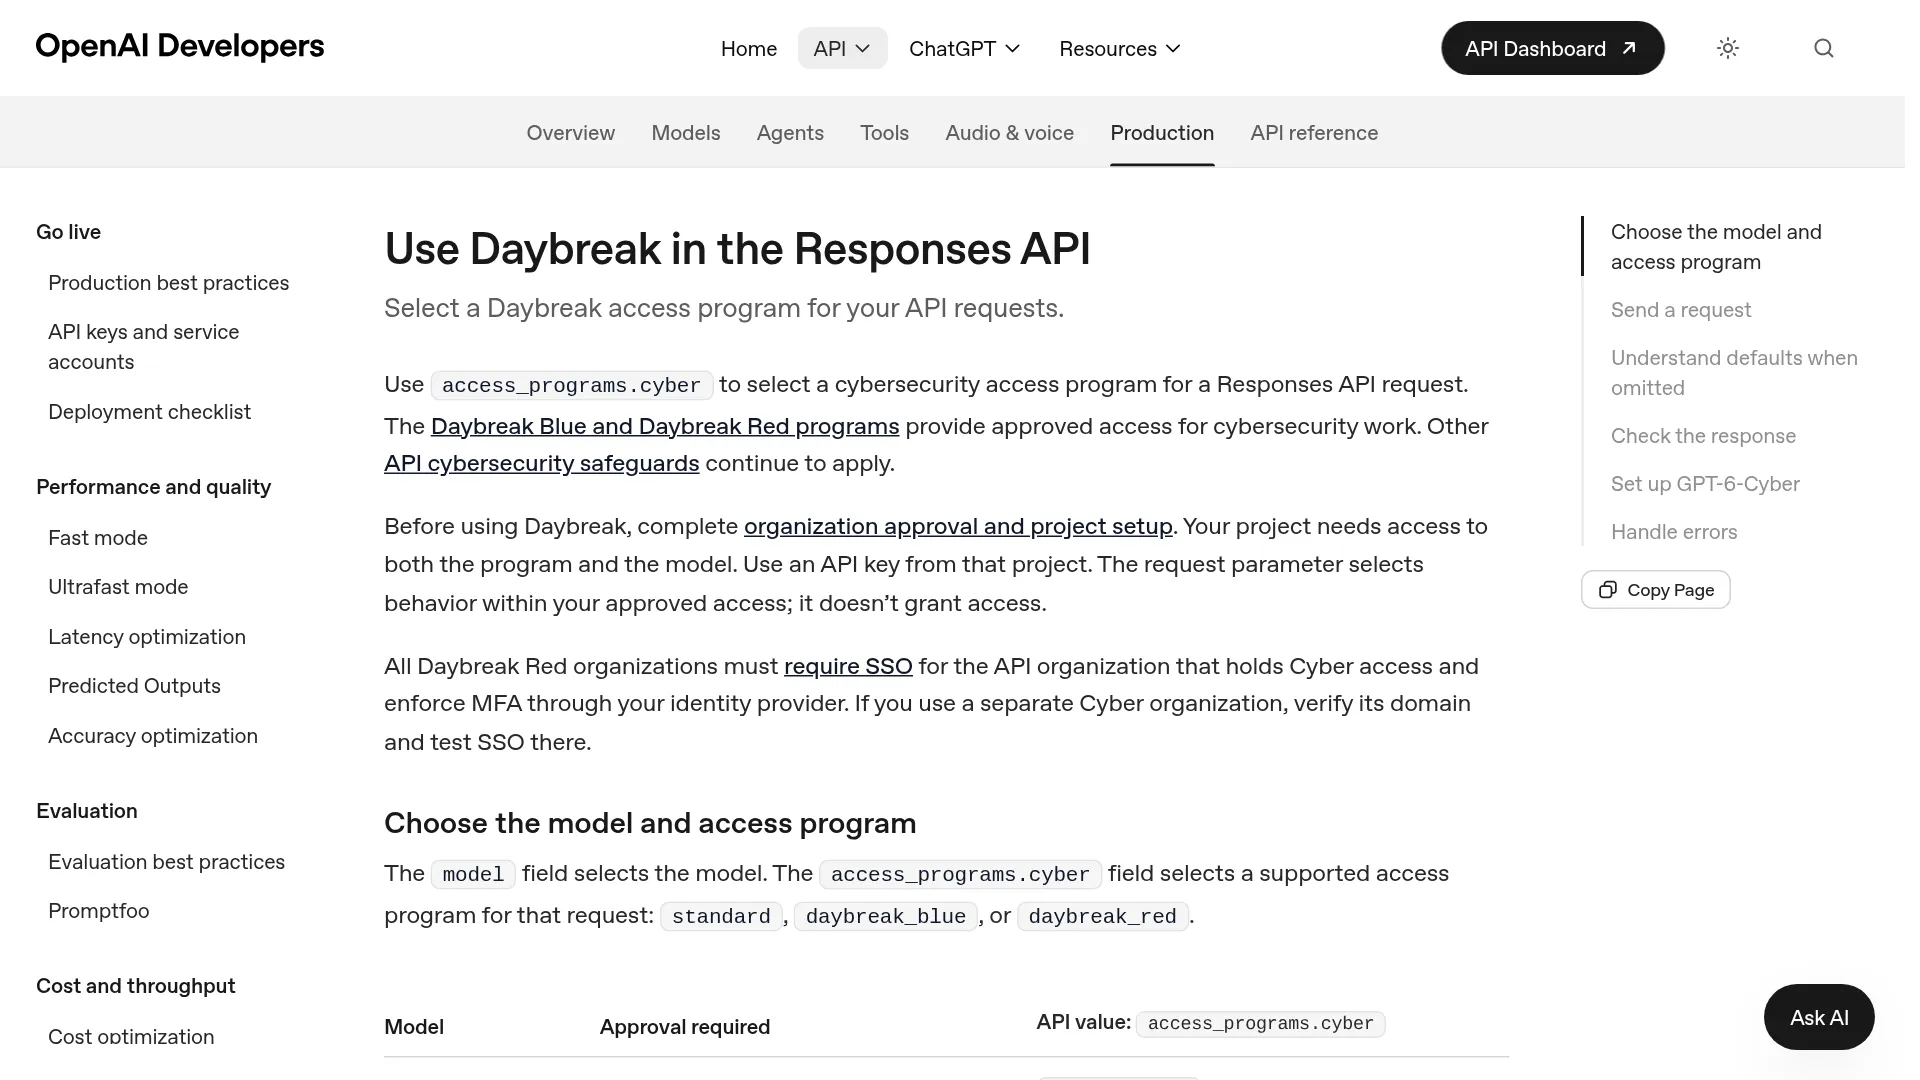
Chi viene qualificato, nella pratica? La panoramica Daybreak di OpenAI parla di clienti enterprise qualificati e professionisti della cybersecurity; Red richiede un’approvazione separata e verifiche più rigorose. Inizialmente GPT-6 Cyber è stato messo a disposizione tramite API e Codex soltanto di un gruppo selezionato di clienti Red approvati. OpenAI ha promesso l’estensione a tutti i clienti Red, ma senza indicare una data, secondo il resoconto del lancio di ArtificialWatch. Al momento della recensione non ho trovato alcun annuncio sulla disponibilità in ChatGPT, e i laboratori indipendenti non avevano ancora testato il modello al lancio perché l’accesso era vincolato, secondo il profilo del modello su BenchLM.
Il passaggio da Blue a Red resta poco trasparente: alcuni pentester raccontano di aver completato la verifica, ottenuto Blue e poi non trovato un percorso chiaro verso Red.
"Recently, both Daybreak Blue and normal codex will refuse to fix memory bugs. It's getting ridiculous." — u/DragonflyOk9274 nel thread di lancio di GPT-6 Cyber su r/codex
Un altro sviluppatore verificato si è imbattuto nell’eccezione di Astra:
"Also found this out when I went and tried to use Astra with the work I've been doing with 5.6 sol the last week or two for it to just give up after a couple of minutes telling me to get daybreak, when I'm already daybreak verified lol." — u/WtWreckor15 su r/OpenAI, nella discussione sulla verifica Daybreak
È esattamente ciò che riportano i documenti: l’approvazione Blue da sola non riduce le protezioni di Astra. Per ottenere meno rifiuti con Astra e gpt-6.1-sol servono progetti abilitati a Red, anche se la richiesta continua a inviare daybreak_blue.
I benchmark da prendere sul serio, e quello in cui vince Astra
Tutti i benchmark di GPT-6 Cyber riportati qui sotto sono stati eseguiti dal provider con il budget di ragionamento più alto testato e pubblicati nella system card di GPT-6 Cyber. Per questo BenchLM mantiene il modello senza ranking: tutte e nove le righe sono dati esatti del provider, senza copertura indipendente negli slot monitorati. Nei benchmark ExploitGym e SEC-Bench, i leader sono Gemini 4 Carbon con il 53.5% e l’88.2%.
| Valutazione | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | Nota |
|---|---|---|---|---|
| ExploitGym (supplied-vuln pass@1) | 48.5% | 42.4% | 32.1% | +16.4 punti rispetto al predecessore, +6.1 rispetto ad Astra |
| ExploitGym Hardened | 36.9% | 29.7% | — | Mitigazioni più robuste |
| SRE-Bench (reverse engineering binario) | 92.8% | 88.0% | — | Non misura attività di site reliability |
| SEC-Bench Pro (motori JavaScript) | 87.0% | 85.4% | — | Vantaggio ridotto |
| ExploitBench Internal Port (V8/Chrome recenti) | 42.0% | 39.0% | — | Target recenti, minore rischio di contaminazione |
| ExploitBench v8-bench | 100% | 100% | — | Parità |
| Recall nel pentest web black-box | 40.3% | 32.0% | — | Precision/F1 non pubblicati |
| RemoteExploitBench (N-day) | 94.7% | 0.0% | — | Astra ha rifiutato ogni attività con Blue |
| Tasso fuori ambito nell’honeypot (più basso è meglio) | 0.07% / 0% con safety prompt | 0.00% | 5.51% | Test dell’ambito, non della sicurezza generale |
Prima di usarli per definire il budget, due righe vanno ridimensionate. RemoteExploitBench misura tanto i permessi quanto le capacità: Cyber ha completato il 95% delle attività N-day in stile GitLab/Postgres, mentre Astra con Blue le ha rifiutate tutte. Quel 0% quindi non misura la capacità latente di Astra nello sviluppo di exploit. L’aderenza all’ambito nell’honeypot è molto buona rispetto al 94.49% di Cyber 5.6, ma riguarda una sola valutazione, non ogni rete dei clienti.
Il set esterno più difficile racconta una storia diversa, secondo i dati della system card di OpenAI riassunti da HandyAI e Kingy. Su Irregular FrontierCyber, che comprende 288 attività reali su software e hardware, Astra ne ha risolte 96 contro le 90 di Cyber; nessuno dei due modelli ha risolto le 15 attività più difficili o un target completamente hardenizzato. Su Irregular CyScenarioBench, dedicato ad attacchi lunghi e multi-step, Cyber è arrivato al 61% contro il 54% di Astra e ha risolto almeno una volta 11 attività su 11, contro 8 su 11 per Astra.
Le prove da campagne reali sono più concrete di qualsiasi singolo punteggio. Secondo il materiale di lancio di OpenAI, riassunto da Axios e Magica, a metà ottobre 2026 una pipeline autonoma ha analizzato circa 2,8 milioni di righe di codice rilevante per la sicurezza del kernel Linux (circa il 7% del kernel), prodotto 2.308 candidati, riprodotto dinamicamente 1.724 casi e, dopo la deduplicazione tramite patch, identificato 948 exploit distinti di escalation locale dei privilegi, per $1,213,430 di crediti API. La stessa pipeline con GPT-5.6 Sol ha prodotto 166 exploit per $513,690. Separatamente, OpenAI ha riferito di aver raccolto prove riproducibili per 81 vulnerabilità Firefox ad alta severità precedentemente sconosciute, oltre a 30 problemi già noti dimostratisi più gravi; Mozilla ha distribuito correzioni per molti di questi casi, secondo Axios e Magica.
Il numero 948 va letto come output della campagna, non come numero di correzioni distribuite, secondo Magica. Nello stesso resoconto si legge che, dopo 10 giorni di analisi, 61 problemi erano già stati corretti upstream, 43 avevano patch in staging, 299 erano oggetto di discussione pubblica e OpenAI aveva divulgato 304 risultati critici con patch candidate. Le prime esecuzioni hanno inoltre evidenziato lacune nella validazione: secondo Magica, 20 dei 200 successi sfruttavano una vulnerabilità sconosciuta diversa da quella assegnata. Sono quindi serviti vincoli più rigidi e un controllo indipendente del difetto previsto. Le patch iniziali, in alcuni casi, bloccavano l’exploit dimostrativo ma non le varianti oppure introducevano costi prestazionali.
Cosa comprano davvero $20/$100
Il prezzo di GPT-6 Cyber, secondo il controllo dei prezzi del 5 novembre di Kingy, è di $20 per milione di token in input, $100 per milione di token in output e $2 per milione di token di input memorizzati nella cache, per richieste standard fino a 272.000 token in input. La scrittura nella cache costa $25 per milione per 30 minuti oppure $50 per milione per 12 ore. Sullo stesso esempio Astra costa la metà, mentre l’input di Cyber costa il 60% in più rispetto ai $12.50 di GPT-5.6 Cyber e l’output circa il 33% in più rispetto ai suoi $75, secondo Kingy.
| Voce di costo | GPT-6 Cyber | GPT-6 Astra | Quando conta |
|---|---|---|---|
| Input / output per 1M | $20 / $100 | $10 / $50 | Ogni analisi multi-turno |
| Input in cache per 1M | $2 | — (vedi pagina di Astra) | Scansioni ripetute sulla stessa codebase |
| Esempio con 100k input + 10k output | $3.00 ($2 + $1) | $1.50 | Base di budget prima dei retry |
| Stesso esempio con input completamente in cache | ~$1.20 + creazione della cache | inferiore | Passaggi su kernel lunghi o monorepo |
| Media della campagna Linux | ~$1,280 per LPE distinta ($1.21M / 948) | — | Media della campagna, non prezzo per vulnerabilità |
La cifra di $1,280 è una ripartizione, non un preventivo. Si riferisce a una specifica combinazione di target e pipeline, include il lavoro sugli information leak, ma esclude sandbox, ingegneria, revisione umana e tempo dei maintainer. Inoltre, più risultati significano più arretrato da analizzare. Le indagini reali moltiplicano turni, chiamate agli strumenti, retry e report lunghi.
Conviene acquistare Cyber quando la validazione di exploit autorizzati o l’audit su larga scala rappresentano il collo di bottiglia e i rifiuti di Astra bloccano il flusso di lavoro. Per code review, triage, stesura delle patch e sviluppo ordinario, meglio Astra o gpt-6-sol. La lettura della system card di HandyAI assegna a Cyber l’82.95% su ExpertSWE contro l’83.24% di Astra: in sostanza, nessun vantaggio nella programmazione generale a fronte del doppio del prezzo.
I limiti che restano anche dopo l’approvazione
Gli utenti verificati con Blue segnalano rifiuti nella correzione di bug di memoria (r/codex), oltre a una discussione su un avviso Cyber Exploitation arrivato in ritardo, in cui l’autore afferma che non era chiaro quale richiesta lo avesse attivato.
Anche i numeri sull’ambito vanno interpretati operativamente. Con il 99.93% di attività in-scope senza il deployment prompt, in quel test 7 esecuzioni su 10.000 toccano un servizio fuori ambito; con il prompt OpenAI riporta il 100% nello stesso test. Chi esegue migliaia di exploit per campagna dovrebbe considerare il prompt, l’isolamento di rete, i target e le credenziali in allowlist e la revisione umana come il vero confine di sicurezza, non il prompt da solo.
La fase di patching resta la metà incompleta del lavoro. La scoperta automatizzata oggi corre più veloce della remediation: trovare 948 exploit non equivale a distribuire 948 correzioni. Revisione dei maintainer, deduplicazione, copertura delle varianti e rollout restano attività legate ai tempi umani.
Questa configurazione aiuta a evitare i ticket più comuni:
- Usa un progetto Red abilitato non predefinito e la relativa chiave
- Imposta il valore
cybercorretto per ogni modello (daybreak_redsoltanto per i modelli cyber) - Verifica IP allowlist e SSO/MFA prima dei test di carico
- Configura ZDR e Private Safety Processing dove richiesto
- In un piccolo pilota isolato, registra modello risolto, ambito, permessi, token, risultati, falsi positivi e blocchi; poi confronta i dati con il processo esistente basato su scanner e revisione umana
Il compromesso è tra scala e capacità di riparazione: nella campagna riportata da OpenAI, la generazione dei risultati ha superato la velocità di revisione delle patch e di integrazione upstream.
FAQ sull’API GPT-6 Cyber
Come posso richiedere l’accesso Daybreak Red per GPT-6 Cyber?
Parti dalla panoramica Daybreak di OpenAI e dal percorso tramite account team, completa la verifica con SSO/MFA, chiedi al proprietario di abilitare Red su un progetto dedicato, ottieni l’approvazione separata per gpt-6-cyber, configura IP allowlisting e gestione ZDR, quindi invia le richieste con daybreak_red.
Ricercatori indipendenti o singoli professionisti possono ottenere Daybreak Red?
OpenAI parla di clienti enterprise qualificati e professionisti della cybersecurity, con un’approvazione separata per Red. Inizialmente l’accesso a Cyber era riservato a un gruppo selezionato di clienti Red; l’estensione più ampia è stata promessa ma non datata. È quindi ragionevole aspettarsi una verifica del caso d’uso documentato. Alcuni pentester riferiscono di aver ottenuto Blue senza trovare un percorso chiaro verso Red.
Daybreak Blue riduce i rifiuti di GPT-6 Astra?
No, non con la normale approvazione Blue. Astra conserva le protezioni standard; per ridurre i rifiuti su Astra e gpt-6.1-sol serve l’approvazione Red con abilitazione del progetto, mentre la richiesta continua a inviare daybreak_blue.
GPT-6 Cyber è disponibile in ChatGPT o soltanto tramite API e Codex?
Al momento della recensione era disponibile soltanto tramite API e Codex per i clienti Red approvati; non era stata annunciata alcuna disponibilità in ChatGPT. Gli utenti generici di ChatGPT dovrebbero usare Astra o i modelli principali con Blue, se idonei.
GPT-6 Cyber vale il doppio del prezzo di Astra?
Per exploitation autorizzata, validazione di vulnerabilità su larga scala ed esecuzioni agentiche sensibili all’ambito, i primi numeri eseguiti dal provider giustificano un progetto pilota: +6 punti su ExploitGym, +7 sui target hardenizzati, 94.7% di completamento delle attività N-day con i permessi Red e 99.93% di aderenza all’ambito. Per code review, triage e sviluppo generale, Astra a metà prezzo resta la scelta predefinita migliore.
Che cosa devo registrare per contestare un avviso o un rifiuto cyber?
Conserva l’ID del modello risolto, il valore del programma nella richiesta, l’ID del progetto, il timestamp, l’ambito del target e le credenziali, il prompt completo e la traccia degli strumenti, indicando anche se è stato usato il deployment safety prompt; poi contatta l’assistenza. La documentazione pubblica non spiega come gli avvisi ritardati vengano associati a una richiesta specifica, quindi i log locali sono il principale registro di audit.