 AIREITER
Sulla carta, LongCat 2.5 costa appena $0,30 per milione di token in input: un prezzo difficile da ignorare. Ma è una promo a tempo limitato senza una data di scadenza dichiarata, e chi ha provato la preview segnala loop che possono trasformare token economici in tentativi costosi. Prima di spostare un carico in produzione farei quindi un test circoscritto, con molto riuso della cache, misurando il costo per risultato effettivamente accettato.
La release definitiva chiarisce il prezzo, non l'affidabilità
LongCat 2.5 è stato rilasciato ufficialmente. Meituan ha pubblicato il blog di LongCat-2.5 il 1 novembre 2026 e ha attivato LongCat-2.5 sulla piattaforma API il 2 novembre 2026, con endpoint OpenAI Chat Completions, OpenAI Responses e Anthropic Messages.
Il dubbio sull'affidabilità, però, resta. I test della preview in OpenCode sono stati abbastanza problematici da lasciare agli acquirenti enterprise una domanda concreta: il rilascio del 2 novembre ha corretto i loop e le modifiche distruttive? Le evidenze pubbliche non permettono ancora di dirlo. Quasi tutte le segnalazioni dettagliate riguardano LongCat-2.5-Preview, tra fine settembre e ottobre, e al 3 novembre nessun laboratorio indipendente aveva ripetuto i test sul checkpoint di produzione.
"Ho testato LongCat 2.5: solido sulla carta, ma nei miei test è emersa una vera crepa." — @prompt48, dopo un test HTML con un albero di Natale in cui gli addobbi finivano sparsi fuori dall'albero nella pagina chat gratuita.
Il commento rispecchia quanto emerso su Reddit. Gli utenti reali di OpenCode descrivono un problema diverso nelle esecuzioni agentiche, non nelle demo in chat:
"L'ho usato per configurare una VM e continuava a entrare in loop eseguendo semplici comandi ls in più occasioni." — u/Such_Competition8263 su r/opencode
"Ha modificato codice completamente scollegato dal task, nel modo più casuale possibile." — u/Avernite nella stessa discussione.
Cosa si acquista davvero: solo API, pesi ancora Coming soon
LongCat 2.5 è accessibile solo via API: niente pesi scaricabili per questo enorme modello mixture-of-experts. Conta 1,6 trilioni di parametri totali, con circa 48 miliardi attivi per token; accetta input testuali, immagini e video, ma genera soltanto testo. La finestra di contesto arriva a 1.048.576 token, con un massimo di 262.144 token in output. In breve: contesto enorme, output testuale.
La multimodalità è nativa, non un'aggiunta esterna. Le immagini vengono convertite in token discreti nella stessa sequenza del testo: fino a 100 immagini per richiesta, da 10 MB ciascuna, nei formati PNG, JPG, JPEG, WebP o GIF. Sono supportati anche fino a 10 video tramite URL pubblico, da 100 MB e sotto i 3.600 secondi ciascuno. Il budget di ragionamento è limitato a 262.144 token e viene restituito come reasoning_content; la temperatura è bloccata a 1.0 con il thinking attivo e a 0.7 quando è disattivato.
Da Preview del 25 settembre alla produzione del 2 novembre: le differenze
La distinzione tra LongCat-2.5-Preview e LongCat-2.5 spiega gran parte dei risultati di ricerca più confusi. LongCat-2.5-Preview è arrivato il 25 settembre 2026 con contesto da 1M e comprensione delle immagini. La versione di produzione, distribuita tra l'1 e il 2 novembre, aggiunge l'input video, l'addestramento Trajectory2Task+ basato su esecuzioni agentiche fallite e il serving W4A4 a 4 bit, per il quale viene dichiarato un throughput di prefill superiore del 43,3% rispetto agli 8 bit.
I pesi non hanno seguito il lancio del modello. Dopo la release, i pulsanti su GitHub e Hugging Face riportano ancora "Coming soon", mentre LongCat-2.0 resta il più grande modello LongCat scaricabile con licenza MIT. Con 1,6T di parametri complessivi, l'hosting autonomo non è una prospettiva immediata per la maggior parte dei team.
Quanto costano davvero le API LongCat 2.5 a $0,30 per milione
La tariffazione promozionale di LongCat 2.5 prevede tre prezzi, bilanciati da un output relativamente costoso.
| Tipo di token | Tariffa promo per 1M | Moltiplicatore |
|---|---|---|
| Input non in cache | $0,30 | 1x |
| Input in cache | $0,006 | 0,02x |
| Output | $1,20 | 4x l'input, 200x la cache |
La formula di fatturazione è (input non in cache x 0.30 + input in cache x 0.006 + output x 1.20) / 1,000,000. I token di ragionamento rientrano nell'output e non sono addebitati separatamente. Con 1 milione di token in input e un cache hit dell'80%, il costo dell'input scende da $0,30 a $0,0648. Il risparmio sull'input è del 78,4%, non del 98%: lo sconto del 98% vale infatti solo per i token che arrivano effettivamente dalla cache.
Due esempi alle tariffe promo mostrano perché l'output pesa così tanto. Un riepilogo con 20.000 token in input e 2.000 in output costa $0,0084, ossia $8,40 ogni mille richieste. Una richiesta agentica con contesto ripetuto, 200.000 token non in cache, 800.000 in cache e 40.000 in output, costa $0,1128, ovvero $112,80 ogni mille richieste.
Retry dovuti a tool falliti, risposte troppo lunghe e HTTP 200 inutilizzabili ma comunque fatturabili fanno salire la spesa. La metrica utile è il costo per risultato accettato: costo totale fatturato su tutti i tentativi diviso per i risultati accettati.
La promo non ha una scadenza: come pianificare oltre lo sconto
Il limite del pricing promozionale di LongCat 2.5 è temporale, non tecnico. Meituan definisce $0,30/$1,20/$0,006 prezzi a tempo limitato, senza comunicare né una data di fine né un listino ordinario. Inoltre si riserva il diritto di modificare le tariffe, facendo fede i record di fatturazione della piattaforma.
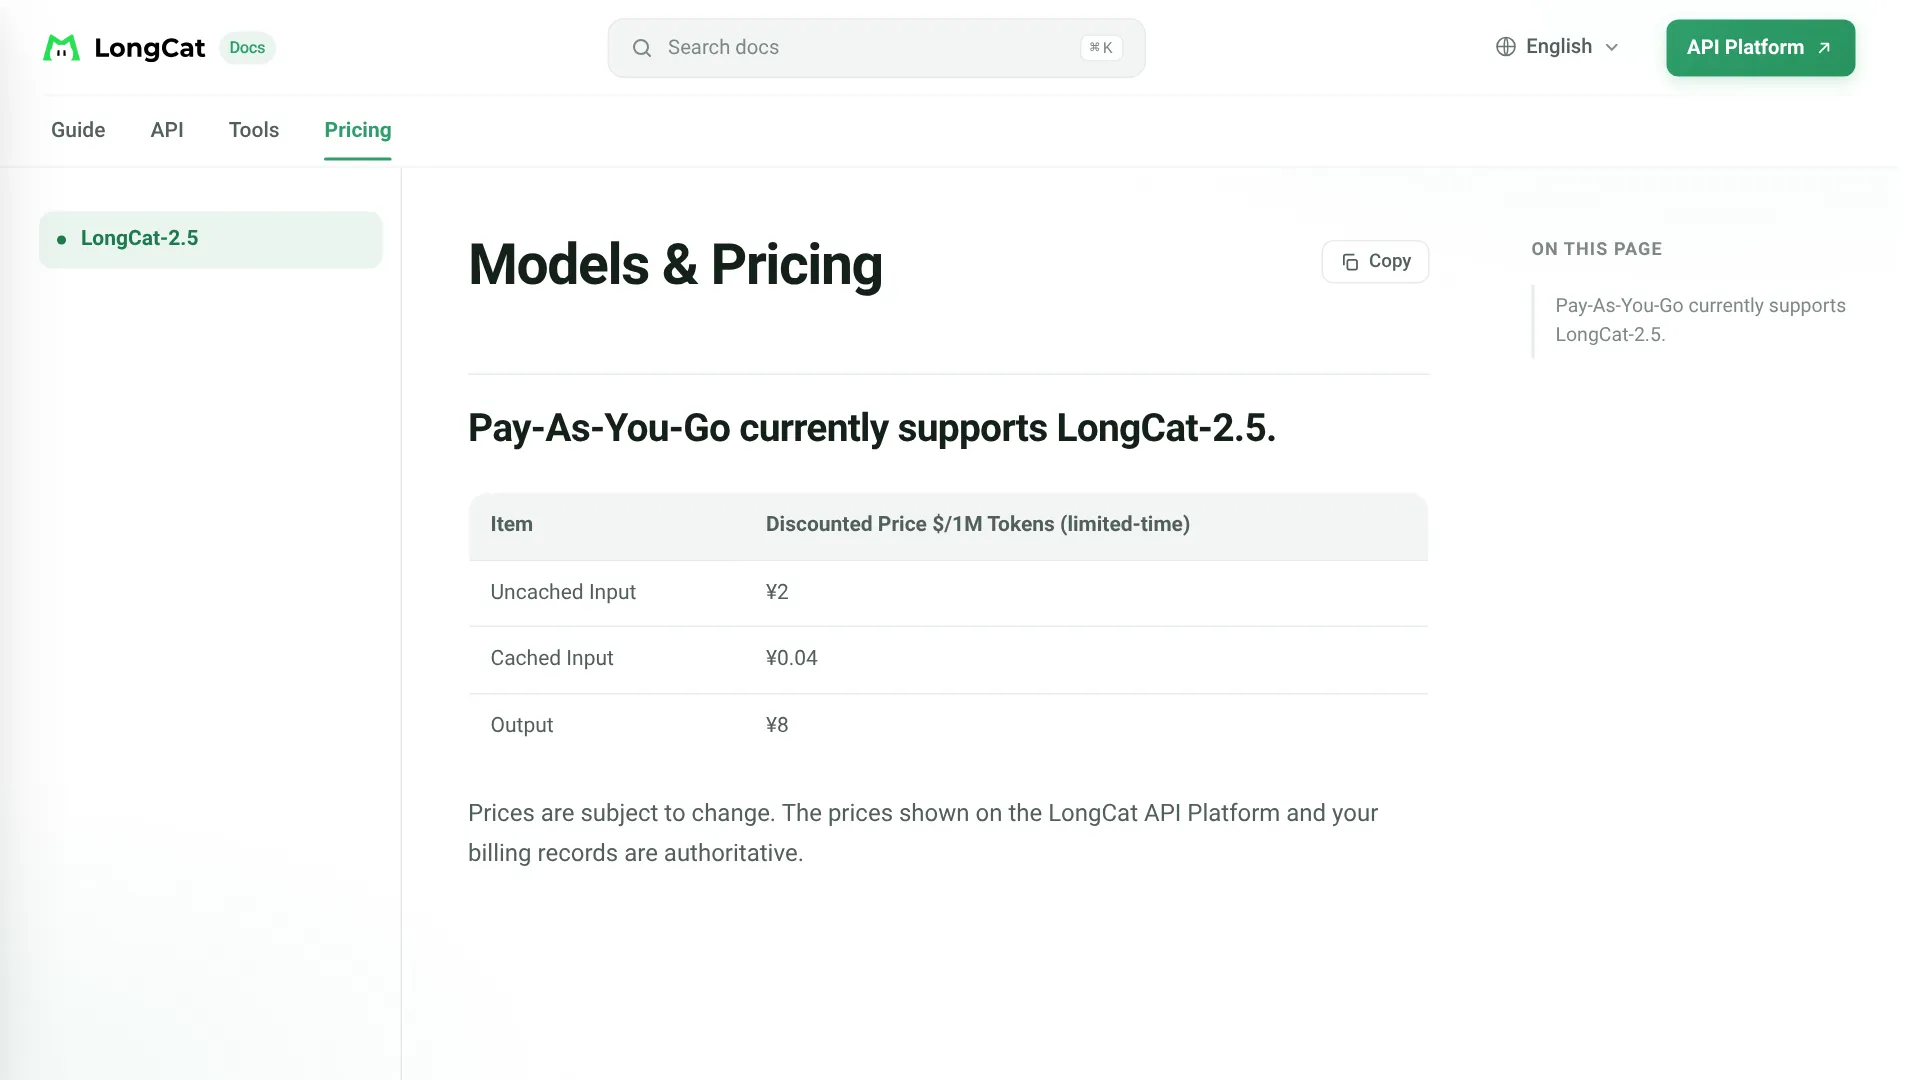
Gli indizi suggeriscono un possibile aumento rilevante. ZenMux indicava per la Preview, prima dello sconto, $0,75 per l'input e $2,95 per l'output; Artificial Analysis riportava gli stessi $0,75/$2,95 per LongCat-2.0. Si tratta di circa 2,5 volte le tariffe promo, il che implica che la promo rappresenti approssimativamente il 40% di un potenziale prezzo standard. La pagina cinese dei prezzi di Meituan, verificata da Hokai il 3 novembre, riporta CNY 2 per l'input non in cache, CNY 0,04 per la cache e CNY 8 per l'output, sempre per milione di token.
Token Pack e livelli enterprise
| Spesa mensile | Sconto enterprise |
|---|---|
| $75+ | 10% |
| $300+ | 20% |
| $1.200+ | 30% |
| $6.000+ | 40% |
- Token Pack: quota fissa, validità di 30 giorni, finestre flash sale; la quota viene consumata per prima, i cache hit sono gratuiti, mentre cache miss e output scalano la quota. L'importo inutilizzato viene rimborsato automaticamente.
- Pay-as-you-go: il saldo non scade; sono supportati carta e Google Pay; gli errori 401/403/429/500 non vengono fatturati.
- Livelli enterprise: si azzerano ogni mese ed escludono utilizzo dei Token Pack e crediti promozionali.
Provider a confronto: tariffe identiche, rischi diversi
Il confronto fra i provider di LongCat 2.5 sembra lineare finché non entrano in gioco qualità del servizio e condizioni contrattuali.
| Canale | Input / 1M | Cache / 1M | Output / 1M |
|---|---|---|---|
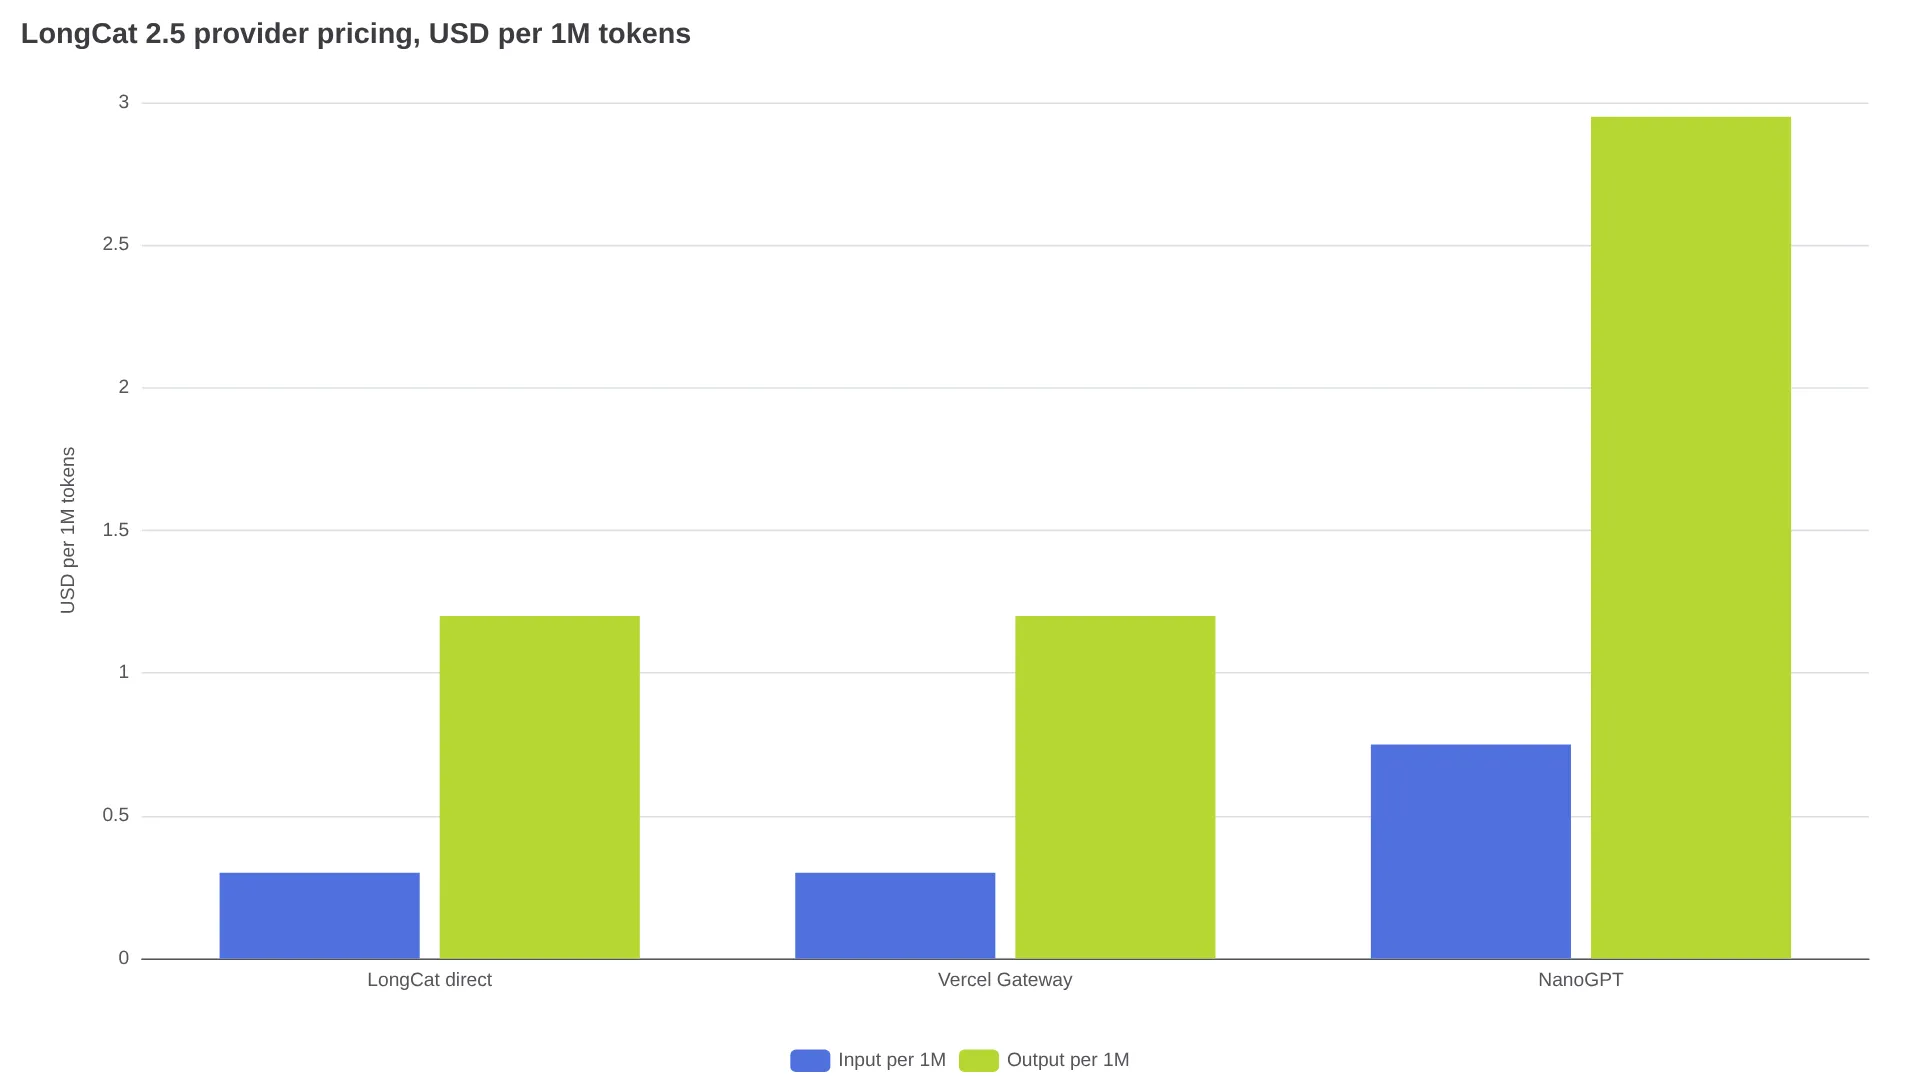
| LongCat diretto | $0,30 | $0,006 | $1,20 |
| Vercel AI Gateway | $0,30 | $0,006 | $1,20 |
| NanoGPT | $0,75 | $0,015 | $2,95 |
L'API ufficiale LongCat è il percorso diretto, con report della cache e accesso ai Token Pack. Vercel aggiunge crediti gateway, routing, limiti e condizioni del provider, pur mantenendo le stesse tariffe per token. La finestra gratuita della Preview su OpenCode era invece una promo del client separata, non la prova che l'API di prima parte sia gratuita.
I calcoli blended favoriscono chi usa intensamente la cache, ma solo finché i dati reali lo confermano. TokenPricing, con rapporto input-output di 3:1 e metà dell'input in cache, arriva a $0,4147 per milione. Hokai, con lo stesso rapporto 3:1 ma senza cache, calcola $0,525 e colloca LongCat-2.5 al 27° posto su 94 concorrenti, contro una mediana di $1,63. Entrambe le stime saltano se il tuo harness rileva pochi cache hit o produce tracce di ragionamento lunghe.
Prima di scegliere un canale, verifica tre aspetti. Controlla che il model ID sia LongCat-2.5 e non un alias preview. Verifica che i cache hit compaiano nei payload di utilizzo. Infine, assicurati che termini sui dati, limiti di output e policy di retry coincidano con la documentazione API ufficiale di LongCat.
Benchmark gestiti dal vendor: come interpretarli
Per valutare i benchmark di LongCat 2.5 bisogna tenere conto della fonte. Tutti i punteggi di LongCat-2.5 nella tabella Meituan sono generati dal vendor. Alcuni risultati dei concorrenti provengono da report pubblici, altri sono stati rieseguiti da Meituan e hanno valore soltanto indicativo. Al 3 novembre, né Artificial Analysis né OpenRouter includevano LongCat-2.5.
| Benchmark | LongCat-2.5 | Miglior concorrente citato |
|---|---|---|
| Terminal-Bench 2.1 | 88,4 | 90,6 DeepSeek V4.1 Flash |
| Terminal-Bench 4.0 | 38,5 | 53,9 Opus 5 |
| DeepSWE 1.1 | 64,6 | 74,2 DeepSeek Flash |
| NL2Repo | 60,5 | 75,3 Opus 5 |
| BrowseComp | 91,9 | 91,5 DeepSeek Flash |
| VideoMME | 85,2 | 90,0 Kimi K3 |
Il quadro è di quasi parità sulla versione precedente di Terminal-Bench e su BrowseComp, con distacchi evidenti nelle suite più profonde per terminale, repository e sviluppo software. Nel confronto mancano inoltre concorrenti più recenti come Kimi K3.1 Pro, GPT-6 Astra e Claude Opus 5.5.
Le condizioni da non trascurare: riuso dati, temperatura fissa, nessun SLA
Per capire se LongCat 2.5 è adatto al codice aziendale, termini sui dati e operatività contano più dei benchmark. Salvo modifiche previste da un contratto enterprise o da un accordo scritto separato, le condizioni API concedono a LongCat una licenza gratuita e mondiale per usare input, output e feedback nell'ottimizzazione del servizio, nella promozione del brand e nel marketing. I server API possono trovarsi a Francoforte, Hong Kong e nella Cina continentale; si applicano il diritto di Singapore e l'arbitrato SIAC.
- Campionamento fisso: niente riproducibilità a bassa temperatura; input audio e generazione di immagini non sono disponibili.
- Nessuna garanzia operativa pubblicata: non sono indicati né un periodo di retention né un SLA; per l'hosting autonomo bisogna attendere un rilascio dei pesi senza data.
- Fatturazione degli errori: autenticazione fallita, rate limit ed errori server non sono fatturati; le risposte riuscite ma inutili, invece, sì.
"Devo dire che la finestra di contesto da 1m token è davvero fantastica. Sto lavorando con LongCat2.5: con quel contesto è sicuramente un buon cacciatore di bug." — @alexokita
L'uso più prudente della finestra da 1M è proprio questo: correzioni mirate di errori con un codice d'errore chiaro e revisione umana, non refactoring non supervisionati.
Ha senso chiamare LongCat 2.5 dal tuo agent?
La scelta di LongCat 2.5 dipende essenzialmente da quanta supervisione puoi accettare e dal livello di riservatezza richiesto. Il modello è adatto a utenti Claude Code, Codex o OpenCode attenti ai costi, che eseguono agenti lunghi con molta cache, lavori frontend screenshot-to-code e ricerca browse-plus-build, dove l'input visivo evita un passaggio descrittivo.
| Usa LongCat 2.5 quando | Cerca altrove quando |
|---|---|
| Il contesto ampio e ripetuto produce molti cache hit | Il codice è regolamentato o altamente riservato e non hai termini enterprise |
| Il task è una correzione circoscritta con un codice d'errore chiaro | Il task è un refactoring autonomo su più file |
| Puoi revisionare le diff e misurare il costo per risultato accettato | Ti servono temperatura bassa fissa, SLA o self-hosting immediato |
Il compromesso irrisolto resta quello tra promozione e prove sul campo. A $0,30/$1,20 con cache a $0,006, LongCat-2.5 costa circa 16 volte meno di Claude Opus, quotato $5/$25, sul solo input. Nella stessa tabella Meituan, però, Opus 5 continua a primeggiare nelle suite più difficili per terminale e repository. Esegui un test misurato sul tuo harness, confronta il costo per risultato accettato con DeepSeek V4.1 Flash e i runner economici della classe GLM, poi valuta se lo sconto compensi davvero il costo della supervisione.
Approfondimenti correlati: recensione di DeepSeek V4.1 Flash 1017 per il coding, benchmark e prezzi di GLM 5.3, guida ai prezzi API di Kimi K3.1 Pro.
FAQ sui prezzi delle API LongCat 2.5
Quanto costa l'API LongCat 2.5?
L'API LongCat 2.5 costa, in promozione, $0,30 per milione di token input non in cache, $0,006 per milione di token in cache e $1,20 per milione di token in output. L'output costa 4 volte l'input non in cache, quindi tracce di ragionamento lunghe incidono maggiormente sulla fattura.
La tariffa di $0,30 è permanente?
No. Meituan descrive il prezzo di LongCat 2.5 come temporaneo, senza una data di fine o un listino standard. Per il budget, considera $0,75/$2,95, il riferimento dell'era Preview, come possibile scenario di aumento.
LongCat 2.5 è open source o disponibile solo via API?
All'inizio di novembre 2026 LongCat 2.5 è disponibile soltanto via API. GitHub e Hugging Face mostrano "Coming soon", senza data o licenza, mentre LongCat-2.0 resta l'opzione MIT scaricabile.
LongCat 2.5 può essere usato in Claude Code e OpenCode?
Sì. LongCat 2.5 supporta OpenAI Chat Completions, OpenAI Responses e Anthropic Messages con il model ID LongCat-2.5. Imposta base URL e nome del modello sul servizio LongCat diretto o su un gateway, quindi verifica il report della cache sul percorso scelto.
LongCat 2.5 è sicuro per il codice aziendale?
La sicurezza per il codice aziendale dipende dai termini contrattuali, non dai benchmark. Le condizioni API standard consentono il riuso di input e output per ottimizzazione e marketing: per lavori regolamentati o riservati serve quindi un accordo enterprise con esclusioni esplicite sull'uso dei dati.
LongCat 2.5 in produzione è diverso dalla Preview?
Sì. La Preview è arrivata il 25 settembre con comprensione delle immagini, mentre la produzione è stata distribuita tra l'1 e il 2 novembre con input video e comportamento agentico riaddestrato. Le segnalazioni pubbliche di problemi riguardano soprattutto la Preview, quindi l'affidabilità della versione di produzione deve ancora essere verificata da test indipendenti.