 AIREITER
Sulla carta, Kimi K3.1 Pro di Moonshot è un modello molto competitivo per coding e agenti: offre 1 milione di token di contesto e costa $2 per milione di token in input e $10 per milione in output. Nei carichi di lavoro della settimana di lancio riportati qui sotto, l'API a consumo si è rivelata molto più conveniente dell'abbonamento da $39.
Cos'è davvero Kimi K3.1 Pro
Kimi K3.1 Pro è il primo modello della serie K3.1 di Moonshot AI, pubblicato il 23 ottobre 2026 come successore post-addestramento di Kimi K3. Moonshot lo presenta come un mixture-of-experts di classe 3T, pensato per coding a lunga autonomia, workflow con strumenti 3D e CAD, analisi di documenti finanziari e agenti multi-step.
La finestra di contesto è di 1.048.576 token complessivi: input, token di ragionamento e output condividono lo stesso spazio. Non si tratta quindi di 1M in input più un ulteriore 1M in output. Attraverso i prodotti Moonshot, gli input possono includere testo, immagini e video; l'API restituisce testo, codice e chiamate a strumenti, mentre l'artefatto visivo viene generato dal software esterno, ad esempio Blender, game engine o strumenti PDF. Il ragionamento è sempre attivo: reasoning_effort prevede i livelli low, high e max, con max impostato come predefinito.
Moonshot aveva promesso i pesi aperti entro il 4 novembre, ma il controllo di TheQuery del 24 ottobre non aveva verificato la disponibilità di un checkpoint scaricabile né della licenza definitiva. Anche ArtificialWatch indicava la licenza come sconosciuta. Fino alla pubblicazione di checkpoint e licenza, conviene pianificare l'uso tramite API ospitata.
Prezzi API: Standard e Highspeed a confronto
Sulla piattaforma API Kimi, Kimi K3.1 Pro Standard costa $2 per milione di token input non in cache e $10 per milione di token output. Kimi K3.1 Pro Highspeed raddoppia le tariffe a consumo, arrivando a $4 per l'input e $20 per l'output, ma mantiene a $0.20 la lettura di input dalla cache. La stessa distinzione $2/$10 e $4/$20 è riportata da ArtificialWatch e nella tabella prezzi di AI/ML API.
| Operazione (per 1M di token) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Input non in cache | $2.00 | $4.00 |
| Output, ragionamento incluso | $10.00 | $20.00 |
| Lettura input dalla cache | $0.20 | $0.20 |
| Scrittura cache, durata 5 minuti | $2.00 | $4.00 |
| Scrittura cache, durata 1 ora | $4.00 | $8.00 |
Tre aspetti della fatturazione contano più del prezzo di listino. Primo: la tariffa non cambia con la lunghezza del contesto e la durata predefinita della cache è di cinque minuti. Riutilizzando un prefisso del prompt entro quella finestra, si pagano $0.20 anziché $2.00. Secondo: i token di ragionamento vengono fatturati alla tariffa di output; con effort max, una lunga traccia di un agente può quindi incidere più di ogni altra voce. Terzo: i costi API sono separati da membership Kimi e abbonamenti Kimi Code. Inoltre, il controllo di TheQuery sulla guida Batch API non trovava K3.1 Pro nell'elenco: non date per scontato che si applichi uno sconto batch.
Con queste tariffe, un esempio a token fissi resta economico: 100.000 token input non in cache ($0.20) più 10.000 token output ($0.10) fanno $0.30, prima di scritture in cache, strumenti, tentativi ripetuti e imposte.
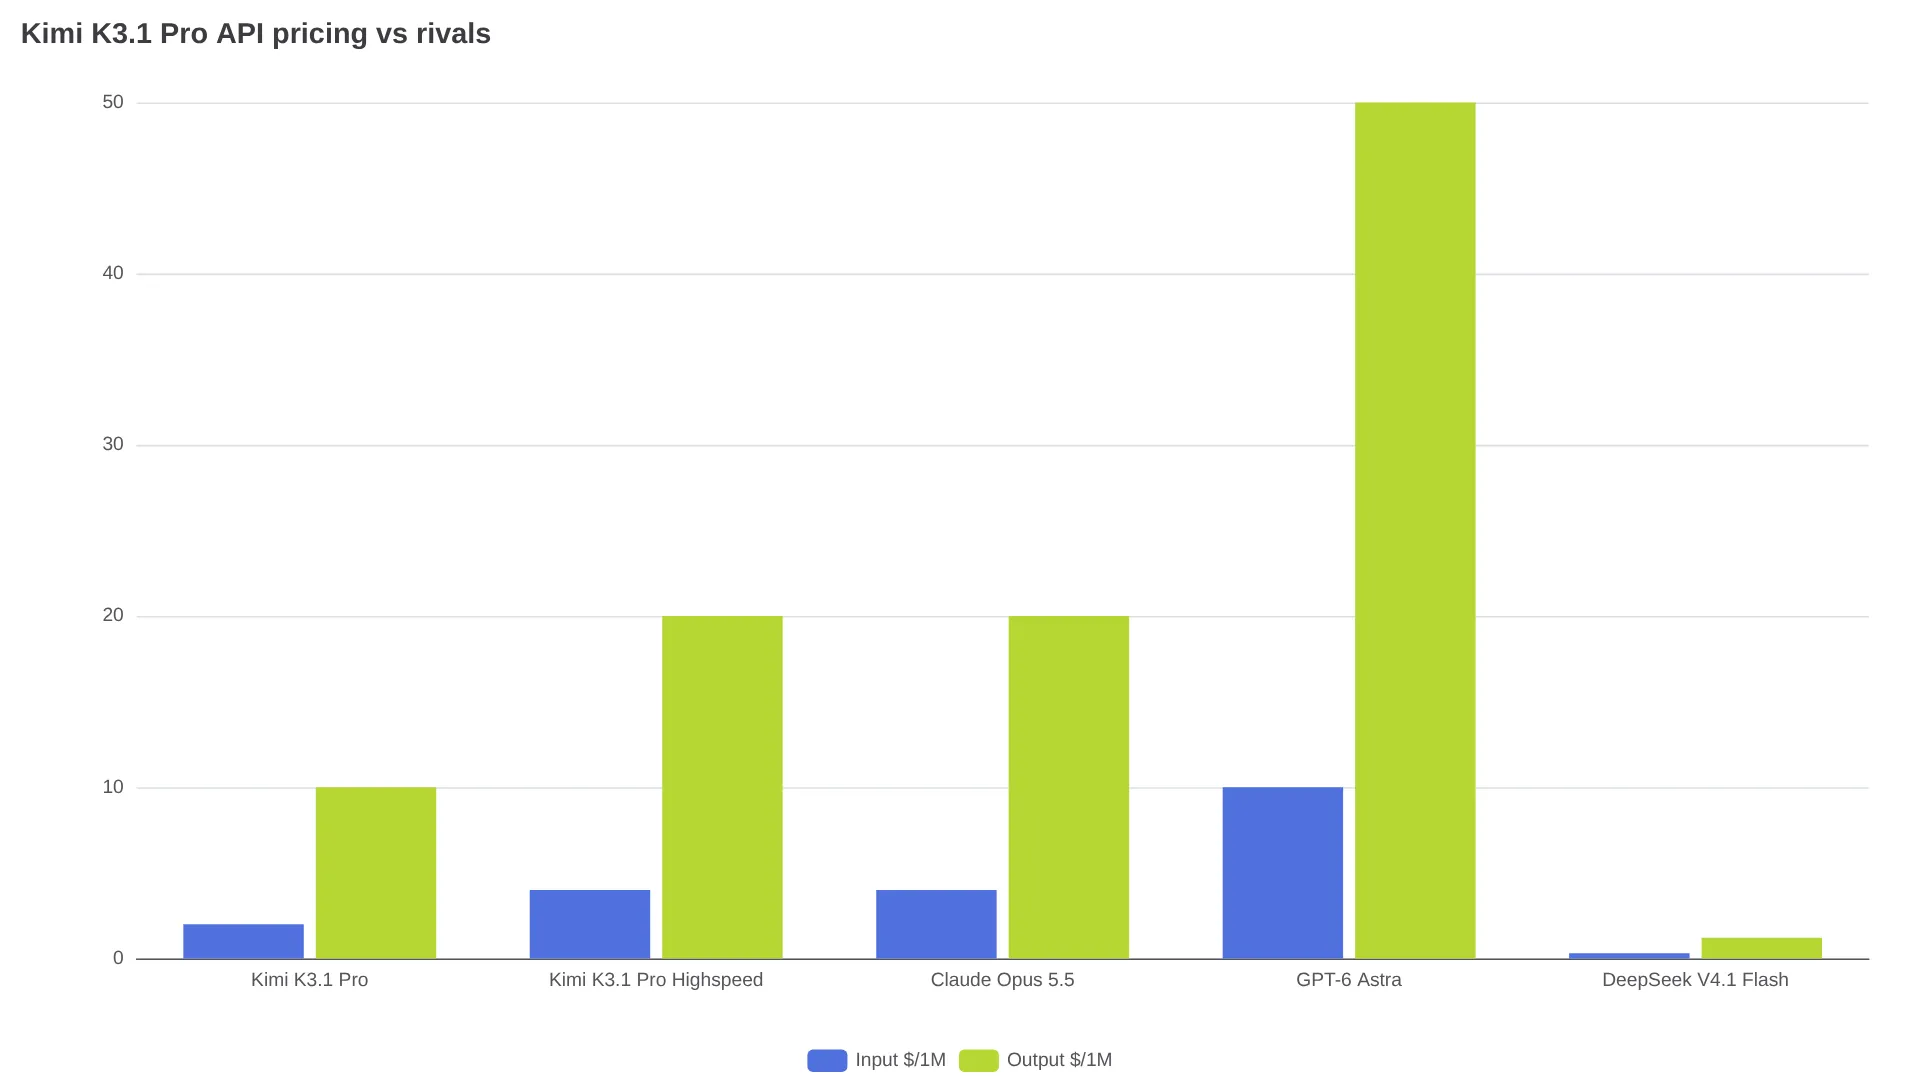
Rispetto ai rivali, K3.1 Pro Standard costa il 33% in meno di Kimi K3 ($3/$15), la metà di Claude Opus 5.5 ($4/$20) e un quinto di GPT-6 Astra ($10/$50), secondo il confronto di ArtificialWatch. DeepSeek V4.1 Flash batte tutti i modelli elencati sul solo prezzo, a $0.30/$1.20 secondo la tabella prezzi di AI/ML API, ma nei benchmark della prossima sezione resta molto indietro. Highspeed costa esattamente quanto Opus 5.5: ha senso soltanto quando l'accelerazione dichiarata di 2-3x riduce abbastanza un'attività vincolata dalla latenza da compensare il raddoppio del costo per token.
Perché l'abbonamento da $39 si esaurisce, mentre l'API no
Al lancio, il prezzo dell'API appariva ragionevole; quello dell'abbonamento, molto meno. Diversi utenti paganti hanno segnalato l'esaurimento della quota di 5 ore dopo uno o due prompt, o il consumo della quota mensile con un singolo lavoro di coding.
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech, consumo della quota segnalato dall'utente
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab, abbonato al piano da $39
Un utente ha riferito di aver speso $400 in abbonamenti per quattro prompt, stimando lo stesso lavoro in $29 via API; un altro ha raccontato di una singola attività di animazione che ha consumato gran parte della quota di 5 ore. Per gli sviluppatori la conclusione è semplice: K3.1 Pro va valutato tramite API pay-as-you-go — Moonshot, OpenRouter o Vercel AI Gateway — dove 100k token input più 10k token output costano $0.30 prima di retry e strumenti, non attraverso una quota in abbonamento che misura lo stesso ragionamento in modo molto più restrittivo.
Benchmark: numeri da leggere con le dovute cautele
Tutti i punteggi principali qui sotto sono dichiarati da Moonshot, salvo diversa indicazione, e sono stati ottenuti con ragionamento massimo, temperatura 1.0 e top-p 0.95. Le differenze minime dipendono dalla configurazione: i punteggi dei rivali arrivano infatti da harness diversi — Kimi Code per Kimi, Claude Code per gli altri e Codex per GPT-6 Astra su OfficeQA — come documenta AI/ML API.
| Valutazione | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi guida in tre test su cinque e perde Terminal-Bench per 0.7 punti: uno scarto che TheQuery osserva essere inferiore all'errore standard di 2.6 punti riportato da Anthropic per Opus. Il 92.7% di BenchCAD rappresenta la sovrapposizione voxel su un sottoinsieme open-model di 1.000 casi; i risultati di Claude provengono invece dalla system card e non da una nuova esecuzione uniforme, secondo le note metodologiche di AI/ML API.
Sul fronte della correttezza fattuale, il Kimi Hallu Bench interno di Moonshot riporta per K3.1 Pro un errore per affermazione del 5.4% nel set standard, contro il 4.2% di GPT-6 Astra, e dell'8.3% contro il 5.5% nel set Hard with-tools, secondo la tabella Hallu di AI/ML API. Rispetto al 23.4% di K3 nel test hard, è una riduzione relativa del 65%, ma Astra resta davanti in entrambi i set. Per i casi in cui una sola affermazione errata compromette l'intero output, Astra va quindi mantenuto nella shortlist. Si tratta comunque di stress test avversariali, non di probabilità di errore nell'uso quotidiano.
L'unico dato indipendente disponibile al lancio arrivava da Artificial Analysis, che ha assegnato a K3.1 Pro un punteggio di 55 nel proprio Intelligence Index e lo ha classificato al quarto posto assoluto, dietro Claude Opus 5.5, Sonnet 5.5 e Muse Wonder Full. Un posizionamento che sostiene l'idea di un modello vicino alla frontiera a metà prezzo, senza basarsi esclusivamente sui test del fornitore.
Come chiamare l'API senza spendere più del necessario
Kimi K3.1 Pro è compatibile con OpenAI: per migrare basta modificare base URL e ID del modello. L'endpoint ufficiale è https://api.moonshot.ai/v1, con gli ID kimi-k3.1-pro e kimi-k3.1-pro-highspeed, secondo il controllo endpoint di TheQuery e la guida di configurazione AI/ML API. I gateway di terze parti adottano ID con namespace, come moonshot/kimi-k3.1-pro su Requesty o moonshotai/kimi-k3.1-pro su Vercel.
Il quickstart fissa temperatura 1.0 e top-p 0.95 e consiglia di ometterli invece di modificarli, secondo le note di TheQuery sul comportamento dell'API. Per controllare i costi, agite invece su reasoning_effort: iniziate con low per le prove, passate a high se il task fallisce e riservate max, che è il valore predefinito, all'esecuzione finale. Un budget di max_completion_tokens pari a 8.192 token può produrre una risposta visibile molto più breve, perché il ragionamento nascosto consuma lo stesso budget alla tariffa di $10 per milione.
Checklist per contenere i costi, secondo le indicazioni di AI/ML API su tool use e token:
- Conservate l'intero messaggio dell'assistente tra un passaggio di strumenti e l'altro, incluso
reasoning_contentdurante lo streaming, e restituite i risultati degli strumenti prima della chiamata successiva. - Riutilizzate i prefissi dei prompt entro la finestra cache di 5 minuti per portare l'input ripetuto a $0.20 per milione.
- Misurate il costo per risultato accettato, non il costo per token.
- Un modello meno caro per token che richiede due tentativi non è davvero più economico.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Una ricarica di $1 abilita l'accesso, soggetto a limiti di velocità per livello, mentre l'accesso enterprise è disattivato per impostazione predefinita finché un amministratore non lo abilita, secondo il controllo di TheQuery sul comportamento dell'API. Sul piano della privacy, l'audit di Opper sul percorso Moonshot riporta che i contenuti vengono conservati e che i dati dei clienti vengono usati per l'addestramento per impostazione predefinita, senza opzione zero-data-retention su questo percorso. Non inviate dati riservati o regolamentati senza adeguate garanzie contrattuali.
Conviene usarlo? Il compromesso da mettere in conto
| Se vi serve | Scegliete | Perché |
|---|---|---|
| Run di coding di classe frontier al costo più basso | Kimi K3.1 Pro API | Guida SWE-Marathon a metà del prezzo di Opus, con 1M di contesto condiviso |
| Latenza minima | Kimi K3.1 Pro Highspeed | Accelerazione dichiarata di 2-3x, ma costo per token esattamente doppio |
| Meno errori fattuali | GPT-6 Astra | 4.2% contro 5.4% nel test Hallu standard, a 5x il prezzo |
| Token più economici, punteggi inferiori | DeepSeek V4.1 Flash | $0.30/$1.20, ma ultimo in quattro dei cinque benchmark elencati |
| Self-hosting | Attendere | Pesi promessi entro il 4 novembre, con licenza sconosciuta |
Se Moonshot pubblicherà i pesi completi con una licenza permissiva entro il 4 novembre, il self-hosting potrebbe cambiare il calcolo tra quote e API. Gli sviluppatori che confrontano modelli per coding a contesto lungo dovrebbero inoltre consultare la guida ai migliori LLM per coding agent nel 2026 prima di scegliere.
FAQ sull'API Kimi K3.1 Pro
Quanto costa l'API Kimi K3.1 Pro?
Kimi K3.1 Pro Standard costa $2 per milione di token input non in cache e $10 per milione di token output; le letture di input dalla cache costano $0.20 per milione. Highspeed raddoppia le tariffe di input, output e scrittura cache, mantenendo invariato a $0.20 il prezzo della lettura dalla cache.
Qual è la differenza tra K3.1 Pro e Highspeed?
Highspeed pubblicizza la stessa intelligenza con una velocità di serving 2-3x superiore, al doppio del prezzo input/output ($4/$20 contro $2/$10). La tabella live dei provider di Vercel indica latenza inferiore e throughput maggiore per Highspeed, ma l'affermazione di Moonshot sull'accelerazione non dispone di un confronto indipendente sui tempi di completamento dei task.
Quali sono gli ID dei modelli API?
Sull'API Kimi ufficiale utilizzate kimi-k3.1-pro e kimi-k3.1-pro-highspeed, oppure gli equivalenti con namespace come moonshot/kimi-k3.1-pro sui gateway di terze parti. Le integrazioni K3 esistenti devono cambiare esplicitamente gli ID.
L'uso dell'API è incluso in una membership Kimi?
No. I costi API sono separati da membership Kimi e abbonamenti Kimi Code; gli utenti della settimana di lancio hanno riscontrato quote degli abbonamenti molto più restrittive dei token a consumo per lo stesso lavoro.
Si può disattivare il ragionamento?
No. Kimi K3.1 Pro ragiona sempre; low, high e max riducono soltanto il livello di deliberazione, con max come predefinito. Per richieste brevi che non richiedono ragionamento è preferibile un modello diverso.
L'API è compatibile con OpenAI?
Sì. Puntate un client SDK OpenAI a https://api.moonshot.ai/v1, oppure al base URL di un gateway, impostate l'ID del modello e attivate lo streaming con stream=True. Il quickstart fissa temperatura 1.0 e top-p 0.95. Intervenite invece su reasoning_effort e max_completion_tokens.