 AIREITER
Oggi, tra questi due modelli, solo MiniMax M3.1 Flash si può davvero scaricare e ospitare in proprio. I suoi open weights sono già disponibili, mentre quelli di Kimi K3.1 Pro arriveranno entro il 4 novembre 2026 secondo Moonshot. Se questa settimana serve un checkpoint self-hosted, su Hugging Face c'è una sola scelta.
Su Hugging Face, per ora, c'è un solo checkpoint
MiniMax ha pubblicato i pesi di M3.1 Flash intorno al 22–23 ottobre 2026 su Hugging Face, con licenza minimax-community. La copertura del lancio segnala anche la disponibilità su ModelScope (Cocoloop). Il blog tecnico ufficiale di Kimi indica invece che Kimi K3.1 Pro è già accessibile tramite Kimi.com, app, Kimi Code e Kimi API; i pesi completi arriveranno entro il 4 novembre 2026 (kimi.com).
MiniMax M3.1 Flash e Kimi K3.1 Pro a confronto
Gli open weights di MiniMax M3.1 Flash corrispondono a un MoE multimodale nativo con circa 428 miliardi di parametri totali e 23 miliardi attivi per token. Accetta testo, immagini e video, genera testo e supporta fino a 1M token di contesto (post di lancio di MiniMax). Kimi K3.1 Pro viene descritto ufficialmente come un MoE della classe 3T con finestra di contesto da 1M token (kimi.com); i valori di 2.8T parametri totali e 104B attivi provengono dalla copertura del lancio (ArtificialWatch, ExplainX), non da una dichiarazione diretta di Moonshot sui parametri.
| Voce | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Parametri totali / attivi | ~428B / 23B per token | Classe 3T; la copertura del lancio riporta 2.8T / 104B attivi |
| Repository Hugging Face | MiniMaxAI/MiniMax-M3.1-Flash, disponibile | Nessuno al 24 ottobre 2026; previsto entro il 4 novembre |
| Dimensione download | Circa 252 GB | Sconosciuta; con la densità di MiniMax (~0.59 GB per B di parametri), un checkpoint da 2.8T sarebbe nell'ordine dei TB |
| Contesto | Fino a 1M token, in base al deployment | 1M token |
| Input / output | Testo, immagini e video in input; testo in output | Multimodale, output testuale; modalità self-hosted esatte non confermate |
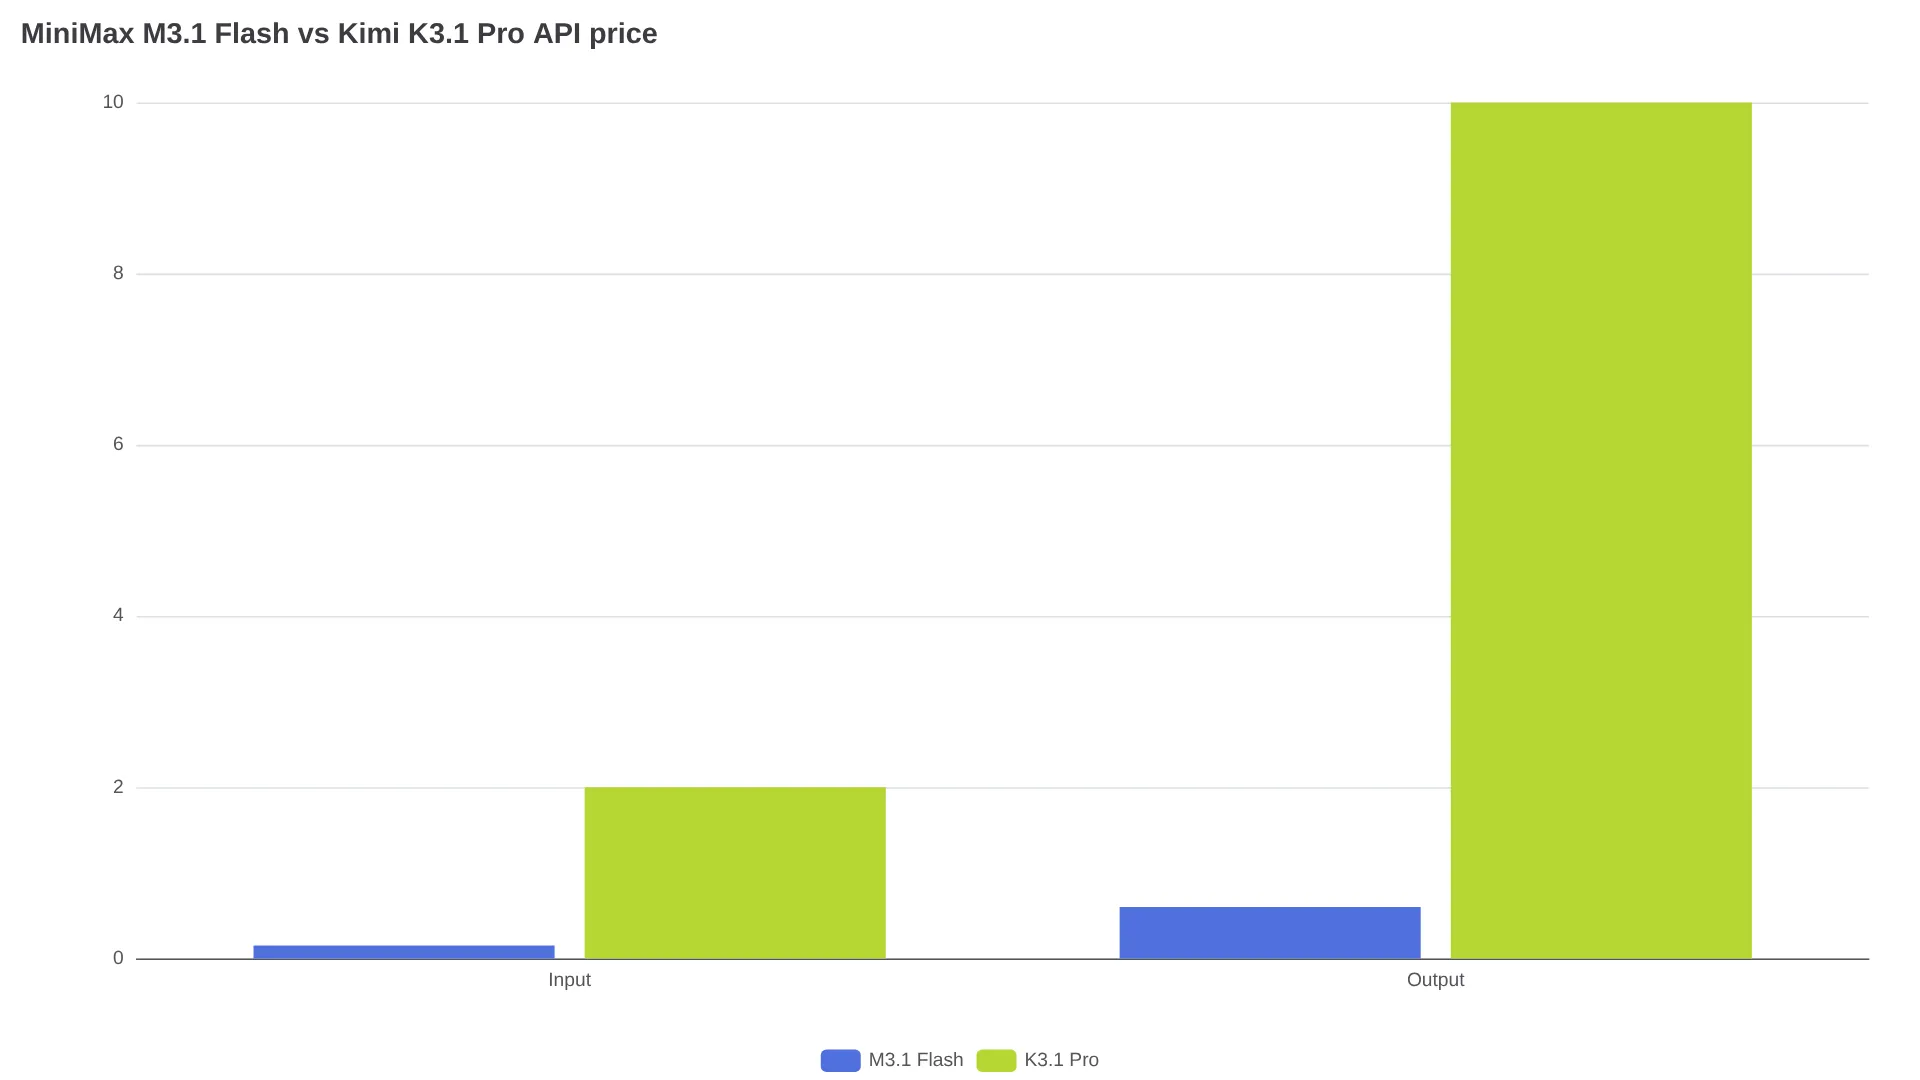
| Prezzo API ufficiale | $0.15 input / $0.60 output / $0.015 cache per 1M token (MiniMax) | Riportati $2 input / $10 output per 1M token (ArtificialWatch) |
| Ricette di serving | SGLang, vLLM, TokenSpeed; FlagOS per configurazioni multi-chip | Non annunciate; ID modello API kimi-k3.1-pro / kimi-k3.1-pro-highspeed (documentazione Kimi) |
| Sampling consigliato | Temperature 1.0, top-p 0.95; reasoning da low a max | Massimo effort di reasoning, temp 1.0, top-p 0.95 secondo la configurazione benchmark di Kimi |
Per scaricare il checkpoint MiniMax, usare il comando ufficiale:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashPrima dei benchmark, verificare di avere l'intero set di file, inclusi la draft head DSpark, il tokenizer e i file di configurazione. MiniMax avverte che i risultati si riferiscono ai pesi ufficiali e che le quantizzazioni di terze parti possono comportarsi diversamente.
Quanto ai benchmark, ogni dato qui sotto va considerato dichiarato dal vendor, salvo ove indicato come indipendente:
| Benchmark | M3.1 Flash (vendor) | Rivale citato dal vendor |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (pareggio) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Una rilevazione indipendente citata colloca M3.1 Flash a metà classifica, con 53.78% (16° su 26) e risultati deboli nei compiti a lungo orizzonte (Vals). Nel proprio grafico, Kimi afferma che K3.1 Pro guida 6 dei 14 test mostrati, inclusi Agents' Last Exam (43.2) e SWE Marathon (51.7), con 65.7 su Terminal-Bench 4.0.
Quanto costa ospitare un download da 252 GB
Il repository pesa circa 252 GB. A 4 bit per peso, i soli 428B parametri occupano approssimativamente 214 GB prima di cache KV e buffer di runtime: per avere un contesto utilizzabile vanno quindi previste diverse GPU della classe 80 GB. L'account NVIDIA RTX Spark indica una DGX Station oppure un cluster di 4x DGX Spark da 128 GB per le esecuzioni locali (post su X), mentre alcuni self-hoster su X osservano che un download da 252 GB e questa soglia hardware escludono i desktop comuni, a fronte di un'API economica (@bufcapy).
Prima conviene fare i conti sul lato API, perché quella di MiniMax costa insolitamente poco. Con $0.15 per input e $0.60 per output ogni 1M token, una giornata da 10M token in input più 2M in output costa 10 × $0.15 + 2 × $0.60 = $2.70, ovvero circa $81/mese.
La formula del punto di pareggio è il costo mensile del cluster diviso per il costo API per token. A $0.15 per 1M token di input, ogni $150/mese di noleggio equivalgono a 1B token in input; a $0.60 per 1M token di output, ogni $600/mese equivalgono a 1B token in output. Inserire il proprio preventivo di noleggio insieme al tempo di engineering: il self-hosting conviene solo quando la fattura API mensile, a queste tariffe, supera quel totale, oppure quando le policy impongono che i pesi restino entro il proprio perimetro. Per Kimi il divario è ancora più netto: i prezzi API riportati di $2/$10 per 1M token rendono l'hosting gestito circa 13x più caro di MiniMax sull'input e circa 17x sull'output. Un futuro checkpoint da 2.8T parametri richiederebbe quindi throughput sostenuto molto elevato per giustificare storage nell'ordine dei TB e un cluster multi-nodo.
Cosa offre il self-hosting fin dal primo giorno
Il supporto ai framework al day zero è concreto, ma incompleto. La model card cita SGLang, vLLM e TokenSpeed, oltre a FlagOS per il deployment multi-chip, con immagini Docker per SGLang; al lancio le integrazioni con Transformers, KTransformers, unsloth e ATOM erano ancora in lavorazione. Un deployer ha segnalato che la configurazione d'esempio vLLM per H100/H200 punta a 256K token invece dell'intero 1M, disattiva l'input video e non abilita la speculative decoding DSpark (@sancaksofttech). Il download è lo stesso, ma non tutte le configurazioni sbloccano ogni funzione.
Su r/LocalLLaMA torna spesso un dubbio: "Flash" descrive l'economia dell'inferenza, non dimensioni ridotte:
Con la quantizzazione può entrare in 256GB? Speriamo — u/BawbbySmith su r/LocalLLaMA
La clausola di licenza conta più dell'hardware
M3.1 Flash è open weights, non open source. Il file LICENSE del repository, etichettato minimax-community (vedere il file LICENSE), consente liberamente l'uso non commerciale; per l'uso commerciale occorre mostrare in modo evidente "Built with MiniMax M3.1-Flash" e inviare una notifica una tantum a MiniMax. Organizzazioni o prodotti con oltre $20M di ricavi annui necessitano di autorizzazione scritta preventiva, mentre gli impieghi militari sono vietati.
Per gli strumenti interni è un onere leggero, ma può bloccare l'hosting commerciale, dove badge e soglia sui ricavi sono più difficili da soddisfare. La licenza di Kimi resta sconosciuta fino alla pubblicazione dei pesi del 4 novembre; Moonshot ha già indicato nel proprio blog tecnico che il checkpoint open differirà dal modello API perché dai pesi aperti sono stati rimossi dati di addestramento relativi alla cybersecurity (kimi.com). Prima di sviluppare, leggere entrambi i file LICENSE.
Quale scegliere in base al proprio scenario
| Situazione | Scelta |
|---|---|
| Servono pesi questa settimana per valutazioni locali, base per fine-tuning o deployment air-gapped | MiniMax M3.1 Flash — è l'unica delle due opzioni scaricabile |
| Agenti di coding sensibili ai costi con carico variabile | API MiniMax a $0.15/$0.60 — self-hosting solo oltre volumi elevati e continuativi |
| Coding frontier a lungo orizzonte e possibilità di attendere | Valutare subito l'API di Kimi K3.1 Pro; decidere sul self-hosting dopo l'arrivo dei pesi, della licenza e delle dimensioni reali il 4 novembre |
| Prodotto commerciale in hosting | Far verificare prima al team legale attribuzione MiniMax e soglia di autorizzazione a $20M; per Kimi non si può decidere finché non uscirà la licenza |
| GPU consumer o singolo Mac | Non viene citata alcuna ricetta validata per un solo dispositivo — usare l'API, salvo voler testare una configurazione non supportata |
FAQ
Dove si scaricano ufficialmente i pesi di MiniMax M3.1 Flash?
Il repository ufficiale è MiniMaxAI/MiniMax-M3.1-Flash su Hugging Face, con mirror su ModelScope; si scarica con hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Esiste un repository Hugging Face ufficiale per Kimi K3.1 Pro?
No. Al 24 ottobre 2026 non esiste un repository pubblico con i pesi di K3.1 Pro; il blog tecnico di Moonshot si impegna a pubblicare i pesi completi entro il 4 novembre 2026.
Posso usare MiniMax M3.1 Flash a fini commerciali?
Sì, a determinate condizioni: bisogna mostrare "Built with MiniMax M3.1-Flash", inviare una notifica una tantum e ottenere autorizzazione scritta preventiva oltre $20M di ricavi annui; gli impieghi militari sono vietati. Verificare il LICENSE del repository con un consulente legale.
Può girare su una GPU consumer o su Apple Silicon?
Le indicazioni di deployment citate non includono una configurazione validata con una sola GPU consumer; le stime richiedono diverse GPU da 80 GB per pesi quantizzati più cache KV. NVIDIA indica una DGX Station oppure un cluster di 4x DGX Spark da 128 GB.
Funziona già con vLLM o SGLang?
Entrambi dispongono di ricette dal day zero, insieme a TokenSpeed e FlagOS per le esecuzioni multi-chip. Tuttavia, le configurazioni d'esempio possono limitare il contesto a 256K, disattivare l'input video o lasciare DSpark disabilitato: controllare la ricetta aggiornata nella model card per il proprio hardware.
L'intero contesto da 1M è disponibile in self-hosting?
Il massimo pubblicizzato è 1M token, ma la lunghezza effettivamente utilizzabile dipende dalla memoria GPU e dalla configurazione di serving. Per workload a contesto lungo, prevedere esplicitamente margine per la cache KV.
Approfondimenti correlati: MiniMax M3.1 Flash Open Weights: guida a download, esecuzione e costi, Guida ai prezzi API di Kimi K3.1 Pro, Kimi K3 Open Weights