 AIREITER
Un coding agent può sembrare conveniente finché non supera una soglia di fatturazione del contesto, oppure finché il budget dedicato al ragionamento non erode il limite dell'output. In questo confronto tra Grok 4.6 e Opus 5, Grok 4.6 è la scelta giusta per carichi sensibili al costo sotto i 200K token di prompt; Claude Opus 5 entra in gioco quando servono davvero una finestra da 1M token, 128K token in output o i suoi controlli per agent documentati.
Prima di tutto, definisci i limiti del carico di lavoro
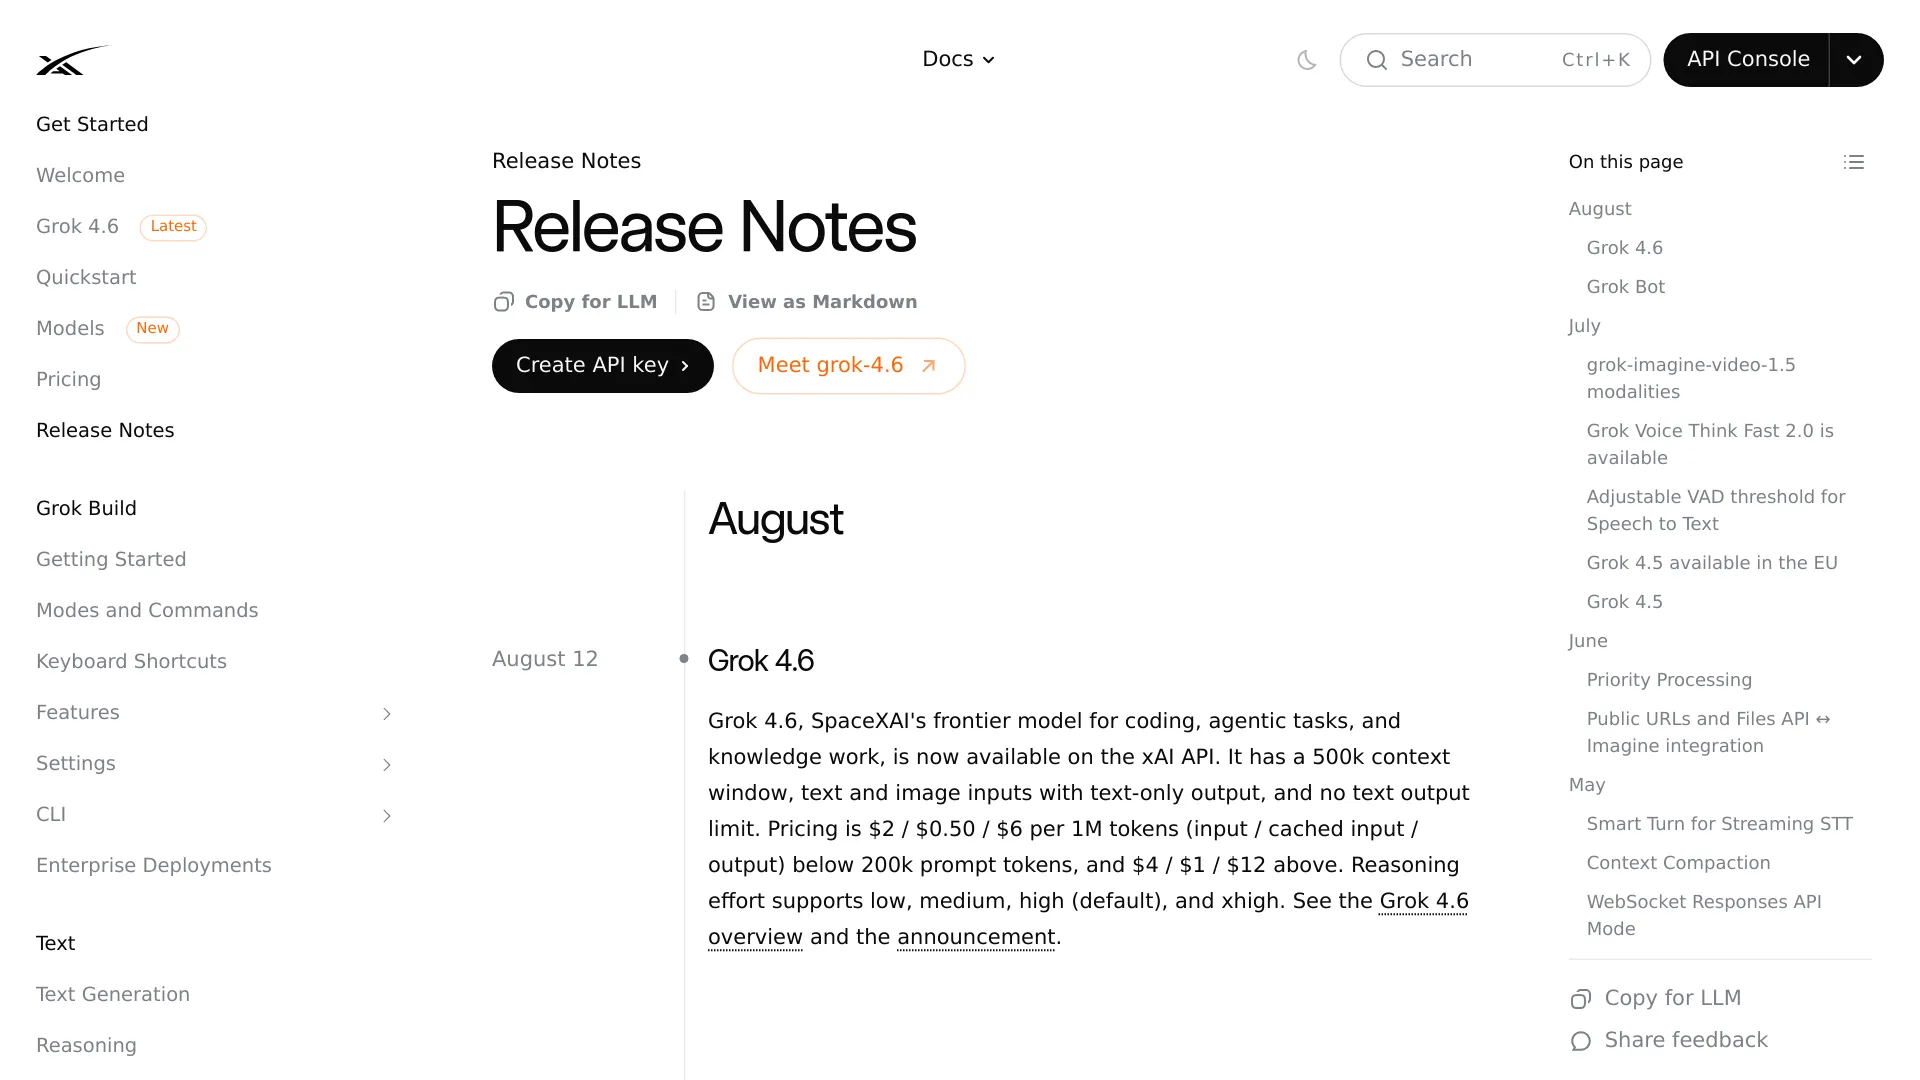
Grok 4.6 è la scelta pratica di default per un agent di coding o knowledge work che produce testo e resta sotto la soglia xAI di 200K token nel prompt. Nelle note di rilascio del 12 agosto 2026, xAI indica una finestra di contesto da 500K token, input testuali e immagini, output testuale e quattro livelli di effort, da low a xhigh. Le note di rilascio per sviluppatori di xAI sono la fonte primaria per queste specifiche.
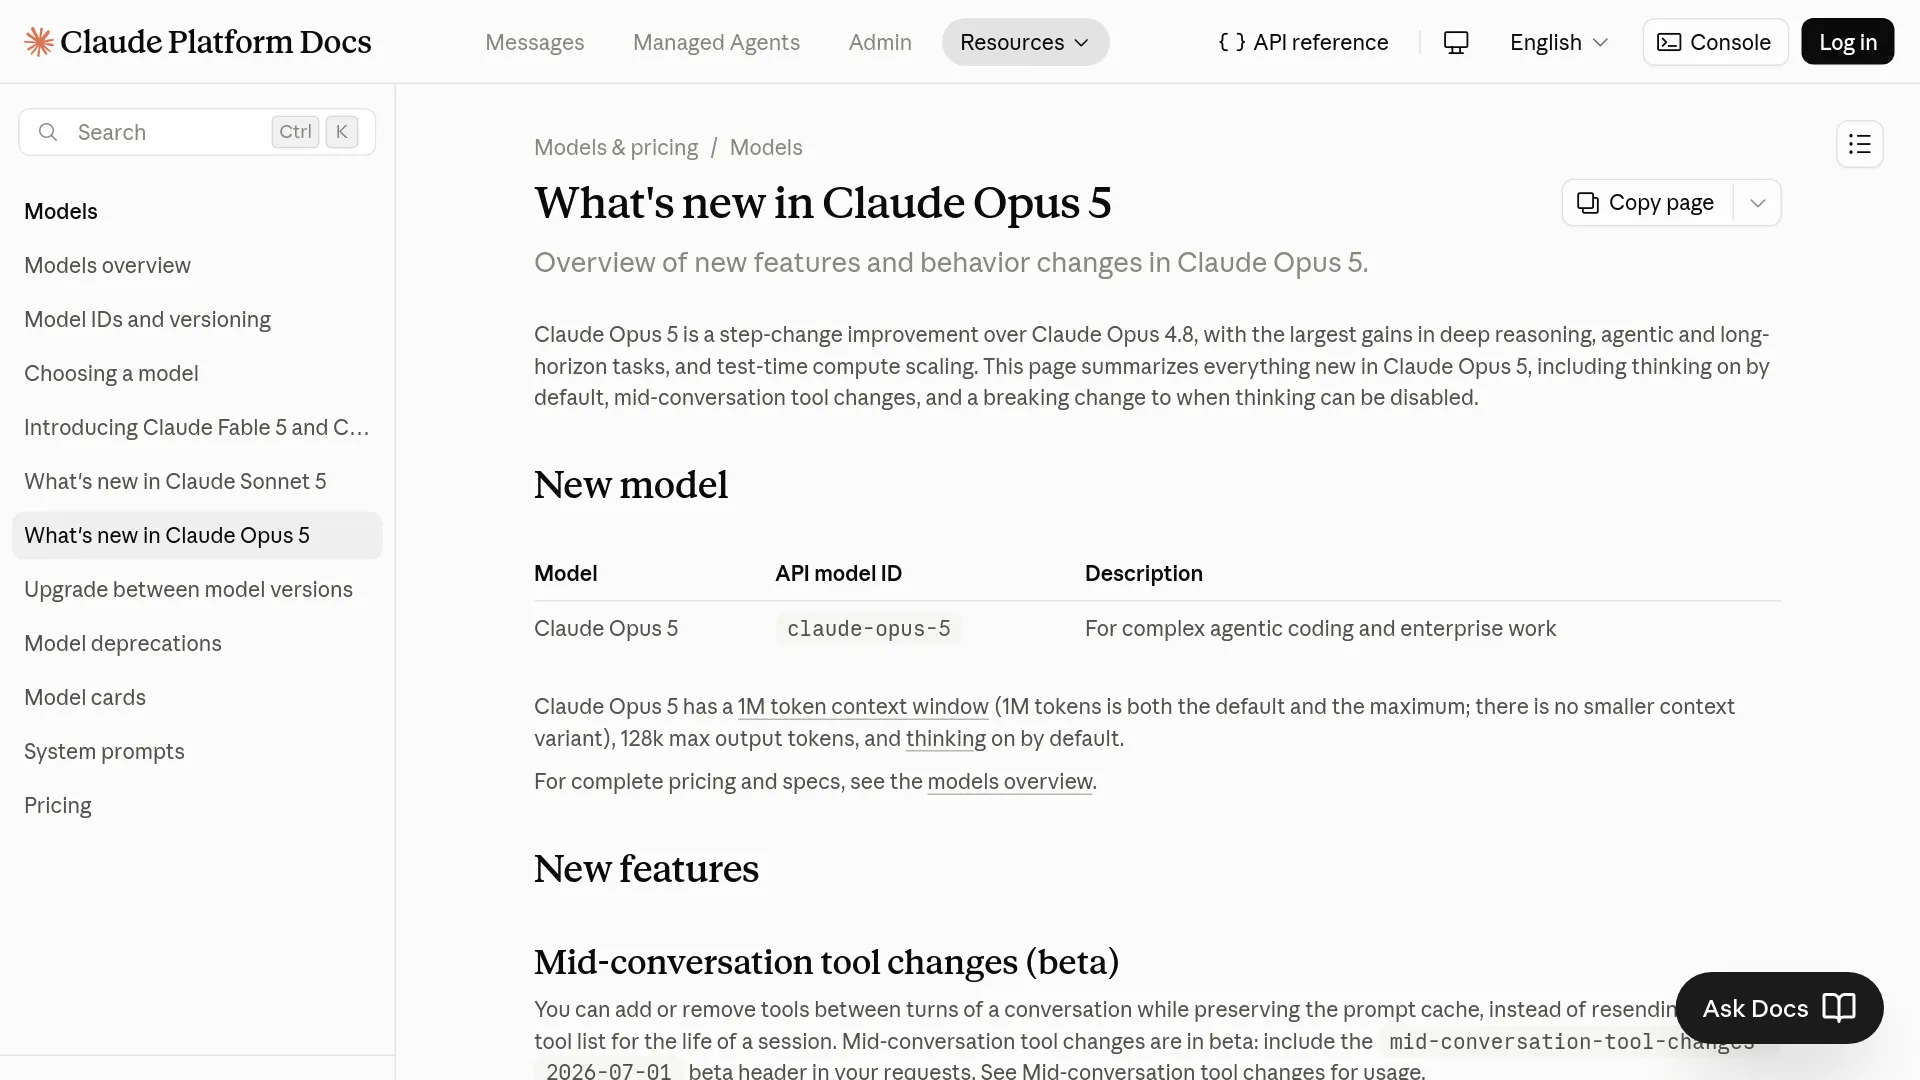
Claude Opus 5 è più adatto se 500K token non bastano, se il workflow richiede fino a 128K token in output oppure se l'integrazione dipende dalle funzioni di fallback e dalla lista dinamica degli strumenti di Anthropic. Anthropic documenta una finestra di contesto predefinita e massima da 1M token, thinking attivo di default e la disponibilità di claude-opus-5 nella sua API e presso i principali cloud partner. In questo caso, la documentazione Opus 5 di Claude Platform conta più di un piccolo scarto in classifica.
Le fonti citate non offrono un benchmark comune in grado di decretare il vincitore per ogni attività di coding. Parti invece dalla dimensione massima del prompt, dalla lunghezza di output necessaria, dal contratto degli strumenti e dal costo per task completato nel tuo harness.
Confronta prima vincoli API, poi i punteggi
Grok 4.6 e Claude Opus 5 accettano entrambi testo e immagini e generano testo. Le differenze che contano riguardano capacità del contesto, fatturazione dei prompt lunghi, vincoli sull'output e controlli di integrazione.
| Proprietà API | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Finestra di contesto | 500K token | 1M token |
| Modalità di input | Testo, immagini | Testo, immagini, workflow PDF/documenti descritti da Anthropic |
| Modalità di output | Testo | Testo |
| Output testuale massimo | Nessun limite numerico indicato nelle note di rilascio xAI | 128K token |
| Impostazioni di effort | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Effort predefinito | high | high |
| Prezzo input standard | $2/M token | $5/M token |
| Prezzo output standard | $6/M token | $25/M token |
| Regola per prompt lunghi | $4/M in input e $12/M in output oltre 200K token di prompt | Nessuna soglia equivalente indicata nella documentazione di rilascio di Opus 5 |
| Input in cache | $0.50/M sotto 200K; $1/M sopra 200K | Prompt memorizzabile in cache da almeno 512 token, con prezzi cache documentati separatamente |
Grok 4.6 ha tariffe unitarie dichiarate inferiori, ma raddoppiano oltre 200K token di prompt. Opus 5 costa di più, ma il suo contesto da 1M può evitare l'overhead di chunking o retrieval in un workflow che ne ha bisogno.
Quando Grok 4.6 cambia davvero l'equazione dei costi
Grok 4.6 costa $2 per milione di token in input e $6 per milione in output sotto i 200K token di prompt. Superata questa dimensione, xAI indica $4/M per l'input e $12/M per l'output; l'input in cache costa rispettivamente $0.50/M e $1/M. Questa soglia pesa più della tariffa headline del livello inferiore. Le note di rilascio di xAI specificano entrambi i livelli.
Alle tariffe indicate, una richiesta con 100K token di input non in cache e 20K token in output costa $0.32; con 250K token in input e 20K in output sale a $1.24 dopo l'applicazione della fascia superiore. Sono calcoli per singola richiesta, non stime di una run dell'agent: retry, chiamate agli strumenti, prefissi in cache e contesto accumulato possono dominare la fattura.
Una recente discussione su r/grok riporta risultati CursorBench 3.2 dipendenti dalla configurazione: $2.81 per task e 46 passaggi per Grok 4.6 Extra High, contro $8.23 e 78 passaggi per Opus 5 Max. Considerali risultati dell'harness dichiarati dall'autore, non una garanzia indipendente dai vendor: lo stesso post riporta per Grok 4.6 il 26.0% su Terminal-Bench 3.0, dietro ad altri modelli nominati.
Quando Opus 5 modifica il design dell'integrazione
Claude Opus 5 abilita il thinking per impostazione predefinita. max_tokens è un limite rigido condiviso tra thinking nascosto e output visibile, quindi una migrazione da richieste Opus 4.8 senza thinking può richiedere un budget di output maggiore. Anthropic specifica inoltre che la combinazione di thinking: {"type":"disabled"} con xhigh o max restituisce HTTP 400. Le note di migrazione propongono due alternative: ridurre l'effort disabilitando il thinking, oppure rimuovere l'impostazione che disabilita il thinking.
Claude Opus 5 riduce anche il prompt minimo memorizzabile in cache da 1,024 token in Opus 4.8 a 512 token. I controlli beta permettono di modificare gli strumenti nel corso della conversazione senza invalidare la cache del prompt e offrono una modalità gestita fallbacks: "default". Sono funzioni rilevanti se l'agent ha autorizzazioni o set di strumenti variabili; non incidono invece su un semplice endpoint stateless di completamento.
Fast mode è una research preview disponibile solo via API, a $10/M token in input e $50/M in output: il doppio della tariffa standard di Opus 5. Anthropic afferma che non è disponibile tramite Amazon Bedrock, Google Cloud o Microsoft Foundry, quindi non si possono dare per scontate insieme portabilità e velocità. L'annuncio di lancio di Anthropic indica per la modalità standard $5/M in input e $25/M in output.
Per i coding agent, le evidenze indicano una direzione ma non un vincitore assoluto
Anthropic dichiara che Opus 5 al massimo effort raggiunge circa il 70.0% su CursorBench 3.2, a circa $8.50 per task, entro 0.5 punti percentuali dal miglior punteggio riportato per Fable 5 e a circa metà del costo. Sono risultati tracciati da Anthropic e vanno letti come evidenza di valutazione del vendor, non come audit tra provider. L'annuncio di Opus 5 descrive il metodo Frontier-Bench come cinque tentativi per task eseguiti internamente da Anthropic.
Per il code review, una misurazione apparentemente indipendente ma più circoscritta è più utile. CodeRabbit ha testato circa 100 pattern di errore verificati provenienti da pull request open source reali, ha eseguito ogni configurazione tre volte e valutato i commenti di review dopo il filtro. Con effort xhigh, la configurazione Opus 5 ha rilevato il 55.2% dei problemi noti, contro il 61.1% della baseline di produzione, mentre la precisione azionabile era 39.3% contro 35.2%; ha inoltre prodotto 92 nitpick contro 23. La valutazione di Opus 5 di CodeRabbit raccomanda un ruolo specifico orientato alla precisione, anziché usare Opus 5 come unica rete di sicurezza.
Da queste evidenze emerge una regola concreta: valuta Opus 5 a più livelli di effort e misura recall, precisione, uso dei token e rumore nelle review sulle tue pull request. Per Grok 4.6, le note di rilascio attuali di xAI definiscono contratto API e prezzi, ma non pubblicano uno studio sul code review direttamente comparabile. Un punteggio sui coding agent non basta per dedurre una vittoria nel code review.
Scegli il modello in base allo scenario di deployment
Grok 4.6 è la raccomandazione per agent i cui prompt normali restano sotto 200K token e per cui la priorità è un costo API dichiarato inferiore. Prevedi un budget di valutazione attorno a quella soglia: un agent per repository può superarla dopo output degli strumenti e retry, anche se il prompt iniziale è piccolo.
Claude Opus 5 è la scelta consigliata per una sessione su repository, documenti o agent che richieda oltre 500K token di contesto attivo, fino a 128K token in output oppure i controlli documentati da Anthropic per modifiche agli strumenti e fallback. Parti da high, poi prova effort inferiori prima di presumere che max si ripaghi da solo.
Per il code review automatizzato, non scegliere nessuno dei due modelli basandoti su una classifica generale di coding. Esegui un set etichettato di pull request, registra recall dei problemi e carico di falsi positivi e mantieni un secondo percorso di review per difetti di concorrenza, utilizzo delle API e validazione. CodeRabbit ha riscontrato che queste erano categorie più deboli per le configurazioni Opus 5 testate. Le sue rilevazioni per categoria sono un motivo per verificare l'aderenza al task, non un'affermazione valida per tutti i deployment Claude.
| Scenario di deployment | Scelta predefinita | Fattore decisivo |
|---|---|---|
| Coding agent sensibile ai costi sotto 200K token di prompt | Grok 4.6 | Le tariffe dichiarate di $2/M in input e $6/M in output |
| Sessione lunga su repository o documenti oltre 500K di contesto | Claude Opus 5 | Finestra di contesto da 1M e limite di output da 128K |
| Agent con strumenti che cambiano dinamicamente | Claude Opus 5 | Le modifiche beta agli strumenti durante la conversazione preservano la cache |
| Task con prompt frequenti oltre 200K token | Valuta entrambi | Grok 4.6 raddoppia le tariffe token dichiarate alla soglia |
| Pipeline di code review | Valuta entrambi su PR etichettate | Recall, precisione, retry e rumore nelle review contano più di un punteggio headline |
FAQ
Grok 4.6 costa meno di Opus 5?
Sotto i 200K token di prompt, xAI indica per Grok 4.6 $2/M in input e $6/M in output, contro $5/M e $25/M per Opus 5. I prezzi dichiarati di Grok 4.6 raddoppiano oltre 200K token di prompt, quindi confronta il costo del task completato e non solo quello della richiesta iniziale.
Quale modello usare per il coding?
Scegli Grok 4.6 per tariffe API dichiarate inferiori se il tuo agent resta normalmente sotto 200K token di prompt. Scegli Opus 5 quando sono necessari contesto da 1M, output da 128K o i controlli per agent di Anthropic; in entrambi i casi, valida la scelta sul linguaggio, sulla struttura del repository e sul loop di strumenti che usi realmente.
Il prossimo passo per il deployment
Esegui da 20 a 50 task rappresentativi su entrambi i candidati, con strumenti fissi, limite di retry fisso e logging dei token. Scegli il modello che raggiunge il tasso di successo richiesto al minor costo per task completato, quindi conserva l'altro come opzione instradata per i carichi in cui il suo vantaggio di contesto o control plane è decisivo.
Approfondimenti correlati: guida ai prezzi API di Claude Opus 5, dettagli sul rilascio di Grok 4.6 e Grok 4.6 vs GPT-5.6.