 AIREITER
DeepSeek a officialisé V4 Pro GA le 13 août 2026. Au programme : scores de benchmarks complets, poids ouverts sous licence MIT et trois niveaux d'effort de raisonnement. Pour les utilisateurs de l'API, le changement à surveiller est tarifaire : la page officielle des prix confirme une facturation en heures pleines et heures creuses à compter du 16 août 2026 à 16:00 UTC. Les tokens de sortie V4 Pro passent de 0,87 $ à 1,98 $/million en heures creuses, ou 3,96 $/million en heures pleines.
V4-Pro-0813 : benchmarks publiés et poids ouverts
Le modèle désormais servi derrière l'alias API deepseek-v4-pro est DeepSeek-V4-Pro-0813. Il est accessible dans l'application DeepSeek, sur le web et via l'API. DeepSeek a annoncé sa disponibilité le 13 août, en mettant en avant des « capacités d'agent considérablement améliorées » face à la version preview du 24 avril.
Architecture et caractéristiques :
| Élément | DeepSeek-V4-Pro-0813 |
|---|---|
| Taille du modèle publiée | 1.7T paramètres (model card ; la preview comptait 1.6T) |
| Longueur de contexte | 1 million de tokens |
| Sortie maximale | 384K tokens |
| Modes de réflexion | Sans réflexion et avec réflexion (ce dernier est activé par défaut) |
| Niveaux d'effort de raisonnement | low, high, max |
| Nouveau module de décodage | Décodage spéculatif DSpark (7 tokens spéculatifs) |
| Compatibilité API | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Limite de concurrence | 500 |
| Licence | MIT |
Pour les scénarios agentiques, la model card recommande temperature = 1.0 et top_p = 0.95. La longueur de sortie maximale atteint 384K tokens avec les niveaux d'effort high et max.
Les benchmarks officiels de la version GA
DeepSeek publie dix comparaisons sur la model card. Les tâches d'agents de code ont été exécutées avec DeepSeek Harness en mode minimal et un effort de raisonnement max. Les deux dernières lignes, DSBench, correspondent à des jeux de test internes à DeepSeek. Tous les scores ci-dessous proviennent de cette model card.
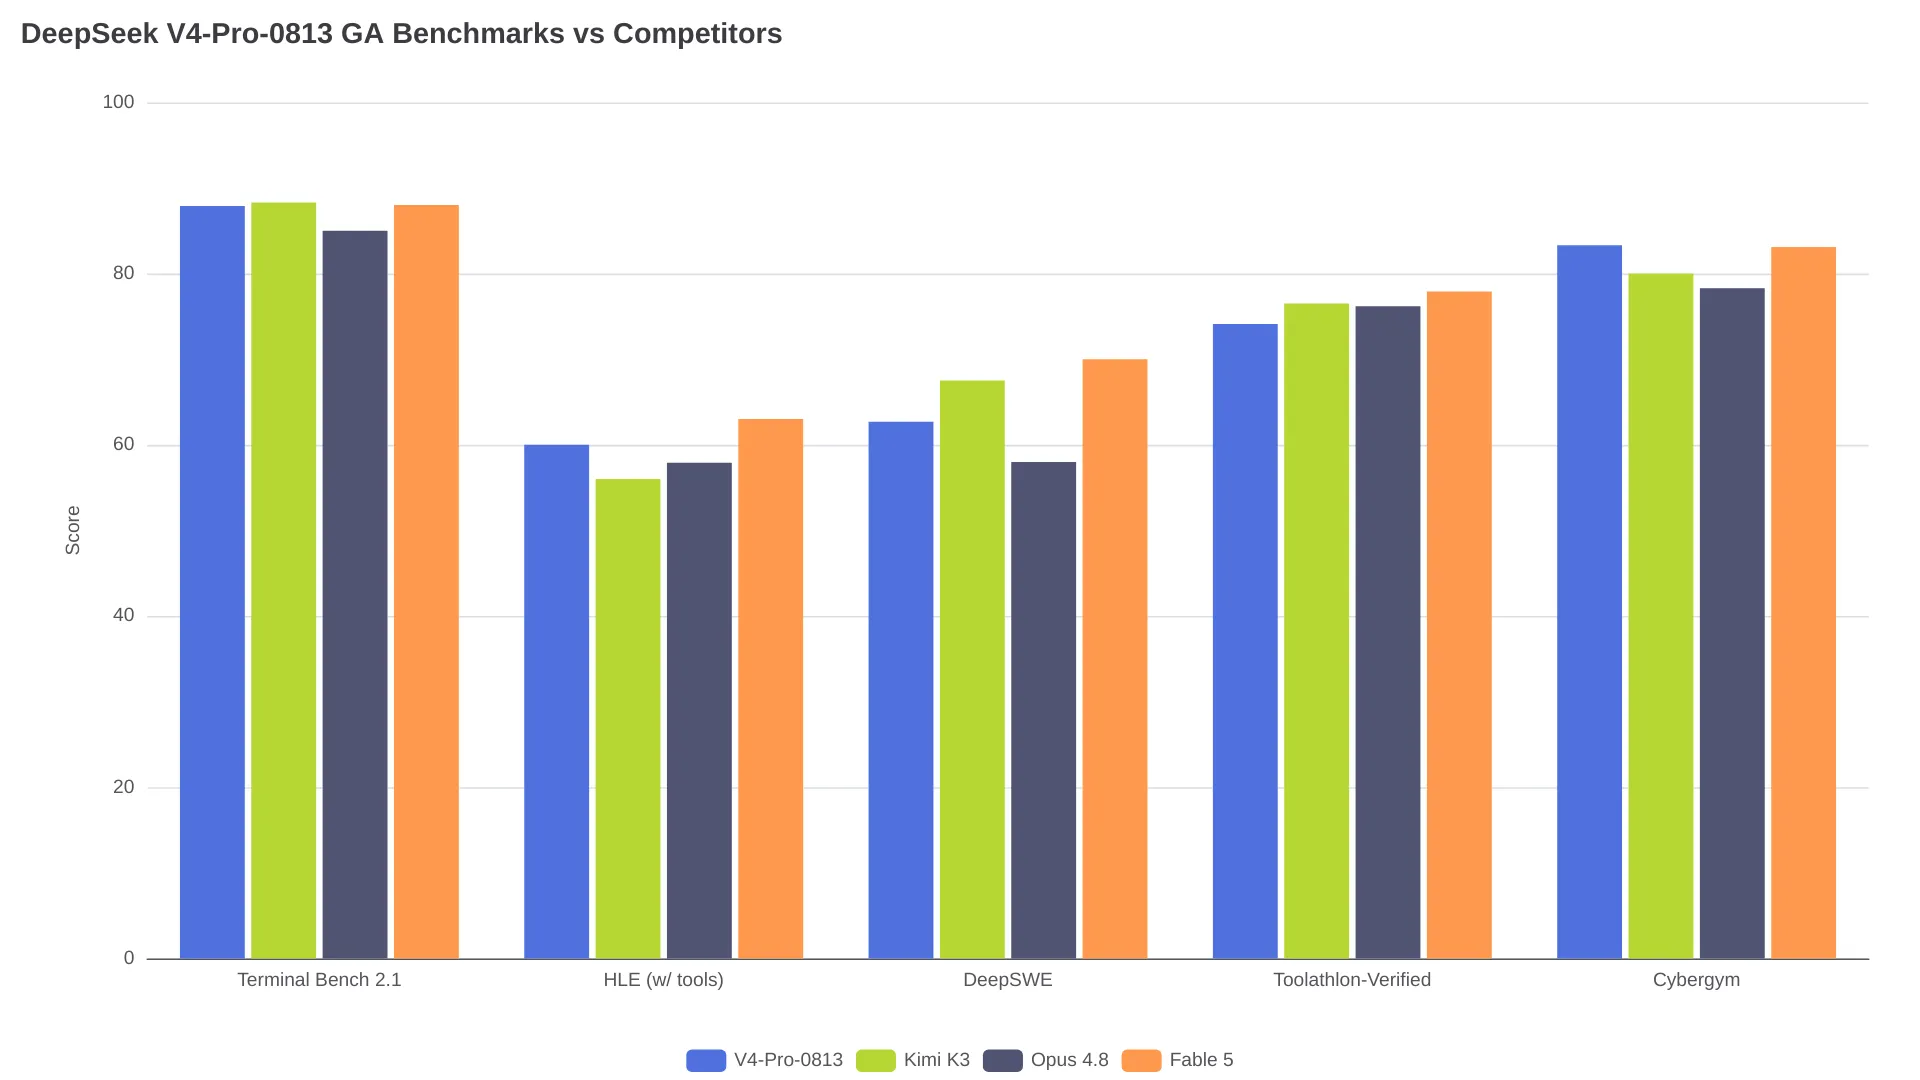
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (sans outils / avec outils) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (public) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (interne) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (interne) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
Le bond par rapport à la preview est spectaculaire : DeepSWE passe de 12.8 à 62.7, tandis qu'AutomationBench progresse de 12.8 à 31.8. Face aux concurrents, Pro-0813 prend la tête sur HLE avec outils, à 60.0, devant les 56.0 de Kimi K3 et les 57.9 d'Opus 4.8. En revanche, il reste derrière Kimi K3 et Fable 5 sur DeepSWE, Terminal Bench et Toolathlon-Verified. Les deux lignes DSBench étant des évaluations internes à l'éditeur, elles ne doivent pas être interprétées comme des benchmarks maintenus de façon indépendante.
Des poids accessibles en open source
Les poids 0813 sont disponibles sur Hugging Face sous licence MIT, avec des options de déploiement via vLLM et SGLang. La model card fournit un exemple de service vLLM reposant sur le décodage spéculatif DSpark, un cache KV en FP8 et un unique nœud 4x GB300.
« Globalement compétitif face aux meilleurs modèles propriétaires disponibles. » — model card DeepSeek V4-Pro, Hugging Face
Tarifs API : avant et après le 16 août
La page tarifaire affiche à la fois un tarif fixe actuel et une grille heures pleines/heures creuses programmée, applicable à partir du 16 août 2026 à 16:00 UTC. Les heures pleines sont fixées à 01:00–04:00 UTC et 06:00–10:00 UTC, soit 09:00–12:00 et 14:00–18:00 à Pékin. Toutes les autres plages sont en heures creuses. Le tarif heures creuses est exactement deux fois inférieur au tarif heures pleines.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Catégorie de facturation | Tarif fixe actuel | Heures creuses (16 août) | Heures pleines (16 août) | Hausse en heures pleines |
|---|---|---|---|---|
| Entrée, cache atteint | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| Entrée, cache manqué | $0.435/M | $0.66/M | $1.32/M | +203% |
| Sortie | $0.87/M | $1.98/M | $3.96/M | +355% |
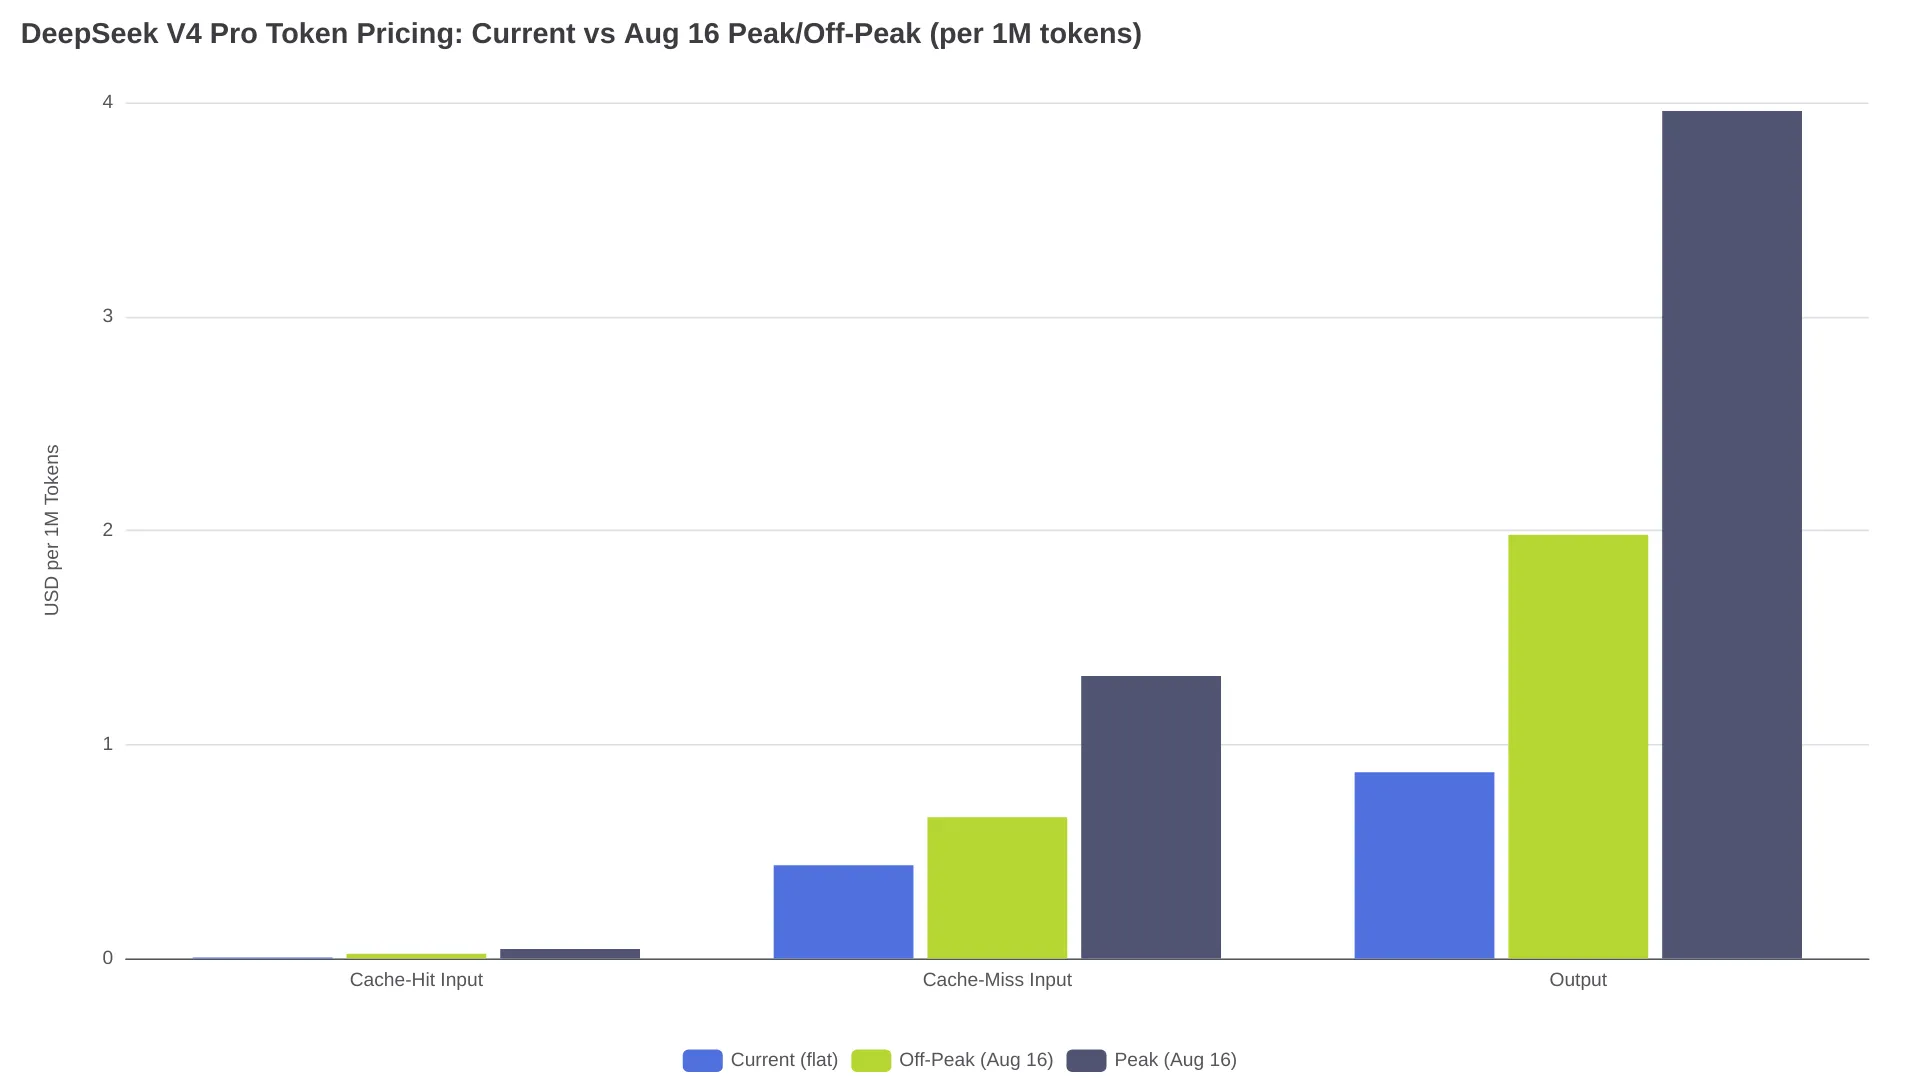
En heures pleines, le coût de sortie est multiplié par 4.6. Le changement sur les cache hits est encore plus sensible pour les workflows d'agents en production : l'ancien tarif de $0.003625/M était environ 120 fois moins cher qu'un cache miss. Après le 16 août, cet écart tombe à 30x dans les deux tranches tarifaires, soit 0.022 contre 0.66 en heures creuses et 0.044 contre 1.32 en heures pleines. Dans le même temps, le coût absolu d'un cache hit est multiplié par 6 à 12.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Catégorie de facturation | Tarif fixe actuel | Heures creuses (16 août) | Heures pleines (16 août) | Hausse en heures pleines |
|---|---|---|---|---|
| Entrée, cache atteint | $0.0028/M | $0.007/M | $0.014/M | +400% |
| Entrée, cache manqué | $0.14/M | $0.22/M | $0.44/M | +214% |
| Sortie | $0.28/M | $0.66/M | $1.32/M | +371% |
Limite de concurrence : 2,500 requêtes simultanées, soit cinq fois l'allocation de Pro.
À quelles heures les tarifs pleins s'appliquent-ils ?
| Fuseau horaire | Plage de pointe 1 | Plage de pointe 2 |
|---|---|---|
| Pékin (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Londres (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| New York (UTC-4) | 21:00–00:00 (jour précédent) | 02:00–06:00 |
| San Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
Pour les équipes basées aux États-Unis, les créneaux de pointe tombent surtout la nuit et en soirée. En Chine et en Asie de l'Est, ils correspondent aux horaires habituels de bureau.
Simulation : Pro avec 10,000 appels par jour
Prenons le cas d'un agent en production qui envoie, à chaque appel, un préfixe mis en cache de 50K tokens et génère une réponse de 2K tokens.
| Poste de coût | Tarif fixe actuel | Heures creuses | Heures pleines |
|---|---|---|---|
| Entrée avec cache hit (500M tokens) | $1.81 | $11.00 | $22.00 |
| Sortie (20M tokens) | $17.40 | $39.60 | $79.20 |
| Total quotidien | $19.21 | $50.60 | $101.20 |
| Total sur 30 jours | $576 | $1,518 | $3,036 |
Dans la réalité, une charge de travail combine appels en heures pleines et en heures creuses : le coût final se situera entre ces deux bornes. Pour ce même usage, Flash revient à $7.00/jour au tarif fixe actuel, à environ $16.70/jour en heures creuses et à environ $33.40/jour en heures pleines. Flash en heures pleines ($33.40/jour) coûte davantage que Pro au tarif fixe actuel ($19.21/jour), mais Flash en heures creuses ($16.70/jour) reste moins cher.
Migration : identifiants de modèles, contrôle du raisonnement et versions figées
Endpoints retirés et identifiants de remplacement
L'annonce de la preview du 24 avril indiquait que deepseek-chat et deepseek-reasoner seraient « entièrement retirés et inaccessibles après le 24 juillet 2026, 15:59 (UTC Time) ». Le code qui référence ces identifiants doit donc être mis à jour.
| Ancien endpoint | Modèle réellement servi | Remplacement |
|---|---|---|
deepseek-chat | V4 Flash, sans réflexion | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, avec réflexion | deepseek-v4-flash (avec réflexion) ou deepseek-v4-pro |
De nombreuses équipes supposaient que deepseek-reasoner donnait accès au raisonnement de niveau Pro. Cet endpoint routait en fait vers Flash en mode réflexion. Passer à deepseek-v4-pro modifiera la qualité des sorties comme le montant de la facture.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
L'URL de base reste https://api.deepseek.com. La structure des requêtes ne change pas par ailleurs.
Trois niveaux d'effort de raisonnement
V4-Pro-0813 introduit trois niveaux d'effort : low pour les tâches simples, high pour le travail agentique courant, et max pour les problèmes complexes. Le mode réflexion est activé par défaut, et les tokens de réflexion sont facturés comme des tokens de sortie. Un prompt qui consomme 3,000 tokens de réflexion avant de fournir une réponse de 200 tokens sera ainsi facturé sur 3,200 tokens de sortie au tarif heures pleines : $0.0127 par appel, contre $0.0008 pour la réponse seule. DeepSeek désigne le niveau low pour les tâches simples, où une réflexion prolongée ajoute un coût sans apporter de valeur.
Figer une version de modèle
L'alias deepseek-v4-pro cible la version courante et peut évoluer lorsque DeepSeek publie de nouvelles versions. Pour garantir un comportement reproductible en production, vérifiez si votre fournisseur prend en charge les identifiants de modèles datés. Certaines passerelles tierces proposent des routes figées : consultez leur documentation pour confirmer quelle version est servie par chaque route avant de vous y fier en production.
Compatibilité des protocoles API
Les deux modèles prennent en charge les formats OpenAI ChatCompletions et Anthropic API. L'endpoint Anthropic est https://api.deepseek.com/anthropic. La compatibilité avec la Responses API et Codex est nouvelle dans la version GA. Testez les deux chemins de protocole si vous rencontrez des erreurs après la migration.
Pro ou Flash après la hausse des prix ?
V4-Pro-0813 devance V4-Flash-0731 sur les dix métriques publiées. L'écart dépend toutefois de la complexité de la tâche :
| Benchmark | Pro 0813 | Flash 0731 | Écart |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 pts |
| DeepSWE | 62.7 | 54.4 | 8.3 pts |
| AutomationBench | 31.8 | 25.1 | 6.7 pts |
| Cybergym | 83.3 | 76.7 | 6.6 pts |
Choisissez V4 Pro si :
- Votre boucle agentique renvoie régulièrement un préfixe stable et volumineux. Les économies liées aux cache hits restent valables, malgré une base tarifaire plus élevée
- Vous avez besoin du plus grand nombre de paramètres de Pro pour un raisonnement complexe, l'utilisation d'outils en plusieurs étapes ou la génération de code à grande échelle
- Votre charge de travail peut s'accommoder de la limite de 500 requêtes simultanées
Choisissez V4 Flash si :
- Vos tâches sont simples, à fort volume ou sensibles à la latence
- Vous avez besoin de la limite de 2,500 requêtes simultanées pour des charges avec fan-out
- Le gain de qualité ne justifie pas un prix de sortie trois fois plus élevé
Pour une analyse plus complète modèle contre modèle, consultez notre comparatif DeepSeek V4 Flash vs Pro. Pour tester le modèle sans gérer de clés API, les pages de chat V4 Pro et V4 Flash sont accessibles immédiatement.
FAQ
Les poids V4-Pro-0813 sont-ils disponibles pour l'auto-hébergement ?
Oui : ils sont sous licence MIT et disponibles sur Hugging Face, avec des options vLLM et SGLang. Consultez la section consacrée aux poids ouverts ci-dessus pour les détails de déploiement.
Faut-il passer de V4 Flash à V4 Pro avec la GA ?
Pour la plupart des charges de travail sensibles aux coûts, Flash reste le meilleur choix en rapport qualité-prix. Selon les benchmarks, il accuse un retard allant de 0.5 point sur Agents' Last Exam à 8.5 points sur HLE avec outils, tout en coûtant trois fois moins cher en sortie. Passez à Pro si votre usage exige l'ensemble des paramètres pour un raisonnement complexe en plusieurs étapes ou pour générer du code à grande échelle.
Comment limiter l'impact de la hausse tarifaire ?
Trois leviers : planifier les traitements par lots et les agents différables en dehors des heures pleines, soit 01:00–04:00 et 06:00–10:00 UTC ; maximiser les cache hits en conservant des préfixes de prompt stables ; router les tâches simples vers Flash ou utiliser l'effort de raisonnement low sur Pro.
La tarification heures pleines/heures creuses concerne-t-elle l'application et le site DeepSeek ?
La page officielle des tarifs documente uniquement la facturation des tokens API. Le calendrier indiqué s'applique aux appels directs à l'API ; les fournisseurs de passerelles peuvent le répercuter, ajouter une marge ou appliquer leurs propres tarifs. Consultez la page tarifaire pour les informations à jour.