 AIREITER
Dos modelos chinos punteros de mezcla de expertos, ambos con una ventana de contexto de un millón de tokens y razonamiento al máximo activado de serie, pero con tarifas radicalmente distintas. Kimi K3 es mejor programando, aunque cobra $15 por millón de tokens de salida: 2.5× los $6 de Qwen 3.8 Max. Qwen 3.8 Max, disponible de forma general desde el 3 de agosto de 2026, es la alternativa más reciente y económica, además de imponerse en gráficos y uso de ordenador. La contrapartida es clara: como ambos piensan al máximo por defecto, el precio superior de salida de Kimi K3 se acumula en cada petición; y los pesos abiertos de Qwen no llegarán hasta alrededor del 11 de agosto.
Misma categoría, pero con una diferencia decisiva
Qwen 3.8 Max y Kimi K3 son modelos de mezcla de expertos de varios billones de parámetros, con contexto de un millón de tokens y visión nativa. Se lanzaron con apenas tres semanas de diferencia a mediados de 2026. Sobre el papel juegan en la misma liga, por lo que es fácil reducir la comparación a una sucesión de benchmarks. Pero la decisión real es más concreta: cuánto sobrecoste de salida aceptas a cambio de una ventaja en programación, y si necesitas hoy pesos abiertos o un modelo multimodal potente.
| Especificación | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Parámetros totales | 2.4T | 2.8T |
| Activos por token | ~95B | 104B |
| Arquitectura | MoE (~4% activos) | MoE (16 de 896 expertos) |
| Ventana de contexto | ~1M (991K de entrada máxima) | 1,048,576 |
| Visión | Sí (entrada de texto + imagen) | Sí (nativa) |
| Razonamiento predeterminado | xhigh, thinking activado | esfuerzo máximo, razonamiento activado |
| Pesos abiertos | No (previstos ~11 de agosto) | Sí (HF, 27 de julio, 1.56TB MXFP4) |
| Estado de la API | GA, 3 de agosto de 2026 | GA |
Fuentes: comparativa cara a cara de yottalabs, Alibaba QwenCloud a través de AIReiter y Moonshot platform.kimi.ai, verificadas el 6 de agosto de 2026.
Precios, coste por carga de trabajo y acceso
Los dos proveedores publican precios por token, pero la gran diferencia no está donde cabría esperar a partir del número de parámetros. Se concentra en los tokens de salida, que es donde los modelos de razonamiento consumen buena parte de su presupuesto. Kimi K3 cobra $15 por millón de tokens de salida, frente a los $6 de Qwen 3.8 Max. Además, los dos modelos razonan en voz alta de forma predeterminada, de modo que esa tarifa también se aplica a las trazas de razonamiento, no solo a la respuesta final.
| Precio por 1M de tokens | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Entrada (sin caché) | $2.00 | $3.00 |
| Entrada (con acierto de caché) | $0.25 | $0.30 |
| Salida (incluido el razonamiento) | $6.00 | $15.00 |
| Contexto | ~1M | 1,048,576 |
Fuentes: página de modelos de Alibaba QwenCloud, actualizada el 2 de agosto de 2026, y Moonshot platform.kimi.ai/docs/pricing/chat-k3, verificadas el 6 de agosto de 2026.
En una carga de programación habitual con 20M de tokens de entrada, una tasa de acierto de caché del 60% y 5M de tokens de salida, Kimi K3 se sitúa cerca de $103 ($27.60 de entrada y $75 de salida). Qwen 3.8 Max ronda los $49 ($19 de entrada y $30 de salida). La diferencia de 2× procede casi por completo de la salida: la caché reduce la brecha en la entrada, pero no hay equivalente para la salida. Y, dado que ambos modelos usan el máximo esfuerzo de razonamiento por defecto, esa partida de salida pesa mucho.
El acceso tampoco es simétrico. Qwen 3.8 Max llegó a disponibilidad general en la API de Alibaba el 3 de agosto de 2026, pero sus pesos aún no son públicos. La página del modelo sigue indicando Open Source: No, con pesos previstos en Hugging Face y ModelScope durante la semana del 11 de agosto (Alibaba, a través de la página de precios de Qwen 3.8 Max). Kimi K3 es la opción abierta: Moonshot publicó el checkpoint MXFP4 de 1.56 TB el 27 de julio y su API ya está disponible.
También se puede acceder a Kimi K3 mediante el endpoint de API de Kimi K3 de AIReiter, con la tarifa oficial de Moonshot y sin recargo. Es útil para probar K3 junto a otros modelos en una sola factura. Qwen 3.8 Max todavía no está integrado allí.
Kimi K3 destaca en programación agéntica
Kimi K3 es el modelo indicado para programación de varios pasos: bucles de agentes, refactorizaciones de repositorios y tareas tipo SWE en las que debe invocar herramientas y recuperarse de callejones sin salida. En los benchmarks públicos de agentes supera de forma consistente a Qwen 3.8 Max, y la distancia es mayor precisamente en las tareas que más se parecen al trabajo de ingeniería real.
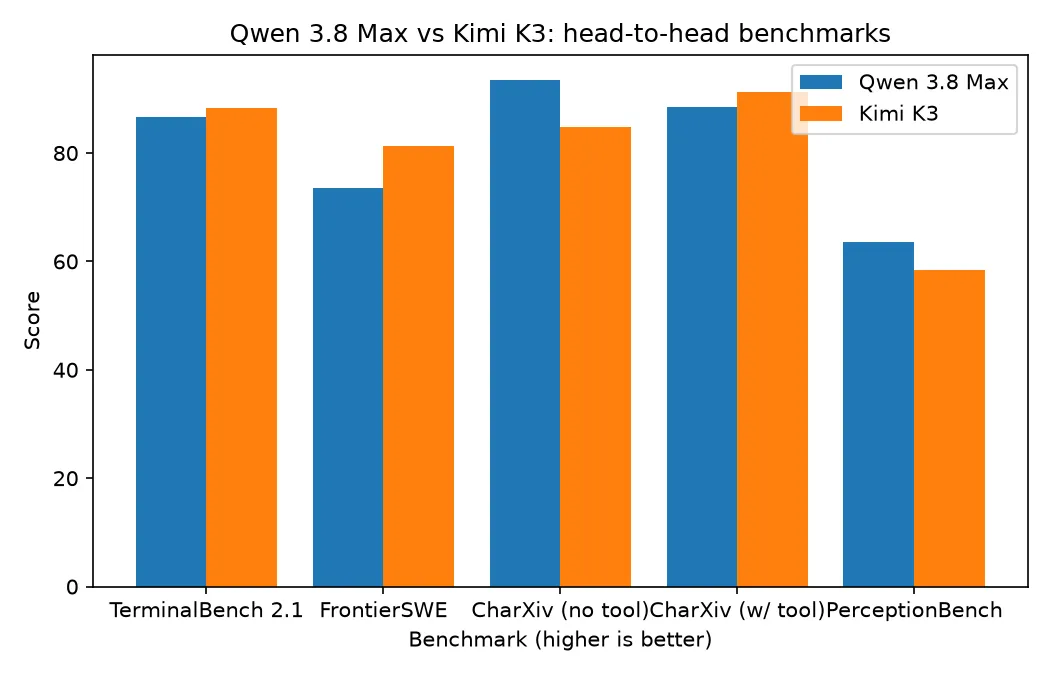
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv (con herramienta) | 88.4 | 91.3 |
Fuente: comparativa cara a cara de yottalabs, verificada el 6 de agosto de 2026.
La opinión de la comunidad encaja con las cifras, aunque con la salvedad de coste que define esta comparativa:
"K3 es de otro nivel. Qwen 3.8 es bastante parecido. Sin embargo, ni la suscripción ni los costes de API están justificados para ninguno de los modelos tal como están…" — r/Qwen_AI
"K3 supera con mucha diferencia a Qwen 3.8 en este ejercicio; Qwen fue 3 veces más rápido que Kimi al generar esta landing page." — @filicroval en X
Kimi K3 también obtiene una puntuación bruta de inteligencia más alta: 57 en el Artificial Analysis Intelligence Index. Sin embargo, es lento: ronda los 39 tokens de salida por segundo y tarda 3.1 segundos en generar el primer token (Artificial Analysis). El intercambio es calidad y apertura a cambio de latencia y coste.
Qwen 3.8 Max gana en multimodalidad y coste
Qwen 3.8 Max encaja mejor cuando la carga de trabajo depende de leer gráficos, capturas de pantalla o controlar un navegador, y cuando el coste de salida importa más que arañar unos puntos extra en un benchmark de programación. Supera a Kimi K3 en pruebas de documentos y percepción, mantiene un estado del arte verificado en un benchmark de uso de ordenador y cobra el 40% de la tarifa de salida de Kimi K3.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv (sin herramienta) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | sin puntuación pública |
Fuente: comparativa cara a cara de yottalabs, verificada el 6 de agosto de 2026.
El punto débil de Qwen 3.8 Max está justamente donde Kimi K3 es más fuerte y donde compite con los modelos cerrados de frontera. En SWE-bench Pro obtiene 67.7, muy por detrás del 80 de Claude Fable 5 (tabla publicada por Alibaba, ejecutada por el proveedor), así que no es el modelo para las evaluaciones de ingeniería de software más exigentes. Además, su API tenía solo tres días de vida al escribir estas líneas —la disponibilidad general llegó el 3 de agosto de 2026— y sus pesos siguen cerrados (consulta los detalles de acceso anteriores). Quien necesite autoalojarlo hoy tendrá que esperar o elegir Kimi K3.
Qué modelo elegir según la carga de trabajo
La elección correcta depende menos de qué modelo sea objetivamente superior que del tipo de tarea para el que lo vas a llamar. Esta tabla relaciona las cargas de trabajo más habituales con una recomendación y el motivo verificado.
| Si tu carga de trabajo es… | Elige | Motivo |
|---|---|---|
| Bucles de agentes, refactorizaciones de repositorios, tareas SWE (el coste no es la limitación) | Kimi K3 | FrontierSWE 81.2 frente a 73.5, TerminalBench 88.3 frente a 86.6 |
| Análisis de documentos/gráficos, navegador o uso de ordenador, sensibilidad al coste | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, $6 frente a $15 de salida |
| Autoalojamiento hoy | Kimi K3 | Pesos en HF desde el 27 de julio; los de Qwen llegarán ~11 de agosto |
Preguntas frecuentes
¿Qwen 3.8 Max es mejor que Kimi K3 para programar?
No. Kimi K3 lidera los benchmarks de programación agéntica relevantes (FrontierSWE 81.2 frente a 73.5, TerminalBench 2.1 88.3 frente a 86.6), por lo que es la opción más sólida para tareas de ingeniería de varios pasos.
¿Cuál es más barato, Qwen 3.8 Max o Kimi K3?
Qwen 3.8 Max. Cobra $6 por millón de tokens de salida frente a los $15 de Kimi K3, y $2 de entrada frente a $3, con precios similares para los aciertos de caché. En una carga de programación típica, la diferencia es de aproximadamente 2×.
¿Cuál es más barato para programación agéntica con razonamiento al máximo?
Qwen 3.8 Max sigue siendo más barato: ambos modelos facturan los tokens de razonamiento como salida al máximo esfuerzo, por lo que la tarifa de $15/M de Kimi K3 amplía la brecha precisamente en la carga de programación donde obtiene mejores resultados.
¿Ambos modelos admiten un contexto de un millón de tokens?
Sí. Qwen 3.8 Max acepta aproximadamente 991K tokens de entrada, menos cuando thinking está activado, y Kimi K3 admite 1,048,576. Ambos tienen nominalmente ventanas de un millón de tokens.
¿Los pesos son abiertos?
Los de Kimi K3 sí. Moonshot publicó el checkpoint MXFP4 de 1.56 TB el 27 de julio de 2026. Los de Qwen 3.8 Max todavía no: Alibaba los lista como cerrados, con lanzamiento previsto en Hugging Face y ModelScope durante la semana del 11 de agosto.
Lecturas relacionadas
- Página del modelo Kimi K3: análisis centrado exclusivamente en Kimi K3
- Precios de la API de Qwen 3.8 Max: desglose completo de precios y aspectos técnicos de Qwen 3.8 Max
- Qwen3.8-27B: la versión más pequeña de Qwen 3.8 con pesos abiertos para autoalojamiento
- Kimi K2.7 Code vs GLM 5.2: una comparativa relacionada dentro del mismo grupo de modelos de programación