 AIREITER
Descargar 17GB no significa que vayas a tener un agente local ágil y cómodo de usar. Qwen3.8-27B es un modelo open-weight competente bajo licencia Apache-2.0, pero su razonamiento extraalto predeterminado puede convertir una tarea rápida en una espera larga si la cuantización, el presupuesto de contexto y el servidor no encajan con tu equipo.
¿Merece la pena ejecutar Qwen3.8-27B en local?
Qwen3.8-27B merece la pena en local para desarrolladores con unos 24GB de GPU o memoria unificada disponibles, que valoren mantener los datos bajo su control y puedan aceptar respuestas interactivas más lentas que las de una API alojada rápida. Su principal atractivo no es un único benchmark: es un modelo denso con licencia Apache-2.0, entrada de imagen y vídeo, 262.144 tokens de contexto nativo y razonamiento configurable en un tamaño desplegable. La tarjeta oficial de Qwen indica que se lanzó el 14 de agosto de 2026.
No conviene tratarlo como un sustituto automático de cualquier modelo vía API. Los resultados oficiales los comunica el propio proveedor, las cuantizaciones agresivas alteran tanto la calidad como la velocidad, y el razonamiento xhigh predeterminado es un mal punto de partida para muchas tareas interactivas locales.
Calcula primero la memoria; los benchmarks vienen después
Qwen3.8-27B es un modelo denso: cada token generado activa el modelo completo. Por eso el ancho de banda de memoria, la caché KV, la cuantización y el contexto solicitado pesan mucho más de lo que sugiere el tamaño del archivo de pesos. La tarjeta de Qwen documenta un contexto nativo de 262K, pero una sesión local puede configurarse muy por debajo de esa cifra para conservar memoria y velocidad utilizables. Los ejemplos de servicio de Qwen muestran el máximo de 262.144 tokens; es un límite de capacidad, no un valor predeterminado sensato para cualquier equipo de consumo.
| Memoria disponible | Punto de partida práctico | Qué esperar | Recomendación |
|---|---|---|---|
| 12GB | Cuantización agresiva de clase Q3 más descarga a CPU/RAM | Contexto corto y concesiones importantes en latencia | Elige un modelo más pequeño salvo que el objetivo sea experimentar en local |
| 16GB | Q3 agresivo o una cuantización tipo Q4 elegida con cuidado | Viable para tareas cortas y supervisadas; el contexto y la velocidad quedan limitados | Pruébalo antes de comprometerte con un flujo de agentes |
| 24GB | Cuantización de clase Q4 | El punto de entrada práctico para programación, herramientas y contexto moderado | La mejor opción para la mayoría de usuarios locales de Qwen3.8-27B |
| 32GB+ | Cuantización de mayor calidad o más margen para contexto | Menos compromisos con la caché KV y las sesiones largas | Prioriza este nivel para trabajo sostenido con agentes |
Son recomendaciones operativas, no mínimos oficiales del proveedor. Usuarios independientes cuentan que una RTX 3060 de 12GB puede ejecutar una compilación local y manejar llamadas a herramientas, mientras otros advierten de que un agente denso con esa VRAM rinde mal; esa discrepancia explica exactamente por qué no hay que confundir «puede cargar» con «funciona bien». Consulta la conversación de usuarios reales en r/LLM.
Una tarjeta de 24GB es el mínimo para un flujo de trabajo cómodo a 4 bits, no una garantía de comodidad con contexto largo. Un análisis centrado en despliegue estima entre 17 y 19GB de memoria total a 4 bits, pero también advierte de que la caché KV crece deprisa durante sesiones largas de agentes. El análisis de despliegue local de Neoteric sirve para planificar, no es una especificación oficial de hardware.
Por qué la configuración predeterminada puede hacer que Qwen3.8-27B parezca inutilizable
Qwen3.8-27B activa el razonamiento de forma predeterminada. La tarjeta oficial expone valores de reasoning_effort como xhigh, medium y low, además de enable_thinking=False para peticiones sin razonamiento; también habilita preserve_thinking por defecto. La sección de buenas prácticas de Qwen advierte de que reducir el esfuerzo de razonamiento no siempre disminuye el tiempo total de una tarea, pero un ajuste alto sigue siendo un valor predeterminado caro para trabajo trivial.
La prueba local de Simon Willison ilustra bien la diferencia. Con una compilación Q4_K_M en LM Studio, cuenta que una primera tarea de SVG consumió 22.276 tokens de razonamiento y tardó 21 minutos con la configuración predeterminada; al desactivar el razonamiento obtuvo un resultado distinto en 137 segundos. Su equipo de prueba no es un benchmark universal, pero deja muy claro el riesgo de configuración. Lee la prueba completa y las transcripciones.
«Esperaba que estuviera más o menos al nivel de 3.6 35b, pero más lento por la cuantización tan agresiva; al final terminó arrasándolo en todas partes». u/AltruisticList6000, r/LocalLLaMA, sobre un experimento Q3 con una RTX 4060 Ti de 16GB.
Ese resultado positivo no elimina las concesiones. Otro informe de un usuario real describe un contexto limitado a 32K y una sesión de agente que se volvió poco fiable, mientras que otro recomienda instrucciones claras y atómicas para programar en local. Aquí está el debate sobre el flujo de trabajo.
Qué ofrece oficialmente Qwen3.8-27B
Qwen3.8-27B es un modelo denso nativo de visión y lenguaje, no un modelo MoE. La tarjeta oficial describe entrada de texto, imagen y vídeo; 64 capas; una dimensión oculta de 5.120; 262.144 tokens de contexto nativo; y licencia Apache-2.0. También documenta una extensión basada en YaRN de hasta 1M de tokens, con la advertencia explícita de que YaRN estático puede perjudicar el rendimiento en textos cortos. Las especificaciones oficiales y la guía sobre contexto deben prevalecer sobre los resúmenes de lanzamiento de terceros.
El repositorio oficial menciona Transformers, vLLM, SGLang, TokenSpeed y rutas locales cuantizadas como llama.cpp, Ollama y LM Studio. La compatibilidad del runner importa porque el modelo emplea una arquitectura híbrida de Gated DeltaNet y Gated Attention; actualiza el runner antes de diagnosticar un fallo del modelo. El repositorio de inicio rápido de Qwen incluye ejemplos de servicio compatibles con OpenAI.
Qué demuestran —y qué no— los benchmarks publicados
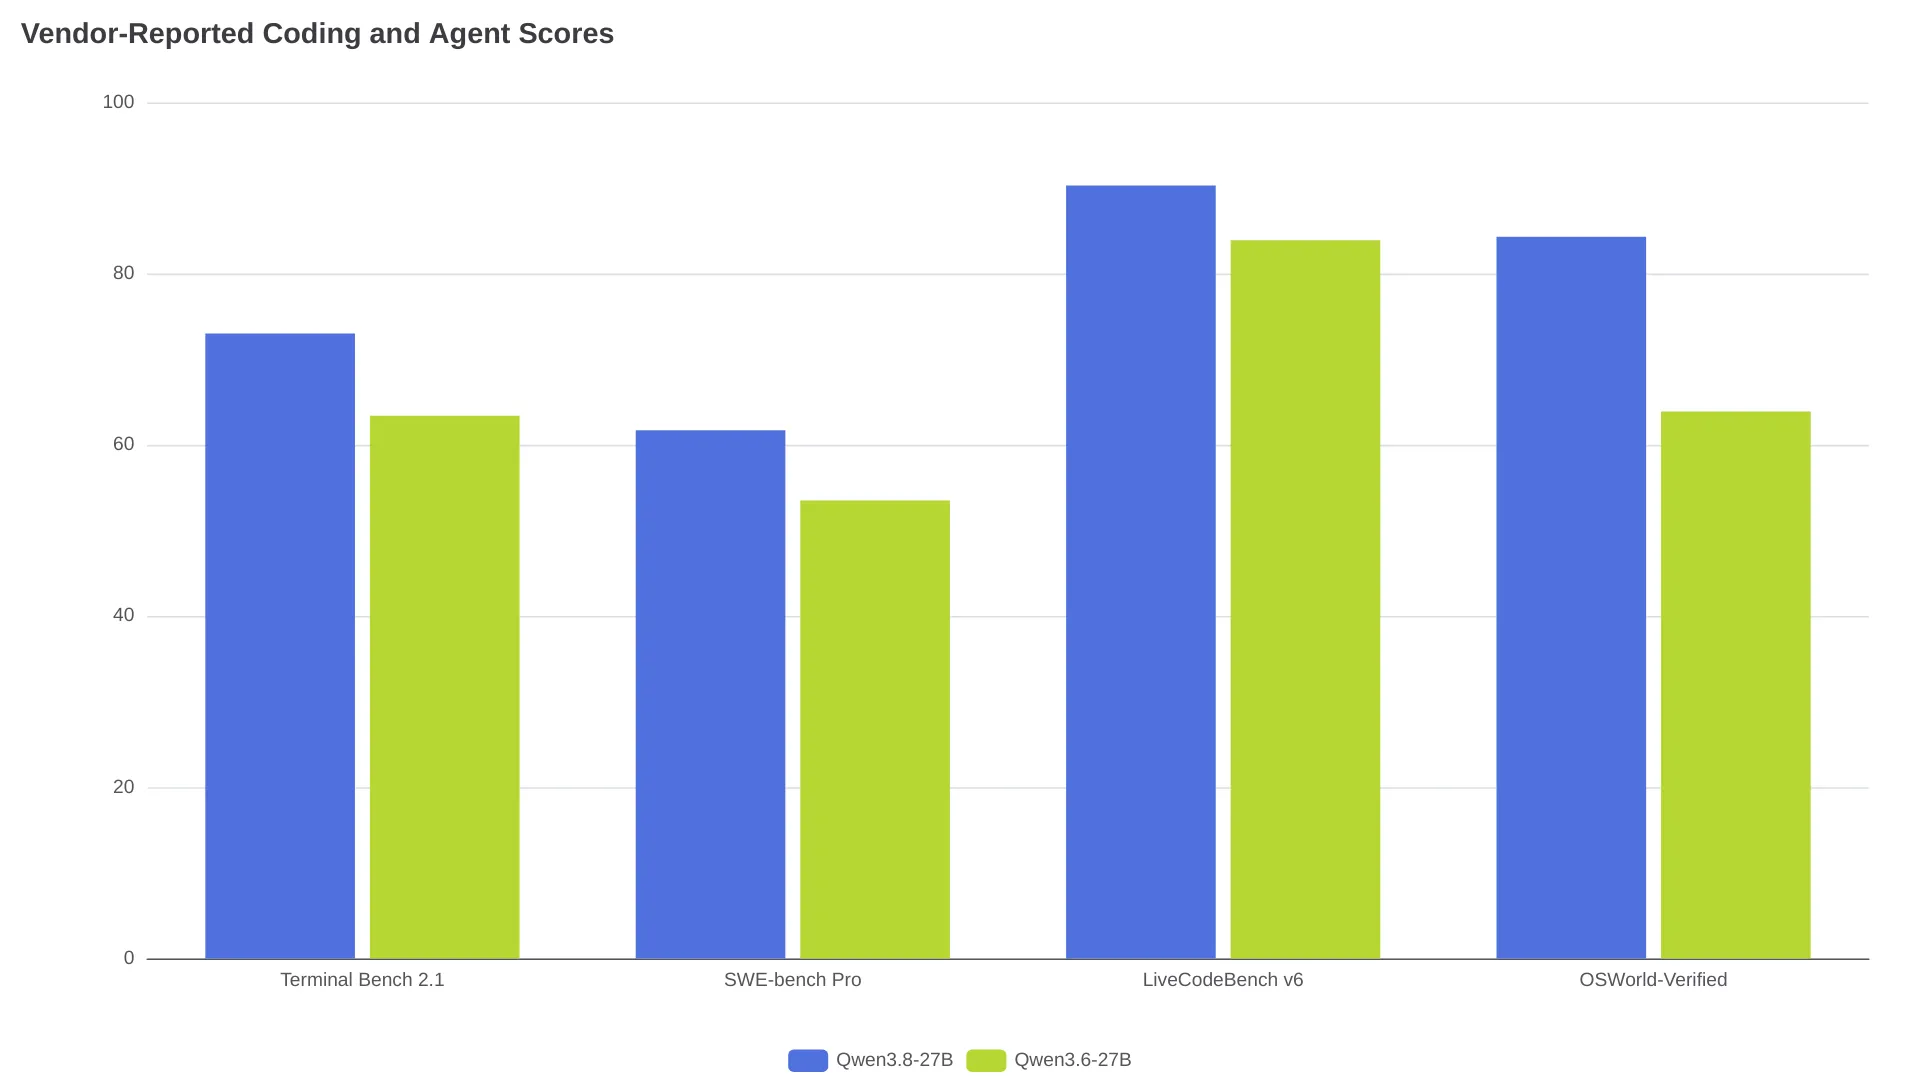
Qwen comunica mejoras relevantes frente a Qwen3.6-27B en evaluaciones de programación y uso de ordenador. El gráfico muestra cuatro puntuaciones comunicadas por el proveedor en la tarjeta oficial del modelo, no resultados reproducidos de forma independiente.
| Benchmark oficial | Qwen3.8-27B | Qwen3.6-27B | Cómo interpretarlo |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Indicador de programación en terminal con agentes |
| SWE-bench Pro | 61.7 | 53.5 | Indicador de resolución de incidencias en repositorios |
| LiveCodeBench v6 | 90.3 | 83.9 | Indicador de evaluación de programación |
| OSWorld-Verified | 84.3 | 63.9 | Indicador de uso de ordenador |
La tarjeta del modelo publica la comparación completa y la metodología. Para SWE-bench Pro y DeepSWE 1.1, Qwen afirma haber usado un harness de Claude Code con temperature=1.0, top_p=0.95 y 256K de contexto; también incluye benchmarks internos como QwenSWEBench. Revisa la metodología antes de comparar modelos. Estas cifras respaldan que es «una mejora oficial sustancial frente a Qwen3.6-27B», no que sea «un sustituto universal demostrado de una API de frontera».
Una primera configuración local con sentido
El primer despliegue local debería priorizar un comportamiento predecible frente al razonamiento máximo. Usa un runner actualizado, empieza con una cuantización de clase Q4 en hardware de la clase de 24GB, fija un límite de contexto deliberadamente moderado y prueba tareas cortas con agentes antes de permitir bucles autónomos largos.
- Inicia un servidor compatible con OpenAI mediante un motor compatible como vLLM o SGLang. Qwen publica ejemplos con
Qwen/Qwen3.8-27B,--reasoning-parser qwen3y--tool-call-parser qwen3_coder. Los comandos oficiales están en el repositorio. - Para clasificación, extracción o ediciones rápidas de código, usa
enable_thinking=False. Qwen recomienda para el modo sin razonamientotemperature=0.7,top_p=0.80ypresence_penalty=1.5. Consulta el ejemplo oficial de API. - Para depuración que requiera razonamiento, prueba
lowomediumantes dexhigh, y compara el tiempo total hasta completar la tarea y la calidad de las llamadas a herramientas en un caso real. - Desactiva el razonamiento preservado cuando cada tarea sea independiente. Consérvalo solo si el contexto de razonamiento multivuelta compensa la presión adicional sobre la caché KV.
- Antes de usarlo sin supervisión, prueba las llamadas a herramientas, el cumplimiento del esquema de salida y un cambio de contexto. Un modelo que escribe buen código en un prompt puede fallar igualmente en un bucle de agente prolongado.
Cuándo Qwen3.8-27B no es una buena elección local
Qwen3.8-27B no es la primera opción adecuada cuando 12GB o menos son un límite estricto, cuando la latencia de respuesta importa más que el control local o cuando un agente debe ejecutarse sin supervisión y cumplir formatos estrictos. Puede funcionar en configuraciones limitadas, pero eso no equivale a ofrecer un rendimiento interactivo fiable ni contexto suficiente para trabajar con repositorios.
Pruebas independientes también detectan tendencia a respuestas largas, latencia elevada en la cola de distribución y cumplimiento imperfecto de instrucciones estrictas. Una evaluación estructurada registró 4 tiempos de espera agotados en 49 pruebas y un tiempo de respuesta P95 de 143,32 segundos en la configuración de su estación de trabajo. Esas cifras no son garantías de rendimiento trasladables, pero sí una advertencia útil contra tratar un modelo local de 27B como un componente de automatización sin revisión. El informe de pruebas de CrucibleMark detalla la configuración y sus limitaciones.
Preguntas frecuentes sobre Qwen3.8-27B
¿Qwen3.8-27B se ha lanzado oficialmente?
Sí. El repositorio oficial de Qwen sitúa el lanzamiento de Qwen3.8-27B en Hugging Face Hub y ModelScope el 14 de agosto de 2026. La cronología de lanzamientos de Qwen es la fuente principal.
¿Puede Qwen3.8-27B ejecutarse en una GPU de 16GB?
Una configuración muy cuantizada y de contexto corto puede ejecutarse, pero será un despliegue limitado. Los informes de usuarios reales van desde resultados prometedores con Q3 en una RTX 4060 Ti de 16GB hasta advertencias de que el uso de agentes densos con poca VRAM implica importantes concesiones de velocidad y calidad. Debate en LocalLLaMA.
¿Qwen3.8-27B tiene una ventana de contexto de 1M de tokens?
Tiene 262.144 tokens de contexto nativo. La tarjeta del modelo describe un contexto de 1M mediante escalado YaRN/RoPE y advierte de que YaRN estático puede reducir el rendimiento con textos cortos. Documentación oficial sobre contexto.
¿Cómo desactivo el razonamiento de Qwen3.8-27B?
Configura enable_thinking=False en la petición de API, tal como muestra la tarjeta de Qwen. Para tareas que necesiten razonamiento, empieza con low o medium en lugar de asumir que xhigh es adecuado. Ejemplo oficial sin razonamiento.
¿Deberían actualizar los usuarios de Qwen3.6-27B?
Actualiza si el hardware actual ya admite la misma clase de despliegue y el flujo de trabajo se beneficia de las mejoras en programación, uso de ordenador o capacidades multimodales. Mantén Qwen3.6-27B si el stack actual es estable y todavía no has validado el nuevo runner, la cuantización o el comportamiento de razonamiento en el flujo de trabajo real.
Elige según la limitación que no puedes cambiar
| Limitación | Siguiente paso recomendado |
|---|---|
| Gestión local de datos y 24GB disponibles | Ejecuta Qwen3.8-27B en Q4; empieza con razonamiento bajo o desactivado |
| Solo 12GB a 16GB | Prueba una compilación tipo Q3 para tareas cortas supervisadas o elige un modelo más pequeño |
| Sesiones largas de agentes sobre repositorios | Reserva margen de 32GB+ y valida el comportamiento de la caché KV antes de adoptarlo |
| Respuestas interactivas rápidas | Usa una API alojada o un modelo local más pequeño |
| Formato estricto o publicación sin supervisión | Mantén una capa de validación y revisión humana; no dependas solo del cumplimiento del modelo |
Qwen3.8-27B amplía lo que puede intentar un modelo local desplegable de 27B. No elimina el trabajo de sistemas: elige la cuantización según el hardware, controla el razonamiento de forma deliberada y evalúa el modelo con un flujo de trabajo representativo, no por el tamaño de la descarga.