 AIREITER
MuseTalk puede ejecutarse en la GPU de 4 GB de un portátil: el README oficial registra unos cinco minutos para un clip de ocho segundos en una RTX 3050 Ti Laptop usando FP16. La diferencia entre «funciona» y «funciona lo bastante rápido» es el verdadero punto de decisión con MuseTalk lipsync, y vuelve a aparecer al hablar de resolución, instalación y costes.
Qué cambia MuseTalk en el vídeo y qué deja intacto
MuseTalk repinta la boca y la parte inferior del rostro de un vídeo existente para que los labios encajen con una pista de audio. La posición de la cabeza, el movimiento de los ojos, la expresión facial, el fondo y el movimiento de cámara se conservan tal como estaban en el original. No es un generador de personas hablando: necesitas partir de un vídeo en el que el rostro se vea con claridad.
La velocidad viene de su arquitectura. El repositorio, publicado por Lyra Lab de Tencent Music, codifica el rostro enmascarado con un VAE sd-vae-ft-mse congelado, extrae las características del audio con un modelo Whisper-tiny también congelado y combina ambas señales mediante atención cruzada en una UNet basada en Stable Diffusion v1.4. En lugar de usar un bucle iterativo de eliminación de ruido, realiza inpainting en el espacio latente en un solo paso. Así es como sus autores aseguran alcanzar 30 fps o más en una NVIDIA Tesla V100.
Qué implica la región facial de 256x256 en un vídeo fuente a 1080p
La cifra de 256x256 corresponde al tamaño de la región facial editable, no a la resolución final. Tu clip a 1080p sigue saliendo a 1080p y conserva su frecuencia de fotogramas; lo que se regenera y se vuelve a integrar sobre la zona de la boca es un parche de 256x256. Por eso el resultado aguanta mejor cuanto más grande aparezca el rostro en el encuadre. En un primer plano cerrado, la suavidad del parche se nota enseguida frente al resto de la cara, que permanece nítida.
Hay dos formas de paliarlo, aunque ambas tienen un coste. Quitar --use_float16 mejora la calidad, pero exige más VRAM y alarga los tiempos de ejecución. Pasar el clip terminado por GFPGAN o CodeFormer para restauración facial puede definir mejor la zona de la boca, a cambio de añadir otra fase de procesamiento y modificar sutilmente el aspecto de la persona.
La calidad en cifras: dónde gana MuseTalk y dónde sigue por delante Wav2Lip
La principal ventaja declarada de MuseTalk está en la calidad de imagen, no en la precisión bruta de la sincronización. En el conjunto de datos HDTF, el informe técnico de MuseTalk le asigna un FID de 6.43, frente a 7.27 de DI-Net, 10.93 de VideoRetalking y 11.21 de Wav2Lip.
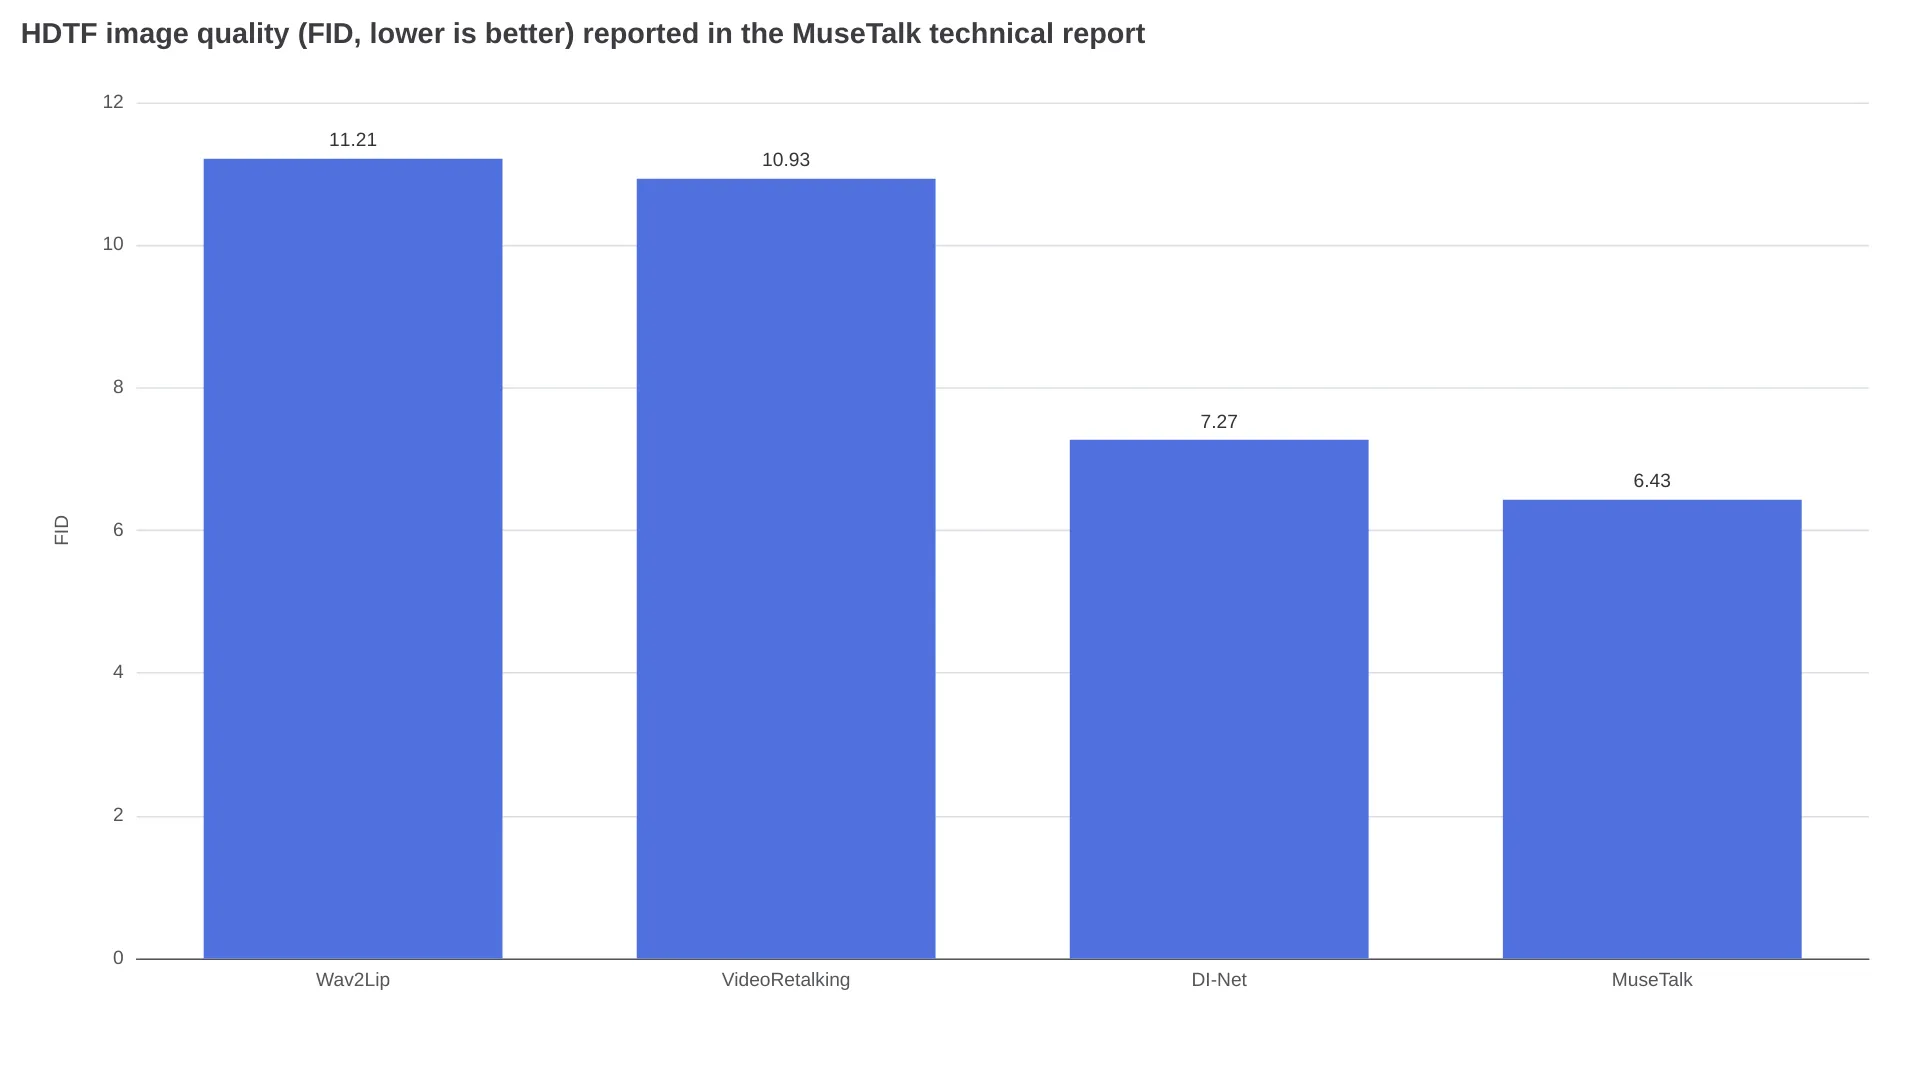
Si cambiamos a la métrica de sincronización, el orden se invierte. El mismo informe da a Wav2Lip un LSE-C de 7.46 frente al 6.53 de MuseTalk. MuseTalk, en cambio, queda ligeramente por delante en similitud de identidad: CSIM de 0.8225 frente a 0.8184. En resumen: el modelo GAN más antiguo sigue el movimiento de los labios algo mejor, mientras MuseTalk conserva mejor la calidad visual. El estudio de usuarios del propio informe arroja cifras moderadas en todos los apartados: 3.62 sobre 5 en calidad visual, 3.55 en identidad y 3.41 en sincronización labial.
Vistos junto al techo de 256x256, esos datos describen un modelo convincente para planos medios, no una solución capaz de salir airosa de un primer plano en 4K.
Cuánto cuesta un minuto de sincronización labial
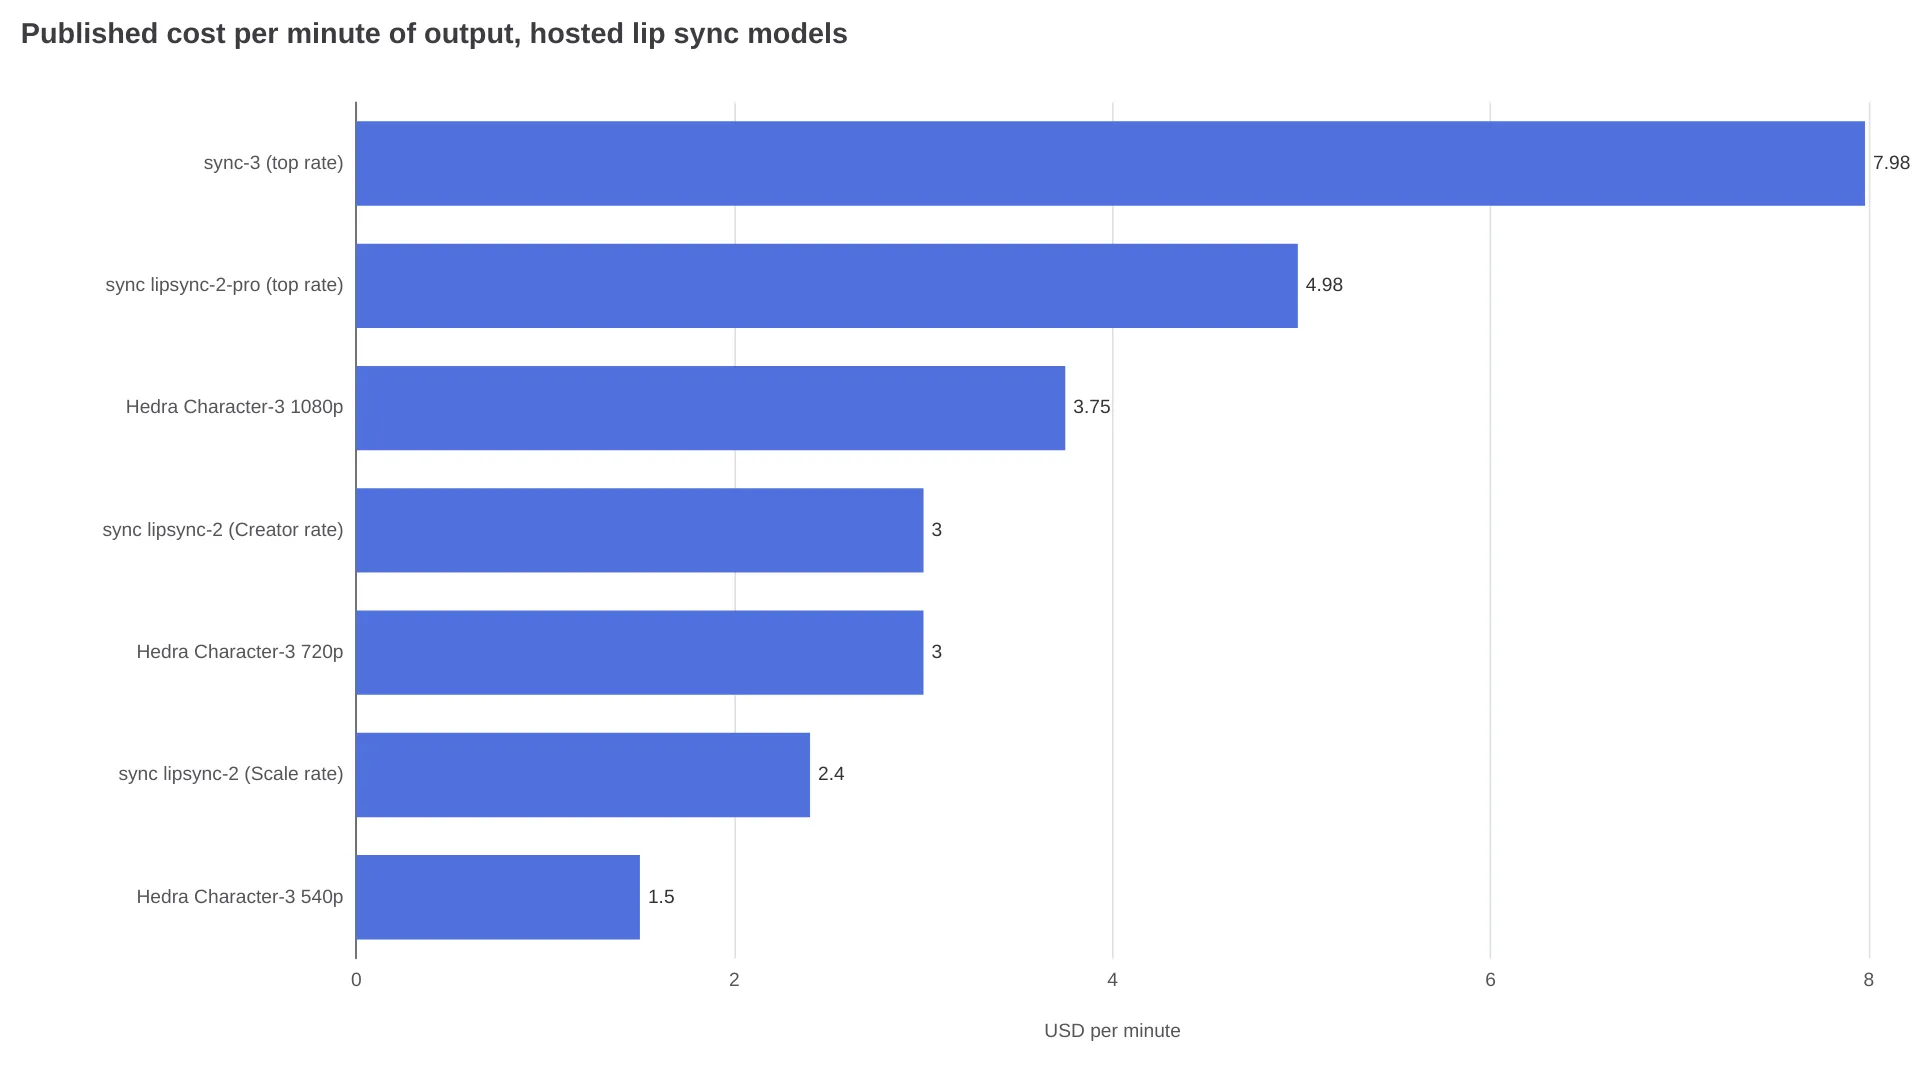
Aquí es donde la vía de código abierto empieza a resultar especialmente atractiva. Las tarifas publicadas para modelos de lip sync alojados se mueven entre 1,50 y casi 8,00 dólares por minuto de salida.
| Vía | Tarifa publicada (las unidades de facturación varían) | Por minuto de salida | Resolución facial |
|---|---|---|---|
| MuseTalk autoalojado, alquiler de una Tesla V100 | 0,188 $ / hora de GPU | ~0,006 $ con 2 minutos de GPU por minuto de clip | 256x256 |
| MuseTalk en Replicate | ~0,052 $ / ejecución, 54 s de tiempo típico según la página del modelo | Se factura por ejecución, no por minuto | 256x256 |
| MuseTalk en fal.ai | Se factura por segundo de cómputo | No publicado en la página del modelo | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — imagen a vídeo, no es un sustituto directo para metraje existente | 2,5 céntimos / 5 céntimos / 6,25 céntimos por segundo | 1,50 $ / 3,00 $ / 3,75 $ | n/a |
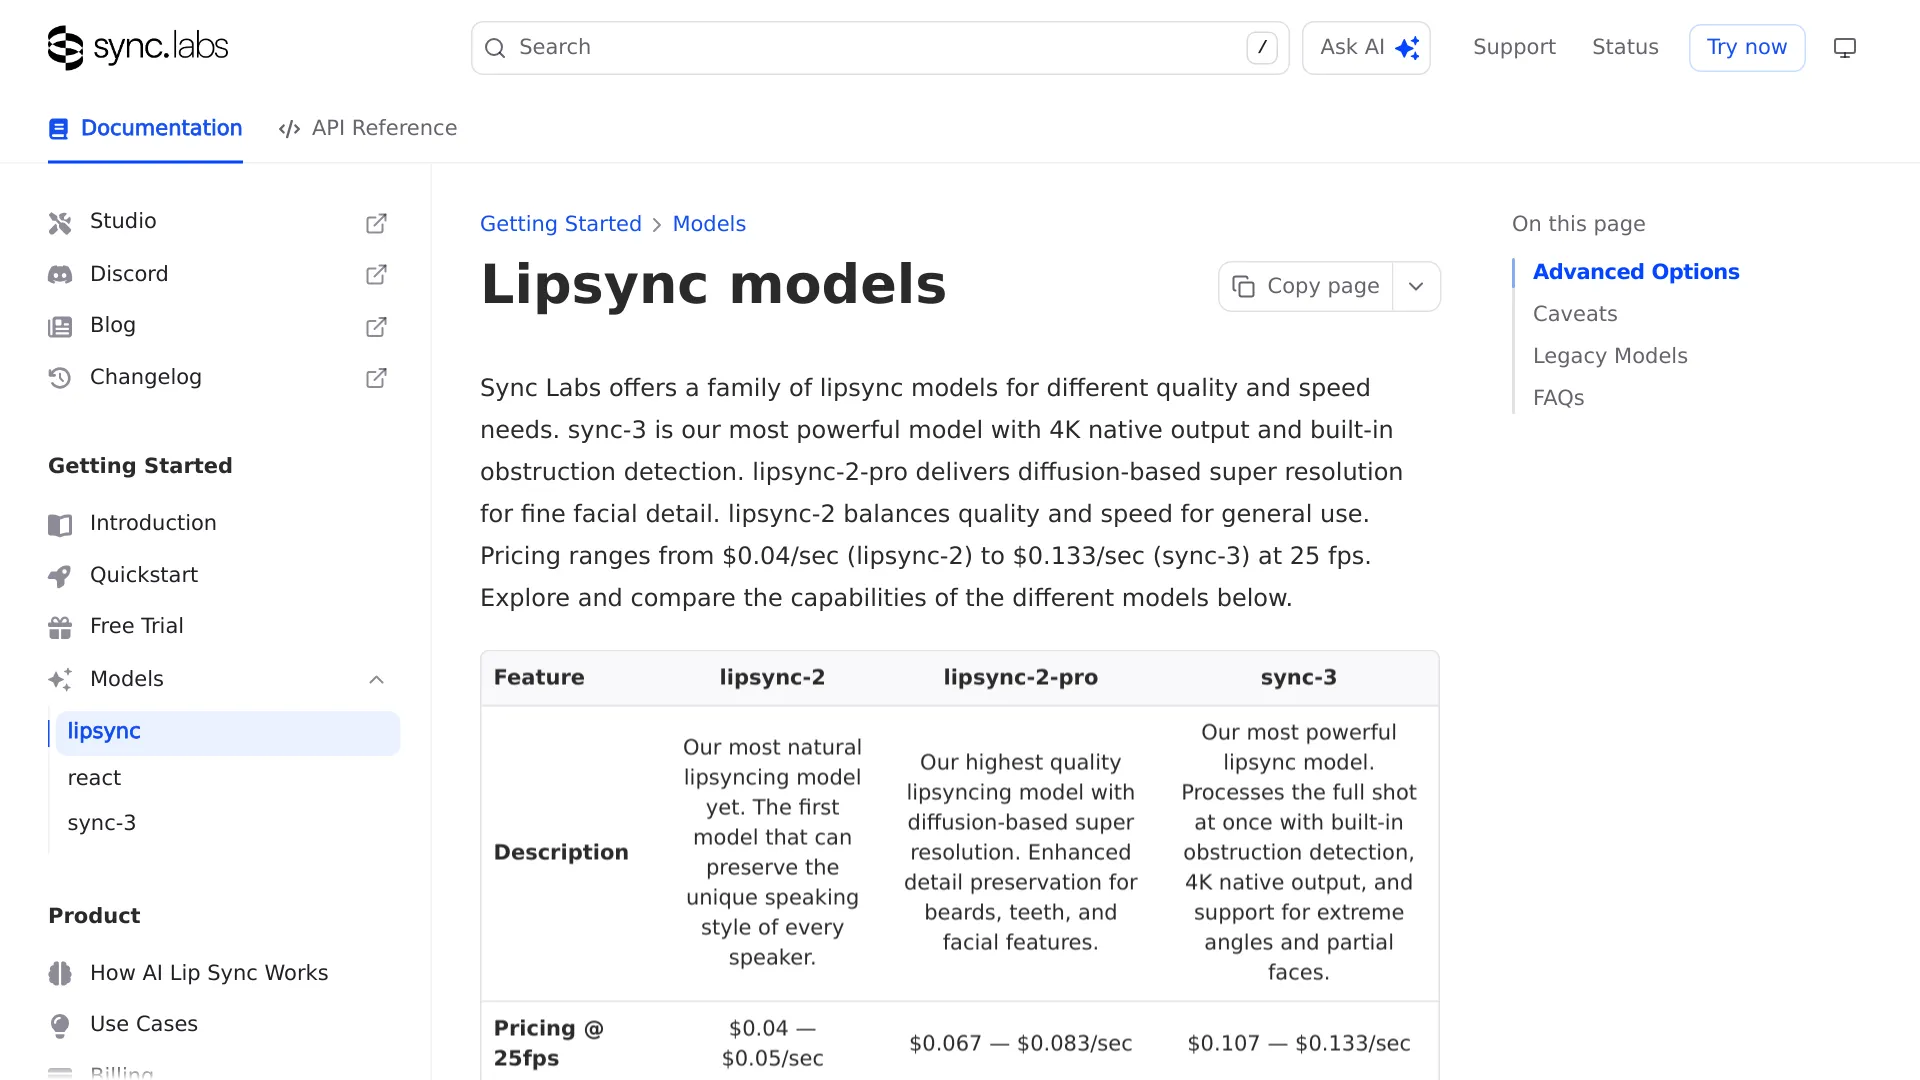
| sync lipsync-2 | 0,04–0,05 $ / s a 25 fps | 2,40–3,00 $ | 512x512 |
| sync lipsync-2-pro | 0,067–0,083 $ / s | 4,02–4,98 $ | 512x512 + pasada de detalle |
| sync-3 | 0,107–0,133 $ / s | 6,42–7,98 $ | 4K nativo |
La cifra del autoalojamiento procede del desglose de costes de NexGPU, que calcula dos minutos de tiempo total de GPU por cada minuto de clip: inferencia, detección con DWPose, codificación y decodificación del VAE y multiplexado con FFmpeg. Cien clips de un minuto suponen aproximadamente 0,63 $ de cómputo en una V100 a 0,188 $ por hora, más unos 0,09 $ de tiempo de configuración. Son únicamente costes de alquiler de GPU: no incluyen horas de ingeniería, almacenamiento ni gastos operativos.
Cuando lo llevas a una cola de localización, la diferencia se dispara. Quinientos minutos de vídeo doblado cuestan aproximadamente 3 $ de alquiler de GPU con MuseTalk autoalojado, frente a 1.200 $ con sync lipsync-2 a la tarifa Creator.
Cuándo deja de ser gratis la opción gratuita
La cuota adicional por minuto compra cosas muy concretas:
- Resolución de generación facial. Según la documentación de modelos de sync, lipsync-2 y lipsync-2-pro generan rostros a 512x512, el doble que la región de MuseTalk; sync-3 produce 4K de forma nativa e incorpora superresolución.
- Planos difíciles. La misma documentación indica que sync-3 gestiona de forma nativa perfiles, encuadres sobre el hombro y rostros parcialmente visibles, además de detectar obstrucciones automáticamente. MuseTalk detecta el rostro en cada fotograma, por lo que una cara girada o una mano delante de la boca son puntos de fallo documentados.
- Vídeos con varias personas. Los tres modelos actuales de sync incluyen detección del hablante activo como opción; MuseTalk no ofrece un parámetro equivalente.
- Tiempo de configuración. En un despliegue autoalojado lo pagas una sola vez, pero no es un coste pequeño.
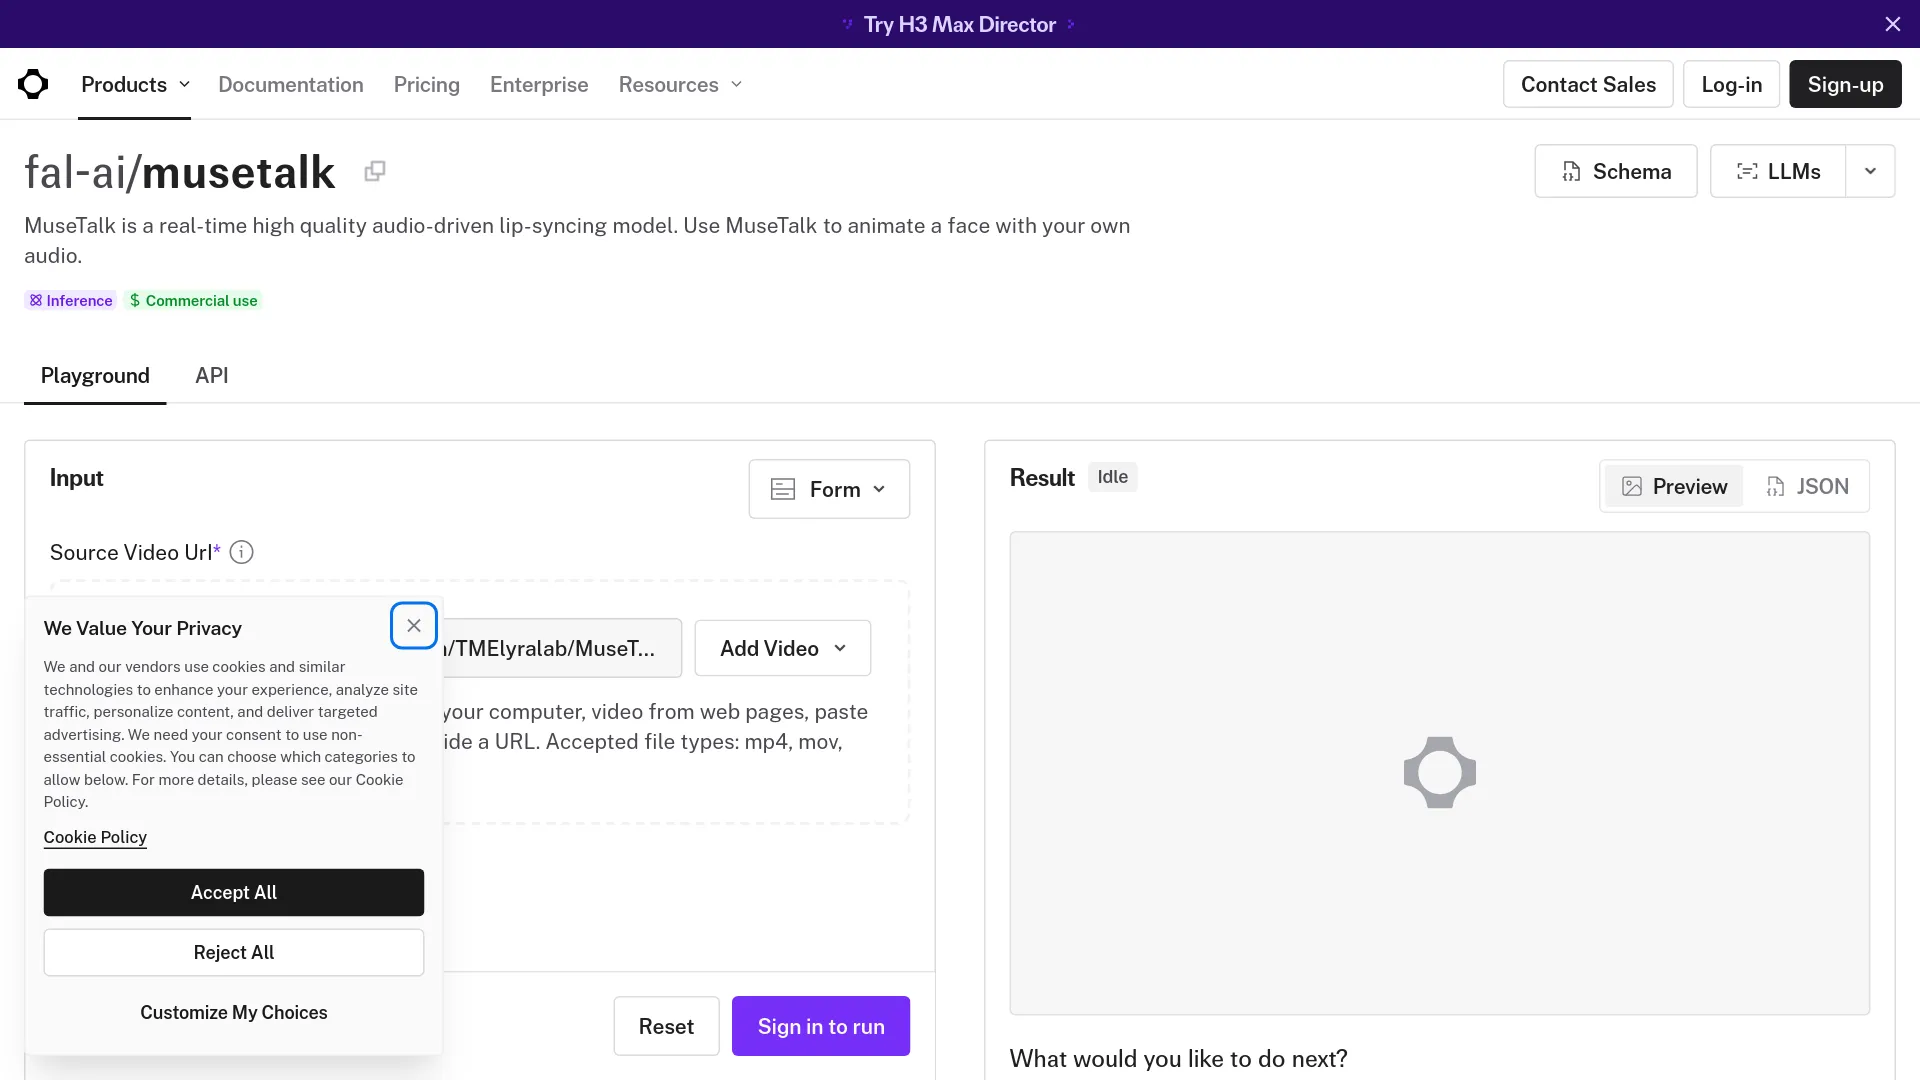
La página de MuseTalk en fal.ai deja claro qué compras con ese último punto: una URL de vídeo, una URL de audio y nada más. No hay entorno conda, versiones fijadas de CUDA ni árbol de pesos que preparar.
Cómo poner MuseTalk en marcha sin pelearte con las dependencias
Una queja habitual entre quienes han ejecutado el modelo no tiene que ver con la calidad de salida, sino con el stack de OpenMMLab. En r/StableDiffusion, un usuario que comparó modelos de lip sync lo resumió así después de probar MuseTalk y LatentSync:
«LatentSync y Musetalk funcionan y tienen un rendimiento parecido... Musetalk es complicado de configurar porque depende de las bibliotecas de OpenMMLab». — u/Traditional_Tap1708, r/StableDiffusion
Instala las versiones fijadas del README mediante mim, no con pip directamente:
- Python 3.10 en un entorno conda nuevo, con PyTorch 2.0.1, torchvision 0.15.2 y torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Una versión más reciente de mmcv es la causa habitual de los errores de importación de mmdet.- FFmpeg en el
PATH, comprobado conffmpeg -version, o indicado explícitamente mediante--ffmpeg_pathen Windows. sh download_weights.shpara descargar todo el árbol. La UNet por sí sola no basta: el script también obtiene sd-vae-ft-mse, Whisper,dw-ll_ucoco_384.pthde DWPose y los pesos de segmentación facial de BiSeNet. Si falta un archivo, el problema suele aparecer como un fallo de detección facial o de composición, no como un error claro.- Convierte la fuente a 25 fps con
ffmpeg -i input.mp4 -r 25 output.mp4. El repositorio recomienda entradas a 25 fps porque esa es la frecuencia con la que se entrenó el modelo, y una discrepancia suele ser la causa del desfase de sincronización. - Indica tu vídeo y audio en
configs/inference/test.yamly ejecutapython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Si vas a generar varias veces con el mismo rostro, establece preparation: true una vez en configs/inference/realtime.yaml para que guarde en caché coords.pkl, latents.pt y el conjunto de máscaras en results/v15/avatars/; después vuelve a ponerlo en false. Añadir --skip_save_images es más importante de lo que parece: escribir los PNG en disco puede convertirse en el cuello de botella, por delante del propio modelo.
MuseTalk 1.5 o 1.0: qué pesos descargar
Usa la 1.5. El repositorio la presenta como la versión más reciente, fechada el 28 de marzo de 2025, y atribuye su mayor claridad, consistencia de identidad y alineación entre labios y habla a sus pérdidas perceptual, GAN y de sincronización, además de al entrenamiento en dos etapas.
El único motivo para conservar la 1.0 es bbox_shift, que solo se aplica a esa versión. Este parámetro mueve verticalmente el límite de la máscara: los valores positivos abren más la boca y los negativos la cierran.
Ejecuta primero los valores predeterminados y el script mostrará el rango ajustable para tu clip. En el ejemplo del README, el rango obtenido es [-9, 9] y el valor elegido es -7. Vuelve a renderizar dentro del rango que te corresponda: usa valores más negativos si la boca parece exagerada y más positivos si apenas se abre.
Los fallos que encontrarás y cuáles se pueden corregir ajustando parámetros
| Síntoma | Causa | ¿Se puede corregir? |
|---|---|---|
| La ejecución se detiene sin detectar ningún rostro | Hay un fotograma con la cara girada, tapada o ausente | Sí. Recorta o elimina el segmento problemático |
| La boca apenas se mueve | La voz queda enterrada bajo la música o el límite de la máscara está demasiado alto | Sí. Aísla las voces; usa un bbox_shift positivo en v1.0 |
| Los labios pierden la sincronización a mitad del clip | La fuente no está a 25 fps | Sí. Convierte el vídeo antes de procesarlo |
| La boca queda borrosa frente a un rostro nítido | La cara ocupa demasiado poco espacio para la región de 256x256 | En parte. Recorta más, desactiva fp16 y añade restauración facial |
| Se ve una costura y no conserva el bigote | La síntesis de la parte inferior del rostro sustituye detalles de identidad | No. Es una limitación reconocida del modelo |
| Parpadeo entre fotogramas | Los fotogramas se generan de forma individual | En parte. El repositorio atribuye al entrenamiento en dos etapas de v1.5 una mayor consistencia |
| Falla con un rostro de dibujos animados o estilizado | La distribución de entrenamiento está compuesta por rostros reales | No |
| Audio enérgico con un hablante inmóvil | MuseTalk no modifica el movimiento de la cabeza ni la expresión | No. Hay que volver a grabar o cambiar el clip fuente |
Un usuario que hizo pruebas con poca VRAM informó de que MuseTalk tardaba «171 s para 7 segundos de audio» y añadió que «solo funciona con imágenes realistas» (u/Bartholomheow, r/StableDiffusion). La afirmación de «tiempo real», por su parte, describe el rendimiento sostenido después de preparar el avatar, no la latencia de extremo a extremo. Un desarrollador que estaba creando avatares parlantes en r/LocalLLaMA comentó que con MuseTalk «el tiempo de preparación es demasiado largo» (u/lonyPorgrammer) para su caso de uso interactivo.
Qué vía de lip sync encaja mejor con cada trabajo
| Vía | Elígela cuando | Principal inconveniente |
|---|---|---|
| MuseTalk autoalojado | Hay mucho volumen y el metraje es favorable: borradores de localización, avatares interactivos que reutilizan un mismo rostro en miles de clips de audio o vídeos internos de formación | La configuración se mide en horas, no en minutos; el rendimiento depende de la GPU que alquiles |
| MuseTalk alojado (Replicate, fal.ai) | Solo tienes unos pocos clips o quieres probar la calidad con tu propio material antes de comprometerte con un despliegue | Mantiene el techo de 256x256, ninguno de los dos esquemas de endpoint ofrece un parámetro de caché de avatar y se factura por ejecución |
| Modelo de lip sync de pago (sync-3, lipsync-2-pro) | Necesitas una entrega para clientes, primeros planos grandes, perfiles, obstrucciones, varios hablantes o salida en 4K | Entre 4 y 8 $ por minuto, y el metraje sale de tu infraestructura |
Alquila una V100 si quieres reproducir la cifra de rendimiento oficial, o una 4090 si vas a emitir en directo. Para la opción basada en endpoints alojados, analizamos ambas plataformas con más profundidad en nuestro análisis de Replicate y en el análisis de fal.ai.
Preguntas frecuentes sobre MuseTalk lipsync
¿Puede MuseTalk ejecutarse en una GPU de 6 u 8 GB?
Sí. El README documenta una RTX 3050 Ti de portátil con 4 GB ejecutando pruebas en FP16, así que la inferencia básica cabe en una cantidad limitada de VRAM. En la práctica, la principal restricción es el rendimiento.
¿256x256 es la resolución de salida?
No. Es la región facial editable, que se integra de nuevo en un vídeo que conserva la resolución y la frecuencia de fotogramas originales.
¿MuseTalk funciona con rostros de dibujos animados o anime?
No de forma fiable. El modelo se entrenó con metraje real de personas hablando, y los usuarios que han probado entradas estilizadas informan de resultados inconsistentes.
¿La cifra de «30 fps en tiempo real» incluye el preprocesamiento?
No. Describe el rendimiento de generación en una Tesla V100 después de preparar el avatar. La detección facial, la codificación latente y la primera fase de caché ocurren antes.
¿MuseTalk o LatentSync?
Elige MuseTalk cuando la latencia y el volumen sean lo más importante, ya que la inferencia en un solo paso y los avatares en caché eliminan buena parte del coste por clip. El usuario de r/StableDiffusion citado antes, que probó ambos, describió su rendimiento como similar. En ese caso, el factor decisivo es el rendimiento, no la fidelidad.
¿Se puede usar MuseTalk con fines comerciales?
El repositorio distribuye su código bajo licencia MIT, pero la cadena de dependencias no comparte una licencia uniforme. Whisper, el VAE, DWPose, el sistema de segmentación facial de BiSeNet y SyncNet tienen sus propias condiciones, y el repositorio señala restricciones separadas para los datos de ejemplo. Revísalas todas antes de poner el sistema en producción.
El equilibrio que este precio todavía no resuelve
MuseTalk te lleva muy lejos por prácticamente nada. Lo que no resuelve bien es conservar la identidad bajo presión: bigotes, la forma exacta de los labios, un rostro que llena el encuadre o un hablante que gira la cabeza a mitad de una frase.
Para la mayoría de los equipos, la respuesta no es una sola herramienta. Lo más sensato es usar MuseTalk para el volumen y reservar un modelo de pago para los planos que vayan a verse a pantalla completa.
También te puede interesar
- Análisis y precios de Higgsfield AI frente al acceso mediante API
- Guía de instalación local de Kokoro 82M TTS, para generar la pista de audio que consume MuseTalk
- Guía de Wan 2.2 Animate