 AIREITER
Un usuario de Claude Code calculó cuánto le habría costado a precio de API un mes de trabajo con el plan Max: 7.470 $, frente a una factura de 200 $. La anomalía no está en la tarifa por token. El acceso medido elimina el techo que el plan de suscripción imponía de forma silenciosa, y los agentes reenvían muchos más tokens de los que utiliza una persona al escribir en un chat.
La brecha que están viendo los desarrolladores
Las proporciones que comparten los usuarios son enormes y bastante constantes. En un hilo de r/ClaudeAI que reconstruye los registros de sesiones de Claude Code, un mes de uso del plan Max se tradujo en unos 7.470 $ a precio de lista de la API, frente a una suscripción de 200 $. En otro hilo sobre suscripción frente a API, un usuario con un plan de 200 $ calculó que el mismo trabajo costaría entre 5.000 y 20.000 $ al mes.
Son estimaciones de usuarios sin auditar, pero en ambos casos se repite el mismo patrón, el que más tokens consume: un agente recorriendo un repositorio.
"Tengo el plan Enterprise de API para mi empresa mediante Claude Code y puedo decir de primera mano que es muy fácil gastar entre 100 y 200 $ por sesión en costes de API programando con normalidad en proyectos grandes." — u/andywidjaja, r/ClaudeAI
Un plan de pago y una clave de API son productos distintos
Anthropic lo explica directamente. Su artículo del centro de ayuda, actualizado el 16 de marzo de 2026, define los planes de Claude y Claude Console como «productos independientes diseñados para fines distintos» y aclara que una suscripción de pago «no incluye acceso a la API de Claude ni a Console». OpenAI aplica la misma separación y gestiona la facturación de ChatGPT y de la plataforma API mediante sistemas independientes.
La mejor forma de entender la diferencia es fijarse en qué vende cada opción:
| Plan de chat de pago | Clave de API | |
|---|---|---|
| Unidad vendida | Una plaza para una persona | Volumen de tokens |
| Límite | Ventana móvil de 5 horas más límites semanales | No incluye una cuota; siguen aplicándose los límites de velocidad y gasto |
| Acceso | Aplicaciones web, de escritorio y móviles | Tu propio código |
| Modelo de precio | Cuota mensual fija | Variable, por token |
| Para impulsar tu propio producto | No es para lo que se vende | Ese es precisamente el objetivo |
La página de precios de Claude sitúa Pro en 20 $ al mes con facturación mensual o 17 $ al mes con facturación anual (200 $ por adelantado), y Max desde 100 $ al mes, con 5× o 20× el uso de Pro por sesión de cinco horas. Anthropic no publica un número de mensajes para esos niveles porque el consumo depende de la longitud de la conversación, el modelo y las funciones utilizadas. Por eso, la comparación enfrenta una magnitud medida con otra que no lo está.
La misma página deja otra pista: Claude Enterprise combina una cuota mensual de 20 $ por plaza con el uso facturado según las tarifas de la API. Los clientes que consumen mucho terminan otra vez frente al contador.
Cuántos tokens compra realmente una suscripción
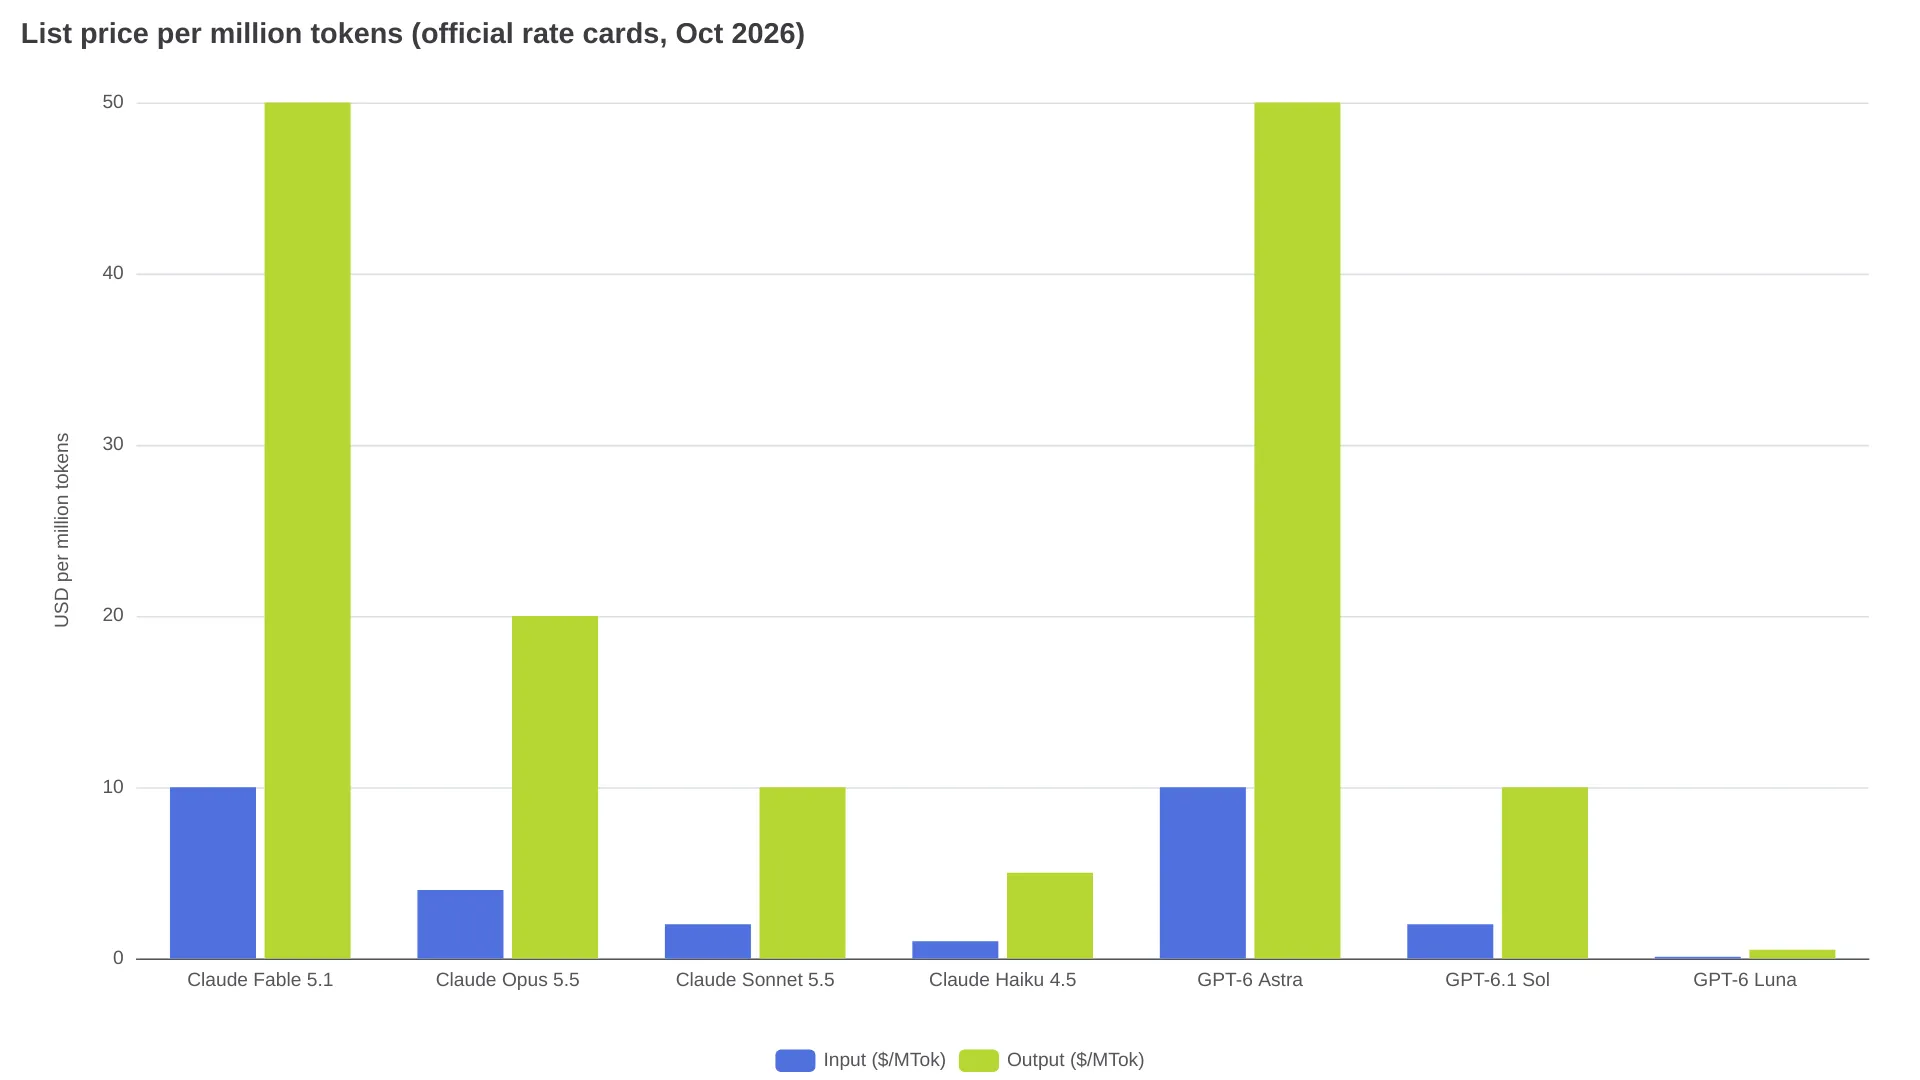
Convertir el precio del plan en tokens hace que la diferencia sea mucho más tangible. Estas son las tarifas oficiales por millón de tokens (MTok) de la documentación de precios de la plataforma de Claude y de la página de precios de API de OpenAI, comprobadas el 1 de octubre de 2026.
| Modelo | Entrada | Salida | Lectura de caché | Lote (entrada/salida) |
|---|---|---|---|---|
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | 5 $ / 25 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 2 $ / 10 $ |
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,20 $ | 1 $ / 5 $ |
| Claude Haiku 4.5 | 1 $ | 5 $ | 0,10 $ | 0,50 $ / 2,50 $ |
| GPT-6 Astra | 10 $ | 50 $ | 1,00 $ | 5 $ / 25 $ |
| GPT-6.1 Sol | 2 $ | 10 $ | 0,10 $ | 1 $ / 5 $ |
| GPT-6 Luna | 0,10 $ | 0,50 $ | 0,01 $ | 0,05 $ / 0,25 $ |
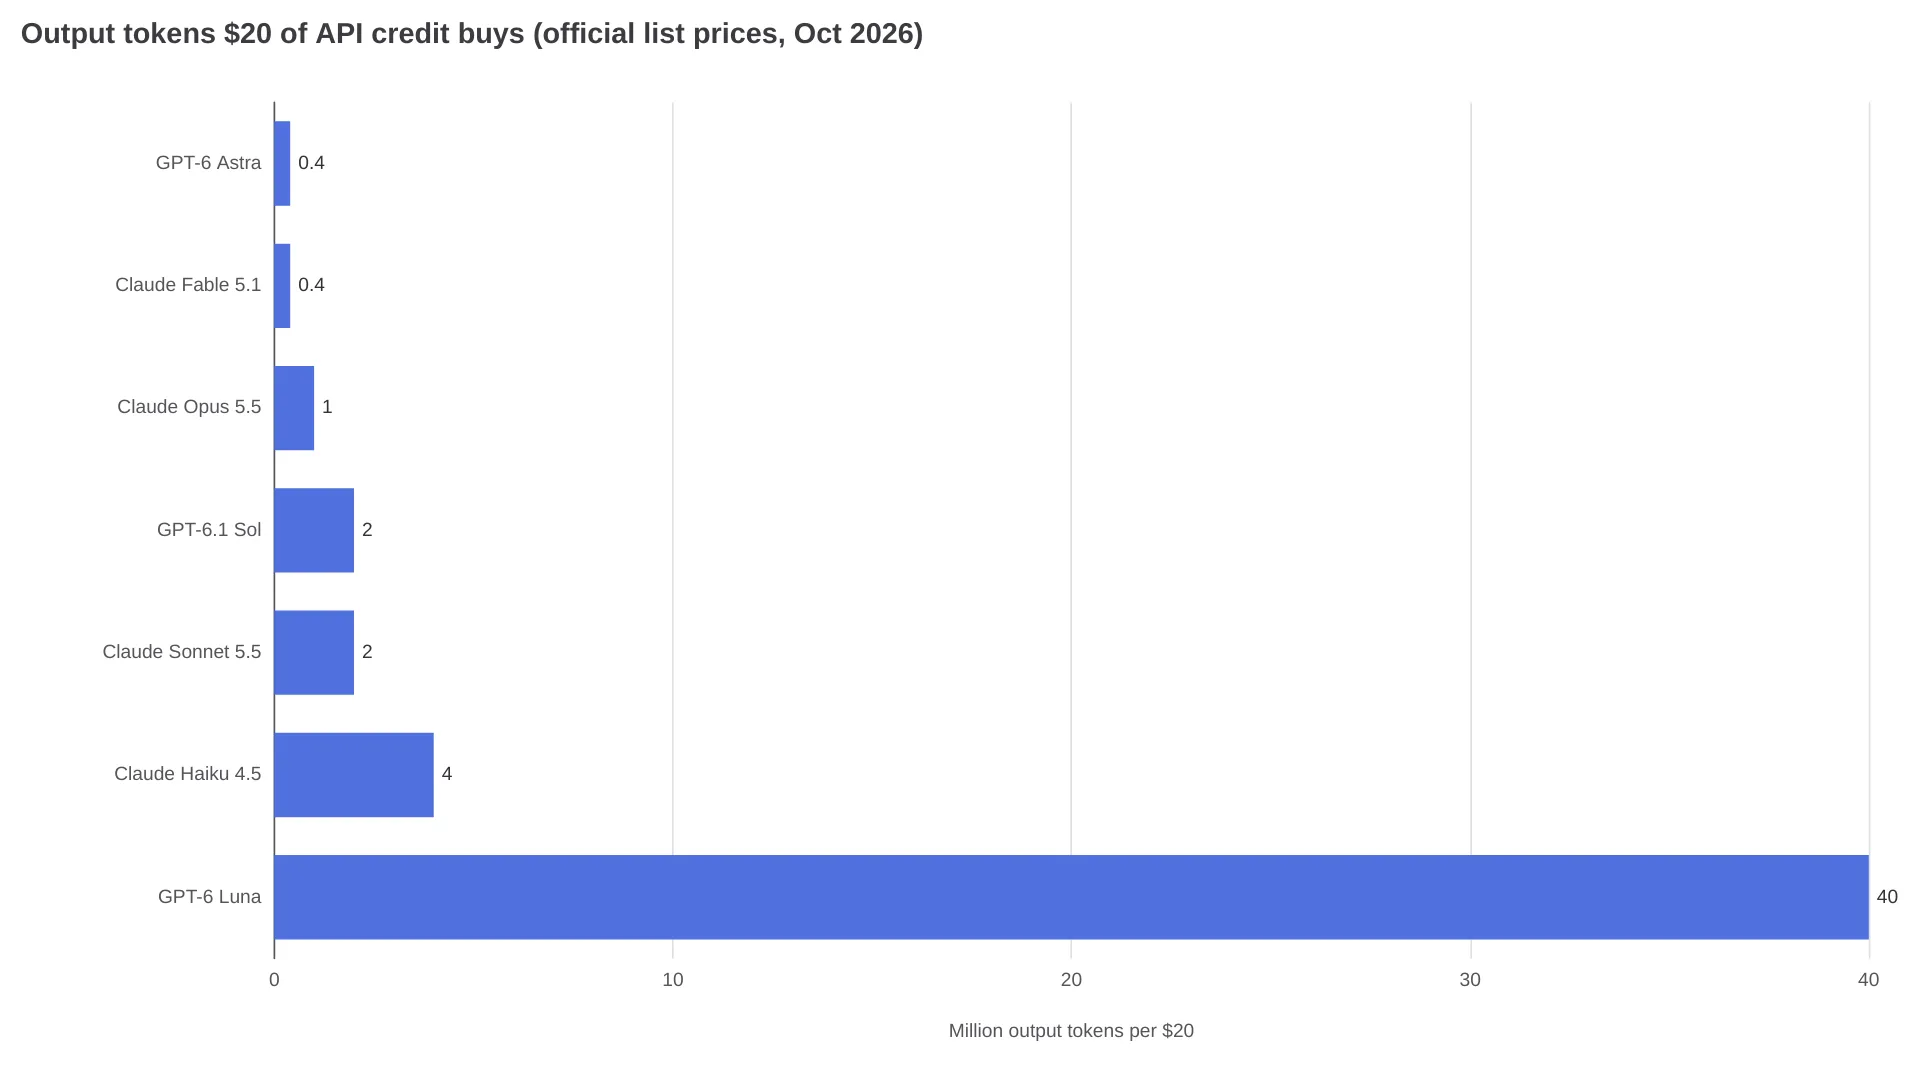
Para un uso parecido al de un chat, con unos pocos miles de palabras de contexto y unos cientos de palabras de respuesta, 20 $ de crédito de Sonnet 5.5 cubren aproximadamente 10 millones de tokens de entrada o 2 millones de tokens de salida. Tu cifra concreta sale de los cuatro campos de la respuesta de la API: (entrada nueva × tarifa de entrada) + (entrada en caché × tarifa de lectura de caché) + (escrituras de caché × tarifa de escritura) + (salida × tarifa de salida), además de los multiplicadores por lotes, contexto largo y región. Registra esos cuatro valores por endpoint durante una semana y tendrás una estimación mensual que podrás comparar con el precio de una plaza.
Dónde se van realmente los tokens
Hay cuatro fuentes habituales de gasto inesperado que no aparecen a simple vista en la tabla de tarifas. Las tres últimas están documentadas en el análisis de LLM Cost Lab sobre los costes fuera de tarifa.
- El historial se reenvía en cada turno. En las integraciones de chat basadas en solicitudes, el cliente vuelve a enviar la conversación, de modo que el turno 20 incluye los turnos del 1 al 19. Si cada turno añade una cantidad parecida de contexto, el volumen de entrada crece aproximadamente con el cuadrado de la longitud de la conversación. Por eso ese análisis calcula 0,163 $ para una sesión de 20 turnos, frente a los 0,063 $ presupuestados como llamadas independientes: una diferencia de 2,6×.
- El prompt del sistema se multiplica en cada llamada. Un prompt del sistema de 2.000 tokens en 1 millón de solicitudes supone 2.000 millones de tokens de entrada antes de que el usuario escriba nada.
- Tokens de razonamiento que nunca ves. En los modelos que facturan las trazas internas de razonamiento como salida, esos tokens pueden ser varias veces más largos que la respuesta visible. Si calculas el consumo a partir de los caracteres devueltos, estarás subestimando la factura.
- Resultados de herramientas, reintentos y generaciones descartadas. Si el modelo lo ha generado, se paga: también la respuesta que rechazó tu validador JSON y la llamada paralela que ejecutaste, pero luego descartaste.
Los tokens baratos también pueden dominar una factura, y eso desconcierta a quienes consultan su propio panel de uso. En el hilo de 7.470 $, un comentarista observó que las lecturas de caché suponían el 48 % del total pese a ser el tipo de token más barato de la tabla.
«Ese ya es el tipo de token más barato de la API, así que, si aun así domina después de aplicar los precios de lista, el uso real consiste sobre todo en volver a leer el contexto en cada turno» — u/YoanEdwin, r/ClaudeAI
Aplica las tarifas de Opus 5.5 a un turno de agente que transporte 150.000 tokens de contexto del repositorio y el patrón queda claro:
| Opus 5.5, sesión de 60 turnos, 150.000 tokens de contexto + 2.000 tokens de salida por turno | Coste |
|---|---|
| Entrada nueva por turno, sin acierto de caché (150.000 @ 4 $) | 0,60 $ |
| Lectura de caché por turno en lugar de entrada nueva (150.000 @ 0,20 $) | 0,03 $ |
| Salida por turno (2.000 @ 20 $) | 0,04 $ |
| Una escritura de caché de 1 hora por sesión (150.000 @ 8 $) | 1,20 $ |
| Total de la sesión, sin caché | 38,40 $ |
| Total de la sesión, con caché | 5,40 $ |
Dos sesiones con caché al día durante 22 días laborables suponen aproximadamente 238 $, ya por encima de un plan de 200 $. Sin caché, el mismo mes supera los 1.600 $. La tarifa no cambió; lo que cambió fue el número de tokens.
No son dos opciones, sino tres
La mayoría de las comparativas se quedan en plan frente a API. Existe un tercer nivel, y los usuarios solo llegan a él cuando agotan la cuota: créditos de uso adicional vendidos dentro del propio producto de suscripción.
Según varios informes de r/codex, ese nivel sale más caro que la API sin descuentos. Un usuario Pro registró aproximadamente 16 millones de tokens consumidos mediante créditos comprados por unos 40 $, y calculó que el mismo volumen habría costado unos 12 $ con las tarifas de lista de la API.
«Sí, el precio de los créditos roza lo abusivo. Cobrar 50 $ por una sola landing page es absurdo cuando en la API costaría unos 2 $.» — u/AbjectBug5885, r/codex
Son estimaciones de usuarios, no tarifas universales, y el precio de las recargas cambia según el proveedor y el plan. En los casos de Codex anteriores, las recargas costaban aproximadamente 3× el gasto equivalente a precio de lista de la API. Conviene comprobarlo con tus propios números antes de volver a comprar créditos la semana siguiente.
Cinco palancas que cambian la factura
Cada una tiene una tarifa oficial, así que puedes comprobar las cuentas directamente en la página del proveedor.
- Caché de prompts, contando también la prima de escritura. La documentación de precios de Anthropic fija la escritura de caché de 5 minutos en 1,25× la entrada base y la de 1 hora en 2×, mientras que las lecturas cuestan 0,1× la base (0,05× en Opus 5.5 y 0,025× en Fable 5.1). Una escritura de 5 minutos se amortiza después de una lectura; una de 1 hora, después de dos. Si escribes en caché y nunca vuelves a leer, pagarás más que sin usarla. El orden también importa: coloca primero el contenido estable y deja la variación del usuario al final, o el prefijo dejará de coincidir. En esta guía sobre caché de prompts explicamos cómo diagnosticar la tasa de aciertos.
- Procesa por lotes todo lo que pueda esperar. Ambos proveedores reducen un 50 % el precio de lista para el procesamiento asíncrono: Opus 5.5 baja a 2/10 $, y Sonnet 5.5 a 1/5 $. La cobertura es irregular en el resto del mercado: LLM Cost Lab contabiliza 26 de los 83 modelos analizados con un nivel de lotes rebajado, así que confirma que el tuyo lo ofrece antes de diseñar tu arquitectura en torno a él. Los detalles están en nuestra guía de precios de la API por lotes.
- Elige el modelo según la tarea. La clasificación, el enrutamiento y las decisiones de recuperación rara vez necesitan un modelo de frontera. Haiku 4.5 cuesta 1/5 $, frente a los 10/50 $ de Fable 5.1: una diferencia de 10× en pasos que generan diez tokens.
- Limita la salida, no solo
max_tokens. La salida cuesta 5× más que la entrada en casi todas las filas de la tabla anterior. Un esquema que prohíba la introducción cambia un pequeño coste estructural por el texto que, de otro modo, tendrías que pagar. Además,max_tokensfunciona mejor como límite de seguridad que como herramienta de formato, porque una respuesta truncada puede obligarte a pagar un segundo intento. - Vigila los multiplicadores adicionales. El nivel de contexto largo de OpenAI duplica las tarifas de entrada de contexto corto, y el modo Fast vuelve a duplicar el precio estándar. Anthropic cobra 1,1× por la inferencia fijada en EE. UU., y su documentación de precios indica que Claude 4.7 y posteriores utilizan un tokenizador nuevo que produce aproximadamente un 30 % más de tokens para el mismo texto. Tu prompt no cambió; lo que cambió fue el contador.
Hay una opción estructural que queda fuera de esa lista: dirigir el tráfico programático a través de un único endpoint medido, en lugar de mantener una relación de facturación por proveedor. Para eso sirve el endpoint de Claude API de AIReiter. A precios de lista, un mes de exceso con 40 millones de tokens de entrada de nivel Sonnet y 8 millones de salida cuesta 80 $ + 80 $, así que comparar esa cifra con una segunda plaza lleva aproximadamente un minuto.
Qué opción comprar
| Tu situación | Compra | Motivo |
|---|---|---|
| Chat, investigación y código ocasional en una aplicación | Solo el plan de pago | Gasto limitado, aplicaciones incluidas y uso muy por debajo de los límites del plan |
| Programación autónoma en solitario, en un solo equipo | Primero el plan; clave medida para el exceso | El plan absorbe la mayor parte y la clave elimina la espera del reinicio semanal |
| Lanzamiento de un producto que utilizarán otras personas | Solo API | Una plaza cubre a una persona; tus usuarios necesitan su propio volumen |
| Trabajos masivos periódicos: evaluaciones, backfills y clasificación | API con nivel de lotes | 50 % de descuento sobre el precio de lista y la latencia no importa |
| Ya compras créditos adicionales la mayoría de las semanas | Compara el exceso con una clave | El precio de los créditos se situó por encima de las tarifas de lista de la API |
Preguntas frecuentes
¿Un plan de pago de ChatGPT o Claude incluye créditos de API?
No. El centro de ayuda de Anthropic afirma claramente que un plan de Claude de pago «no incluye acceso a la API de Claude ni a Console», y OpenAI factura ChatGPT y la plataforma API mediante sistemas independientes. Si pagas por ambos, tendrás dos cargos.
¿Me cobran por los tokens de razonamiento que no veo?
Sí, en los modelos que exponen pensamiento o razonamiento extendido. Esos tokens se facturan a la tarifa de salida sin aparecer en el cuerpo de la respuesta, así que debes consultar el objeto usage.
¿Pago por toda la conversación en cada turno?
Sí, salvo que un acierto de caché cubra el prefijo repetido. Si no existe una función de estado en el servidor, tu cliente reenvía el historial que quiere que vea el modelo. Ese historial se factura como entrada nueva a la tarifa del modelo o a la tarifa de lectura de caché cuando el prefijo coincide.
¿Una solicitud fallida o repetida también cuesta dinero?
Según el análisis de facturación de LLM Cost Lab, una solicitud que llega al modelo y obtiene respuesta se factura aunque tu aplicación descarte el resultado después de un fallo de esquema o de un tiempo de espera del cliente. La excepción son las solicitudes rechazadas antes de la generación.
El intercambio que nadie ha resuelto
Los planes limitan el gasto, pero racionan el acceso; las claves medidas invierten ambas cosas. Como no se publica el valor en tokens de la cuota de un plan, responder a «¿qué me sale más barato?» exige medir durante una semana tu propio tráfico y calcularlo con la tabla anterior.
Lecturas relacionadas: La API de LLM más barata en 2026 · Guía de precios de Claude API