Las cifras de los servicios alojados prometen 280 tokens por segundo, pero las primeras pruebas en portátiles se mueven entre 8 y 220 tok/s según el hardware y el runtime. Inkling 2 Mini es una opción potente para agentes de programación sin conexión: un modelo de pesos abiertos de 26.4B que ocupa aproximadamente 20 GB. Aun así, conviene conocer sus carencias en chat, factualidad y disponibilidad de API antes de descargarlo.
Quién debería apostar por Inkling 2 Mini y quién no
Inkling 2 Mini encaja muy bien en una tarea concreta y bastante peor en varias otras. Por eso, el tipo de uso importa más que la tabla de benchmarks. Su terreno natural es la asistencia de programación local con herramientas y búsquedas; el chat intensivo y el uso exclusivamente mediante API no son su fuerte.
| Tu tipo de uso | Veredicto sobre Mini |
|---|---|
| Agente de programación local en un Mac con 32 GB o más, o en un DGX Spark | Muy buena opción: aquí aparecen sus mejores resultados |
| Trabajo privado con contexto largo (hasta 1M de tokens nominales) | Merece una prueba: en la práctica, empieza con un contexto de 32K |
| Chat con varios turnos o seguimiento estricto de instrucciones | Mejor evitarlo: Qwen3.8-27B ofrece mejores mediciones en este apartado |
| Consumo mediante una API alojada hoy | Mejor evitarlo: todavía no hay una oferta serverless; solo están disponibles las tarifas de muestreo y ajuste fino |
El resto del análisis pone cifras a esa diferencia: qué cambia con el bucle, qué benchmarks resisten una revisión más crítica, qué velocidad local puede esperarse en la práctica y qué se obtiene por el precio.
Qué es Inkling 2 Mini y cómo funciona su bucle
Thinking Machines Lab lanzó Inkling 2 Mini el 20 de noviembre de 2026 como un modelo de pesos abiertos bajo licencia Apache 2.0. Los pesos están disponibles en Hugging Face con el nombre thinkingmachines/Inkling-2-Mini. Acepta texto e imágenes, genera texto y declara un contexto máximo de 1 millón de tokens.
| Especificación | Inkling 2 Mini |
|---|---|
| Lanzamiento | 20 de noviembre de 2026, Thinking Machines Lab |
| Licencia | Apache 2.0 |
| Parámetros | 26.4B totales / 3.4B activos por token / 5.4B efectivos con bucles |
| Capas | 24 almacenadas; las 12 centrales se ejecutan 3 veces por token (6 + 3x12 + 6 = 48 aplicaciones) |
| Enrutamiento MoE | 8 de 128 expertos por token y capa |
| Precisión | NVFP4 para 20 capas, MXFP8 para las 4 finales; checkpoint de unos 20 GB (19.5 GB + predictor de 0.64 GB) |
| Contexto / modalidades | Hasta 1M de tokens; entrada de texto e imagen y salida de texto |
| Objetivos locales | Mac con 32 GB o más de memoria mediante Ollama, o un NVIDIA DGX Spark según la tarjeta del modelo |
La cifra de 3.4B representa los parámetros activos almacenados; si se cuentan las tres pasadas del bucle, el cómputo efectivo ronda los 5.4B. Reutilizar los pesos reduce el tamaño del archivo, pero aumenta el trabajo necesario para generar cada token, como explica el análisis técnico de Hugging Face.
El bucle añade capacidad de cálculo, no conocimiento almacenado. En el anuncio de lanzamiento, el laboratorio presenta Mini como un modelo inferior a los Inkling más grandes en recuperación factual, porque el conocimiento depende sobre todo del número total de parámetros. De ahí que las búsquedas y las herramientas sean tan importantes en este caso.
Los benchmarks fiables y los que conviene poner en contexto
Todas las cifras siguientes proceden de los propios bancos de pruebas del laboratorio, recogidos en la tarjeta del modelo en Hugging Face. Mini destaca en programación con herramientas y búsquedas, pero empata o queda por detrás en razonamiento, visión y disciplina conversacional.
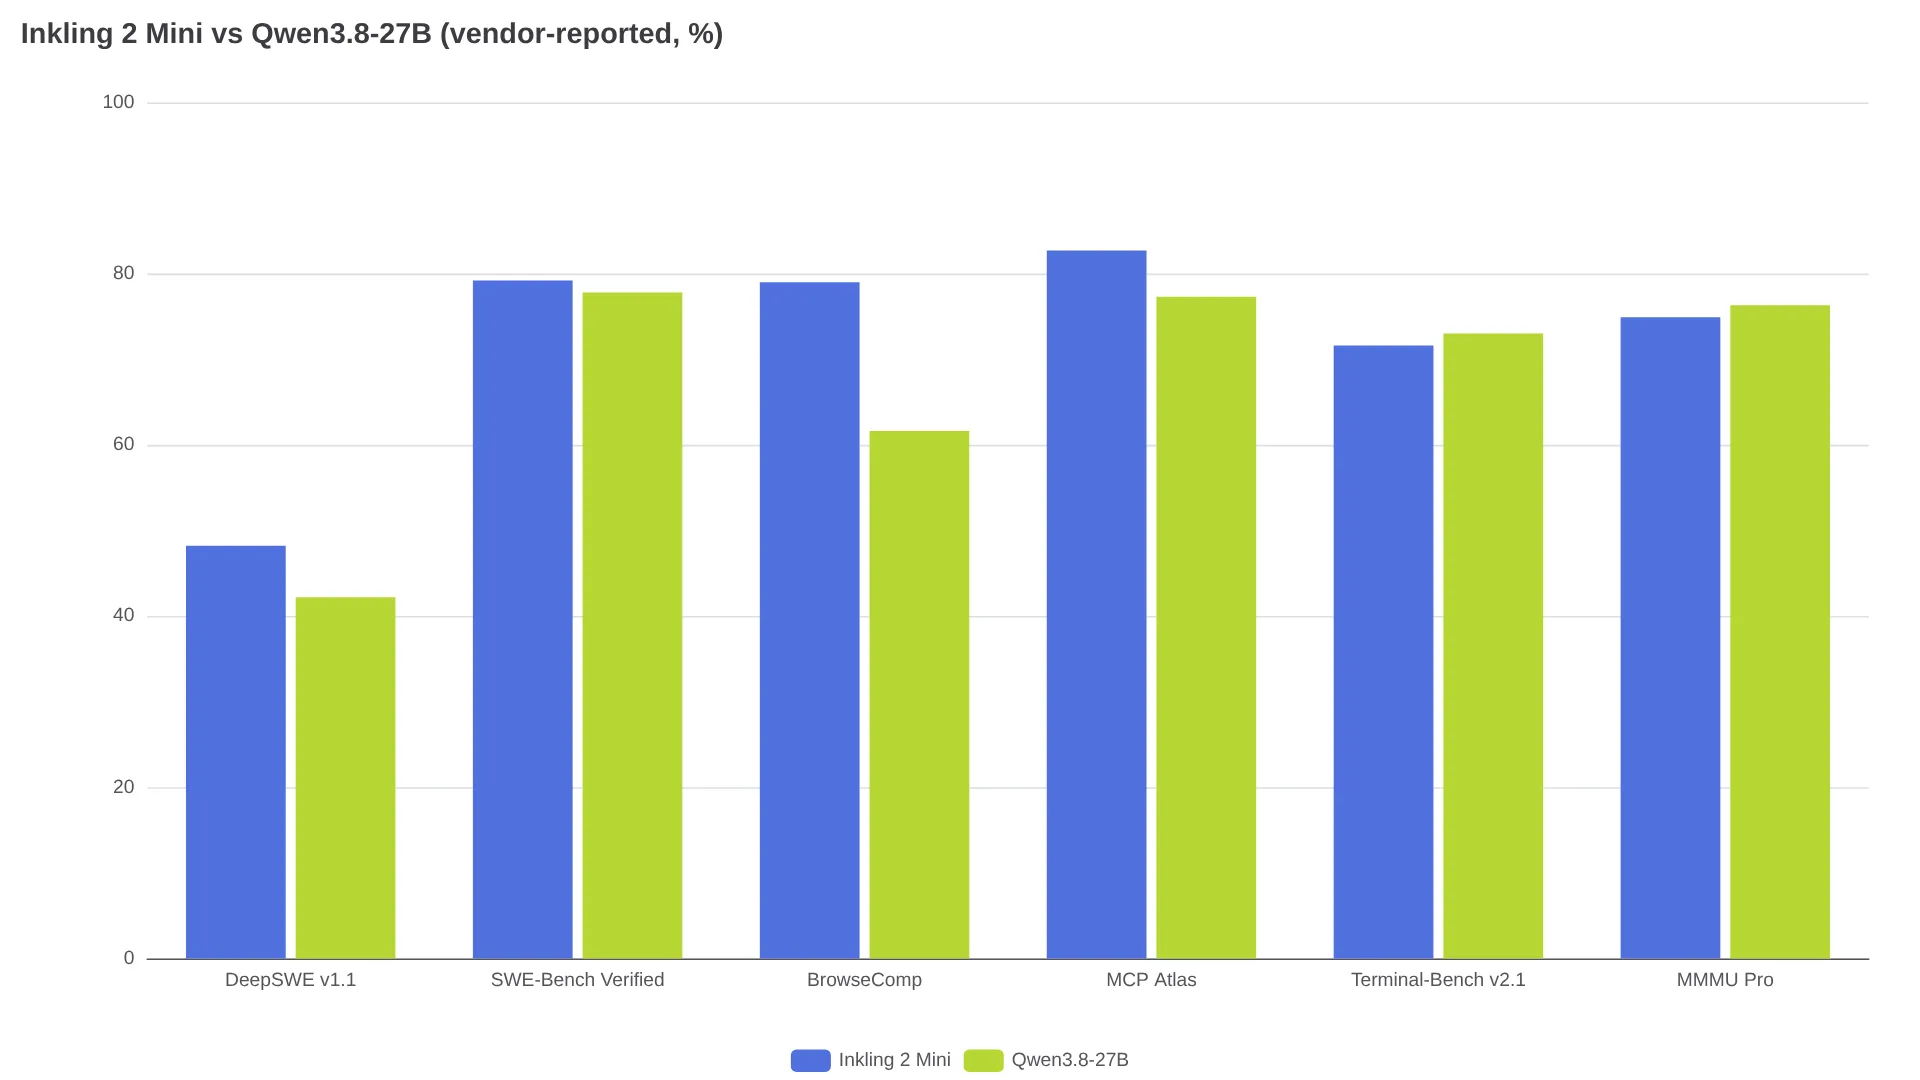
Mini supera a Qwen3.8-27B en DeepSWE v1.1, con un 48.2% frente a 42.2%; en SWE-Bench Verified, con 79.2% frente a 77.8%; en BrowseComp, con 79.0% frente a 61.6%; y en MCP Atlas, con 82.7% frente a 77.3%. Artificial Analysis concede a ambos modelos una puntuación de 20.1 en su Intelligence Index, aunque Mini completa la tarea del índice en 9.0 minutos frente a los 38.2 de Qwen. ARC Prize informa de un 84.5% en ARC-AGI-1 y un 49.3% en ARC-AGI-2 con el nivel de razonamiento más alto.
La otra mitad de la historia aparece en la misma tarjeta del modelo, donde Mini queda por detrás: 15.2% frente a 15.3% en HLE-Diamond, 74.9% frente a 76.3% en MMMU Pro y 71.6% frente a 73.0% en Terminal-Bench v2.1. La diferencia en factualidad es más amplia: la tasa de respuestas no alucinadas en AA-Omniscience es del 63.4%, frente al 71.4% de Qwen. Mini también pierde en ComplexConstraints (33.4%) y MultiChallenge (50.0%).
La ejecución local no se resume en una sola cifra
La página oficial de Ollama y la tarjeta del modelo apuntan a un Mac con 32 GB o a un DGX Spark, pero el soporte todavía temprano de los modelos con bucles hace que la velocidad real varíe mucho. El rendimiento alojado —280 tok/s según Artificial Analysis— sirve de poco para predecir lo que obtendrás en un portátil.
| Configuración | Velocidad comunicada | Fuente |
|---|---|---|
| Evaluación alojada (Artificial Analysis) | 280 tok/s | Medición de terceros |
| RTX 4090, vLLM parcheado + FP8/NVFP4 + drafter | ~190-220 tok/s | Usuario de Reddit, solo después del parche (117 de base) |
| MacBook Pro con M5 Max | ~125 tok/s | @alexocheema |
| MacBook Pro con M1 Max y 64 GB, cuantización de 4 bits | ~20 tok/s | Usuario de Hacker News gregsadetsky, a través del análisis de lanzamiento de eesel |
| Primeras compilaciones de llama.cpp, hardware variado | ~5-10 tok/s | Hilo de r/LocalLLM |
"No conseguí que pasara siquiera de 5 t/s." — u/KURD_1_STAN, hilo comparativo de r/LocalLLM
El runtime y la cuantización explican buena parte de la diferencia. Las compilaciones actuales gestionan mejor las capas en bucle que las primeras, y la elección de cuantización cambia el tamaño ocupado —la recomendada de 4 bits ronda los 17.6 GB más un proyector de visión de 639 MB, según la guía de Unsloth publicada a través de Crewmark— antes de que los contextos largos añadan presión sobre la caché KV.
En una prueba de emparejamiento de pagos con la misma latencia, Qwen alcanzó un 98.2% de precisión sin falsos positivos, frente al 96.9% de Mini con cinco falsos positivos:
"Probamos Inkling 2 Mini frente a Qwen3.8-27B en nuestro flujo real de emparejamiento de pagos... Qwen: 98.2% de precisión, 0 falsos positivos... Inkling: 96.9%, 5 falsos positivos... Qwen se queda para este trabajo." — @exebat3 (publicación)
La conclusión práctica es sencilla: empieza con un contexto de 32K, redúcelo si falta memoria y comprueba que tu compilación del runtime sea compatible con las capas en bucle antes de sacar conclusiones sobre la calidad.
El precio, aunque todavía no haya botón de compra
Las tarifas de Tinker que recoge la página del modelo en Artificial Analysis son de 0.15 $ por cada millón de tokens de entrada, 0.015 $ para los tokens en caché y 0.50 $ para la salida. El ajuste fino cuesta 0.75 $ (64K) y 1.50 $ (256K). Aplicadas al uso de tokens medido, esas tarifas producen un coste de 0.59 $ por tarea del índice, frente a los 3.53 $ de Qwen3.8-27B.
Esos 0.59 $ son una estimación, no un precio alojado que pueda contratarse. En el momento de este análisis, Mini no aparece en ninguna oferta de inferencia serverless; el análisis de eesel documenta la comprobación en Tinker y OpenRouter. Además, Mini generó 161M tokens de salida en la ejecución del índice, frente a una mediana de 85.7M, así que su mayor verbosidad se come parte del ahorro por token. Para alojarlo por tu cuenta, compara el coste del hardware, la electricidad y la configuración con una API alojada de Qwen o de un modelo de frontera.
Dos ajustes que determinan si funciona
El esfuerzo de razonamiento va desde ninguno (0.0) hasta mínimo (0.1), bajo (0.2), medio (0.7), alto (0.9, el valor predeterminado) y xhigh/máximo (0.99). Según la tarjeta del modelo, el nivel mínimo no desactiva por completo el razonamiento.
Un nivel más bajo puede dar mejores resultados. En el debate de r/LocalLLM sobre Terminal-Bench, un usuario obtuvo 10/13 en un subconjunto de 13 tareas con esfuerzo bajo, mientras que el nivel medio agotaba el tiempo de espera repetidamente. Por otro lado, un usuario de Hacker News citado por el análisis de eesel consumió 19,200 tokens de razonamiento sin herramientas y no terminó la tarea; al activar la búsqueda, produjo una solución con el nombre de hook equivocado.
Limita los tokens de salida y los turnos del agente, ejecuta el acceso al sistema de archivos dentro de un sandbox y exige revisión humana antes de usarlo en producción. La tarjeta del modelo advierte de acciones destructivas sin confirmación y de bucles de razonamiento atascados, especialmente al depurar código.
El intercambio que debes aceptar antes de descargarlo
Mini obtiene más capacidad de cálculo sin aumentar el tamaño del checkpoint al reutilizar sus capas centrales. Además, el laboratorio distribuye un checkpoint de investigación con bucles variables para estudiar ese comportamiento (análisis técnico). Los fallos observados son concretos: bucles durante la depuración, un cambio al japonés a mitad de una respuesta comunicado por un usuario y llamadas a herramientas que necesitan límites claros. Descárgalo para programar sin conexión y con controles; espera si necesitas un chat cuidadoso o una API lista para usar.
Preguntas frecuentes
¿Puede Inkling 2 Mini funcionar en un portátil?
Sí, con la compilación adecuada: en un Mac con Apple Silicon y 32 GB o más mediante Ollama o una versión actual de llama.cpp, preferiblemente en 4 bits (~17.6 GB más el proyector). Espera unos 20 tok/s en un M1 Max antiguo y más de 100 tok/s en hardware M5; los runtimes sin parchear pueden arrastrarse a velocidades de un solo dígito (consulta la tabla anterior).
¿Es Inkling 2 Mini mejor que Qwen3.8-27B?
Para agentes de programación, sí; para chat, no. Como muestra el gráfico anterior, Mini lidera en DeepSWE, SWE-Bench Verified, BrowseComp y MCP Atlas. Qwen gana en Terminal-Bench v2.1, MMMU Pro, factualidad e instrucciones con restricciones. Todas las cifras proceden de los proveedores y aparecen en la tarjeta del modelo.
¿Por qué las fuentes hablan tanto de 3.4B como de 5.4B de parámetros activos?
3.4B son los parámetros activos almacenados; 5.4B suma las tres pasadas del bucle, de aproximadamente 1.0B cada una. Usa 5.4B para estimar el cómputo y 3.4B para la memoria.
¿Puedo llamar a Inkling 2 Mini mediante una API alojada?
No había un endpoint serverless oficial en el momento del análisis. Tinker publica tarifas de muestreo y ajuste fino, pero no ofrece Mini en su catálogo serverless, según la comprobación de eesel. Ejecuta los pesos de Hugging Face localmente o espera a que haya soporte alojado.
¿Cómo puedo detener los bucles de razonamiento?
Empieza con un nivel de esfuerzo bajo (0.2), limita los tokens de salida y los turnos del agente, y ejecuta las herramientas dentro de un sandbox, tal como recomienda la tarjeta del modelo.
Lecturas relacionadas: análisis de Inkling 2 Small y sus precios de API para conocer al hermano de 594B que responde Mini; mejor LLM para agentes de programación en 2026 para situar Mini frente a otras opciones para agentes; y guía de llama.cpp v1.0 para entender el runtime del que Mini depende localmente.